
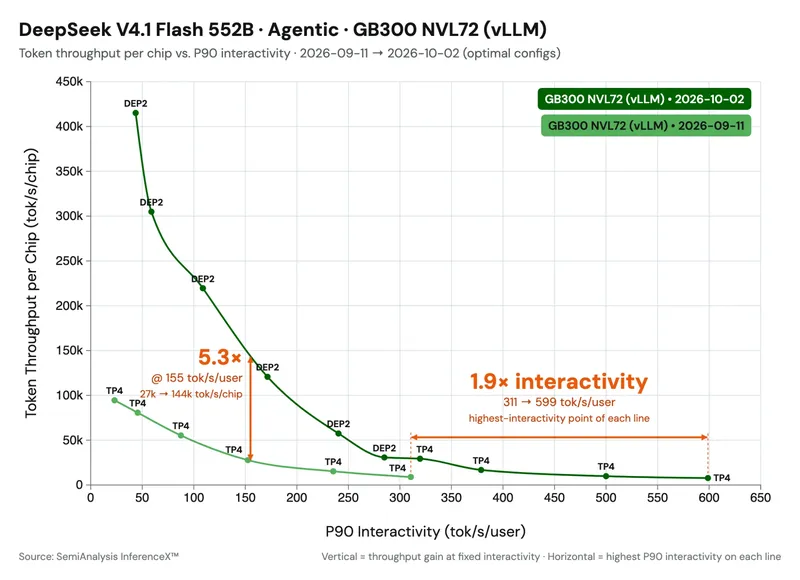
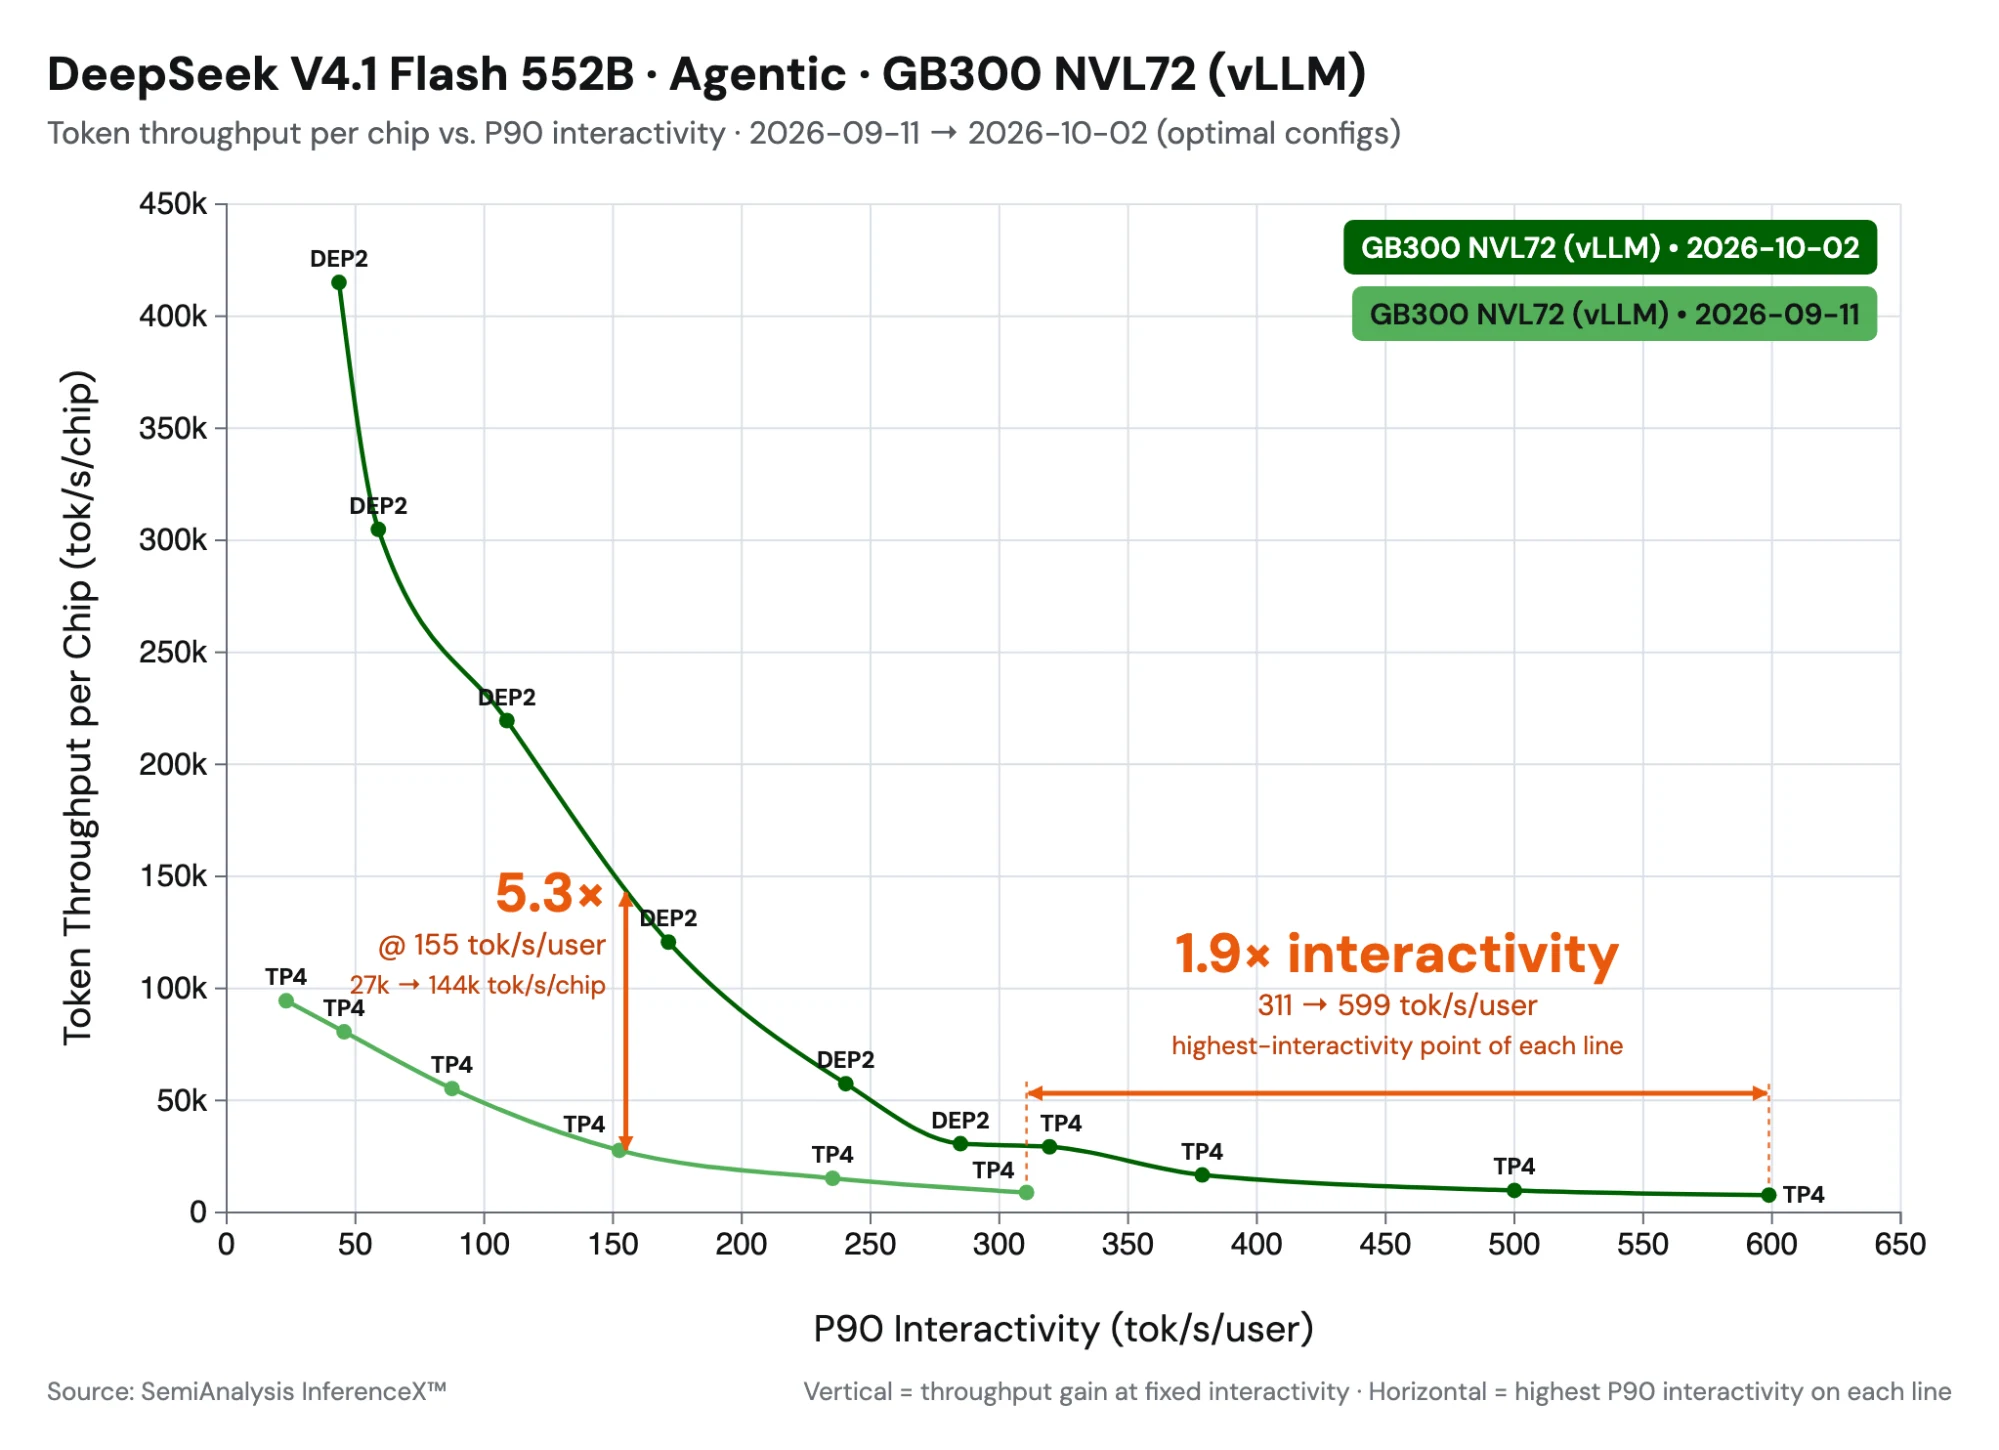
TL;DR: 在 DeepSeek-V4.1-Flash 发布后的三周内,Inferact 和 vLLM 社区对该模型进行了优化,在低并发下实现了 1.9× 的加速,并在 150 TPS 约束下实现了 5.3× 的吞吐量提升。性能提升来自:
-
我们实现了带 CUDA graphs 的 SWA 有界重放,将 TTFT 降低约 30%。
-
我们集成了 DeepSeek 新发布的内核,包括 MegaAttention、Mega-mHC、Mega-Gate 和 DeepSelect。
-
我们激进地融合和并行化了其余内核,包括 mHC 边流,并将 all-reduce 与其前后算子融合为单一内核。
DeepSeek V4.1 为长时程 agentic 服务任务引入了一种高效架构:凭借其因果编码器-解码器(CED)架构,该模型在解码时每个 token 激活 16B 参数,但在 prefill 时仅激活 8B 参数。该模型的内存效率也极高。它结合多种技术来缩小 KV 缓存大小:Compressed Sparse Attention 2(CSA2)、FP4 KV 缓存以及跨层 KV 缓存共享,将全局 KV 占用降至每 token 890 字节。本文展示了我们如何将 DeepSeek 的这些模型级优化与 vLLM 侧的系统优化相结合,在 SemiAnalysis AgentX agentic 服务基准上实现 5× 吞吐量。我们将优化分为两类进行重点介绍:SWA 有界重放和内核相关优化。
SWA 有界重放
DeepSeek-V4.1-Flash 保留两种 KV 缓存。全局 KV 经过压缩、跨层共享并以 FP4 存储,约每 token 890 字节(见V4.1 报告)。滑动窗口(SWA)KV 以 FP8 不压缩存储,覆盖 40 层中每层的最后 128 个位置。
SWA KV 带来两项成本:
-
前缀缓存必须在每个可能的命中边界存储它,存储成本超过全局 KV 的 10 倍。
-
Prefill 需要对每个提示 token 运行第 21–39 层,尽管解码只读取它们的最后 128 个位置。
一种直接的方法是重新计算 SWA KV 而不是缓存它。然而,精确重算成本高昂,因为每层的 128-token 窗口依赖于下一层中更早的位置,因此跨 L 层重建它意味着重放约 L × 128 个 token。
DeepSeek V4.1 引入了 SWA 有界重放,以牺牲精确性换取效率。它只重跑最后 128 个 token,并在重放起点处裁剪 SWA 窗口。结果并非比特级精确,但 DeepSeek 报告称质量损失可忽略不计(详见下文)。vLLM 在两个地方应用它,分别对应两项成本。
编码器侧:在缓存命中时重建窗口
通过编码器侧重放,vLLM 只缓存全局 KV 并跳过 SWA KV。在长度为 H 的前缀命中时,它重跑 token [H − 128, H) 以重建 SWA KV,窗口在 s = H − 128 处裁剪。
解码器侧:跳过大部分提示 prefill
在 DeepSeek V4.1 的 CED 架构中,第 20 层计算解码器的全局 KV,第 21–39 层复用它。因此 vLLM 对每个 token 运行第 20 层以生成该全局 KV,而第 21–39 层只在每个请求的最后 128 个 token 上运行。对于长提示,这跳过了近一半的模型。
为裁剪后的层使用 CUDA graphs
裁剪后,第 21–39 层的 GPU 工作量极小,以致于在即时执行模式下内核启动开销占主导,GPU 处于闲置状态。它们的输入形状也与第 0–20 层不同,因此两部分无法捕获在同一个 CUDA graph 中。vLLM 的可中断 PIECEWISE graph 本身就会在模型中间断开,这提供了一个自然的分割点:第 0–20 层在完整批次上捕获,第 21–39 层在裁剪后的批次上单独捕获。这使得 CUDA graphs 可用于裁剪后的 prefill,并让第 21–39 层使用自己的捕获尺寸以获得更好的图覆盖率。
SWA 有界重放对 DeepSeek-V4.1 默认开启,并由以下参数控制 --[no-]swa-bounded-replay.
精度与性能结果
尽管 SWA 有界重放并非精确计算,DeepSeek 报告的质量损失仅可忽略不计。我们在 vLLM 上通过包括 GSM8K 和 GPQA 在内的基准测试证实了这一点,未观察到有意义的精度差异(差距在约 1.5 个标准误以内)。
在性能方面,编码器侧以每次命中一次窗口 prefill 换取缓存空间,因此加速来自解码器侧。我们在三种设置下测量单请求 prefill TTFT:关闭重放;开启重放但无解码器 CUDA graphs(第 21–39 层即时执行,仅即时步骤被裁剪);以及开启重放并带解码器 CUDA graphs。
带 CUDA graphs 的解码器重放将 prefill 计算时间缩短 30–40%。 CUDA graphs 对短提示最为关键,因为此时内核启动是瓶颈:没有它们,启动开销会超过 GPU 节省的时间,重放反而比基线更慢(在 DEP2 的 1K 下最高 +12%)。对于长提示,GPU 工作量足以掩盖启动开销,因此即时重放已能捕获大部分收益,CUDA graphs 再增加几个百分点。
内核
DeepSeek 在发布 DeepSeek-V4.1-Flash 的同时,在其三个代码仓库中发布了新内核。DeepSelect 是一个用于 DeepSeek Sparse Attention 的新型 top-k 库。DeepGEMM 添加了稀疏索引器内核和若干 GEMM 相关的融合内核。FlashMLA 添加了 NVFP4 KV 缓存支持和一个融合注意力内核 MegaAttention。我们已将其中多个开源内核集成到 vLLM 中,并在以下位置跟踪进展: #57448.
Mega-mHC(#56962). Mega-mHC 将 mHC 链融合为一个 kernel:post 步骤、delayed-pre 步骤以及 RMSNorm。它替换了现有的 TileLang 融合路径,该路径如今已被 DeepGEMM 的实现超越。在 NVIDIA GB200 上,该 kernel 比 TileLang 版本快 1.14–1.51×。
Mega-Gate(#56266). Mega-Gate 将 MoE 路由(gate GEMM、专家打分、偏置和 top-k 选择)融合为一个 kernel。此前,这些操作作为一个 GEMM 加上一个单独的 top-k kernel 运行,需要额外的启动开销以及分数在内存中的一次往返。这种融合在中等批量大小下带来 1.18–1.31× 的 kernel 加速。
mHC 多流重叠(#57603). 在 V4.1 中,mHC 系数偏移了一个子层,因此下一个接缝的系数 GEMM 只读取在 attention 或 FFN 运行之前就已经存在的残差流。双方在下一个 post/pre 步骤将它们合并之前,都不需要对方的输出。在小批量大小下,vLLM 现在在一个侧 CUDA 流上计算下一个 mHC 块的系数,与 attention 和 FFN 并行。这隐藏了原本会占用延迟受限解码关键路径的工作。在 TP4 低延迟场景中,这将延迟降低了约 4%。
稀疏 MQA logits(#56254). 在 V4.1 中,靠后的 indexer 层从固定的 16K 个候选位置集合中挑选 top-k。之前的实现对整个上下文计算分数,并在打分前屏蔽所有非候选块。DeepGEMM 的稀疏 kernel 只对候选位置打分,因此成本不再随上下文增长。在 NVIDIA GB300 上每层,8K token 时快 1.2×,512K 时快 14–23×。在 4× NVIDIA GB300 上端到端,解码提升 3–6%。Prefill 在 512K 上下文时快 1.43×,1M 上下文时快 2×。
带 NVFP4 压缩 KV 的 MegaAttention(#56935). FlashMLA 的 MegaAttention kernel 在单次启动中执行查询 RoPE、稀疏注意力、对输出的逆 RoPE 以及 FP8 转换,直接写入输出投影读取的缓冲区。这消除了 attention 与下一层之间的独立 kernel 和内存往返。它还读取一种新的 NVFP4 压缩 KV 格式,比之前的 FP8 KV 缓存小 45%。MegaAttention 还通过在操作间消除 HBM 写入的激进融合,将 kernel 效率提升 1.45×。
低延迟融合 WO-A kernel(#58634). 对于 Blackwell 上的小批量解码,我们将逆 RoPE、FP8 量化、WO-A 批量 GEMM 和 MXFP8 重量化融合为单个 CuTe-DSL kernel,将 WO-B 之前的链路从三个 kernel 减少到一个。关键思想是将中间激活保持在片上,并将数据移动与计算流水线化,避免在小批量大小下占主导地位的额外 kernel 启动和全局内存往返。这将融合的 WO-A 路径提升高达约 2.1×,并在低并发下提供高达约 6–7% 的更低 token 间延迟。
Engram。 V4.1 的 Engram 层从两个大型 FP8 表中按哈希 token n-gram 为键查找行。每一步只读取几行,因此表的放置和查找延迟比计算更重要。我们异步预取 CPU 卸载的 Engram 查找,将主机内存访问与解码器计算重叠,以加速小批量解码(#56512)。Engram 头采用统一的 TP/DP 方案进行分片,并且同址的 DP 副本共享相同的主机表,避免查找路径上的冗余副本和任何 DP 通信(#57651)。对于这些驻留在主机上的大表,我们还支持透明大页(THP)以减少缺页开销,为 prefill 提供高达 10× 的更快查找 kernel(#56926)。我们还为没有足够大页可用的情况添加了优化(#59327).
Agentic 性能
我们使用 SemiAnalysis AgentX 基准测试作为代表性的 agentic 服务工作负载来衡量性能(在我们的 上一篇文章中有详细介绍)。这些优化加在一起,使 vLLM 相比我们的 day-0 实现获得显著的性能提升。如图 6 所示,我们的低延迟结果比 day-0 结果提升 1.9×,高吞吐量结果提升约 5×。
对于低延迟服务,我们使用 TP4 与 FlashInfer attention。小批量解码在很大程度上受内存带宽限制,因此将模型权重分片到四个 GPU 上是合适的。我们也尝试了 MegaAttention,但它的主要优势在于更高吞吐量的设置,融合在那里有更多发挥空间。在 TP4 下,这一收益要小得多,在我们的运行中 FlashInfer 最终更快。
为了实现高吞吐量,我们切换到 DEP2,使用 DP attention 并将专家切分到各 GPU 上。由于 V4.1 在所有 head 之间共享 KV latent,TP 会在各 GPU 上重复 KV cache。DP 避免了这种重复:每个 GPU 只为其所服务的请求存储 KV,并通过 session affinity 在多轮之间保持 prefix-cache 局部性。MegaAttention 进一步通过 NVFP4 降低了每个请求的 KV 占用,相比 FP8 几乎减半,并提高了单 GPU 并发。
值得注意的是,V4.1 内存效率很高,在整个基准测试中都不需要 KV cache offloading。我们预计在更高并发并结合 P/D disaggregation 时,KV cache offloading 才会开始发挥作用。
SWA bounded replay 连同 prefill 侧的内核优化,也大幅改善了 TTFT。
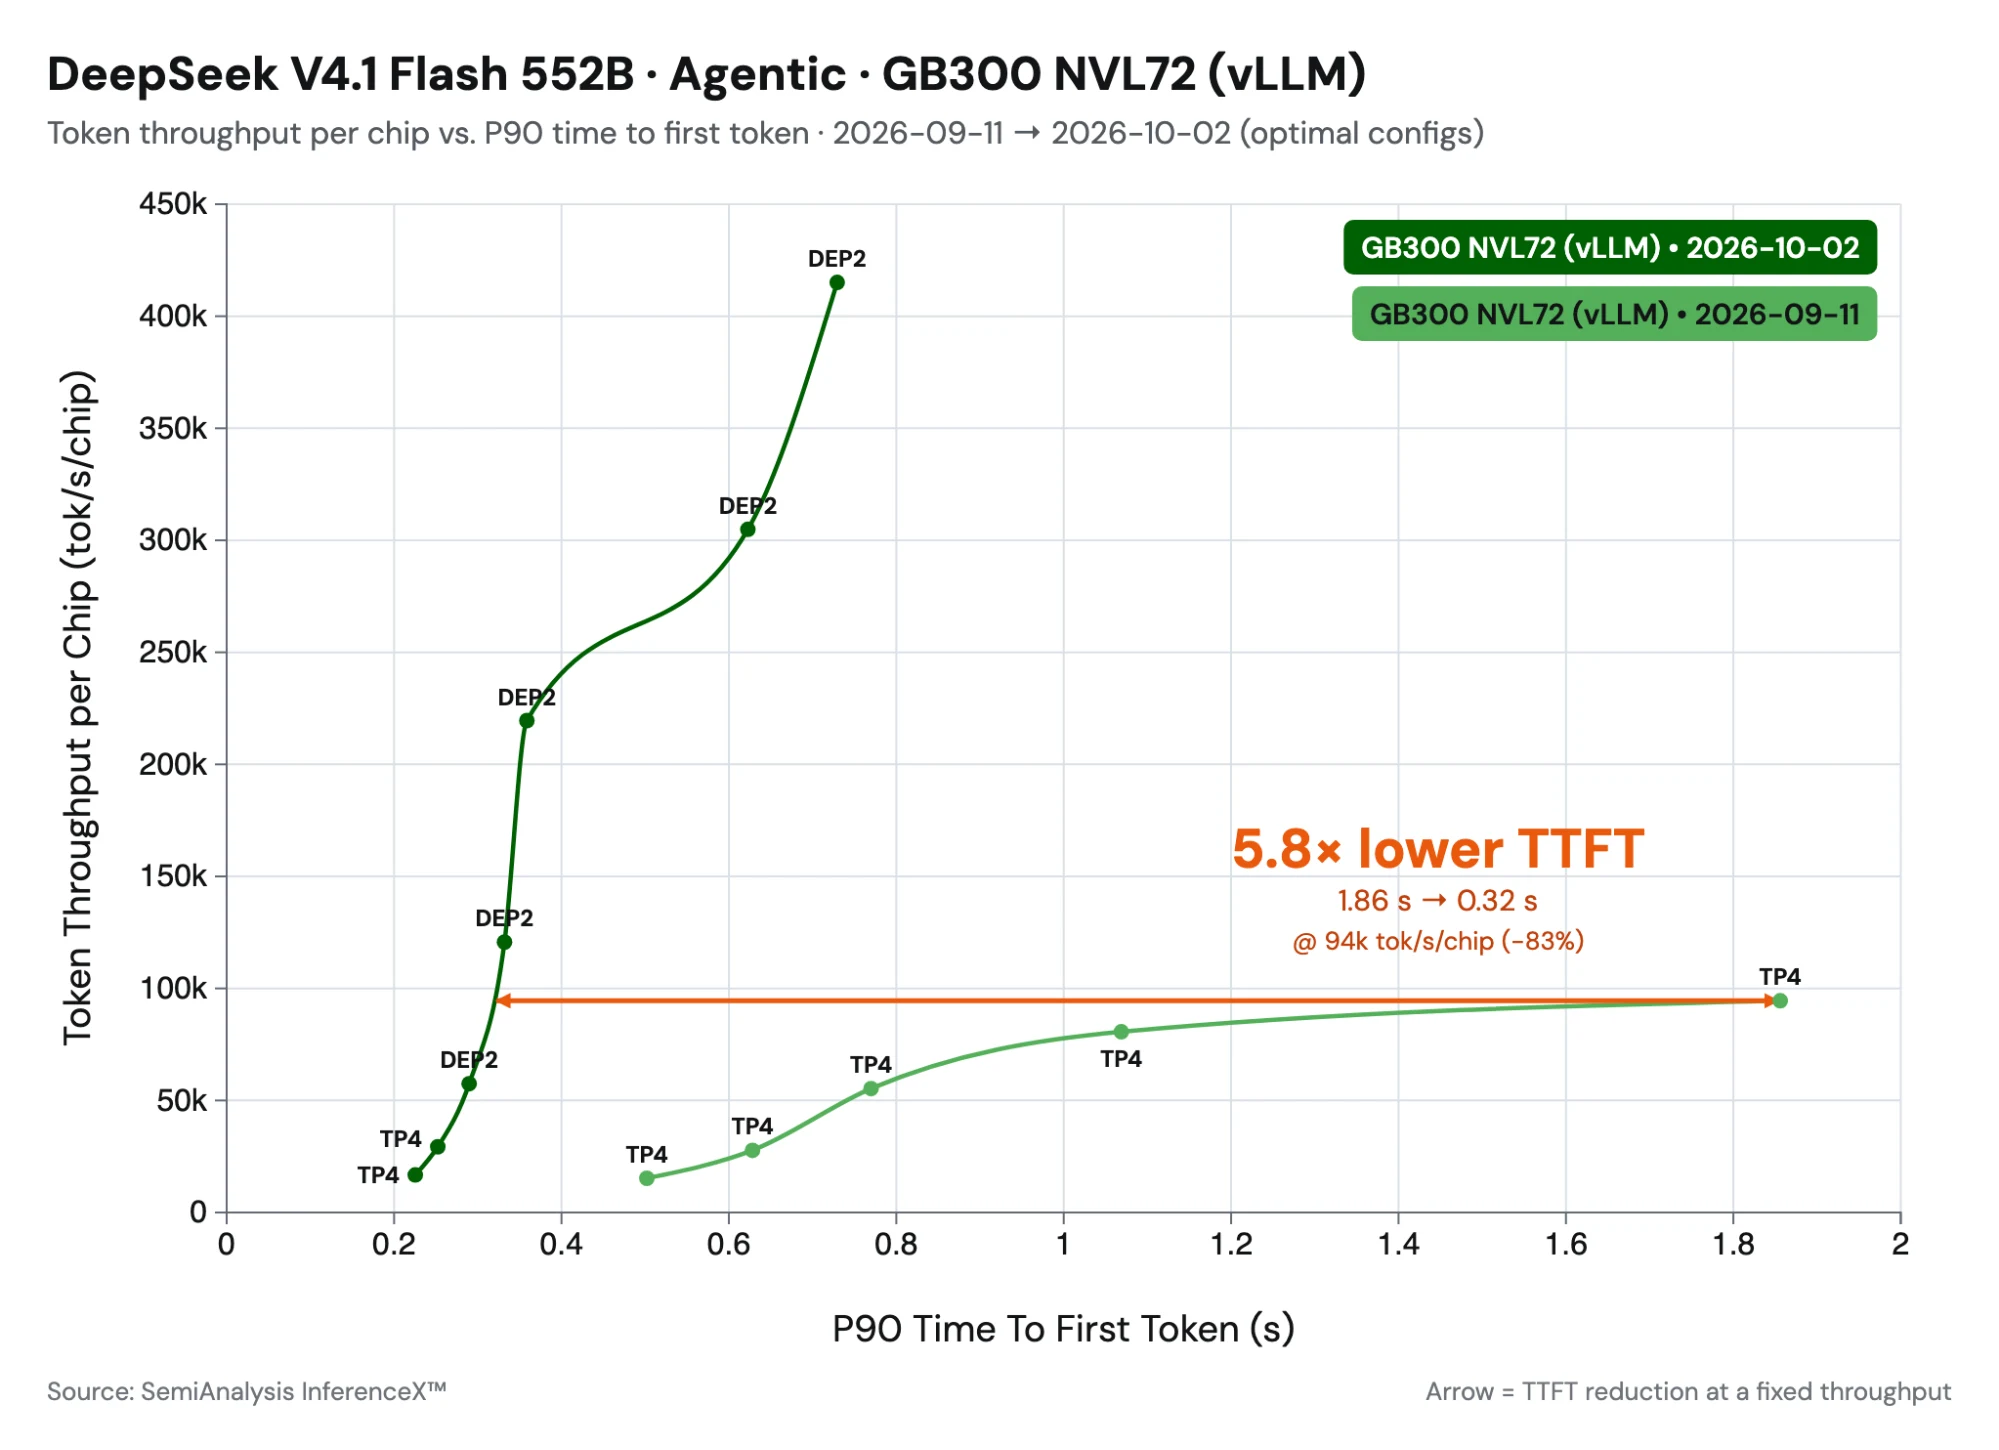
图 7 展示了优化后的 TTFT–吞吐量权衡。在约 100K 吞吐量下,通过三项优化相结合,TTFT 降低了近 70%:
-
SWA bounded replay 让模型的上半部分只处理最后 128 个 token,将 prefill 计算量大约减半。
-
CUDA graphs 使裁剪后的小规模 replay 在 GPU 上保持快速,而不是受限于 CPU 内核启动,因此我们实现了全部的加速效果。
-
内核改进加速了模型计算。
致谢
我们感谢 DeepSeek 开源 DeepSeek-V4.1-Flash 及相关内核,感谢 Inferact 团队完成最初的模型部署和优化,感谢 NVIDIA 的协作与支持,以及 SemiAnalysis 提供 AgentX 基准测试。