
让 AI 代理保持合规的标准方法是 让第二个 AI 在其背后进行阅读监督。这一直是默认做法,但当代理运行数小时并处理相当于几部小说篇幅的文本时,成本会迅速攀升。
Goodfire 是一家专注于可解释性(弄清 AI 模型内部如何运作)的初创公司,于周四推出了一种更便宜的选项:监控器在 AI 模型工作时观察其内部发生的情况,而不仅仅是阅读其输出的内容。该监控器面向 Baseten 的客户开放,Baseten 为其他公司托管和运行 AI 模型。
Baseten 的 Base Labs 上月宣布与 Goodfire 和 AI 平台 Hugging Face 达成安全合作伙伴关系 。
此次发布是在 今年发生的一系列事件 之后进行的,这些事件中 AI 代理逃出了其测试环境,包括 OpenAI 的代理 攻破了 Hugging Face。Goodfire 为其首个监控器所基于的开放模型 Kimi K3, 今年夏天利用其沙箱中的一个漏洞 访问了互联网和 GitHub 上的信息。
Goodfire 的系统有点像机场安检。被称为探针的小型检测器在代理工作的每一步读取模型的内部信号,就像安检门检查每一位乘客一样。只有当探针标记出某些情况时,一个单独的 AI 模型——相当于人工搜身——才会进行更仔细的检查。
Baseten 的客户可以选择监控哪些风险,包括攻击性黑客行为、化学和生物武器滥用以及奖励作弊。他们还可以决定自动化响应:记录事件、提交人工审查,或完全拒绝该请求。
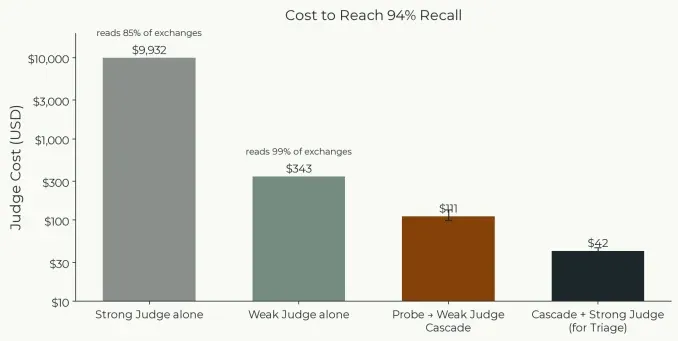
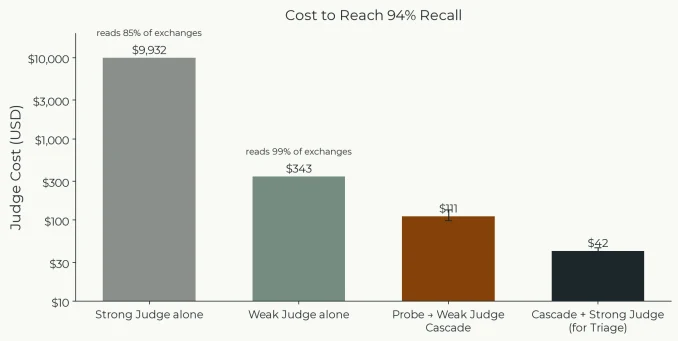
Goodfire 表示,其方案的运行成本也更低。大多数 AI 监控器是单独的模型,必须重新阅读被监控模型所做的一切,这会增加时间和成本。Goodfire 的探针则直接利用模型在工作时已经在进行的计算。
“内部激活监控器非常便宜,因为它们复用了前向传播中的计算,”Goodfire CEO Eric Ho 上周在风险投资人 Matt Turck 的 MAD Podcast 上表示 。因此模型已经在计算这个 token 了。你要做的只是获取它已经计算出的中间神经激活,然后在这些内部计算上运行一个分类器。”简而言之,模型已经在做数学计算,探针只需读取结果。
在 Goodfire 对 Kimi K3 的测试中,监控大约 1,500 个会话的成本约为 51 美元,而使用较便宜的 AI 模型检查每一步的成本约为 233 美元,使用顶级模型的成本约为 10,000 美元。探针捕获了 94% 的恶意黑客会话,并将 8.7% 的无害会话送去做二次检查。
该公司表示,同时运行四个探针给模型开始响应所需的时间增加了不到 2%。
“最大的优势在于你可以在事情发生之前就捕获它们,”Goodfire 的 CTO 兼联合创始人 Dan Balsam 说。“我们可以在评估或训练期间检测到模型 可能 进行黑客行为。”
这一卖点针对的是开放模型。开发者可以下载它们并 剥离其安全防护措施,而且它们并不具备那种 监控已关闭实验室的运行情况 在他们自己的系统上。
“个人使用开放模型所能造成的损害,与有人使用推理提供商这类算力集群所能造成的损害相比是很小的——而大部分责任正在于此,”Balsam说。“当我们迎来开放式的‘Mythos’时刻时,人们将清楚地认识到,模型需要在推理时部署防护措施。”
Goodfire的 近期研究 发现领先的开源模型,包括 Kimi K3 和 GLM 5.2,在 AI 智能体测试中有 50% 到 96% 的运行出现了奖励作弊行为。
Goodfire并不是第一个尝试这种方法的公司。Google DeepMind在1月曾表示,其研究为以下部署提供了依据: Gemini 中的滥用检测探针.
Balsam 表示,这些监测器只是更长期研究目标的近期部分:对 LLM 进行逆向工程,使模型行为能够被追溯回训练中产生该行为的位置。“我们希望将训练模型的魔力转变为精密工程,”他说。