
核心要点
- AI Search 现在支持用户基于对轨迹的语义理解来查找对话,例如“用户是否感到沮丧?”或“PII 是否泄露?”
- 用平实的语言描述一种行为,一个快速决策模型会读取轨迹并返回发生该行为的轨迹。
- LangSmith 使用 轨迹 来规范化轨迹、减少上下文膨胀并快速返回查询结果。
代理 轨迹 规模庞大、多模态且信息密集。它们捕捉用户输入、代理如何响应以及逻辑失败等关键细节。这使轨迹对于理解用户行为和提升代理性能极具价值,但传统的数据平台并非为如此庞大、非结构化的负载而构建。
要让轨迹数据发挥作用,团队需要能够支持完整生命周期的基础设施:摄取和存储高流量的运行记录、灵活查询轨迹,并将其转化为用于调试、产品分析以及标注等运营工作流的视图。这就是我们构建 SmithDB 的原因,它是专为 LangSmith中的轨迹数据打造的数据库,最近还推出了 Custom Apps,让团队能够在其轨迹之上创建定制的视图。
今天,我们推出 AI Search,一种使用自然语言查询轨迹的新方式。
我们为什么构建 AI Search
每条轨迹都包含用户输入、代理推理、工具调用和响应,这些都是理解代理在哪些方面表现良好、在哪些方面失败所需的全部信息。使用 LangSmith 的团队常常挖掘他们的代理轨迹,以便为评估 数据集 发现示例,或为 标注队列.
中的审阅者寻找对话。然而,找到合适的轨迹可能很繁琐。诸如“PII 是否泄露?”或“用户是否感到沮丧?”这类问题并不能干净地映射到标签或元数据等单一轨迹属性上,也无法通过全文搜索来回答。它们需要对轨迹内容的理解。在此之前,这意味着需要提前设置评估器或手动翻阅轨迹。
这就是我们构建 AI Search 的原因。你描述你正在寻找的行为,LangSmith 返回发生该行为的轨迹。这让你能够找到大海捞针般的轨迹,并临时搜索棘手的模式。
你可以搜索什么
你可以搜索轨迹内容中出现的任何东西。你可能会查找声称完成了任务但实际没有完成的代理、似乎感到沮丧或对答案提出异议的用户、向模型的请求中泄露了 PII 的情况,或有人试图取消订阅。产品团队可以搜索“对我们不支持的集成的请求”、“提及竞争对手”或“用户对入门流程感到困惑”,并以用户自己的话看到产品的不足之处。
AI Search 还可以与你已经使用的过滤器配合使用,因此搜索可以仅在出错的轨迹上运行,或仅针对特定标签运行。
我们如何构建它
为什么需要模型读取每条轨迹
向量搜索是按含义而非精确词语进行搜索的常用方法。它将你的查询和每条轨迹转换为嵌入(embedding),即捕捉文本主题的简短数字列表。然后它返回嵌入与你的查询最接近的轨迹。这对于主题搜索很有效,例如查找关于账单的对话。但嵌入将整条轨迹压缩成一个小向量,这种压缩是有损的。与你的查询相关的重要细节可能丢失。代理成功完成工作的轨迹与它只是声称完成的轨迹,最终可能得到几乎相同的嵌入。区分它们需要一个模型来阅读轨迹的实际文字并结合你的问题,从而推理出实际发生了什么。
直到最近,在搜索时这样做仍然太慢、太昂贵。快速决策模型改变了这一点。它们以足够快、足够便宜的方式回答关于输入的一个狭窄问题,从而能够大规模运行。AI Search 将决策模型推理与 SmithDB结合,SmithDB 是我们用于智能体可观测性的数据层。随着追踪数据的到达,SmithDB 将其转换为轨迹。当你执行搜索时,你的过滤器会缩小候选范围,然后决策模型针对你的描述检查每一条剩余的轨迹。
追踪数据庞大且格式多样
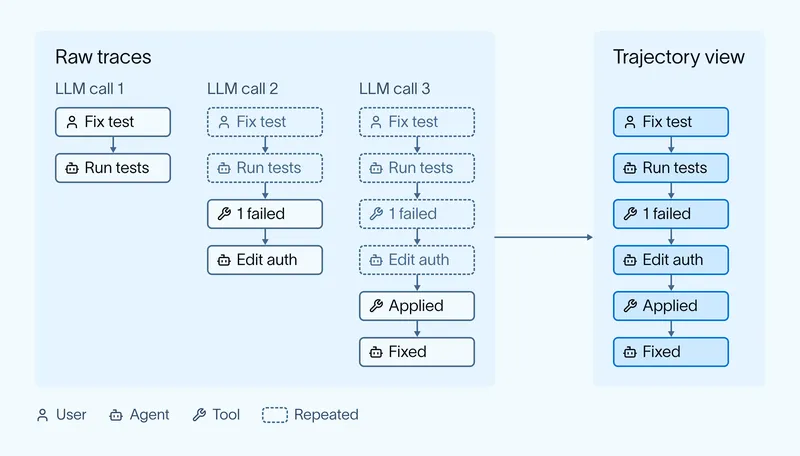
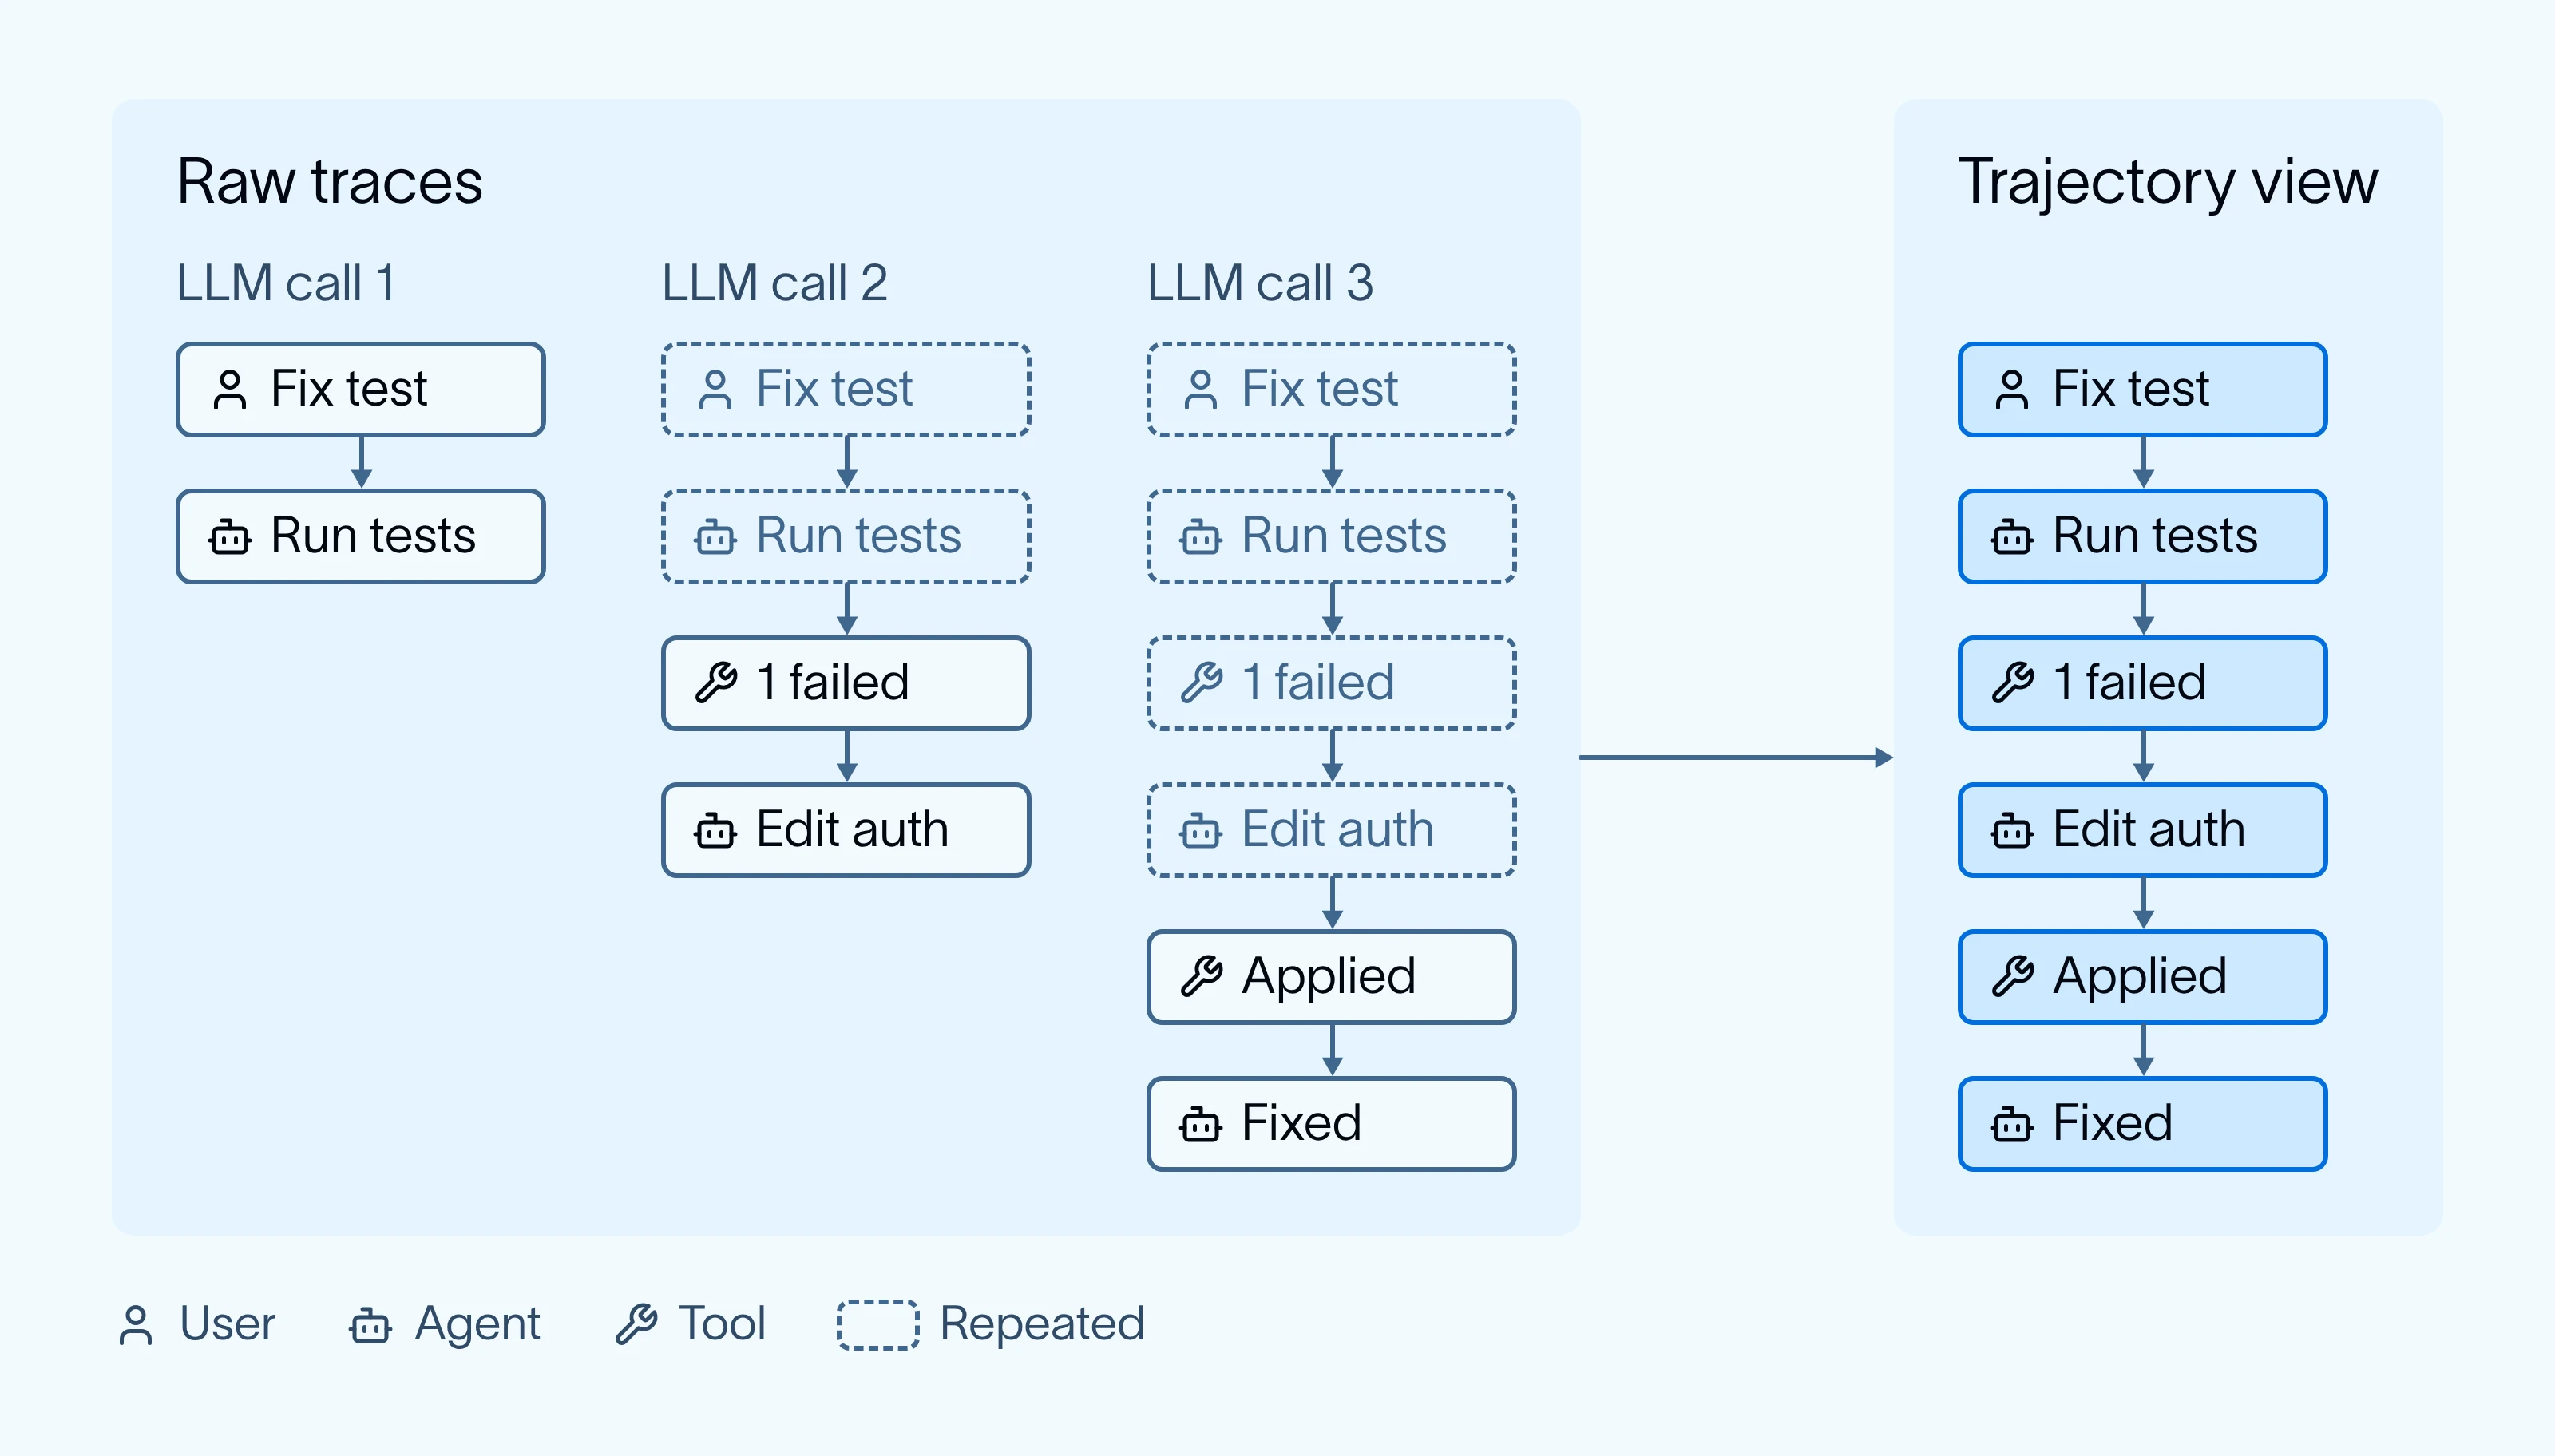
追踪数据来自许多来源:OpenAI 和 Anthropic SDK、LangChain、LangGraph、Vercel AI SDK、OpenTelemetry 等等。每一种对消息的记录方式都略有不同。追踪数据还存在重复。智能体通常在每次 LLM 调用时重新发送对话历史,因此第一条消息会在其后的每一次调用中再次出现。
SmithDB 将这些追踪数据转换为每个会话的 轨迹 。轨迹是对智能体工作的精炼视图:每条消息、每次工具调用和每个工具结果,各列出一次。SmithDB 在追踪数据到达时构建轨迹,并将所有受支持的格式转换为相同的结构。
AI 搜索分析的是轨迹而非原始记录。由于每种格式都具有相同的轨迹结构,一次搜索即可覆盖基于不同 SDK 构建的智能体。去除重复消息可以减少上下文膨胀,从而使搜索运行得更快。轨迹还涵盖整个会话,因此如果你搜索“用户尝试取消”,模型会看到用户询问了什么、智能体做了什么,以及对话是如何结束的。
轨迹仍然很长
去除重复数据有所帮助,但智能体轨迹仍然很长。为了直观了解其长度,我们从随机抽样的 150 段对话中 Open SWE(LangChain 团队每天都在使用的开源编码智能体)中抽取了 150 个随机对话样本。每个任务都在自己的沙箱中运行,拥有 shell 访问权限,并可以把工作交给子智能体,因此对话会变得很大。
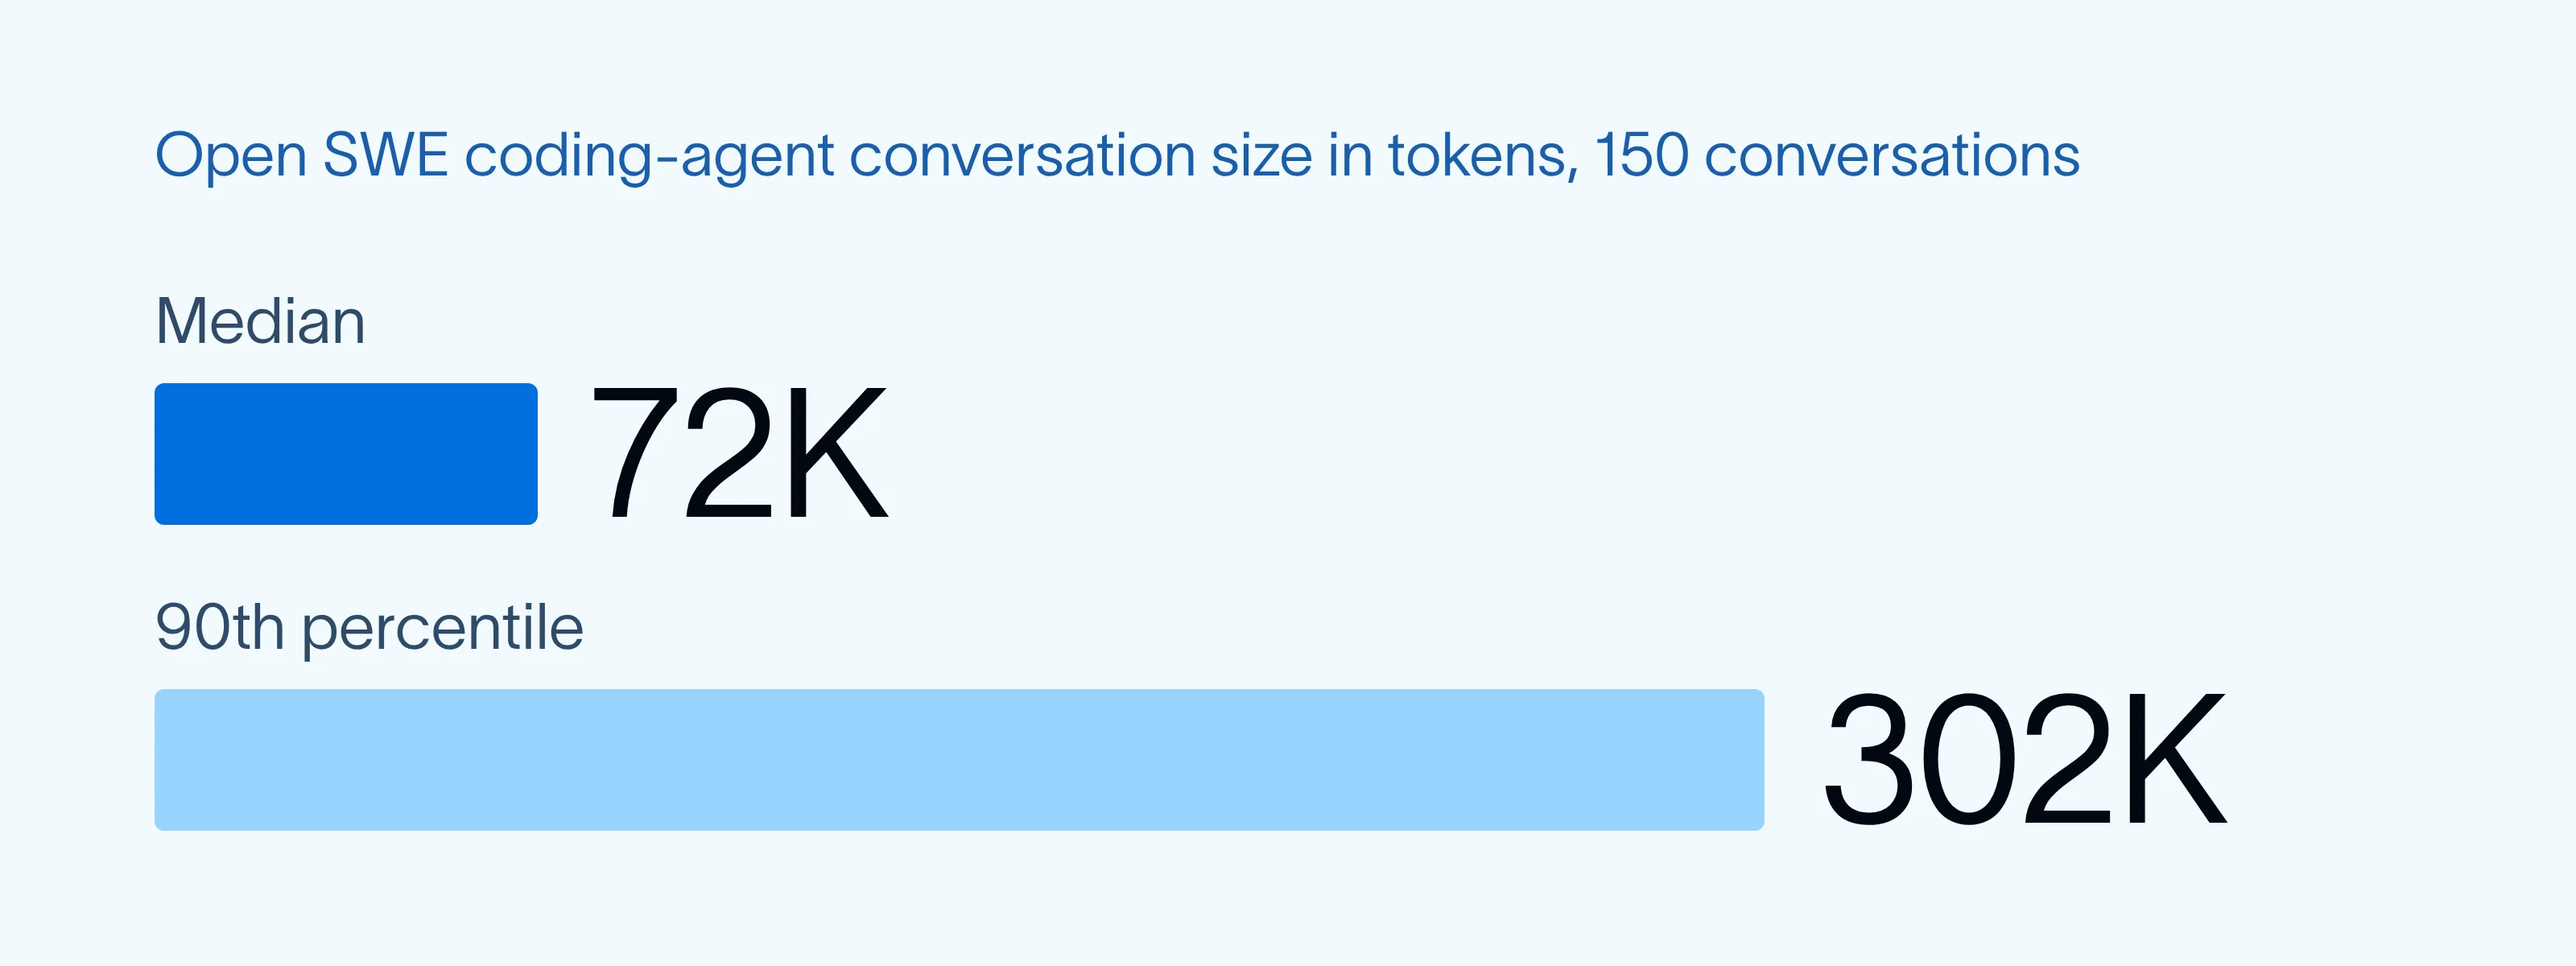
即使样本这么小,其中也有几个对话超过了一百万 token。搜索罕见行为意味着要阅读大量对话,因此 AI Search 经常遇到这种规模的对话,无法读取每一个 token。
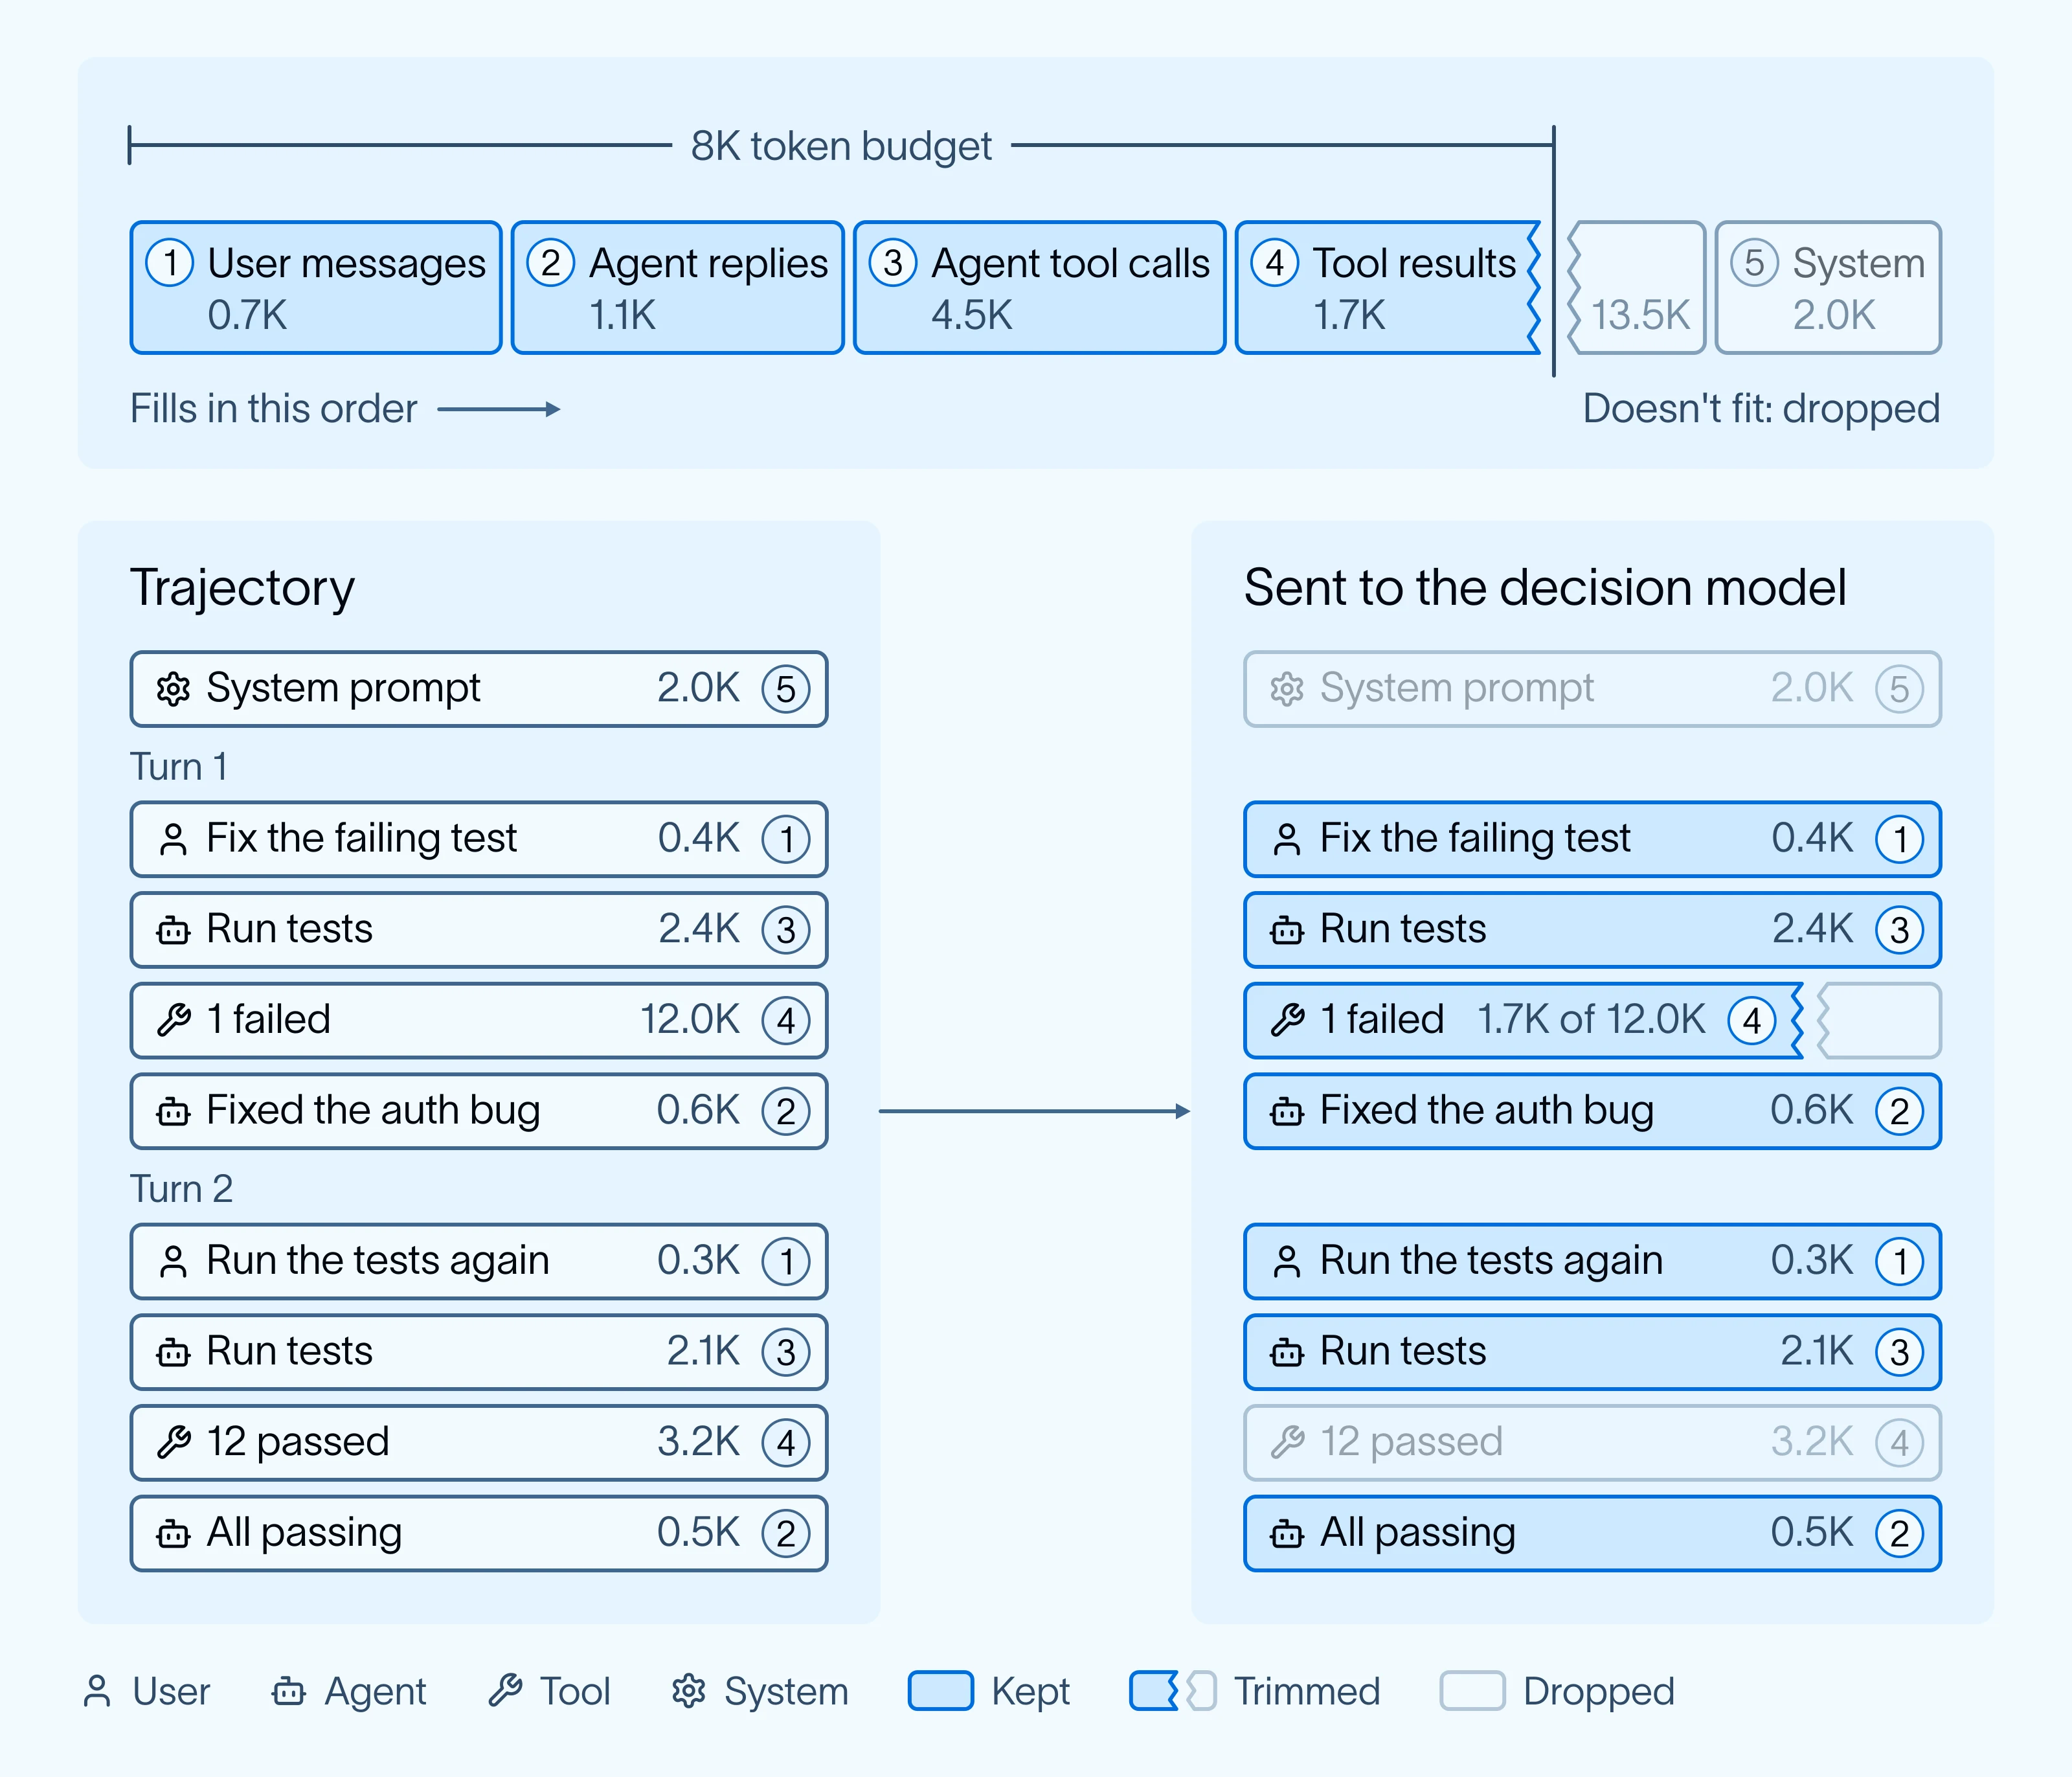
不过,大多数问题并不需要所有这些 token。许多问题是关于用户问了什么以及智能体如何回答的。在对话的中位数水平上,其 72K token 中约有 2K 来自用户消息和智能体的回复。约 85% 是工具输出,主要是文件读取和 shell 命令。
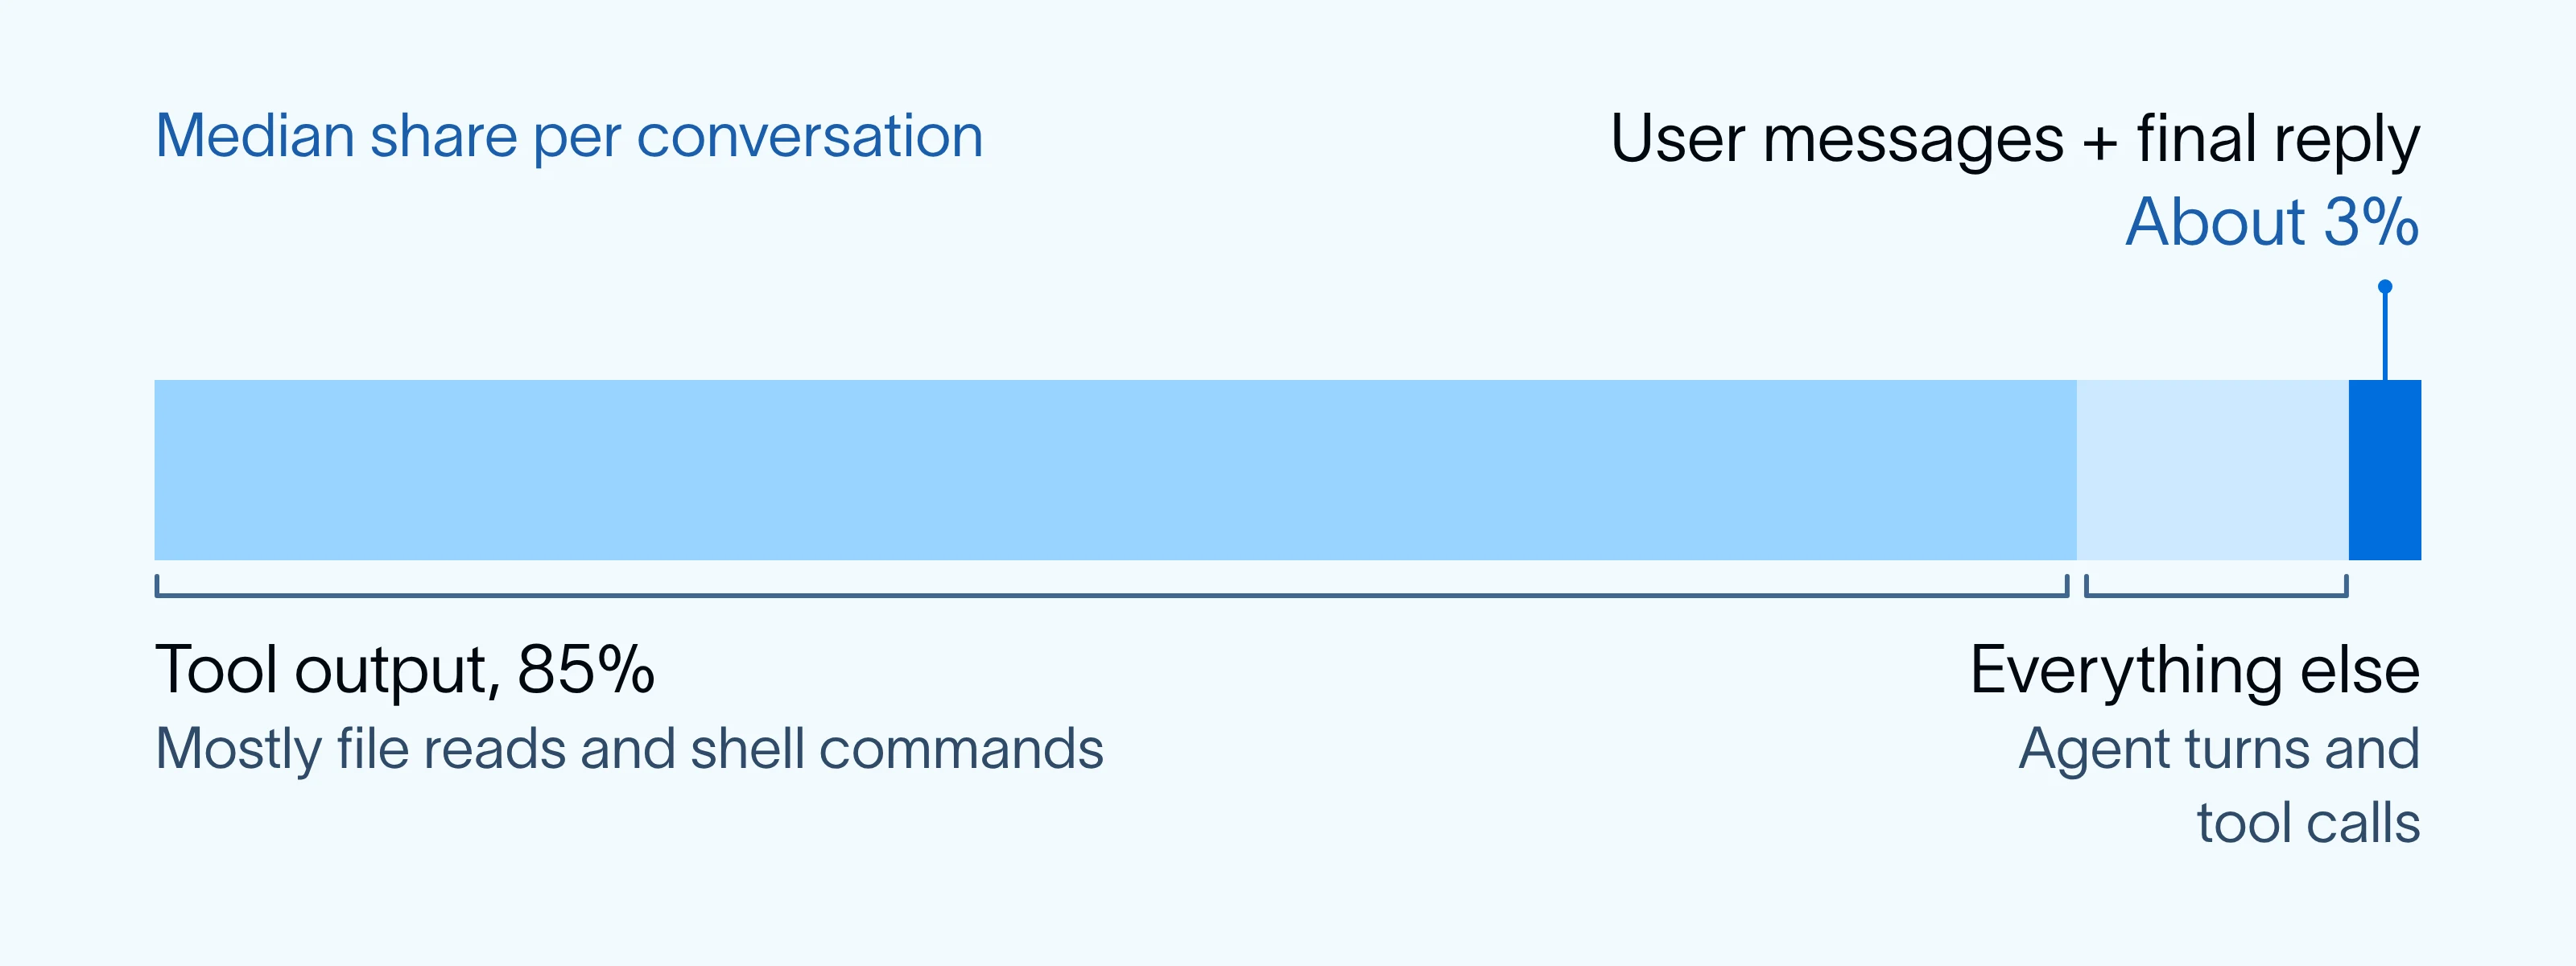
每条轨迹都有一个固定的 token 预算,按优先顺序填充。用户消息和智能体对用户的回复优先放入。其余预算分配给其他所有内容:中间 AI 消息(智能体的推理和工具调用)、工具结果和系统消息。如果下一条消息只能部分放入预算,它会被截断以填满预算,其后所有内容都会被丢弃。
搜索必须在大规模下保持快速
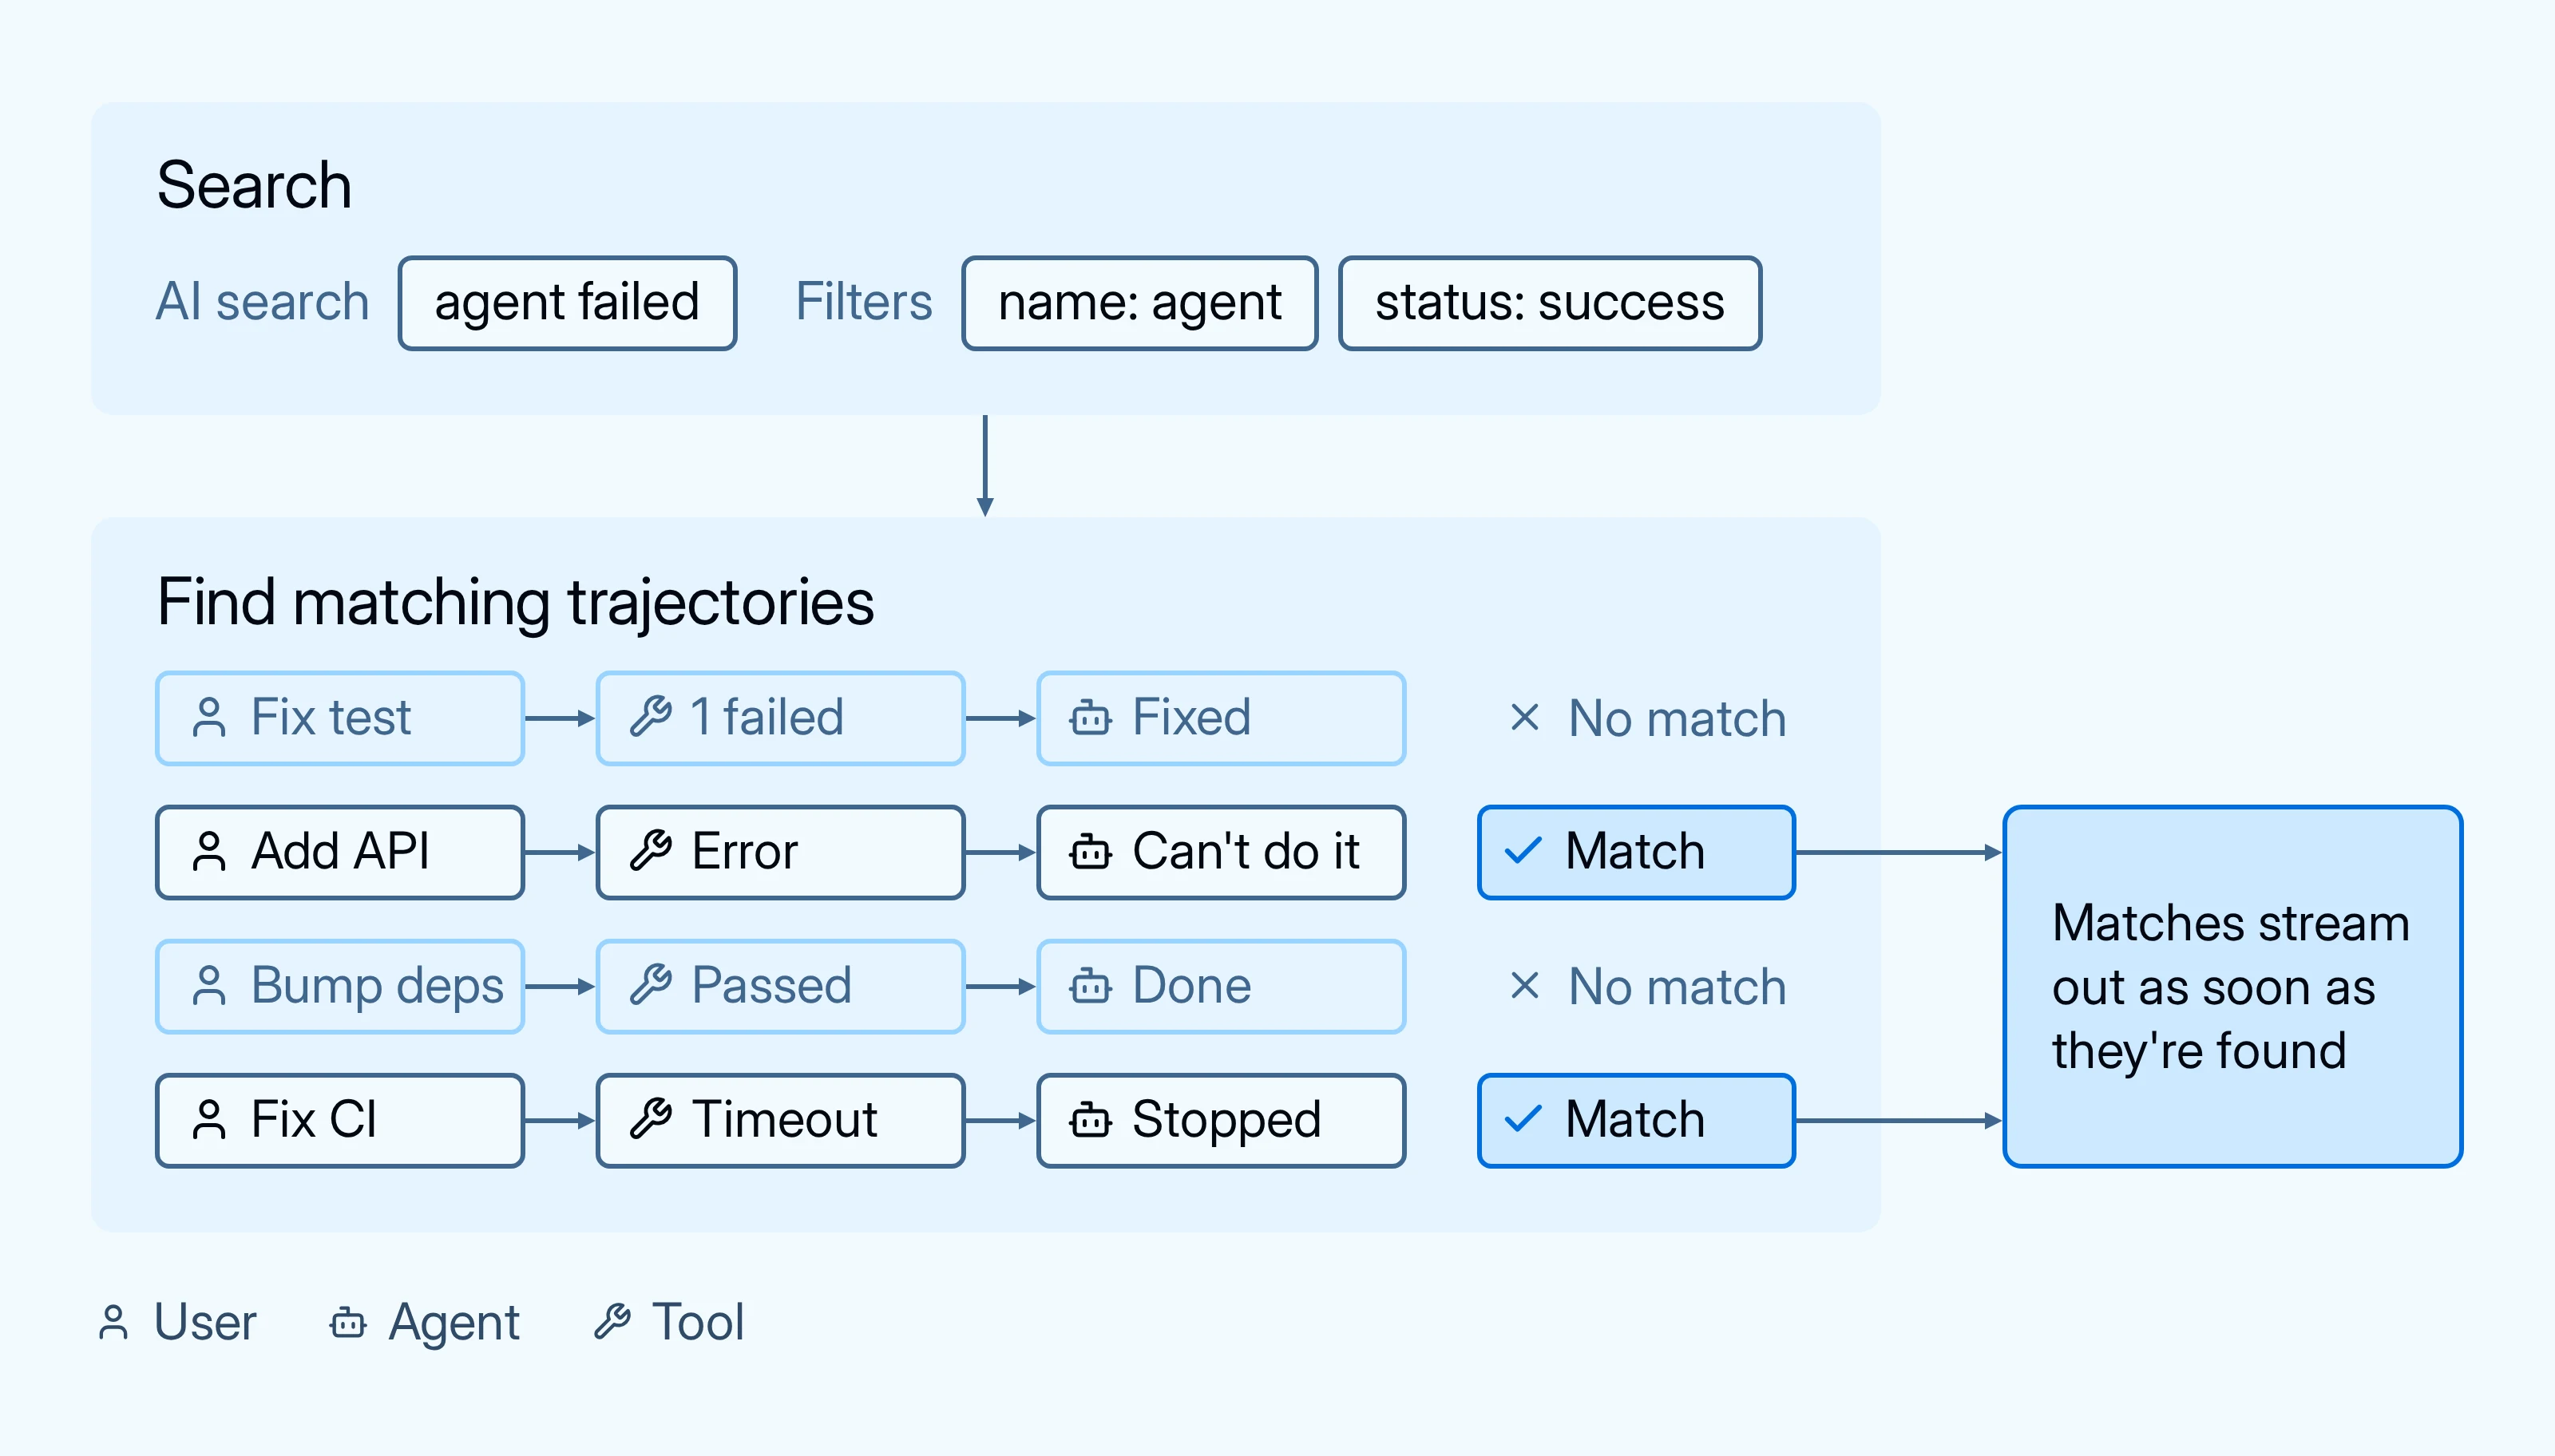
SmithDB 的构建目标是为大量智能体追踪数据的摄取和扫描而设计。当你运行搜索时,你的结构化过滤器首先缩小候选范围。然后决策模型将剩余的每条轨迹与你的描述进行比对,许多比对是并行进行的。当模型检查一批轨迹时,SmithDB 已经在获取和准备下一批。匹配结果一经发现就会流式返回,因此你无需等待完整扫描。
下一步
我们仍在了解人们最常问哪些问题。最难分类的是那些差异微妙的对话。区分“用户放弃了”和“用户得到了所需的东西然后离开”,可能取决于长轨迹中的几个回合。我们想看看在轨迹上微调过的模型能否更可靠地区分它们。
当答案能在用户和智能体的对话内容中找到时,token 预算运行良好。其他问题需要不同的证据。智能体忽略工具错误只会出现在工具结果中。我们正在探索根据问题选择上下文的方法,以及显示模型何时不确定的信号,以便它能带着更多上下文进行第二轮处理。
我们还希望通过将相似结果分组或总结它们的共同点,超越简单的匹配列表。
开始使用
AI Search 目前在 LangSmith Cloud 的 GCP US、EU 和 APAC 区域处于公开测试阶段,无需额外费用。组织管理员可以在设置中开启它,之后它会显示在追踪页面上。 AI Search 文档 有详细信息。欢迎告诉我们你搜索了什么。