
混合专家(MoE)是一种稀疏激活架构,它在保持每 token 计算量较低的同时扩展大语言模型(LLM)的容量。由于 MoE 运算占总计算时间的很大一部分,其中的低效会直接抬高请求延迟和成本。因此,通过内核工程优化 MoE 运算是获得性能提升的最大机会。
融合 MoE 是 MoE 架构的一项关键优化技术。融合 MoE 系统将 token 路由、数据重排和专门的神经网络计算合并为 GPU 上的单个批处理操作。这取代了将路由和专家计算作为独立、顺序循环操作来执行的方式。虽然这带来了延迟优势,但也带来了内核实现和调试能力方面的复杂性。该架构要实现高 GPU 利用率需要针对特定硬件的优化。
在这篇文章中,我们介绍我们为融合 MoE 模型实现的各种内核优化,并向您展示您如何从这项工作中受益。我们使用了一个具有代表性的 MoE 模型作为主要示例。
用于提升 WGMMA 利用率的 Swap-AB
为了最大化张量处理吞吐量,NVIDIA Hopper 架构依赖 Warp Group Matrix Multiply Accumulate(WGMMA)指令协议,该协议在一个由 128 个线程组成的协作 warp 组上集体执行。这种操作数不对称本质上是指令集架构(ISA)层面的属性。在底层的 wgmma.mma_async 汇编定义中,硬件将矩阵行维度(M)固定为 64 的恒定规模,以定义其并行线程映射拓扑。列维度(N)则保持高度可变。操作数 A 严格映射到这个固定的 M 维度(使用寄存器或共享内存),而操作数 B 映射到可变的 N 维度(通过共享内存描述符)。因此这些操作数槽位在结构上是不可互换的。 consequently,峰值硬件 tile 利用率由这些刚性的形状编码决定,要求 M 维度等于或大于 64,以防止计算执行通道闲置。
这种结构偏好源于 Hopper Tensor Core 划分内存块的方式。硬件对第一个操作数的主体维度强制一个固定的最小布局形状,将块高度精确锁定为 64(M=64)。当一个数学矩阵在这个主要槽位上拥有较大的连续主体维度时,Hopper 的内部硬件调度器可以干净地在物理计算网格上映射和分发数据。
这种结构不对称在 MoE 网络的解码阶段成为严重的性能瓶颈。在标准 MoE 层中,管理专家计算的线性代数使用传统矩阵记号表述:
A[M,K] x B[K,N] —> C[M,N]
其中(M)表示 token 行数(或批大小),(K)表示隐藏特征维度,(N)表示庞大的专家输出维度。
在解码阶段,系统每次只处理每个用户序列中的一个 token。因此批空间或 token 行大小非常单薄,通常降至(M < 64)的形态,且经常降至单行(M = 1)。在这种标准结构布局下:
矩阵(A)变成一个细碎的水平向量(例如 1 x 4096)。
矩阵(B)(核心专家权重)仍是一个大型密集的纵向块(例如 4096 x 8192)。
由于行数(M)极小,矩阵(A)在物理上无法填满硬件为操作数 A 固定的(64)行布局桶。当 WGMMA 指令在此布局上执行时,它使物理 Tensor Core 容量的很大一部分完全处于饥饿状态。硅片花费时钟周期处理空的空间槽位,导致硬件利用率低下。
在标准的稠密 LLM 层中,权重矩阵是静态、统一且完全连续的。然而在 MoE 层中,工作负载被分散到一组独立的子网络(专家)中。这造成了独特的内存和布局瓶颈,使其对 Hopper GPU 的 WGMMA 约束高度敏感。在标准稠密层中,矩阵乘法将一个 token 向量与单个层权重矩阵相乘。输出维度(N)是模型的隐藏层大小(例如 4096)。
在融合 MoE 内核中,GPU 不只是与一个专家相乘。它同时对所有活跃专家进行分组并执行计算,以避免为每个专家单独启动内核。对于标准稠密层,N 是隐藏层大小(4,096)。对于融合 MoE 层,N 是所选专家数量乘以专家中间维度大小。对于一个运行 topk=8 例行程序的模型,融合内核内的有效 N 维度会膨胀到数万或数十万个参数。由于 N 维度相对于极小的解码 token 大小(M=1)大得不成比例,布局不对称变得极端。转置矩阵将这个庞大的组合 MoE 维度移入主要槽位,释放出标准稠密层无法企及规模的硬件预取能力。
为了在不改变模型底层数学完整性的情况下解决这种硬件错位,我们利用了矩阵转置的代数特性:
BT[N,K] x AT[K,M] —> CT[N,M]
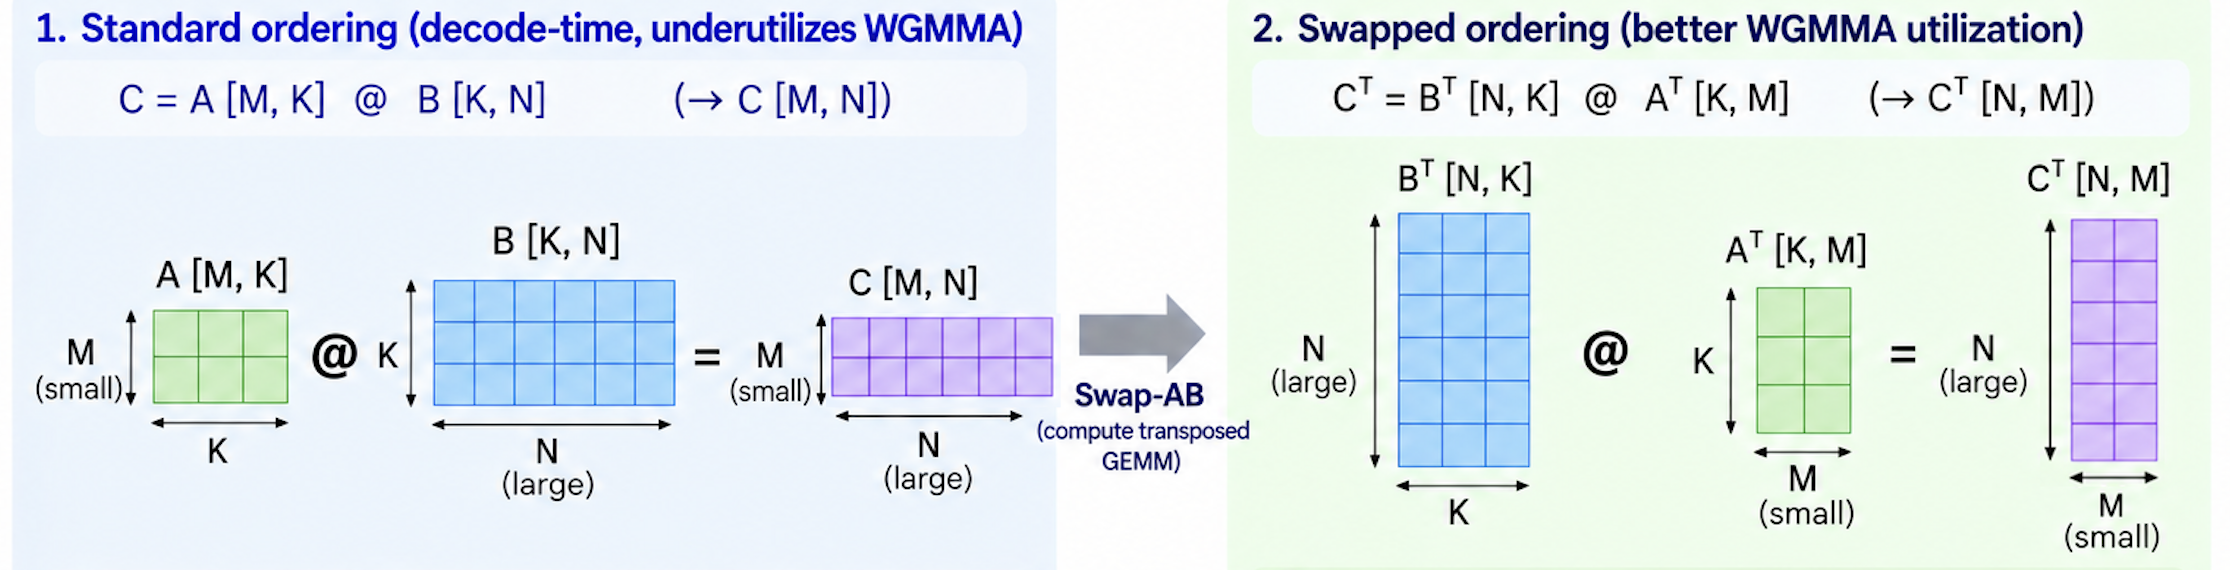
图 1:用于提升 WGMMA 利用率的 Swap-AB
通过在矩阵乘法到达 PTX 汇编层之前以编程方式对其进行翻转,我们将软件重新对齐以精确匹配 Hopper 芯片的拓扑结构。这种转置在 GPU 上触发了两个直接的架构优势。首先,它使物理布局达到饱和。庞大的专家维度 (N = 8192) 被提升到第一个操作数位置 (BT),由于 (N) 很大,它轻松填满了硬件强制要求的 (64) 行阈值。Tensor Core 随后以最大的局部密度运行,没有浪费的执行周期。其次,它激活了异步预取。Hopper 专用的硬件拷贝引擎可以在数学执行块启动之前,异步地将内存地址从共享内存直接预取到寄存器中。将连续的大权重块 (BT) 放在首位插槽,使这些引擎能够平滑地追踪数据布局,并在无需 CPU 干预的情况下保持计算管线饱和。这在 H200 上的大规模 MoE 模型中带来了 2-4% 的端到端输出吞吐量提升。我们已将此优化上游贡献至 vLLM,版本 0.24.0 或更高版本中可用。
FP8 张量量化的后端路由选择
除了内核内部之外,选择哪个后端来执行 MoE 计算对性能有很大影响。vLLM 的 MoE oracle 将不同的量化方案路由到 Triton、FlashInfer+CUTLASS 或其他后端。性能分析显示,对于 Hopper 上的 FP8 张量量化模型,Triton 后端始终优于默认 FLASHINFER_CUTLASS 路径。
Triton 后端在低并发 MoE 工作负载中优于 CUTLASS,主要是因为它用自定义的算子级寄存器融合取代了僵化的框架级矩阵数学配置。CUTLASS 依赖标准的 C++ 模板结构,将 FP8 张量缩放、矩阵乘法和专家聚合视为离散的数学操作。Triton 后端则将整个管线合并为单次硬件处理。数据从全局高带宽内存 (HBM) 中仅被读取一次,并完全在 GPU 超快的本地 SRAM 寄存器和计算执行单元内处理,然后流回最终的矩阵目标位置。这消除了拖累 CUTLASS 的缓慢全局 VRAM 读写往返——后者被迫不断执行中间张量缩放步骤。
此外,这种寄存器级融合专门搭配了围绕可变 token 分桶设计的动态调度布局,解决了传统编译模板中的一个严重结构缺陷。CUTLASS 原生针对稠密、大且可预测的矩阵维度进行了优化。当它遇到实时解码生成阶段典型的流动、极瘦的批次配置(M < 64 或 M = 1)时,其默认的分块平铺和线程映射结构会变得非常低效,导致严重的 warp 利用不足或昂贵的内存填充开销。相反,Triton MoE 后端擅长将这些细小、碎片化的 token 数组动态映射到活动专家权重的物理边界上。即使在极低批次大小下处理高度不稳定的负载,也能使硬件内部的预取流和 Tensor Core 管线保持完全饱和。
更新路由策略是一项纯粹的配置更改,未修改任何内核代码。尽管如此,它仍然带来了 H200 上 FP8 量化融合 MoE 模型 10% 的端到端吞吐量提升 在 H200 上适用于 FP8 量化融合 MoE 模型。该改进已在 AWS Large Model Inference (LMI) v28 容器中提供。
消除 Triton JIT 重新编译
GPU 推理中最具影响的性能问题之一也是最不显眼的:不必要的内核重新编译。Triton 是 vLLM 许多自定义内核所依赖的编译器框架,它默认对整数参数进行特化。每当内核以一个之前未见过值被调用时,Triton 就会触发一次全新的即时 (JIT) 编译。在序列长度和批次大小持续变化的服务工作负载中,这会产生源源不断的编译开销,从而推高延迟,尤其是首 token 时间 (TTFT)。
在 MoE 模型服务中, _fused_inv_rope_fp8_quant_per_head 内核(负责融合旋转位置编码和 FP8 量化)在每次出现新的 num_tokens 值时都会重新编译。为可变长度参数添加 do_not_specialize 注解完全消除了这些重新编译,在 8 路张量并行下使 H200 上的 TTFT 提升了 9% 在 H200 上以 8 路张量并行运行(PR #42849)。
在多 GPU 集群中,所有 8 个 GPU 必须以微秒级精度完美同步地执行其内核。如果哪怕只有一个 GPU 因其本地 token 批次数变化而必须停下来重新编译其本地 _fused_inv_rope_fp8_quant_per_head 内核,其他七个 GPU 就会闲置等待。通过消除整个集群范围内的重新编译,我们平滑了多 GPU 协调开销,使用户的初始响应延迟获得了 9% 的加速。这里的原则是将编译器视为一等优化对象。理解 Triton 的特化语义,并识别参数何时是死的或可变的,能够以最小的代码改动解锁延迟改进。
我们已将此优化上游贡献至 vLLM,版本 0.22.0 或更高版本中可用。
结论
通过与 vLLM 社区的合作,我们实现并开源了多项针对 fused MoE 模型的内核优化。我们在 Amazon SageMaker AI 的 LMI Deep Learning Container 中应用了这些优化。这些优化合计带来了高达 10% 的吞吐量提升和高达 9% 的 TTFT 缩短。要开始使用自定义模型托管,请参阅 Amazon SageMaker AI 托管文档.