
本文与来自 ShipStation Global 的 Kenneth Salmon、Edward Boswell、Jack Armstrong、Robert Bahn 和 Nick Ciubotariu 共同撰写。
回答同样的 IT 问题并清理常规工单,消耗了 IT 团队本可以花在其他地方的时间。为了找回这些时间,ShipStation Global 工程团队构建了 Deckhand,一个面向 Slack 的 AI 驱动 IT 帮助台代理,其构建平台为 Amazon Bedrock AgentCore.
ShipStation Global 是面向中小型发货商的领先智能运输和物流平台,其运营基于一个简单的信念:团队越高效,就能为客户提供越好的交付服务。Deckhand 将这一信念付诸实践。它从一个精心整理的知识库中回答日常 IT 和公司问题,读取错误消息截图,并创建和更新 Jira Service Management 工单。
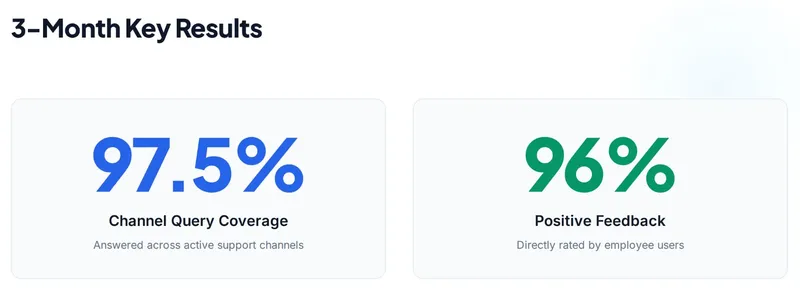
在本文中,我们讨论 ShipStation 如何架构 Deckhand,最终解决了 97.5% 的传入频道提问,同时获得员工 96% 的正面反馈评分(图 1)。
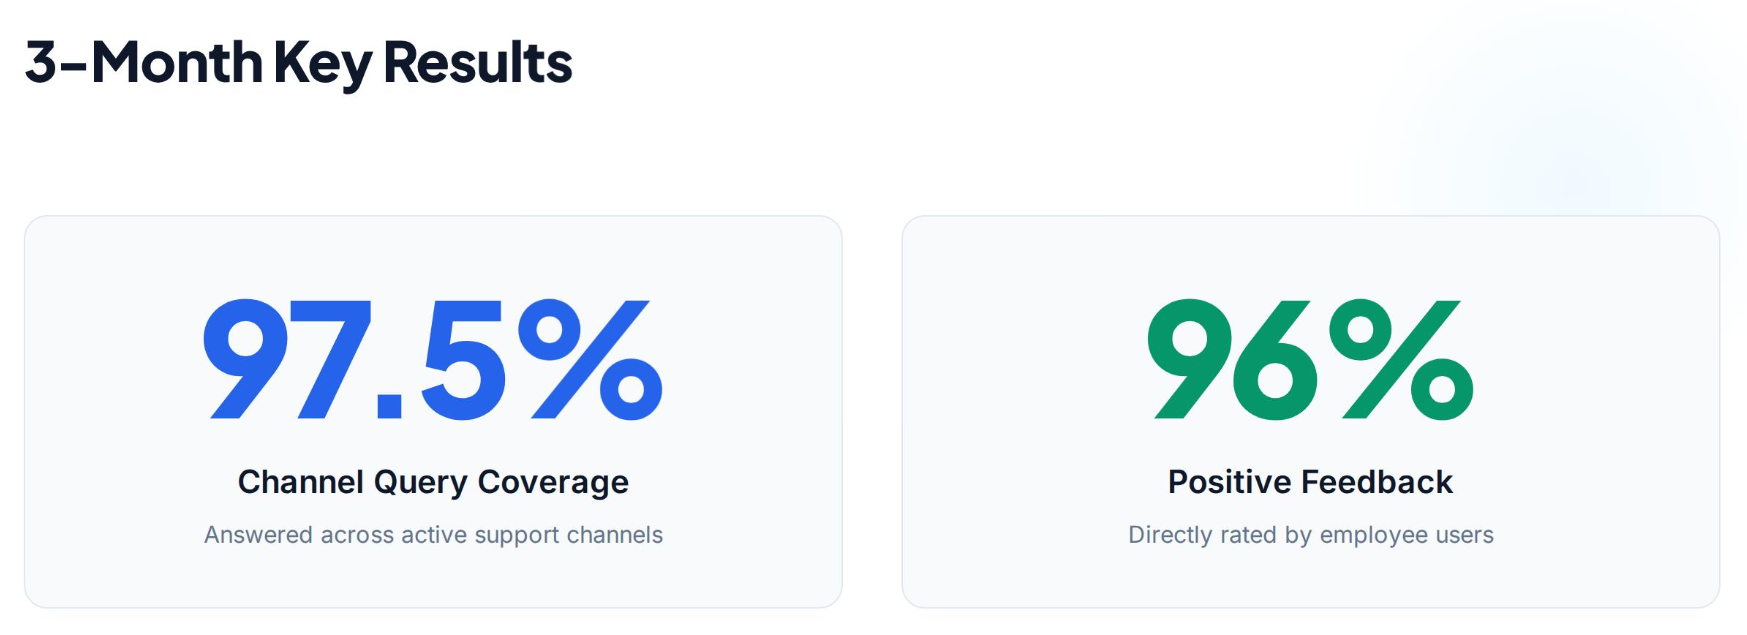
图 1:3 个月内的频道覆盖率和正面反馈
业务挑战
Deckhand 解决的问题是每个 IT 团队都熟悉的:同样的问题被反复提出,错误消息在下班后发布,信息需要从不同团队收集。在 ShipStation Global,这些对话发生在一个繁忙的帮助台 Slack 频道中,员工提问,IT 一个接一个地回复。答案通常已经存在于某篇 Confluence 操作指南、公司内网页面,或八个月前的某个帖子中。难的是找到它们。
频道数据使这个规模变得具体。在上线前的 12 个月内:
- 员工发布了超过 1,500 个帖子,而且数量持续增长。
- 由于员工分布在美国、英国、西班牙、波兰、澳大利亚和菲律宾,超过五分之一的问题在美国工作时间之外提出。
- 答案分散在不同的地方:Confluence 文章、内网页面和 PDF、IT 维护的指南,以及频道自身的历史记录。
- 重复的问题消耗了本可以由结构化自助步骤处理的时间。
“我们创建 Deckhand 是因为获取帮助应该像在 Slack 中提一个问题一样简单,而不是去破解一张工单表单,或者把邮件发进虚空。我们相信,工单是运营摩擦而非生产力的体现。Deckhand 能当场解决常见问题;当它无法解决时,只需一键即可将对话转换为具有完整上下文的工单,从而改善员工体验,并将我们的团队从无休止地重复‘请提交工单’这句话中解放出来。”
—— Chris Collins,ShipStation Global IT 高级总监
解决方案概述
Deckhand 在 Slack 中的工作方式就像任何一位队友一样——加入频道、阅读对话,并从 Slack 个人资料中获取上下文来就地回答 IT 问题。我们在 Amazon Bedrock AgentCore 上运行它,这是一个可以使用任意框架或模型来大规模构建、连接和优化代理的平台。AgentCore runtime 是 Amazon Bedrock AgentCore 的一项功能,它在隔离的会话中托管代理,因此我们不需要运行任何服务器或容器。
该解决方案有四个主要组件,如图 2 所示:
- Slack 服务: 一个基于 FastAPI 和 Slack Bolt 的应用程序,托管在 AWS App Runner上。它接收 Slack 事件,决定机器人是否应回复,并根据请求者的 Slack 个人资料构建用户上下文有效负载,包括姓名、电子邮件、时区和经理。
- 代理服务: 一个 Strands 代理,以容器形式部署在 Amazon Bedrock AgentCore runtime上,使用 Anthropic 的 Claude 管理多轮工具代理循环, Amazon Bedrock.
- 工具与知识: 一个单一的 AWS Lambda 函数,通过 AgentCore Gateway(Amazon Bedrock AgentCore 的一项功能)以模型上下文协议(MCP)工具的形式对外提供,负责对请求进行分类、创建和更新 Jira 工单,以及分析图像。一个 Amazon Bedrock 知识库 对来自 Confluence、公司内网、Slack 和营销页面的内容建立索引,并将其存储在 Amazon Simple Storage Service (Amazon S3).
- 运维与反馈。 Amazon DynamoDB 存储反馈, AWS X-Ray 使用 OpenTelemetry 追踪请求路径,各服务将日志写入 Amazon CloudWatch.
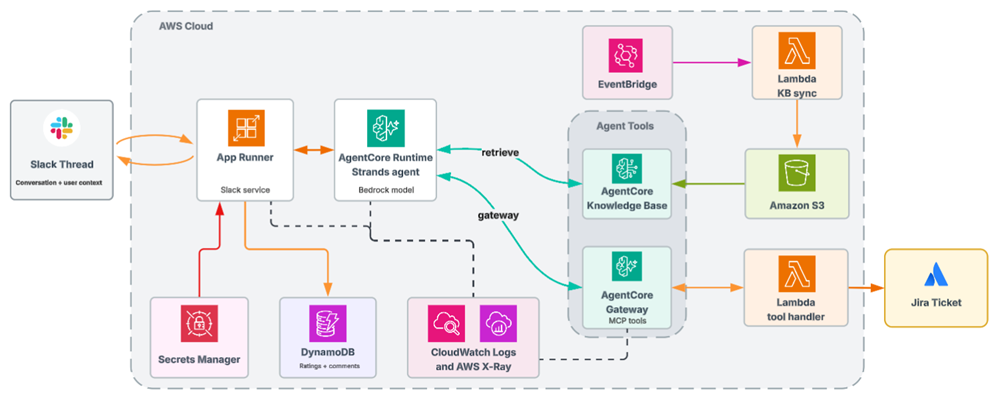
图 2:架构图,显示 Slack 事件进入 Slack 服务和 Amazon Bedrock AgentCore runtime,并分别连接到 Amazon Bedrock 知识库、由 AgentCore Gateway 支持的 Lambda 工具、Jira Service Management 和 DynamoDB 反馈。
当员工在 Deckhand 所属的频道中发帖时,Slack 服务会整理完整的会话线程历史和用户上下文,然后通过 AgentCore runtime API 调用智能体。智能体搜索知识库并按需调用工具。找到答案时,它会返回最终回复(图 3);找不到时,它会提出澄清性问题或提议创建工单(图 4)。
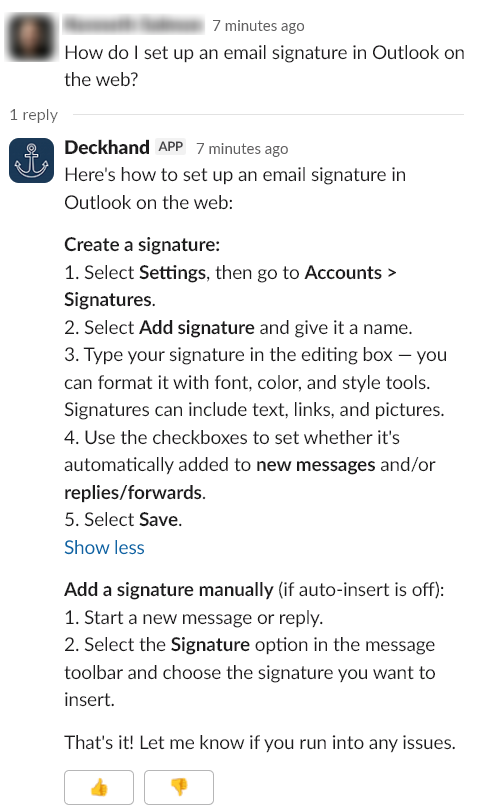
图 3:Deckhand 以自助操作步骤进行回复
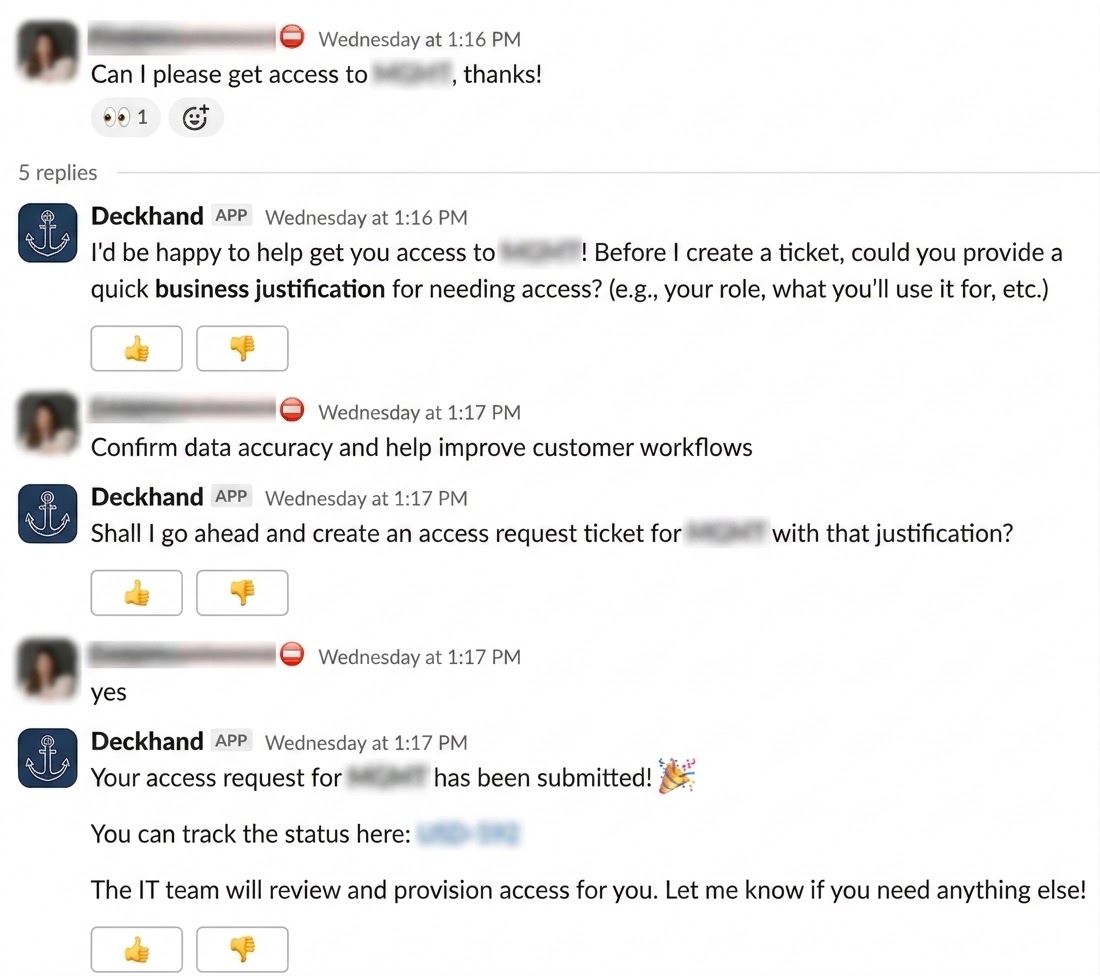
图 4:Deckhand 提议创建工单
Deckhand 工作流
本节将逐步介绍 Deckhand 的实现过程,从前置条件到可运行的部署。
前置条件
要实现此模式,您需要以下内容:
- 一个可访问 Amazon Bedrock、AgentCore runtime 和 AgentCore Gateway 的 AWS 账户。
- 一个启用了事件订阅的 Slack 应用,包含签名密钥和按您的使用场景限定权限的机器人令牌。
- 一个容器镜像仓库,例如 Amazon Elastic Container Registry(Amazon ECR)。
- 一个 Amazon S3 存储桶和一个 Amazon Bedrock 知识库。
- 为每个 runtime 和工具限定权限的 AWS Identity and Access Management(IAM)角色,以及用于第三方凭据的 AWS Secrets Manager 条目。
使用 Strands Agents 和 AgentCore 构建智能体
该智能体刻意保持轻量。使用开源的 Strands Agents SDK,一个智能体由模型、一组工具和一个系统提示词组成。该 SDK 管理推理循环,让模型选择工具、处理结果并迭代,直到产出答案。Deckhand 的智能体服务仅用几行 Python 代码实现。
from strands import Agent
from strands.models import BedrockModel
from strands.tools.mcp import MCPClient
from strands_tools import retrieve
from mcp.client.streamable_http import streamablehttp_client

model = BedrockModel(
    model_id=MODEL_ID,
    max_tokens=2048,
    temperature=0.3,
)

gateway = MCPClient(lambda: streamablehttp_client(url=GATEWAY_URL))

agent = Agent(
    model=model,
    tools=[gateway, retrieve],
    system_prompt=SYSTEM_PROMPT,
)
模型 ID 通过环境变量设置,因此无需修改应用代码即可切换模型。
工具以两种方式与智能体集成。Amazon Bedrock Knowledge Bases 检索是 Strands 原生工具,只需一次导入即可支持知识库搜索。其他功能,包括分类、工单管理、用户解析和图像分析,则由注册在 AgentCore Gateway 上的 Lambda 函数处理。该 Gateway 将这些功能作为 MCP 工具暴露,Lambda 按工具名称路由每次调用。这种分离使工具逻辑可以独立更新,智能体无需重新构建即可访问 Gateway 上的新工具。
AgentCore runtime 以容器形式托管智能体,免去服务器和会话管理的需要。Slack 服务针对每条消息同步调用智能体,提供线程转录和用户上下文,并发布最终回复。由于包括员工资料在内的上下文随每次请求一并传入,智能体可以自动补全工单详情。
知识库设计与答案路由
Deckhand 从一个包含核心 S3 支持数据源的 Amazon Bedrock 知识库中获取答案:
- 从 Confluence 同步的文章。
- 从公司内网同步的内部页面、PDF 和活动。
- 从 Slack 中挖掘的已解决支持会话线程(下一节介绍)。
每个文档都包含标题、来源 URL、内容类型和活动日期等元数据。这使得智能体能够过滤内容,例如当用户询问 Austin 办公室即将举行的活动或每周午餐菜单时。
用递归语言模型(RLM)挖掘 Slack 历史记录
最有价值的数据源是已解决支持线程的存档。在 Deckhand 出现之前,Slack 是问题得到解决的地方:多年来员工描述问题,IT 人员引导他们完成修复。这段历史是一个有机的知识库,由最好的审核者——问题得到解决的人——进行验证。但它也很嘈杂:原始导出内容混杂了闲聊、自动警报以及从未真正解决的线程。索引一个未经核实的修复方法或一段乱糟糟的摘要,意味着知识库会以与正确答案相同的置信度呈现错误答案,因此提取必须精确。
挖掘过程遵循三阶段流水线(图5):
- 一个脚本通过 Slack API 导出频道的完整历史记录,获取每个线程的所有回复,并写入包含线程标记、时间戳和回复数量的结构化转储文件。
- DSPy 的递归语言模型(RLM)在 Amazon Bedrock 上运行 Claude,将该导出内容视为沙箱化 Python 读取-求值-打印循环(REPL)内可导航的记忆空间,而不是单个提示。它通过迭代处理数据,将每个线程分类为已解决、未解决或已升级,并过滤掉公告和非问题内容。严格的标准保证了质量:只有当完整、可行的修复方法在线程本身中清晰可见时,该线程才被算作已解决。
- 对于每个已解决的讨论串,RLM 编排递归的子 LLM(大语言模型)调用,以提取结构化字段,每个字段都通过 Pydantic 模型进行验证。这些字段包括问题摘要、原始问题和解决方案。它们还捕获修复是自助式还是需要提交工单、自助步骤、所涉及的应用和系统、错误消息以及标签。当子 LLM 调用返回的内容不符合 schema 时,RLM 基于代码的循环会在解释器中捕获该验证错误并重试。结果以按问题组织的 markdown 文档形式写入。该流水线将其上传到 Amazon S3,供知识库进行索引。
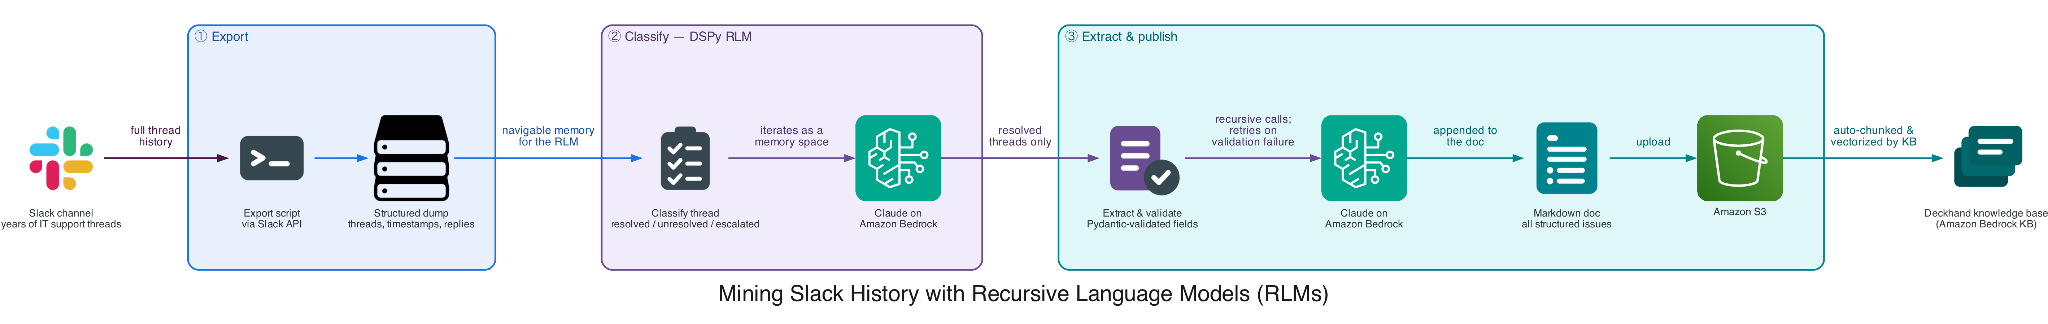
图 5:Slack 对话的导出分类和提取工作流
我们选择 RLM 是因为它将整个 Slack 历史记录保存在一个持久化的沙箱变量空间中,从而允许对导出内容进行迭代推理并保持一致的输出结构。这样一来,当员工遇到同事 previously 解决过的问题时,Deckhand 能提供已被验证有效的解决方案,通常以可执行的编号步骤形式呈现。
知道何时不回答
共享频道中的 AI 机器人在技术失效之前,往往先在社交层面失效。Deckhand 最精细的逻辑就是决定何时保持沉默:
- 智能体对每条消息的第一个判断是:它是一条公告、一条社交消息,还是人与人之间的对话。如果是,则输出“SKIP”,Slack 服务将抑制回复。
- 在讨论串中,它只回复原始发帖人。
- 如果最后一条回复来自另一位人工帮助者,它就保持沉默,因为已经有人接管了。
- 如果一条回复以 @提及某个人开头,那么该消息不是发给机器人的。
收集反馈
每个回答都包含反馈按钮。点赞会被直接记录,而点踩则会提示填写一个简短的“出了什么问题”字段。评分连同原始问题和机器人的回答一起存储在 DynamoDB 中。
负面反馈是一个有价值的数据集,用于改进系统提示词和智能体行为,以及更新知识库中不正确的信息。
安全与验证
提示词规则可以增强行为,但不能取代访问控制。执行通过代码和基础设施来管理:
- 创建工单需要明确确认。当 Deckhand 提出要创建工单时,Slack 服务会添加一个 Create Ticket 按钮,选择它即通过智能体发送确认。工单更新只接受符合服务台项目模式的有效键,并拒绝空评论。
- 分类在执行操作前经过验证。请求分类作为单独的 Amazon Bedrock Converse API 调用运行,返回结构化的工单字段,在任何内容到达 Jira 之前先用 Pydantic 进行验证。
- 图像工具被限制为只能从 Slack 的文件主机下载。它使用机器人令牌进行身份验证,将每个请求限制为最多五张、每张不超过 5 MB 的图像,并通过 Converse API 将文件发送给视觉模型。
- 凭据不放在代码中。Slack 令牌、签名密钥和 Jira 凭据存放在 AWS Secrets Manager中,并且每个服务和工具都在其自己的作用域化 IAM 角色下运行。
- 提示词强制执行行为安全防护:绝不请求密码或多因素身份验证(MFA)码,绝不在工单评论中写入凭据,绝不暴露用于工单字段的个人资料元数据。
成果
Deckhand 于 2026 年 4 月上线。它从每天约 30 条消息起步,到初夏时达到每天多达 100 条。在最初的 3 个月里,它处理了 1,935 条消息,启动了 1,221 次智能体对话,并创建了 409 个 Jira 工单。它回复了 97.5% 的消息。三分之一的问题是在下班后提出的,那时 IT 团队没有人在工作,而 Deckhand 回答了其中 94% 的问题。原本要等到第二天早上的人当晚就得到了答案。
随着团队的改进,反馈不断提升。在他们修订系统提示词和知识库以解决用户抱怨的问题后,好评率从 4 月的 82% 上升到 6 月的 96%。
最显著的成果是工单分流。一次智能体对话指的是一个本可以变成 Jira 工单的问题。在 1,221 次对话中,只有 409 次变成了工单。其余的 812 次在聊天中得到了处理。提交一个工单然后处理并关闭它大约需要 30 分钟。这 812 次对话在 3 个月里累计节省约 406 小时,或每年约 1,600 小时。员工把这段时间留给了自己的工作,而 IT 也无需将其耗费在工单受理上。
结论
Deckhand 将重复的 IT 问题从员工的事务中移除,把时间还给了员工和 IT 团队。它之所以有效,是因为技术栈的每个部分都只有一个职责,并作为托管服务运行:AgentCore runtime 托管代理,AgentCore Gateway 将 Lambda 函数转换为代理可调用的 MCP 工具,而 Amazon Bedrock Knowledge Bases 负责检索。团队无需搭建服务器或维护编排代码就交付了它。
要构建类似的解决方案,请从一个维护良好的知识源和一个明确定义的操作开始。请参考 Amazon Bedrock AgentCore 文档 和 Strands Agents SDK 进行智能体开发,并参考 Amazon Bedrock Knowledge Bases 文档 来连接内容源。
如需讨论适用于贵组织的智能体 AI 用例,请联系您的 AWS 客户团队。