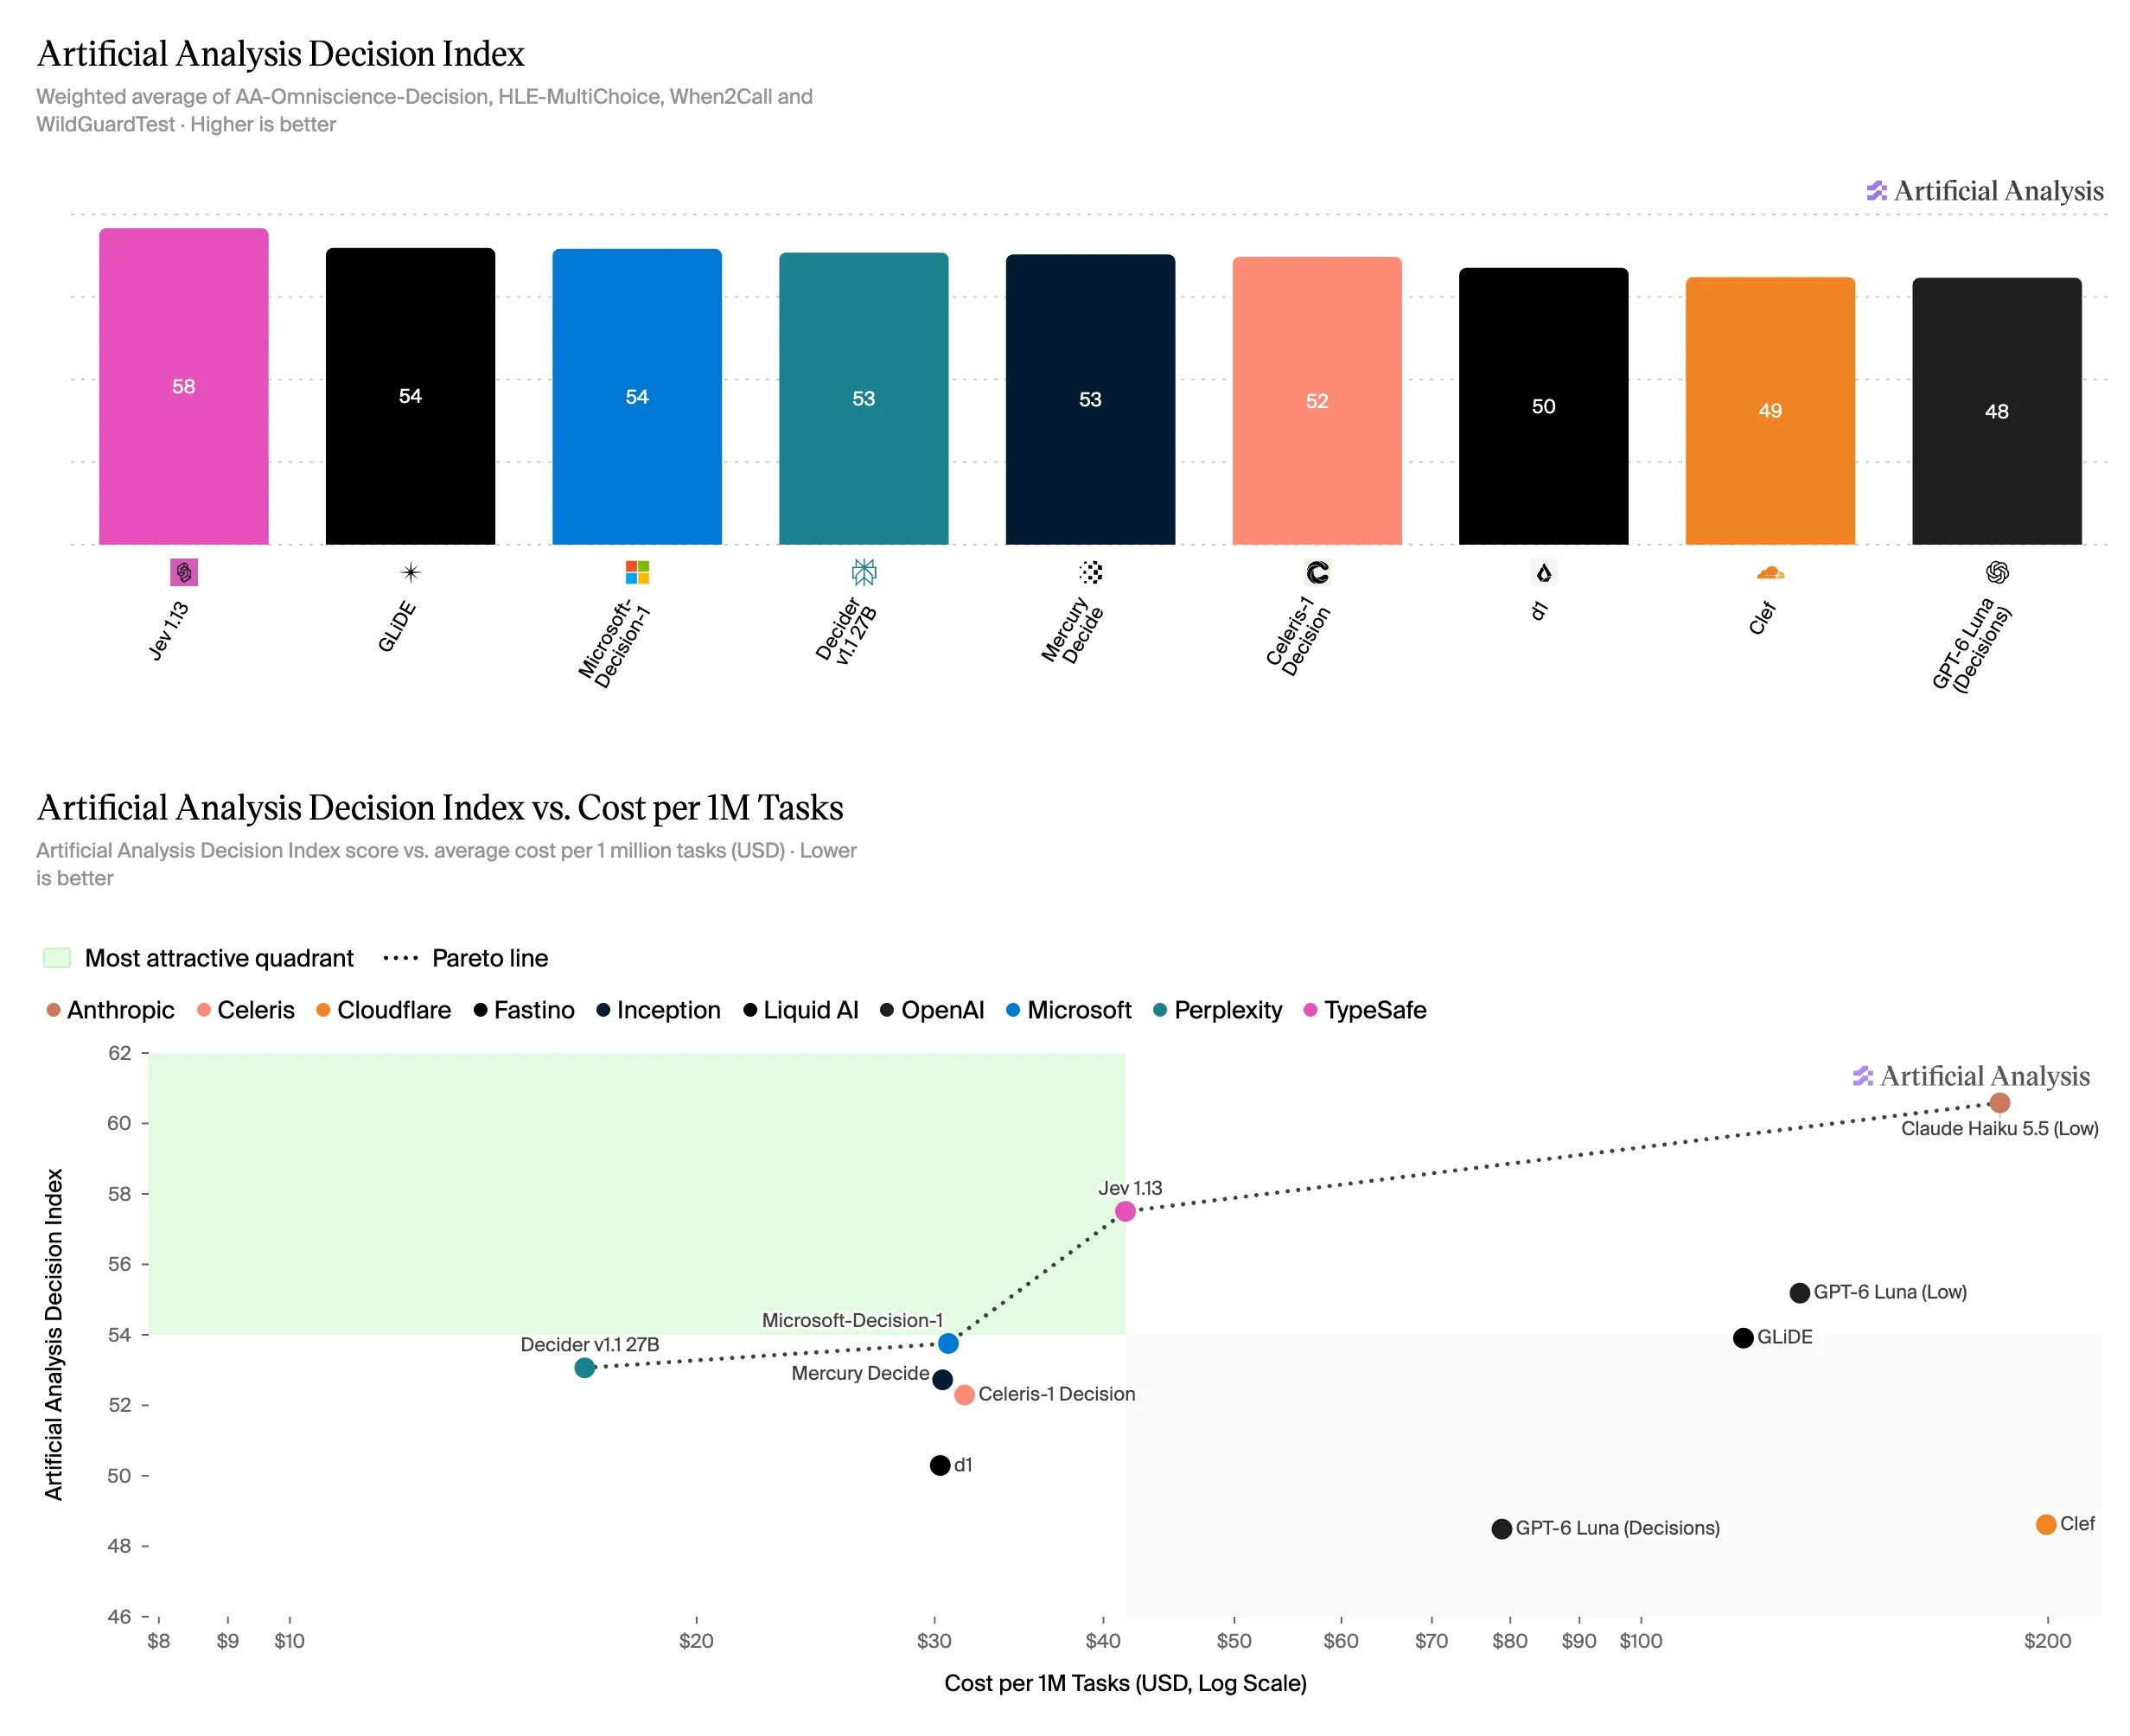
隆重推出 Artificial Analysis Decision Index——一项在分类、工具调用、知识与推理方面对决策模型进行基准测试的指数。Jev 在决策模型中领先;像 Claude Haiku 5.5 这样的语言模型仍能提供更高的准确率,但成本和延迟要高得多。
决策模型提供带相关概率的结构化答案或分类,与使用语言模型相比,响应更快、成本更低。Artificial Analysis Decision Index v1.0 比较决策模型的能力、成本和速度,并与语言模型进行比较。
Artificial Analysis Decision Index v1.0 中的基准测试:
➤ AA-Omniscience-Decision:一个包含 500 个问题的私有数据集,改编自专有的 AA-Omniscience 基准,衡量决策模型的知识水平和产生幻觉的倾向
➤ HLE-MultiChoice:来自 Humanity's Last Exam 的 513 道纯文本多项选择题,测试决策模型的推理能力
➤ When2Call:来自 NVIDIA 的工具调用基准,测试模型能否正确决定调用工具、请求澄清、拒绝回答或直接响应,评估与代理工作流和工具路由相关的能力
➤ WildGuardTest:一项安全基准,评估模型在有害用户请求、助手拒绝和有害响应方面的分类能力。我们使用原始 1,725 行测试数据中的一个 835 行子集,其条件是三位人工标注者对所有三个标签均达成一致,并排除了持续触发模型拒绝的问题
主要结果:
➤ Jev 1.13领跑Decision Index,并位于能力与成本的Pareto前沿:来自@typesafeai的Jev 1.13在Artificial Analysis Decision Index上得分为58,领先于来自@fastinoAI的GLiDE(54)和来自@Microsoft的Microsoft-Decision-1(54)。来自@perplexity_ai的Decider v1.1 27B拥有最低的每1M任务成本,为17美元,Microsoft-Decision-1(31美元)和Jev 1.13(42美元)同样位于能力与成本的Pareto前沿。Celeris-1 Decision拥有最快的每任务用时,为0.06秒,比Jev 1.13(每任务0.13秒)快2倍以上
➤ 决策模型在知识和推理任务上的校准不佳:在几乎所有选择答案的概率水平上,所有决策模型的准确率都低于该概率。这一差距在 AA-Omniscience-Decision 和 HLE-MultiChoice 上最大,而大多数模型在 WildGuardTest(分类)和 When2Call(工具调用)上的校准相对较好
➤ 决策模型相比语言模型具有显著的速度和成本优势,但在知识和推理方面落后:在分类和工具调用任务上,领先的决策模型的表现与语言模型相当,同时速度显著更快、成本显著更低。然而,语言模型在知识和推理方面大幅胜出。Claude Haiku 5.5(Low)在Decision Index上得分为61,领先Jev 1.13达3分,但每任务用时为1.4秒,对比0.13秒(慢11倍),每1M任务成本为184美元,对比Jev 1.13的42美元(贵4.4倍)
我们将继续完善 Artificial Analysis Decision Index,帮助开发者和企业更好地理解何时以及如何使用决策模型。