文本 竞技场战斗展示:
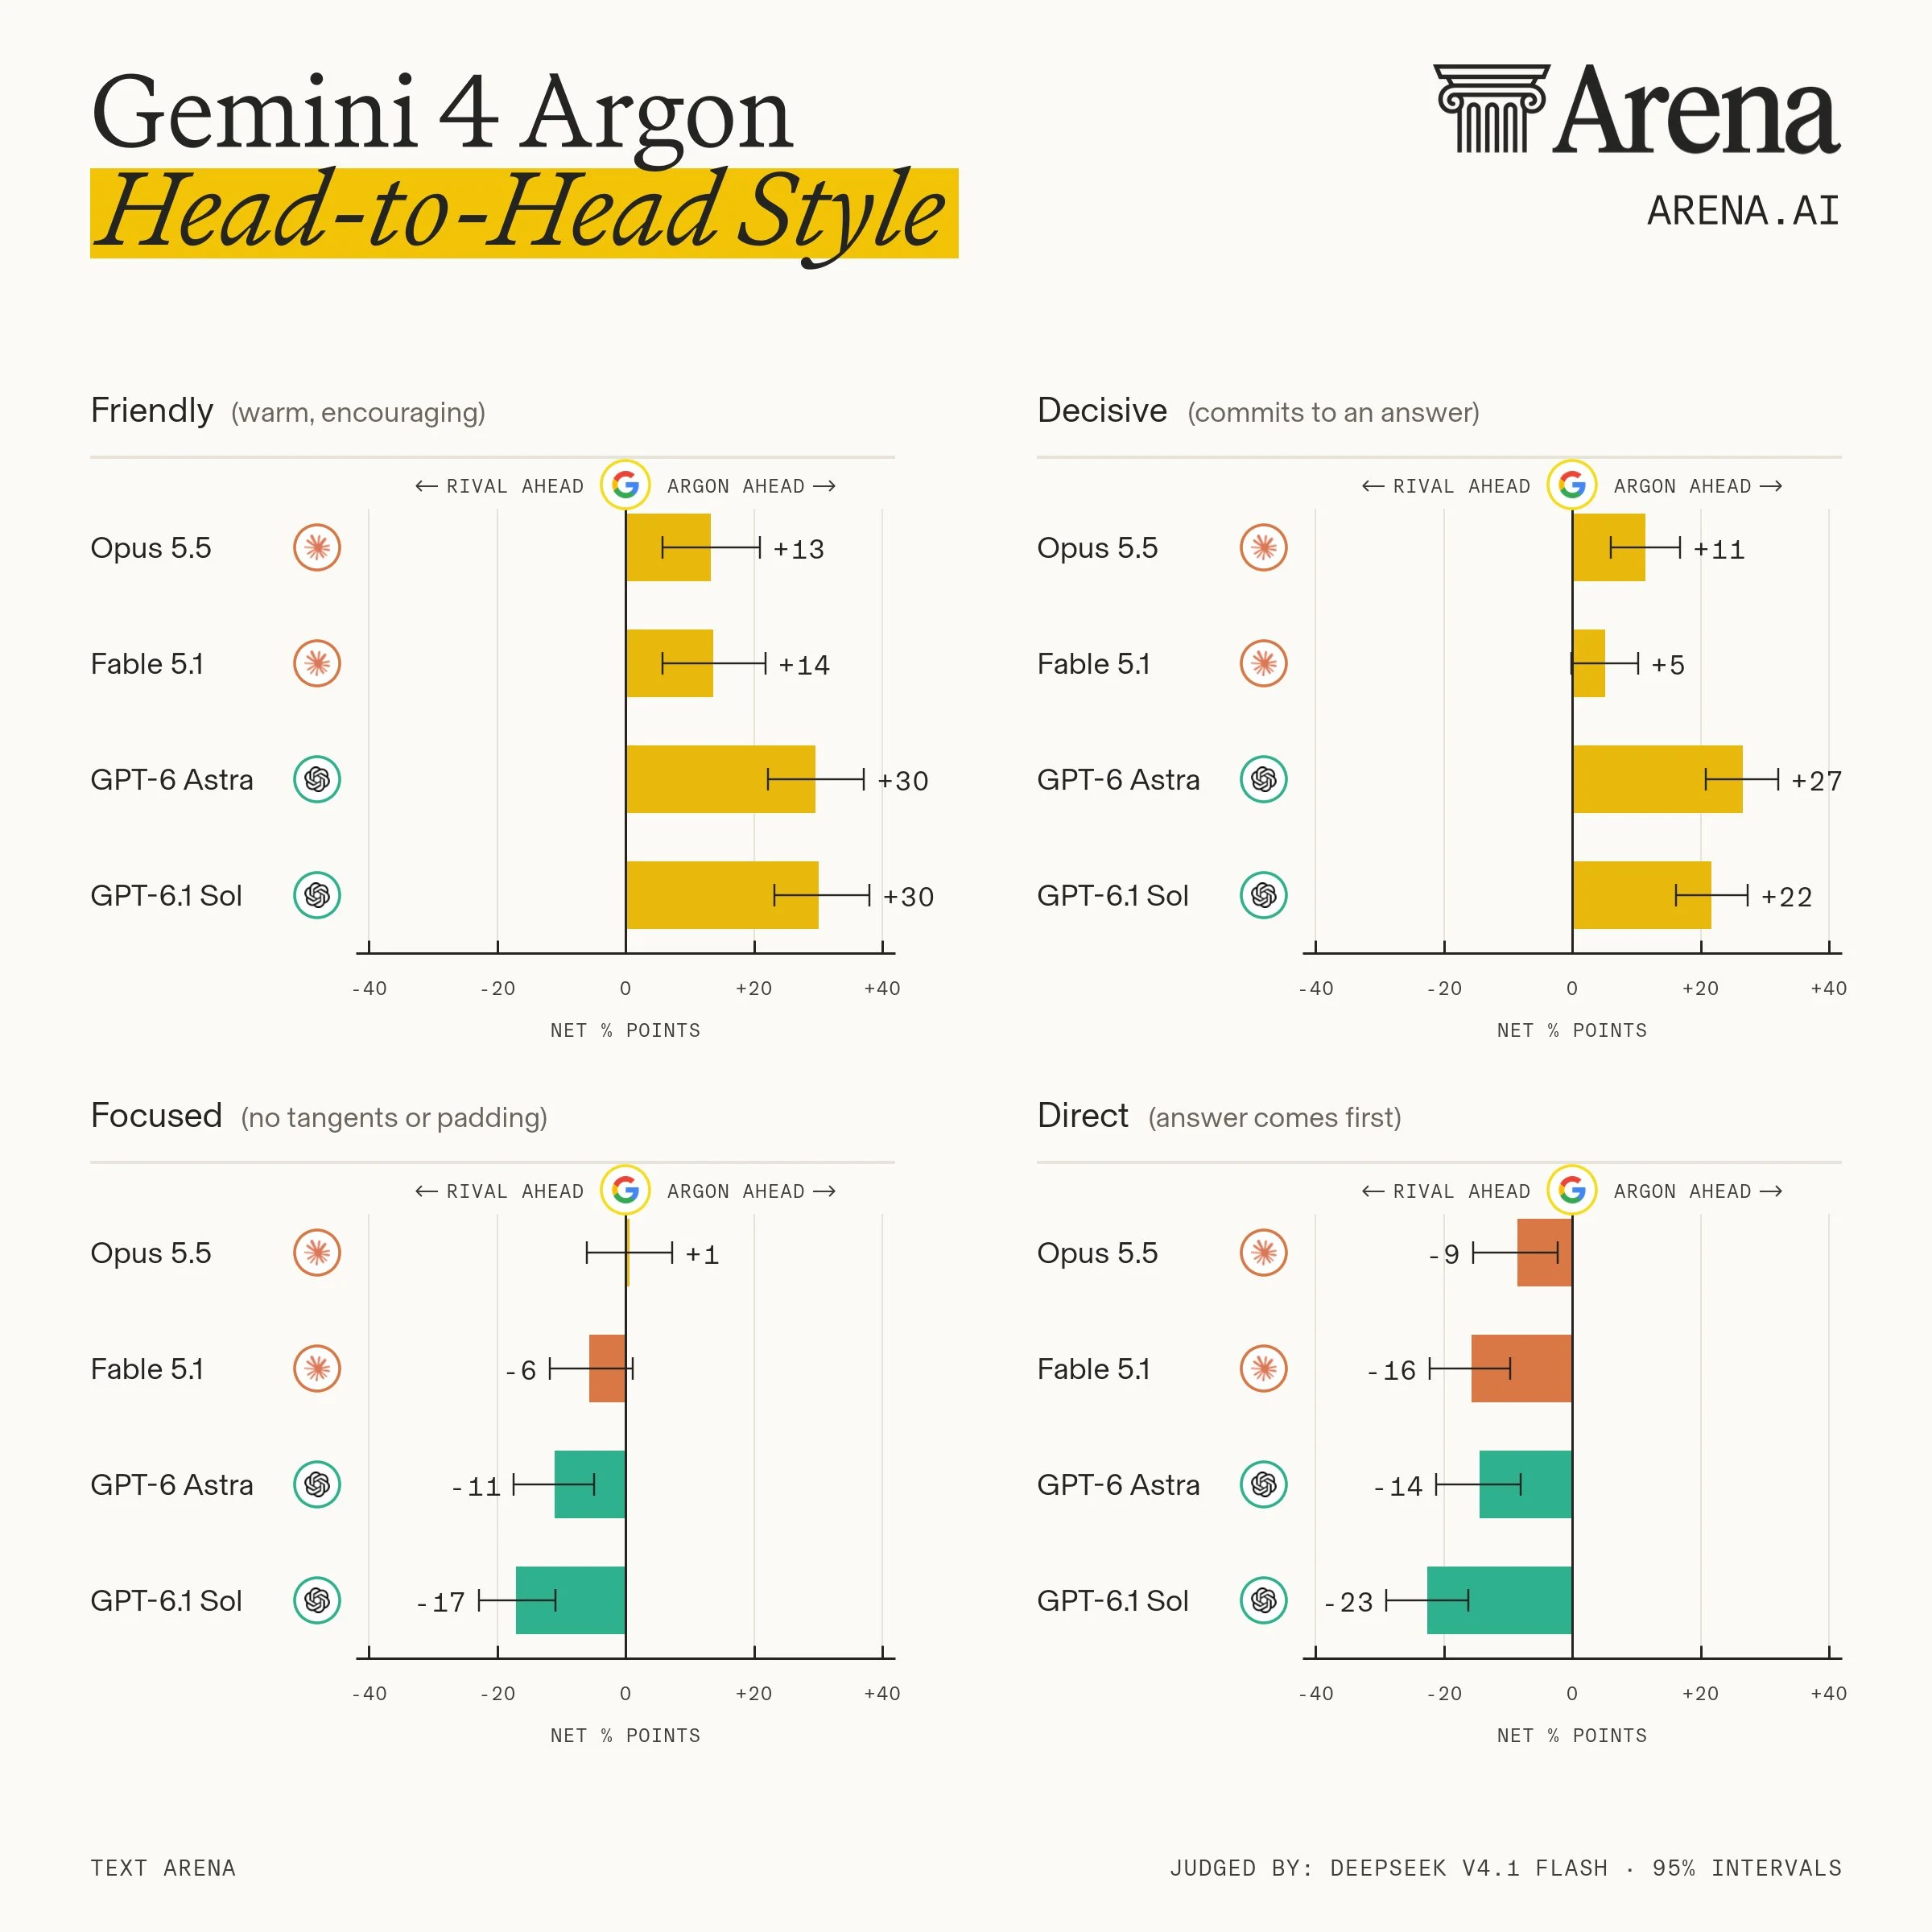
- @GoogleDeepMind 的新版本更加友好且果断。其语气温暖、鼓励人心且清晰明了。针对 GPT-6.1 Sol,AI 法官在 55% 的对比中认为 Argon 更友好,而 Sol 仅为 25%。针对 Opus 5.5,比例为 46% 对 32%。
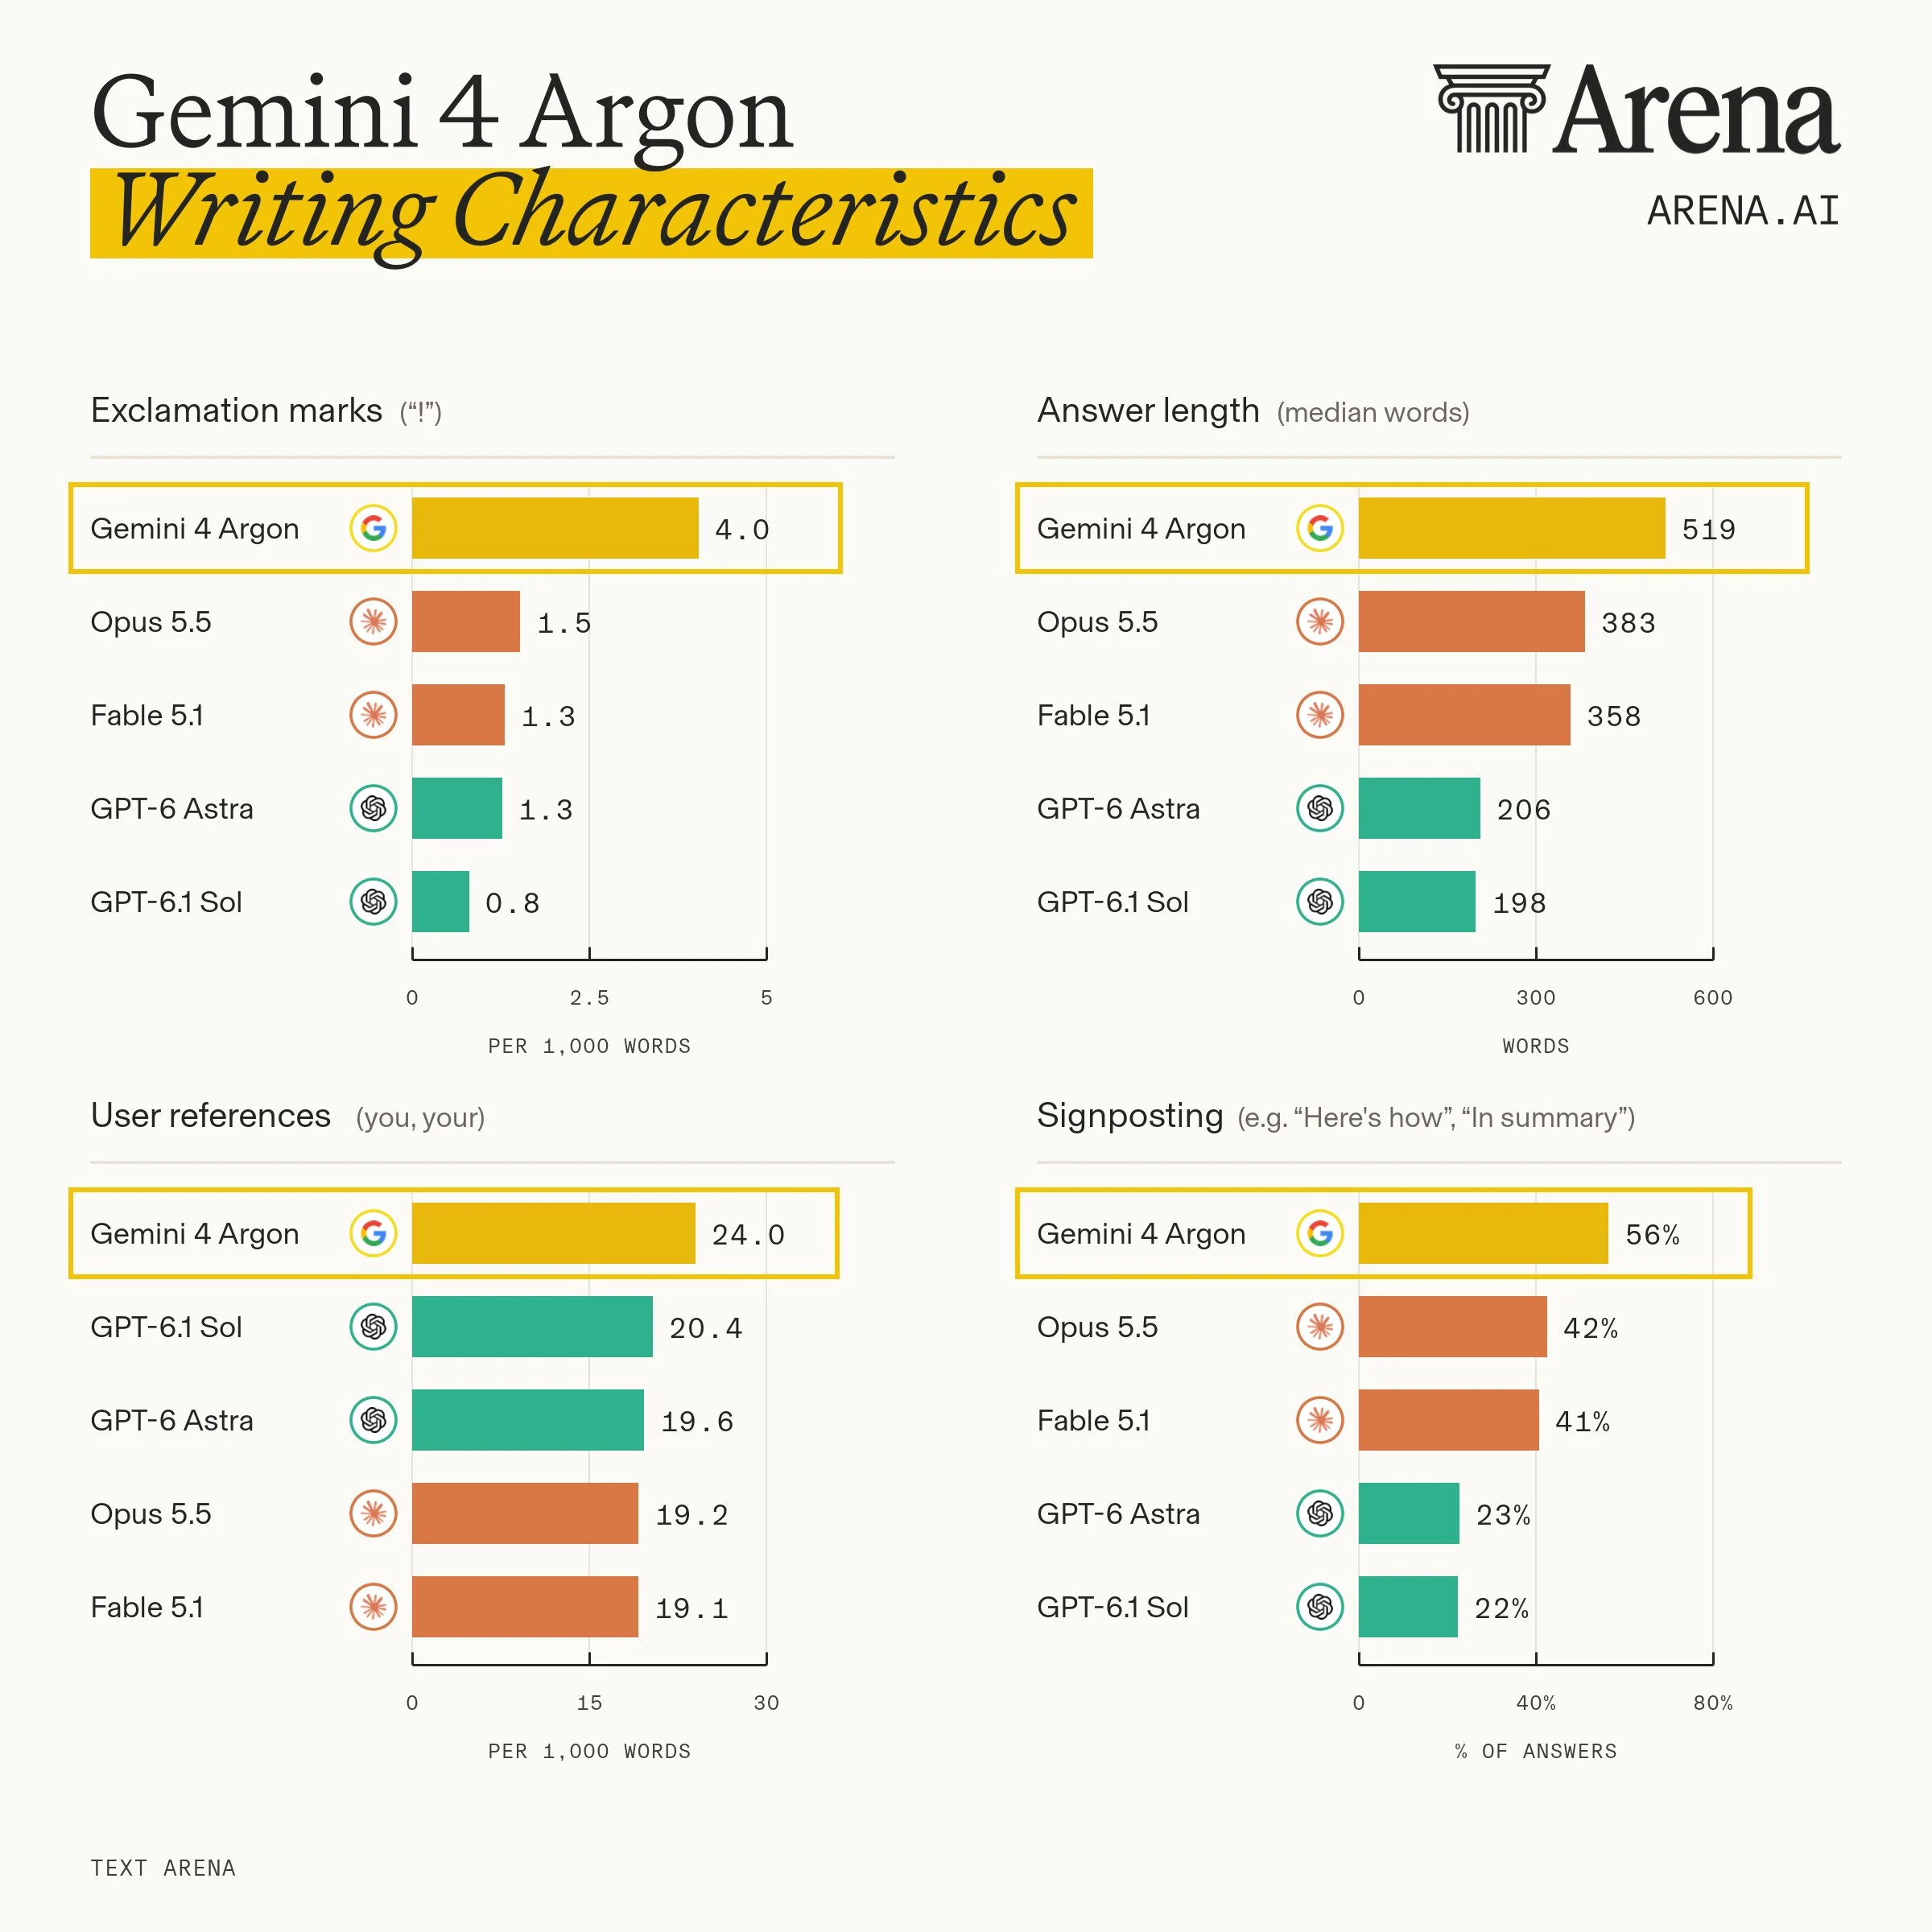
- 它更具对话性:模型更容易偏离主题,不够直接。在32-37%的对比中,对手的回答被认为更直接,而Argon的回答只有14-23%。这也体现在其回答长度上:Argon的平均回答长度为519词,而Claude为358-383词,GPT模型约为200词。
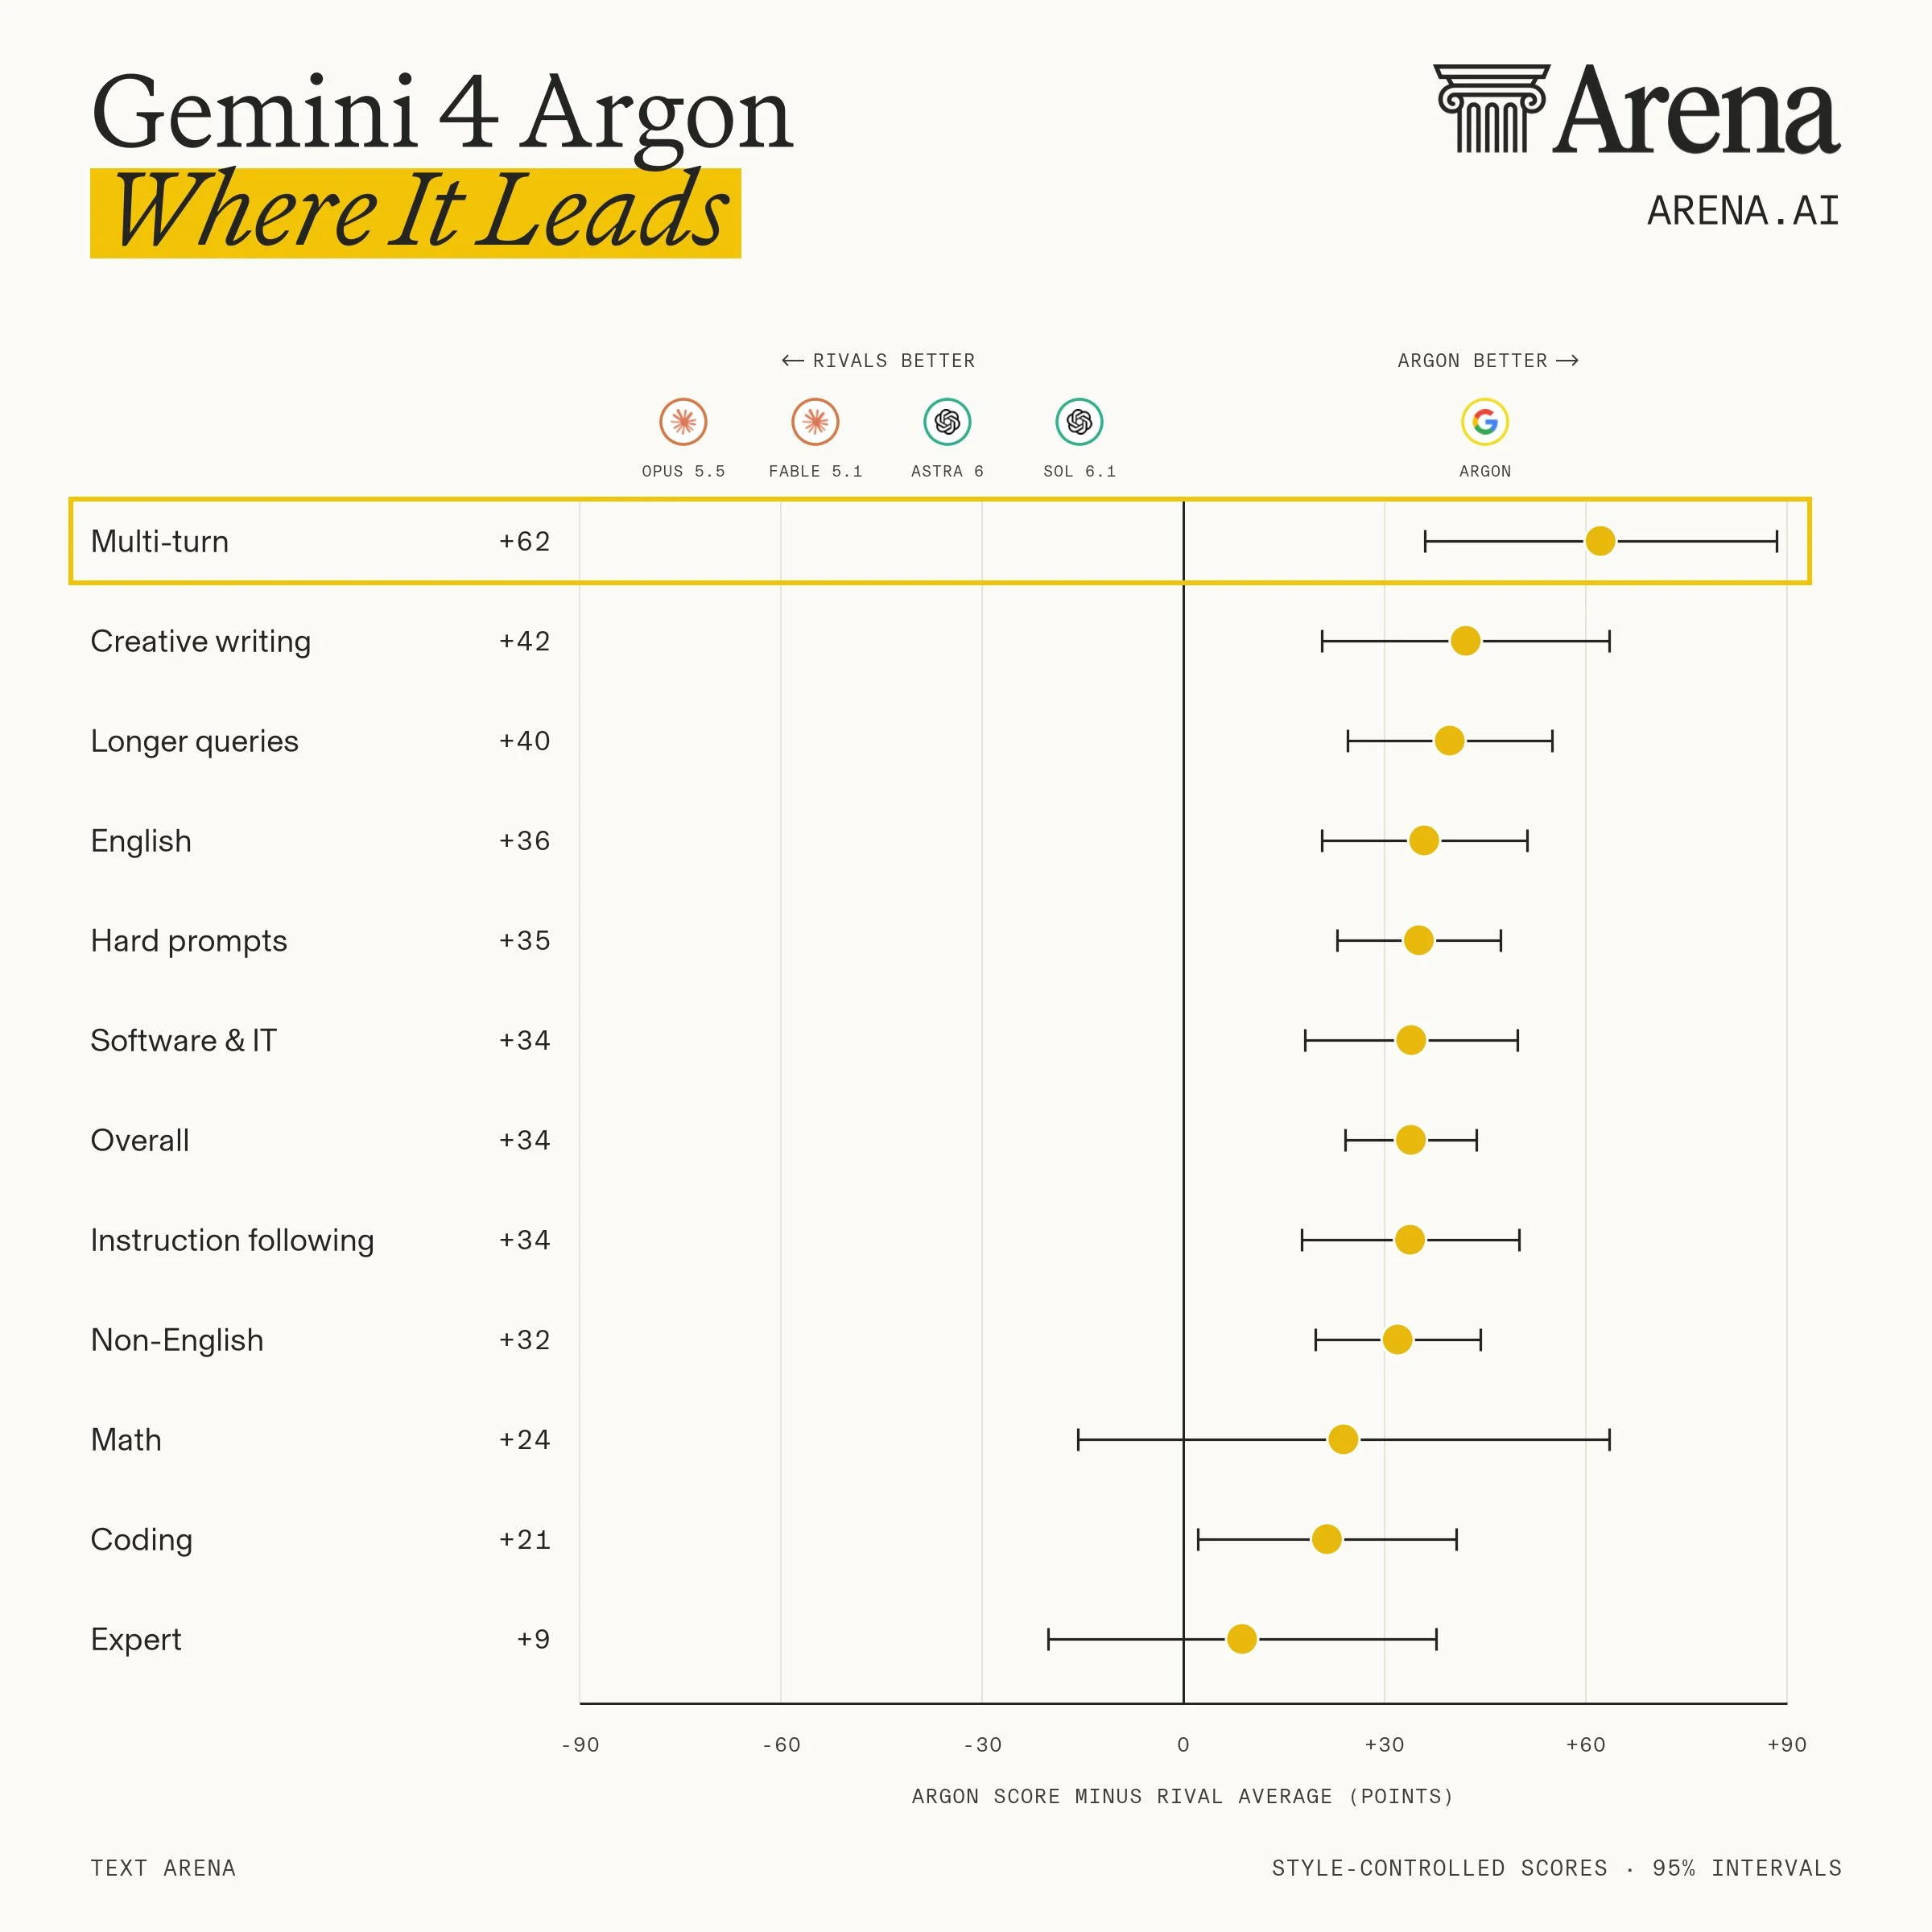
- 这些行为体现在用户投票中。Argon在多轮聊天(+62分)、创意写作(+42分)和长查询(+40分)这些领域具有最明显的优势,而这些领域正是个性最为重要的地方。
- 其易于理解的风格最明显的标志是使用感叹号(约 3 次 Opus 5.5 和 5 次 GPT-6.1 Sol),提及用户的内容(每 1,000 个词中有 24 处,而竞争对手为 19-20 处),以及明确的指示语(其回答中 56% 包含指示语,而 Claude 为 41-42%,GPT 模型为 22-23%)。