构建下一阶段AI的标准
OpenAI 阐明了建立共享全球AI标准的路径,呼吁通过协调一致的评估、报告和治理来提升安全性。
浏览AI动态,在一处查找来源与时间。
OpenAI 阐明了建立共享全球AI标准的路径,呼吁通过协调一致的评估、报告和治理来提升安全性。
探索全新的 OpenAI Academy 学习路径,面向员工、开发者、领导者、教育者和学生,帮助构建并展示实用的 AI 技能。
借助 GPT-5.6,V7 将分散的公司文件转化为智能体可用的上下文,以完成复杂的、带有来源链接的工作。
我们很高兴地开源 Qwen-Image-2.1,千问图像系列当前兼顾生成效果、推理效率与使用成本的开源图像模型。Qwen-Image-2.1 将文生图与图像编辑整合在同一模型中,视觉生成部分仅有 7B 参数,并原生支持透明图像的生成与编辑。 本次更新的主要特色包括四个方面: 小模强效,极致价比:轻量的模型结构与推理优化,在生成质量和计算成本之间取得平衡。
在HUAWEI CONNECT 2026期间,华为举办了以"引领AI DC创新,塑造智能体世界"为主题的AI DC创新峰会。
在HUAWEI CONNECT 2026期间,以为主题的全球教育峰会在上海成功举行。峰会上,华为正式面向全球发布AI实践实验室(AIPL)解决方案,并同时发布《AI+实践教学白皮书》。
基于UnifiedBus,华为提出了一种面向SuperPoD和SuperCluster、覆盖五个维度的新型智能体计算开发方法。
在HUAWEI CONNECT 2026上,华为以“安全智能联接”理念发布了升级版Stellar AI Network解决方案。
在HUAWEI CONNECT 2026期间举办的“ICT服务与软件使能行业迈向智能体世界”峰会上,华为发布了五款新方案及O3平台服务的智能化演进
我们在最新一期的 GitHub Podcast 中深入探讨了这些问题以及其他 AI 热门观点。文章《你应该阅读代码吗,RAG 死了吗,Skills 杀死了 MCP 吗?》最初发表于 The GitHub Blog。
我们正在壮大我们的AI与经济团队,引入世界一流的学术顾问、研究员和核心内部研究人员。
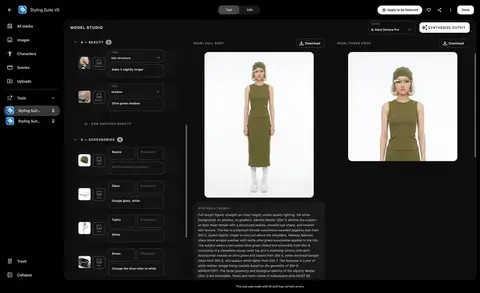
Google与设计师Jane Wade和Sergio Hudson并肩合作,定制设计Google Flow工具,为纽约时装周做准备。
OpenAI推出澳大利亚青少年安全蓝图,这是一份六支柱路线图,旨在打造更安全的AI体验,保护并赋能年轻人。
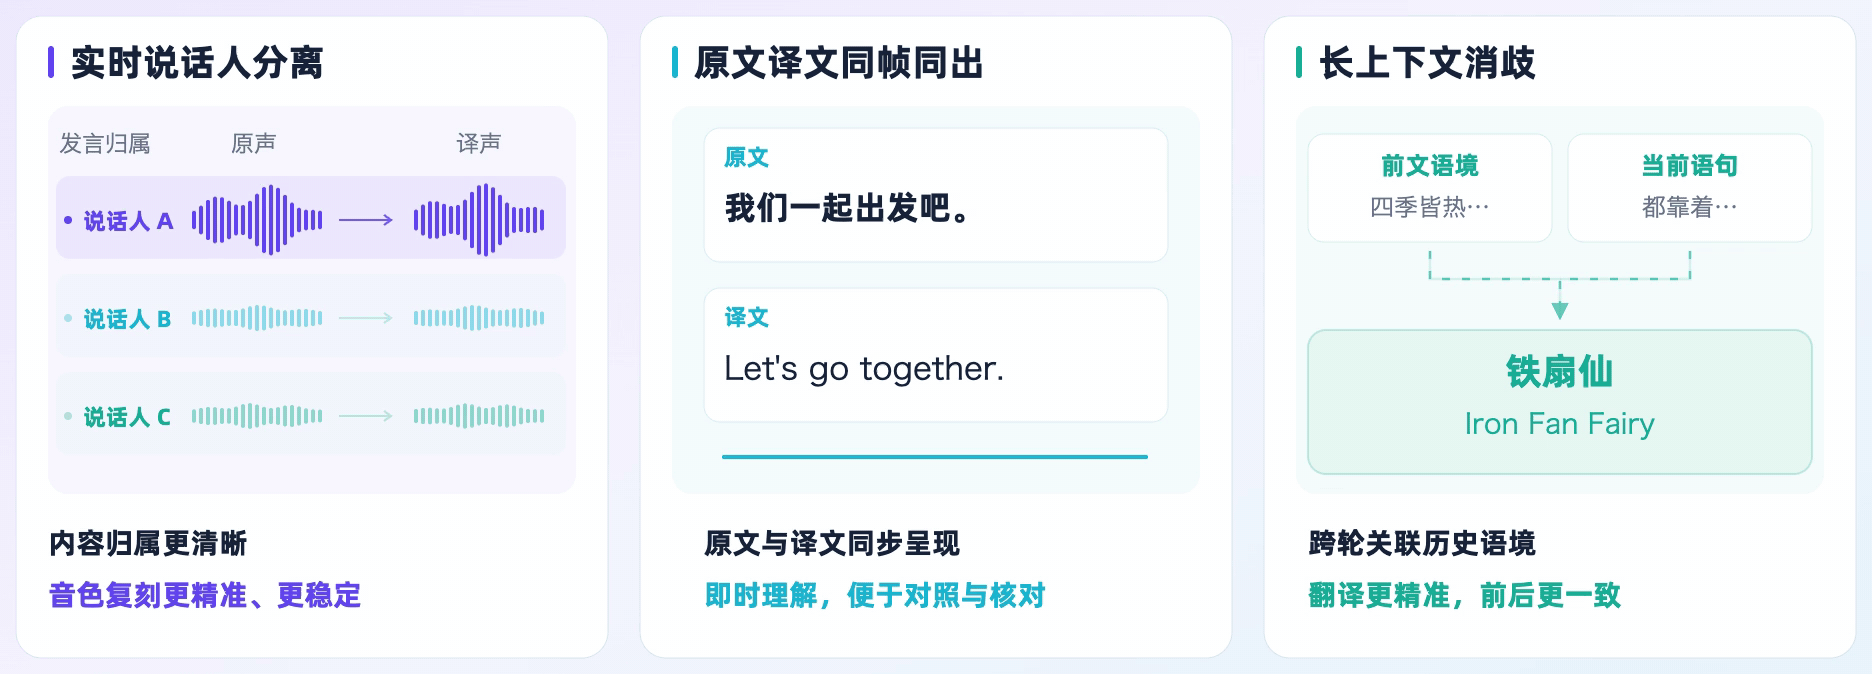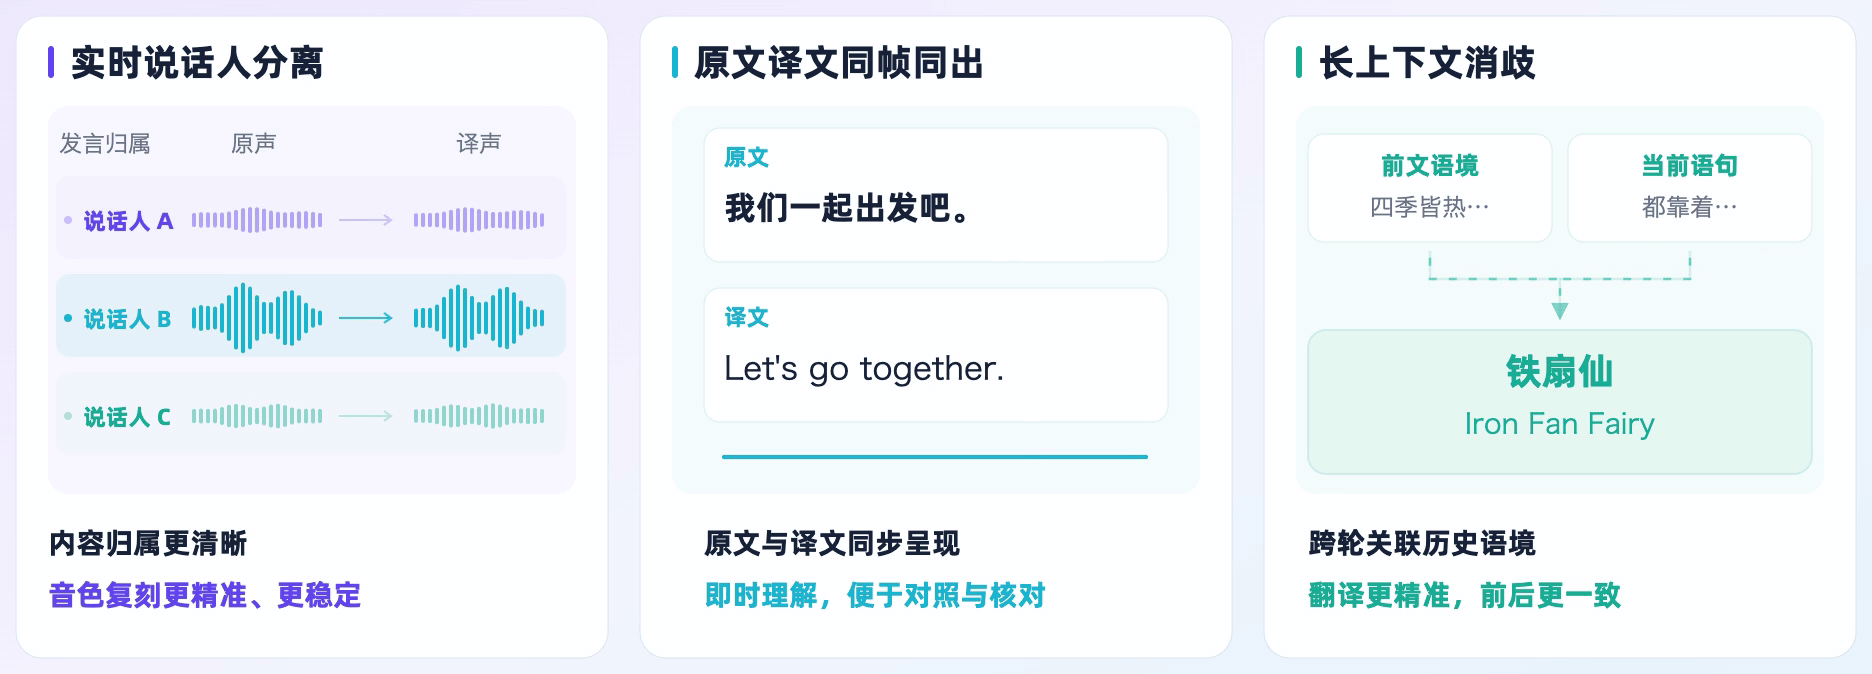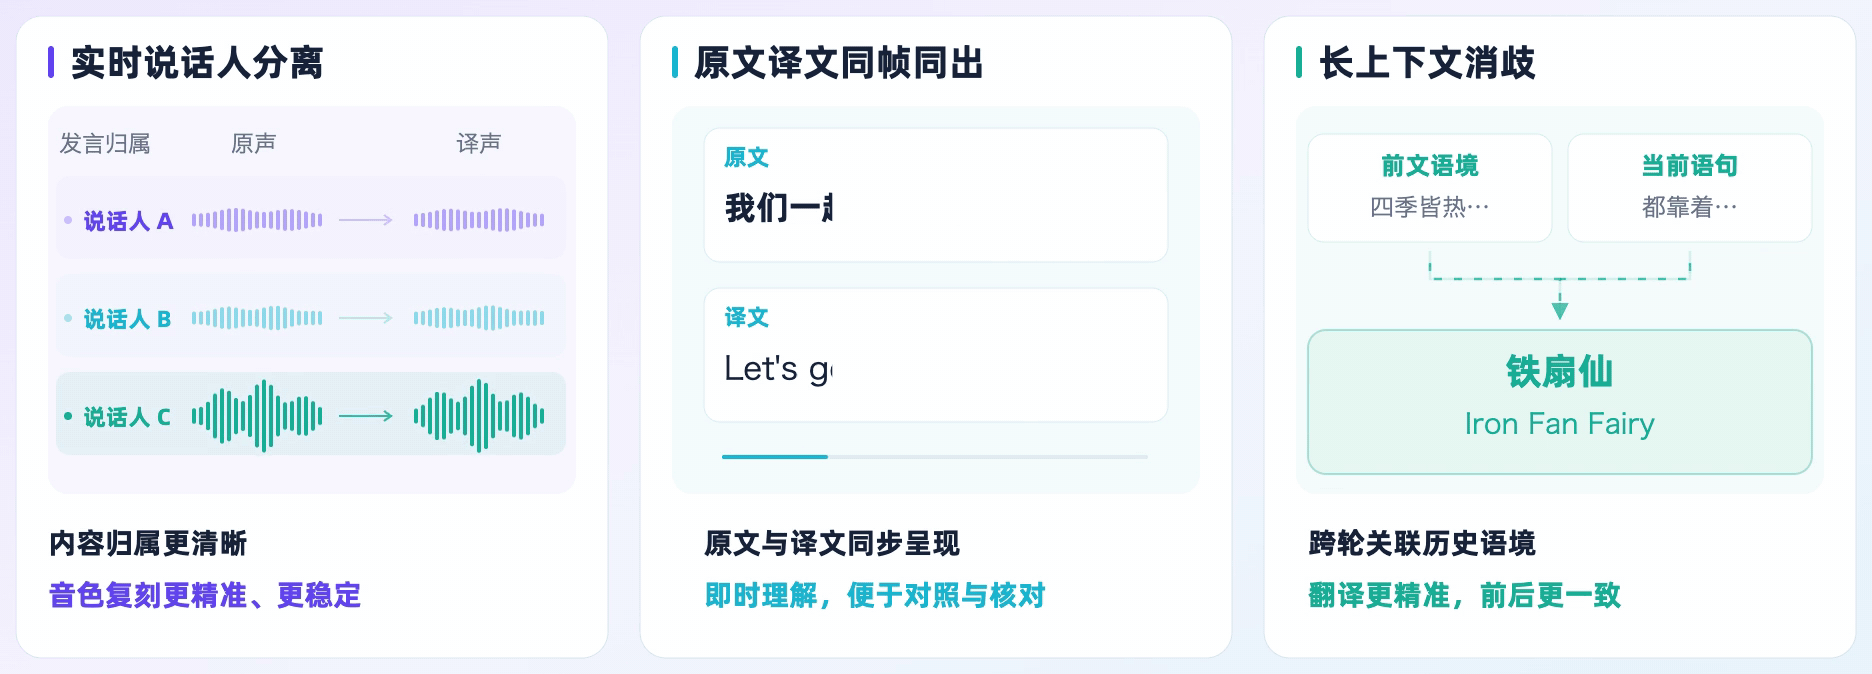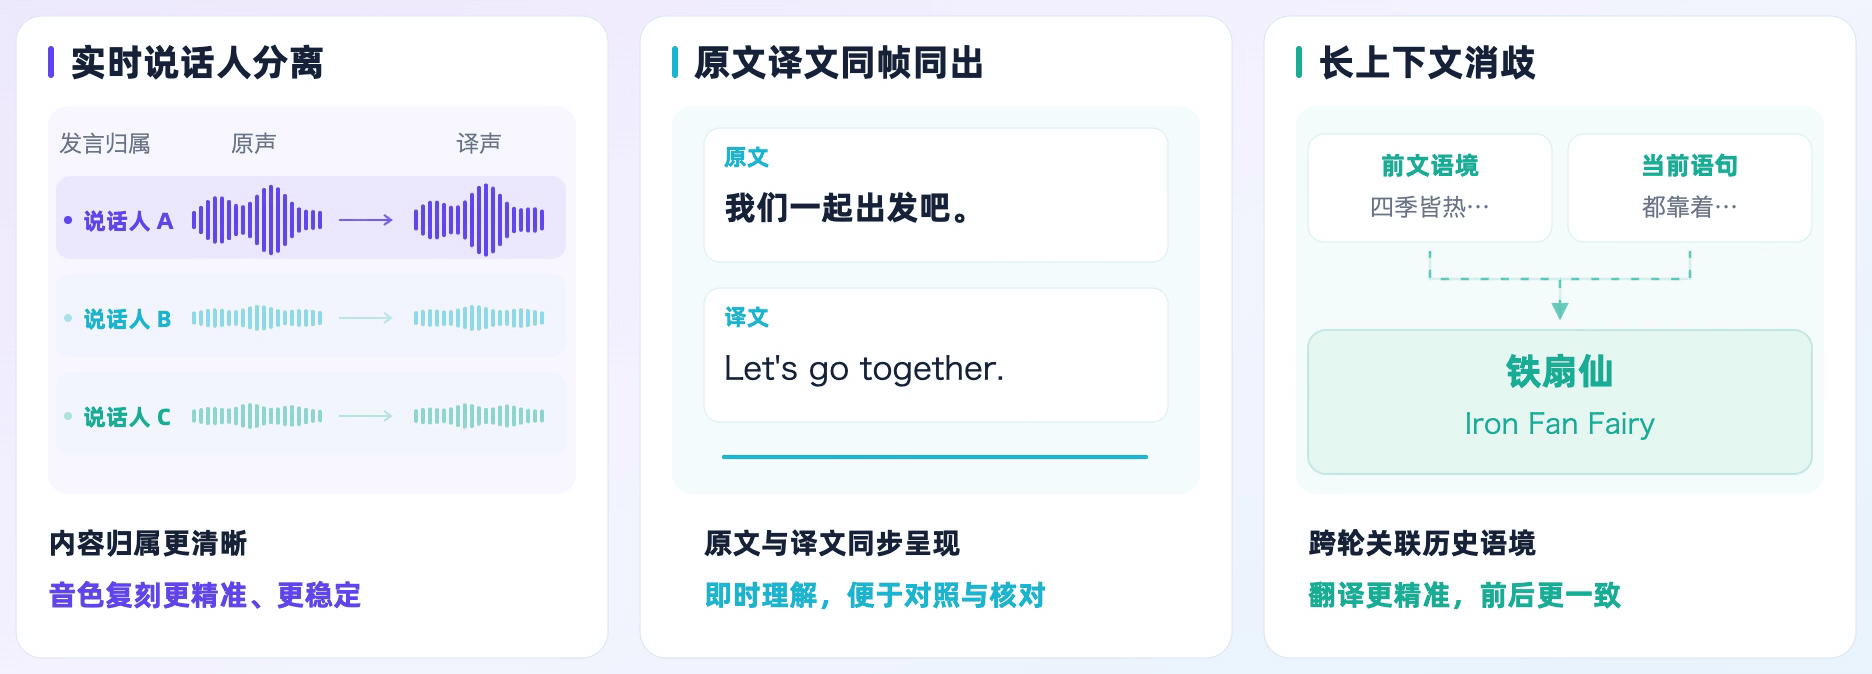
同传不只是翻译得快,更要听得清、译得准。Qwen3.8-LiveTranslate 以 Interleave 架构重构实时同传,忠实度、流畅度、简洁度全面提升,字均延迟(LAAL)从 2.8 秒降至 2.3 秒。我们希望同传不只传递语言、也能保留交流中人物与上下文信息,因此,在支持 60 种语言的基础上,Qwen3.8-LiveTranslate 新增三项能力让同传更广泛的应用于真实场景中:实时说话人分离,每句话归属清晰,音色复刻更稳定;原文译文同帧同出,双语同屏;长上下文消歧,联系前文读懂当下,人名术语翻译更精准。
今天,新一代原生全模态模型 Qwen3.8-Omni-Flash 正式上线。该模型的核心目标是提升其在真实生产力场景中的 Agent 能力,推动全模态模型从“理解全模态内容”进一步走向“规划任务、调用工具并完成创作”。在具备编程、文本知识工作和 GUI 操作等通用 Agentic 能力的基础上,Qwen3.8-Omni-Flash 进一步拓展了以音视频为核心的 Agentic 应用,在视频剪辑、音乐视频创作、影视制作与解说、音视频转图文摘要和音视频对话等需要综合处理文本、图像、音频与视频的工作流中取得了显著效果。
谷歌与联合国系统共同推出了联合国系统数据共享平台(UN System Data Commons),这是一个全新的开放平台,让全球统计数据触手可及、易于搜索。
华为正式与南方医院、南方医科大学联合发布南方医院全球样板点及医疗AI助手(HAIC)解决方案,旨在为医疗行业树立全球标杆和智慧医疗示范样板