
يون تشونغ، من معقل أوفاي سي
الكمية | الحساب العام QbitAI
إن OpenAI تلقي في الآونة الأخيرة قنابل ثقيلة متكررة على وسط الرياضيات.
في الشهر الماضي، أعلنت OpenAI أن نموذجها الذكي استطاع، في 88 ساعة فقط، حسم واحدة من أصعب مسائل الألفية السبع التي ألحقت البشرية لمئة عام — معادلات نافييه-ستوكس؛ وأمس، أطلقت 722 مخطوطة رياضية، تشمل ثلاث مسائل أخرى من مسائل الألفية.
لكن في تقييم PaperBenchX الصادر عن UniPat AI، وبمواجهة 93 مهمة حقيقية لإعادة إنتاج أوراق بحثية، حقق GPT-6 Astra الأقوى أداءً نسبة إعادة إنتاج كاملة لا تتجاوز 13.98%.
△ الأداء الإجمالي والمرحلي لـ 10 إعدادات مُختبَرة على 93 مهمة إعادة إنتاج
مع اللمعان البرتقالي!النماذج الحالية قادرة على تحقيق اختراقات عظيمة كحل مسائل الألفية الرياضية، لكنها نادراً ما تكمل عملية إعادة إنتاج علمية موثوقة من البداية إلى النهاية.
(بجدية تامة) يثير هذا بعض التساؤلات: في مجال الذكاء الاصطناعي للعلوم الواسع، بأي معيار نحكم على «فعل العلم بشكل صحيح»؟ وبما يليق بروح البحث العلمي الدقيق، ما هي الخطوة الأولى نحو رياضي ذكي اصطناعي بل عالم عام بالذكاء الاصطناعي؟ وكيف نبني مجموعة من المعايير القابلة للتحقق والمقارنة لقياس التقدم الحقيقي للذكاء الاصطناعي في البحث العلمي؟
بأي مسطرة نقيس تقدم الذكاء الاصطناعي في العلم؟
في هذه اللحظة، دعونا نتأمل مجدداً الرسالة المفتوحة الصادرة باسم مشترك من 25 حائزاً على ميدالية فيلدز منهم تيرنس تاو ودينغ يو.
لقد أقرّوا بالارتفاع الحاد في القدرات الرياضية للنماذج اللغوية الكبيرة، بحيث أصبحت قادرة على حل مسائل كبرى في الرياضيات، لكنهم طرحوا أيضاً سؤالاً أكثر جوهرية:شركات الذكاء الاصطناعي تعتبر حل المسائل الرياضية اختباراً معيارياًوهذا أمر ضار بعلم الرياضيات وبمجتمع الرياضيات على حد سواء.
لذا، فهذه ليست رسالة معادية للذكاء الاصطناعي، بل تطرح سؤالاً أبسط:بأي مسطرة نقيس بالضبط تقدم الذكاء الاصطناعي في العلم؟
وتحمل الرسالة عبارةً أثقل وزناً: فإن إشكالية اعتبار حل المسائل الرياضية اختباراً معيارياً هي جزء من إشكالية انحراف أوسع، تمس هو الأخرى المهن العلمية والإبداعية الأخرى، بل المجتمع بأسره.
وفي الحقيقة، الأسئلة المطروحة أعلاه تصبح أصعب إجابة كلما اتسعت من مجال الرياضيات إلى العلوم الطبيعية بل إلى المجال الاجتماعي.
فالرياضيات على الأقل تملك خط دفاع أخيراً: Lean. صحة البرهان يمكن للآلة فحصها خطوة بخطوة، وصحة الإجابة أو خطئها لها سند مضمون.
أما في غيرها من العلوم، فمعامل الانعكاس في محاكاة كهرومغناطيسية، أو منص帯 طاقة، أو فجوة نطاق متقاربة، ليست لديها Lean. قد يكون الرقم المتوافق مع الورقة البحثية ناتجاً عن نموذج فيزيائي خاطئ، أو محاكاة غير متقاربة، أو معالجة لاحقة غير صالحة تصادف أن أسفرت عن قيمة تبدو معقولة.
لذلك، وقبل قياس قدرة العالم العام بالذكاء الاصطناعي — الذي يطرح الأسئلة ويصمم التجار ويحقق اكتشافات جديدة باستقلالية — توجد مسألة أكثر أساسية:هل يستطيع إعادة إنجاز عمل علمي منشور سلفاً بشكل موثوق، وإثبات أنه أنجزه على النحو الصحيح؟
منطق هذا السؤال يكمن في أن إعادة الإنتاج لها إجابة صحيحة وحيدة، ولذلك يمكن تقييمها بدقة.
العمل الذي أصدرته UniPat AI مؤخراً«PaperBenchX»يستهدف بالضبط هذا الأمر — فقد بنت منه 93 مهمة إعادة إنتاج مستمدة من 93 ورقة بحثية، تمتد هذه المهام على 12 اتجاهاً بحثياً تشمل الكهرومغناطيسية والبصريات والكيمياء والمواد والأحياء والروبوتات، و10 بيئات علمية أصلية للمجالات، وتضم 3168 بند تقييم مُتحقَّقاً منه من خبراء،وهي أول معيار مرجعي (Benchmark) في العالم متعدد التخصصات لإعادة إنتاج نتائج الأوراق البحثية من البداية إلى النهاية.
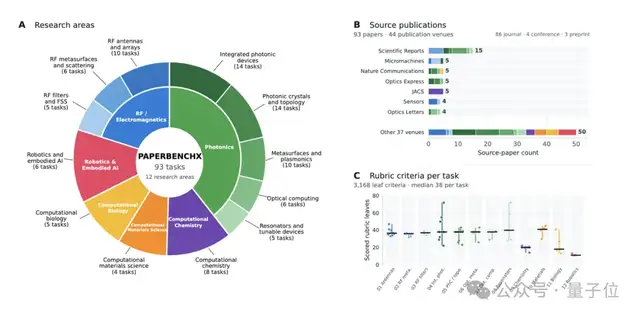
△ توزيع مهام PaperBenchX، والأوراق المصدر، وتكوين بنود التقييم
قواعد اختبار PaperBenchX بسيطة جداً:
حصل الـAgent على مقالورقة بحثية حقيقيةوعلى جهازٍ ثُبِّتت عليه البرامج العلمية المناسبةبيئة الحاوياتوثيقلة توضح «أي جزء يجب إعادة إنتاجه»وثيقة المهمة;
يعيد الوكيّل (Agent) تسليمسير عمل قابل للتنفيذ لإعادة الإنتاج;
معايير التقييم، السماحيات، الإجابات المرجعيةمخفي بالكامل عن الوكيل。
نقطة تحتاج إلى انتباه خاص هي أن الورقة البحثية نفسها متاحة للعموم، وبالطبع يستطيع الـAgent رؤية الأرقام الناتجة الواردة في الورقة، لكن من الواضح تمامًا أن هذا الامتحان لا يختبر «تخمين الإجابة»، بل يختبر ما إذا كان الذكاء الاصطناعي قادرًا على إعادة بناء مسار سليم علميًا، واشتقاق بنفسه الأدلة التي تدعم تلك النتيجة.
إذن، ما الذي يقيسه PaperBenchX بالضبط؟
الجواب هو: لا تُقاس «كمية الأرقام التي تم الحصول عليها»، بل يُعتمد فقط على الأدلة المُعاد توليدها. بعد أن يسلّم الـ Agent عمله، يحذف النظام كل المخرجات ويقطع الاتصال بالشبكة، ثم يعيد تشغيل سير العمل من البداية في بيئة معزولة، ولا يثق المقيِّم إلا في نواتج إعادة التشغيل.يمكن القول إنه، بمعنى ما، «Lean» أُنشئ من أجل المحاكاة العلمية.
كيف كانت النتائج المقاسة؟
النتيجة: من بين 93 مهمة إعادة إنتاج للأوراق العلمية، لم يتجاوز معدل الإعادة الكاملة لنموذج GPT-6 Astra، وهو الأقوى أداءً، 13.98٪.
هذا يعني أن النموذج قادر على إنتاج نتائج تبدو معقولة في العديد من المهام، لكن نسبة النجاح في تشغيل سير العمل الكامل فعلياً من الصفر وتوليد أدلة قابلة للتحقق ومتسقة مع الورقة البحثية أقل من واحد من كل سبعة.
هذه هي المسافة بين الذكاء الاصطناعي اليوم وGeneral AI Scientist القادر على تجاوز حدود المجالات العلمية المختلفة.
تكمن أهمية PaperBenchX في أنه قاس هذه المسافة للمرة الأولى。
حالياً، يختار فريق UniPat AI مهمة تمثيلية واحدة (1) من كل اتجاه بحثي، ليفتح المصدر بإجمالي12 مهمة اختبارية. تغطي هذه المهام اتجاهات بحثية مختلفة وحزم برمجيات علمية متنوعة، ويمكن استخدامها لتقييم الوكلاء (Agent)، وتصحيح أخطاء سير عمل الاستنساخ، ودراسة قدرة النماذج على الاستنساخ من البداية إلى النهاية في بيئات علمية حقيقية.
كما يحافظ الفريق في الوقت ذاته على 81 مهمة اختبارية مغلقة من أجل الحفاظ على تمييز PaperBenchX وفاعليته في التقييم على المدى الطويل.
ما وراء نسبة 13.98%، أين تكمن عقبة الاستنساخ الموثوق؟
بعد ذلك، نلقي نظرة تفصيلية على 10 مجموعات من النماذج الرائدة وتكوينات أطر العمل الوكيلة (Agent) التي قيّمها PaperBenchX على المجموعة نفسها البالغة 93 مهمة، ونحلل نتائج التقييم لفهم أين تكمن عقبة الاستنساخ الموثوق بالضبط.
△ (a) درجات المراحل للتكوينات المُختبَرة؛ (b) العلاقة بين عدد جولات التفاعل والدرجة؛ (c) توزيع الوقت في سير العمل لمسارات مأخوذة بعينة
الإنجاز الجزئي لا يعني الاستنساخ الكامل
لنبدأ بالشكل a، درجات المراحل للتكوينات المُختبَرة. يمكن ملاحظة أنه في جميع التكوينات المُختبَرة، بلغ متوسط الدرجات في النمذجة (Modeling) والتنفيذ (Execution) 62.70% و61.84% على التوالي، بينما بلغ التحقق (Validation) 42.80% فقط.
هذا يعني أن الوكيل قادر على إنجاز جزء من النمذجة، واستدعاء الحلّال (solver) وتوليد ملفات النتائج، لكن هذه النتائج ليست صحيحة بالضرورة، ولا تثبت بالضرورة أنها تدعم فعلاً استنتاجات الورقة البحثية. وبشكل عام، ما زال من الصعب عليها ربط المراحل المختلفة ببعضها لإنجاز استنساخ كامل وموثوق.
زيادة التفاعلات لا تعني نتائج استنساخ أفضل
لننتقل إلى الشكل b، العلاقة بين عدد جولات التفاعل والدرجة. يُظهر تحليل المسارات أن التشغيل الطويل غالباً ما يعني محاولات متكررة، أو تعافياً من الأعطال، أو مواصلة الحساب على إعدادات نموذجية خاطئة. وهذا يدل على أن زيادة عدد جولات التفاعل لا تعني بالضرورة درجة أعلى.
القرارات المبكرة تحدد ما إذا كانت مراحل التنفيذ اللاحقة ذات قيمة
لننظر إلى الشكل c، توزيع الوقت في سير العمل لمسارات مأخوذة بعينة. على سبيل المثال، خصص Fable 5 نسبة 37.1% من وقته لإعادة بناء الورقة وتنفيذ الشيفرة، وهي أعلى نسبة استثمار مبكر بين النماذج الخمسة، ومع ذلك تمكن من تحقيق درجات جزئية قريبة من الأمثل بعدد تفاعلات أقل.
أي أن مدى معقولية القرارات المبكرة مثل فهم الورقة، والنمذجة العلمية، واختيار المعاملات، وتنظيم التجارب، يحدد إلى حد كبير ما إذا كان الحساب اللاحق سيتحول إلى إهدار للموارد.
لأنه إذا كانت البنية الهندسية، أو الشروط الحدية، أو تعريفات الأنماط، أو المعاملات الأساسية قد ضُبطت بشكل خاطئ في المرحلة المبكرة، فإن الحلّال حتى لو عمل بشكل طبيعي، سيكون ببساطة يحسب نظاماً علمياً خاطئاً. قرار مبكر خاطئ واحد قد يجعل ساعات الحساب اللاحقة تفقد قيمتها بالكامل.
باختصار، النظر فقط إلى النتائج التي تبدو وكأنها عملت أو إلى المخرجات النهائية المتحصل عليها لا يسمح بالتمييز بين أسباب الفشل المختلفة. بعض الوكلاء نجحت تجاربهم في التشغيل، لكن نموذجهم العلمي أو تحليل نتائجهم كان خاطئاً؛ بينما تعذر على وكلاء آخرين إتمام إعادة التشغيل بسبب غياب عملية حلّ موثوقة أو أخطاء في الشيفرة.
كما أشار فريق UniPat AI بشكل أكثر تفصيلاً إلى عدة نقاط أساسية لتحقيق «الاستنساخ الموثوق»:
الصعوبة لا تكمن في «هل يمكن تشغيله»، بل في «هل ما تم تشغيله صحيح علمياً» : رقم يبدو متطابقاً قد ينتج عن نموذج خاطئ، أو معاملات غير مناسبة، أو محاكاة لم تتقارب، أو معالجة لاحقة غير صالحة؛
يجب أن يستند تقييم النتائج إلى أدلة مُعاد توليدها، لا إلى شهادة الوكيل ذاته: احذف المخرجات، وافصل الشبكة، وأعد التشغيل، وقبل فقط بمنتجات إعادة التشغيل؛
بعض التقدم الحالي حقيقي، لكن الاستنساخ الكامل لا يزال نادراً: أصبح الوكلاء قادرين على كتابة محاكاة معقولة وتشغيلها حتى اكتمالها، لكن جعل العملية بأكملها والنتائج النهائية قابلة للتحقق لا يزال صعباً للغاية.
التصميم التمييزي لـ PaperBenchX
إن اعتماد «استنساخ الورقة كاملة» كنموذج تقييم للوكلاء ليس ابتكاراً حصرياً لـ UniPat AI، فـ PaperBench من OpenAI هو عمل مشابه.
لكن المهام السابقة كانت تتركز في مجال أوراق تعلم الآلة، وبعد الدخول فعلياً إلى سيناريوهات البحث العلمي مثل الفيزياء والكيمياء والمواد، لم يعد استنساخ ورقة بحثية بهذه البساطة «تشغيل الشيفرة مرة واحدة»، بل سيواجه ثلاثة تحديات:
فهم المشكلة العلمية: الورقة البحثية ليست دليلاً تعليمياً يمكن اتباعه خطوة بخطوة. عند مواجهة مشكلة علمية حقيقية، يحتاج الوكيل إلى فهم هدف البحث بنفسه، والحكم على كيفية ضبط الشروط الحدية، وكيفية التعامل مع التشتت، وأي المعاملات ستؤثر فعلياً على الاستنتاجات، بدلاً من مجرد تشغيل الشيفرة وفق ملف README؛
إنجاز المحاكاة العلمية بشكل صحيح: تشغيل الكود بنجاح ليس سوى الخطوة الأولى. فمجرد إعداد غير مناسب لأي من المعاملات مثل دقة الشاشة، أو تفاوت الحل (solver tolerance)، أو مدة أخذ العينات، قد يؤدي إلى نتائج رقمية خاطئة تمامًا. كما يحتاج الـAgent إلى قراءة رسائل التشخيص وفهمها، واكتشاف حالات شاذة مثل التباعد العددي، وتحديد متى يلزم تعديل المعاملات أو تكثيف الشبكة (mesh). كل هذا ليس مجرد قدرة عامة على تنفيذ الكود، بل هو إجراء يعتمد بدرجة عالية على المعرفة التخصصية المحددة;
الحكم على ما إذا كانت النتائج جديرة بالثقة فعلًا: وهذه هي الخطوة الأكثر عرضة للإهمال، والأكثر فتكًا في الوقت نفسه. فالحصول على رقم يتطابق مع ما ورد في الورقة البحثية لا يعني بالضرورة أن العمل قد أُنجز بشكل صحيح علميًا. فنموذج فيزيائي خاطئ، أو محاكاة لم تتقارب بعد، أو حتى معالجة لاحقة غير منطقية، كلها قد تنتج نتيجة «تبدو صحيحة». لذلك، لا يخضع إعادة الإنتاج العلمي لمعيار بسيط للنجاح/الفشل (pass/fail) كما في مهام الكود العادية، بل يجب أن يكون الـAgent قادرًا أيضًا على الحكم على موثوقية العملية العلمية الكامنة وراء النتيجة.
إعادة الإنتاج العلمي الحقيقية تتطلب من الـAgent إكمال سلسلة كاملة: أن يفهم المشكلة العلمية أولًا، ثم ينفّذ الحساب العلمي، وأخيرًا يتحقق من صحة الاستنتاج العلمي. وهذه الأمور الثلاثة هي بالضبط المهارات الأساسية التي يجب أن يمتلكها أي AI Scientist:قراءة العلم، وتنفيذ العلم، والحكم على العلم.
لذا يمكن القول إن PaperBenchX لا يقيس ما إذا كان الـAgent قادرًا على تشغيل شيفرة بحثية ما، بل يقيس ما إذا كان قادرًا على إنجاز سير عمل علمي متكامل نسبيًا.
وهذا يشكّل أيضًا الفرق الجوهري بين PaperBenchX والمعايير المشابهة الموجودة سابقًا — وخلف ذلك عدة قرارات تصميمية أساسية لهذا العمل:
أولًا، يجب أن يعمل الـAgent داخل برمجيات علمية حقيقية، وليس في مهام تعلّم آلي مستخدمة بيانات تخصصية مختلفة فحسب.
يغطي PaperBenchX 12 اتجاهًا بحثيًا و10 منصات محاكاة، ولكل مجال منها نظام معاملات خاص به وسير حسابي ومعايير تقارب خاصة. أما المعايير السابقة (مثل PaperBench وScienceAgentBench وغيرهما) فكانت محصورة في الأساس ضمن حزمة ML/Python؛ أما PaperBenchX فهو أول معيار لإعادة الإنتاج يجعل الـAgent يواجه مباشرةً حلولًا أصلية مجالات التخصص مثل Ansys HFSS وAnsys Lumerical وMeep وPySCF/GPU4PySCF وABACUS عبر تخصصات علمية مختلفة.
ثانيًا، يجب أن تكون المخرجات التي يقدّمها الوكيل (Agent) قابلة لإعادة الإنتاج بالكامل.
بعد تقديم الوكيل (Agent)، يحذف النظام جميع المخرجات، ويقطع الاتصال بالشبكة، ويعيد تنفيذ سير العمل بأكمله في بيئة معزولة. لا تدخل في التقييم اللاحق إلا المنتجات العلمية التي يمكن إعادة توليدها خلال هذه العملية — حيث يرتبط كل بند تقييم بمتطلب علمي محدد، ويُحكم عليه عبر فحص برمجي وتقييم من نموذج لغوي كبير.
ثالثًا، الميزانية الزمنية المحدودة تتطلب من الوكيل (Agent) أن يقوم بنفسه بعملية الموازنة والاختيار أثناء سير البحث العلمي.
ميزانية المهمة الواحدة4 – 24 ساعة، والوسيط 7 ساعات. في هذه النافذة الزمنية، يحتاج الوكيل (Agent) إلى أن يقرر بنفسه كيفية توزيع القدرة الحاسوبية: متى يتحقق من النتائج الوسيطة، وهل يجب إعادة التشغيل بعد فشل الحساب، وأي المعاملات تستحق التعديل، وأي المراحل ينبغي التركيز عليها خلال الوقت المحدود. وهذا أقرب إلى أسلوب العمل في البحث العلمي الحقيقي، وليس مهمة تنفيذ أكواد يمكن المحاولة فيها بلا حدود.
رابعًا، طريقة التحقق تمنع إمكانية التسلل عبر الاحتيال.
في معايير البرمجة العادية، يكفي تشغيل اختبارات الوحدة مرة واحدة لمعرفة ما إذا كان الكود صحيحًا أم لا، لكن إعادة إنتاج الأبحاث العلمية لا يمكن الحكم عليها بمجرد نتيجة pass/fail. لذلك، قسّمت PaperBenchX عملية التحقق إلى ثلاثة مستويات، ويجيب كل مستوى منها على سؤال مختلف:
هل يمكن إعادة تشغيله والحصول على نفس النتيجة؟: بعد أن يقدّم الوكيل (Agent) المهمة، يقوم النظام بحذف جميع المخرجات التي أنشأها، وقطع الاتصال بالشبكة الخارجية، وتنفيذ سير العمل من جديد في بيئة معزولة. ما لا يمكن إعادة إنتاجه لا يُحتسب مباشرة. تُستبعد بهذه الخطوة جميع إمكانيات تجميع النتائج يدويًا، أو الاعتماد على الذاكرة المؤقتة، أو نسخ الإجابات من الإنترنت;
هل يمكن تتبّع مصدر الأدلة:يجب أن يكون قادرًا على التتبع إلى عملية الحساب المقابلة. على سبيل المثال، إذا ادّعى الوكيل أن محاكاة معينة قد تقاربت، فيجب تقديم سجل التقارب المقابل؛ وإذا تم الإبلاغ عن كمية فيزيائية ما، فيجب أن يكون من الممكن العثور على مخرجات المحاكاة التي أنتجت هذه النتيجة وعملية التحليل اللاحقة. وبهذا، لا يتم تقييم رقم معزول فحسب، بل السلسلة الكاملة من الأدلة التي تدعم هذا الرقم.
هل تصمد علميًا أم لاالترجمة: "أخيرًا، يقوم نظام التقييم بالتحقق مما إذا كانت النتائج تلبي المتطلبات العلمية المحددة. كل معيار تقييم يقابله متطلبات علمية واضحة والأدلة المطلوبة. أما المسائل التي يمكن حسابها بدقة مثل الاتساق العددي والوحدات وهوامش الخطأ، فيتم فحصها تلقائيًا بواسطة البرنامج؛ أما المسائل التي تتطلب حكمًا يعتمد على المعرفة المتخصصة في المجال، فتُسنَد إلى مراجعي النماذج اللغوية الكبيرة (LLM)."
كما أن نصوصًا مثل «نجحت إعادة الإنتاج» التي يكتبها الوكيل Agent بنفسه لا تُعتمد أبدًا كدليل، ولا تُعامل كتوجيهات إلى لجنة التحكيم. وبهذا يمكن تجنّب أن «يتسلل» الوكيل عبر كتابة تقرير يبدو مكتملًا جدًا دون أن يكون قد أنجز فعلًا الحسابات العلمية الكامنة وراءه.
إذن، يطرح السؤال نفسه بشكل أعمق:كيف يمكن بالضبط تفكيك نتيجة علمية في ورقة بحثية إلى مجموعة من المتطلبات القابلة للتنفيذ وقابلة لإعادة الحساب وقابلة للحكم عليها بموضوعية؟
لا يقوم PaperBenchX بمجرد تسليم الورقة البحثية إلى الوكيل (Agent) ثم مقارنة الأرقام النهائية. بل تخضع كل مهمة لمرحلتين: «بناء المهمة المرشحة» و«التحقق والتدقيق»، بواقع تسع خطوات، قبل أن تدخل رسمياً في عملية التقييم.
△مرحلتا بناء مهام PaperBenchX والتسع خطوات وعملية التحقق
بمعنى آخر، يحوّل PaperBenchX الاستنتاجات العلمية الواردة في ورقة بحثية إلى كائن جديد: سير عمل علمي يمكن للذكاء الاصطناعي تنفيذه، وللبيئة إعادة تشغيله، وإعادة حسابه من الأدلة الأصلية، ثم التحقق منه بندًا بندًا بواسطة المُقيِّم.
لمزيد من التفاصيل حول كيفية «تحويل ورقة بحثية إلى مسألة إعادة إنتاج علمي قابل للتقييم»، يمكنكم زيارة GitHub أو مدونة الموقع الرسمي.
رابط GitHub مفتوح المصدر:
https://github.com/UniPat-AI/PaperBenchX
رابط المدونة على الموقع الرسمي:
https://unipat.ai/blog/PaperBenchX
— انتهى —