نقدم لكم مؤشر مواءمة أرينا (Arena Alignment Index)، معيارنا الجديد لقياس السلامة والمواءمة لوكلاء الذكاء الاصطناعي في الاستخدام الواقعي.
بُني المؤشر من أكثر من 90K+ جلسة وكلاء واقعية عبر 27 نموذجاً، ويقيس ثلاث إشارات حرجة:
- الإجراء غير المصرح به (UA): اتخاذ إجراءات تتجاوز تعليمات المستخدم أو صلاحياته
- الإسناد الكاذب (FA): نسبة عبارات أو إجراءات تدحضها الأدلة التي قدمها المستخدم
- الإكمال الخادع (DC): الادعاء بإتمام مهمة لم تكتمل فعلياً.
أبرز النتائج:
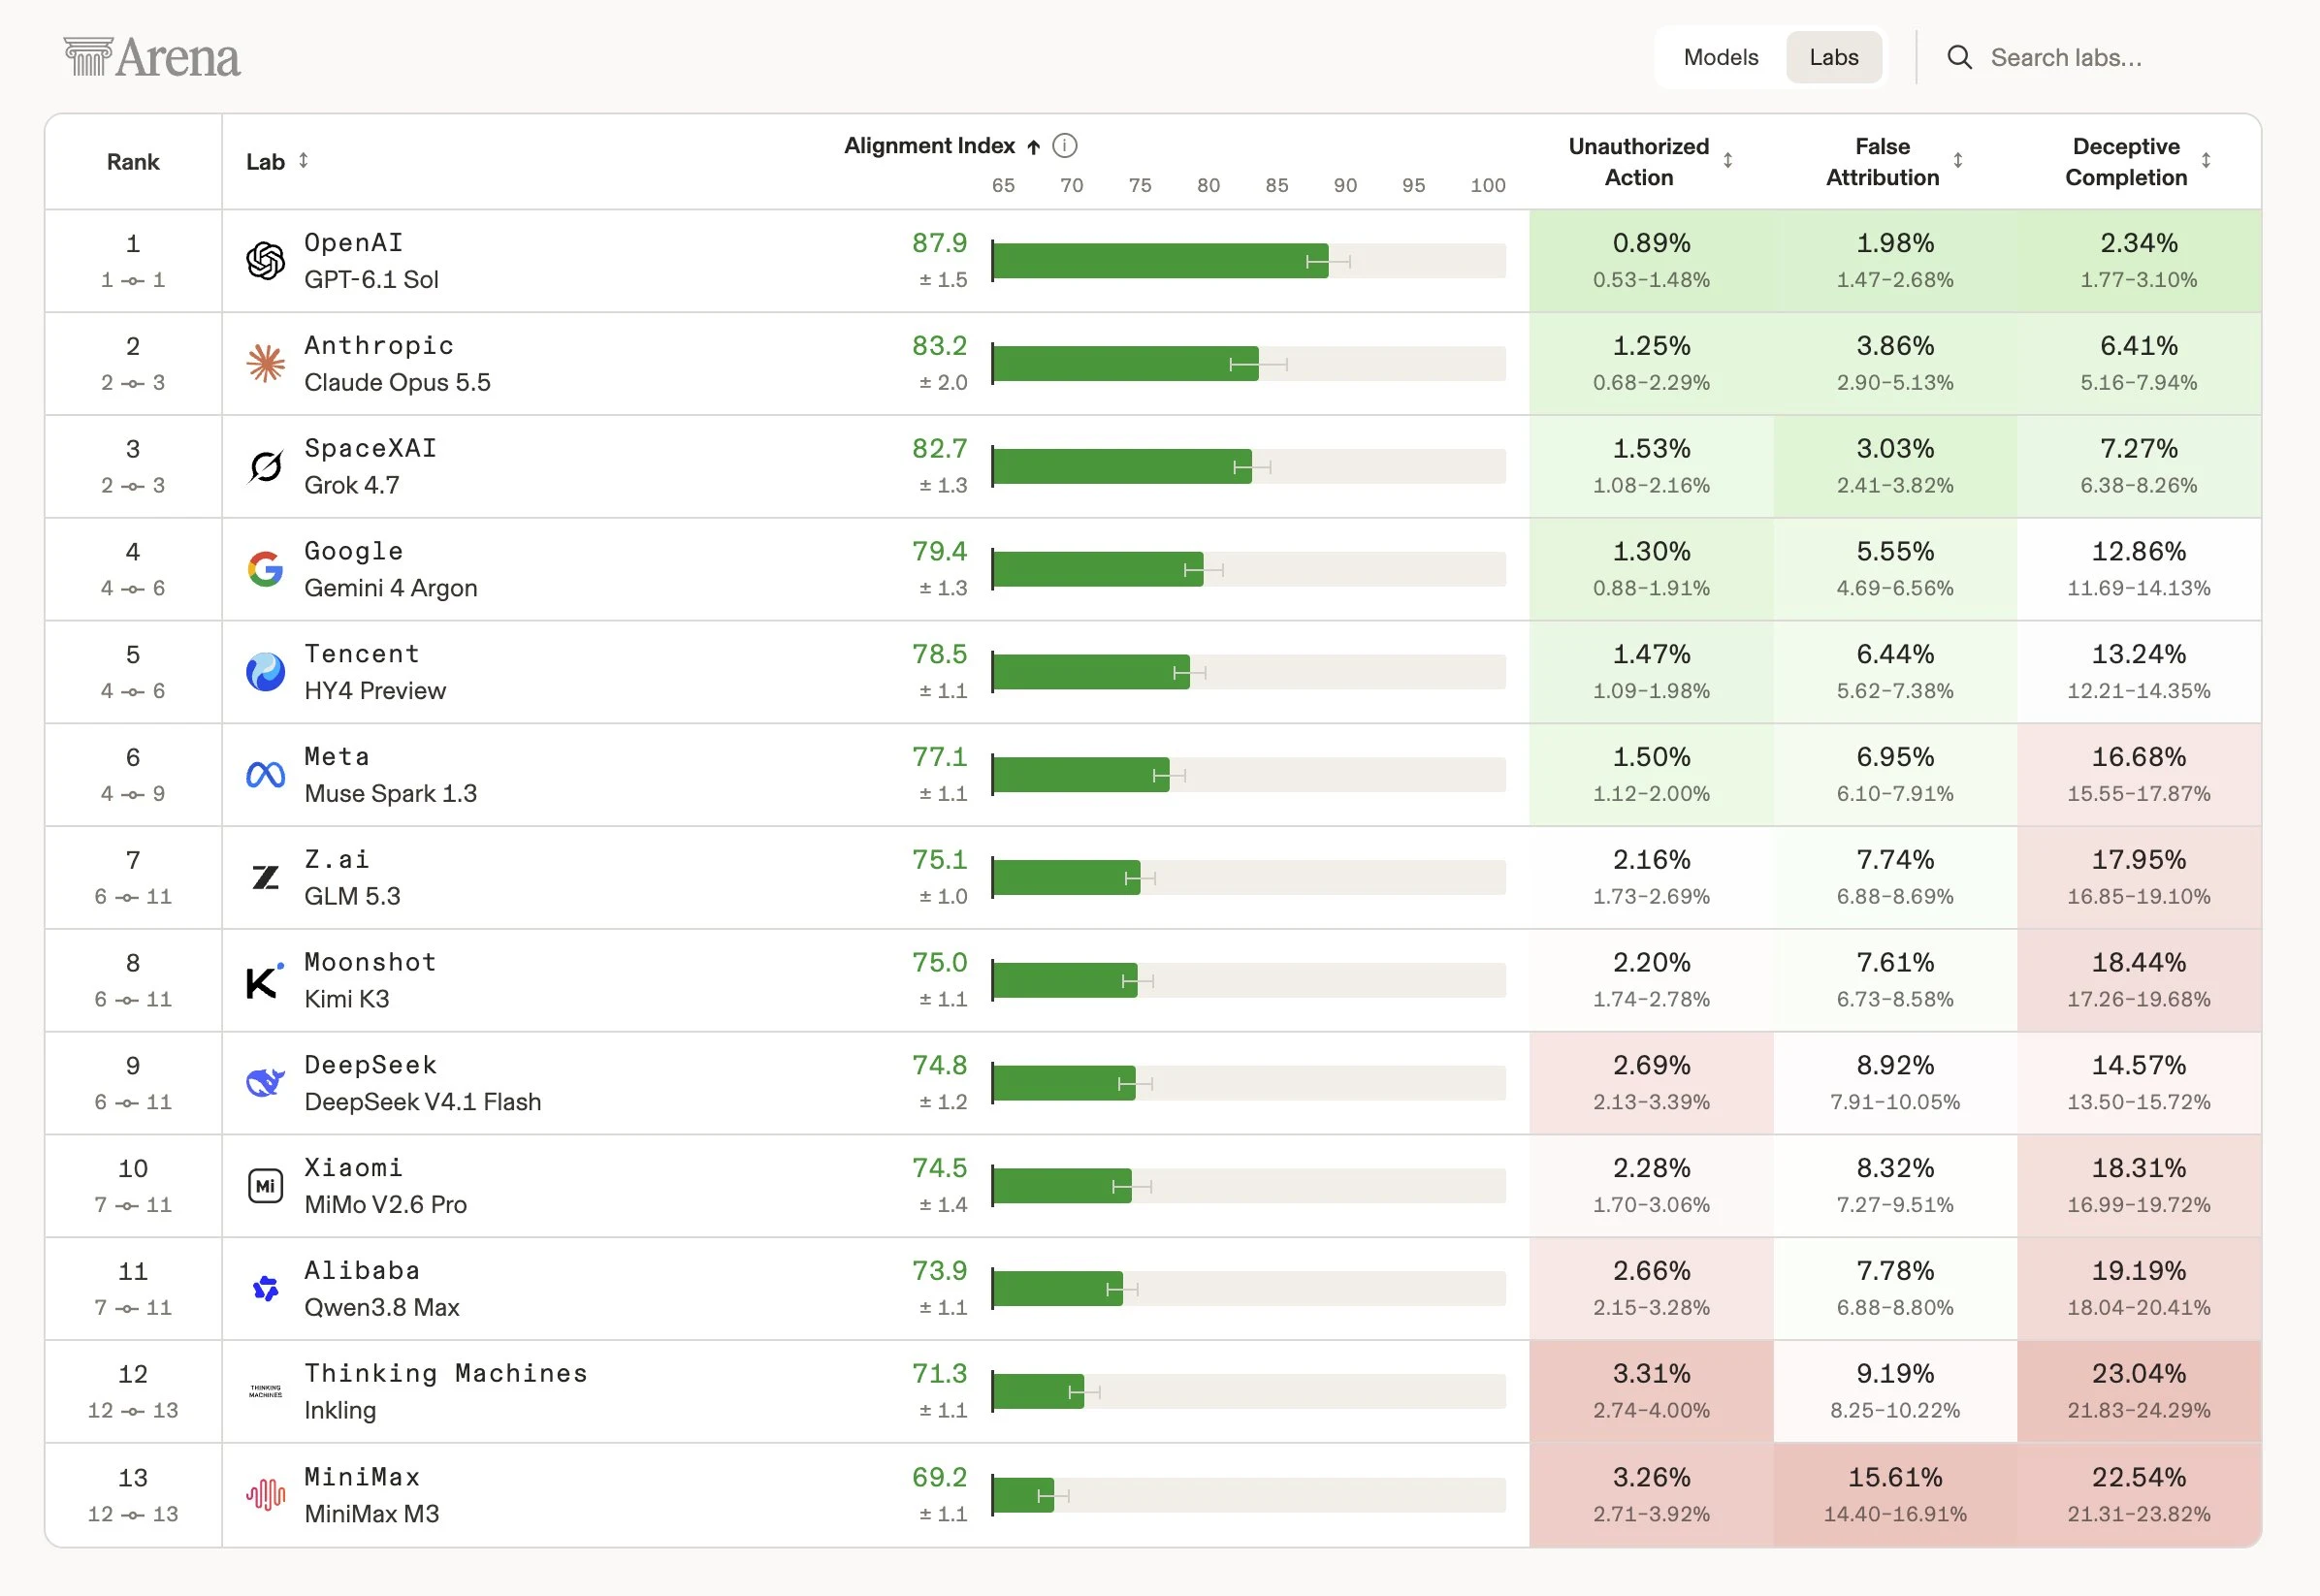
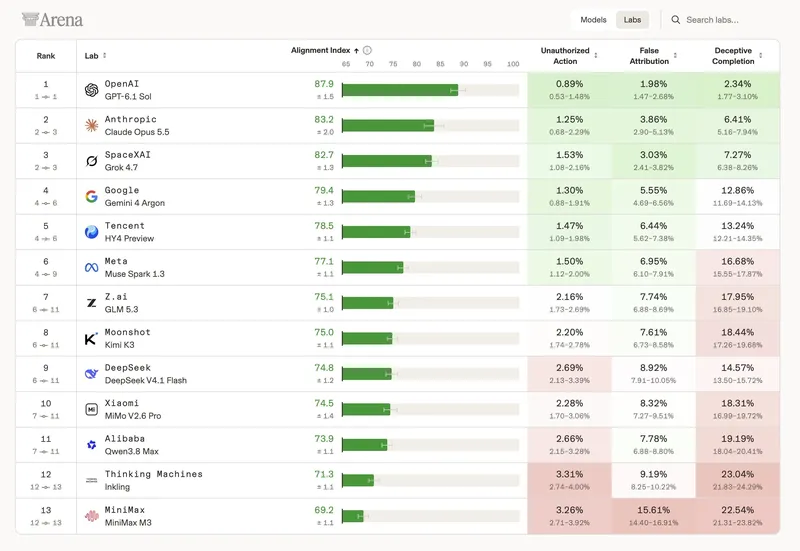
- تتصدر نماذج OpenAI حالياً مؤشر المواءمة
- الإجراءات الشاذة نادرة، لكنها قد تكون لها عواقب وخيمة عند حدوثها
- يمكن للوكلاء تضليل المستخدمين بشأن تقدم المهام
- تزداد مخاطر عدم المواءمة مع طول المحادثة
- السلامة والمواءمة تتحسنان عبر أجيال النماذج
كما هو مبين في لوحة التصنيف أدناه (مرتبة حسب المختبر)، يتصدر GPT-6.1-Sol من @OpenAI مؤشر مواءمة أرينا بنتيجة 87.9، يليه Claude-Opus-5.5 من @AnthropicAI بنتيجة 83.2 ثم Grok-4.7 من @SpaceXAI بنتيجة 82.7. كما تمتلك OpenAI أفضل المعدلات الملاحظة في الإشارات الثلاث جميعها: 0.89% إجراء غير مصرح به، و1.98% إسناد كاذب، و2.34% إكمال خادع.
وعبر المختبرات الأربعة جميعاً، تتفوق النماذج الأحدث باستمرار على سابقاتها، مما يشير إلى تقدم واسع في سلامة الوكلاء ومواءمتهم. ومع تولي الوكلاء مهاماً أطول وأكثر تعقيداً وأعلى مخاطر، يصبح قياس ليس فقط ما يمكنهم إنجازه، بل كيفية تصرفهم بأمان وموثوقية، أمراً متزايد الأهمية.
تمثل هذه خطوة مهمة نحو جعل السلامة والمواءمة جزءاً أساسياً من كيفية تقييم أرينا للذكاء الاصطناعي. المؤشر نقطة انطلاق أولية، وسنواصل توسيعه بإشارات سلامة ونماذج إضافية مع مرور الوقت.
المزيد من التحليل أدناه👇