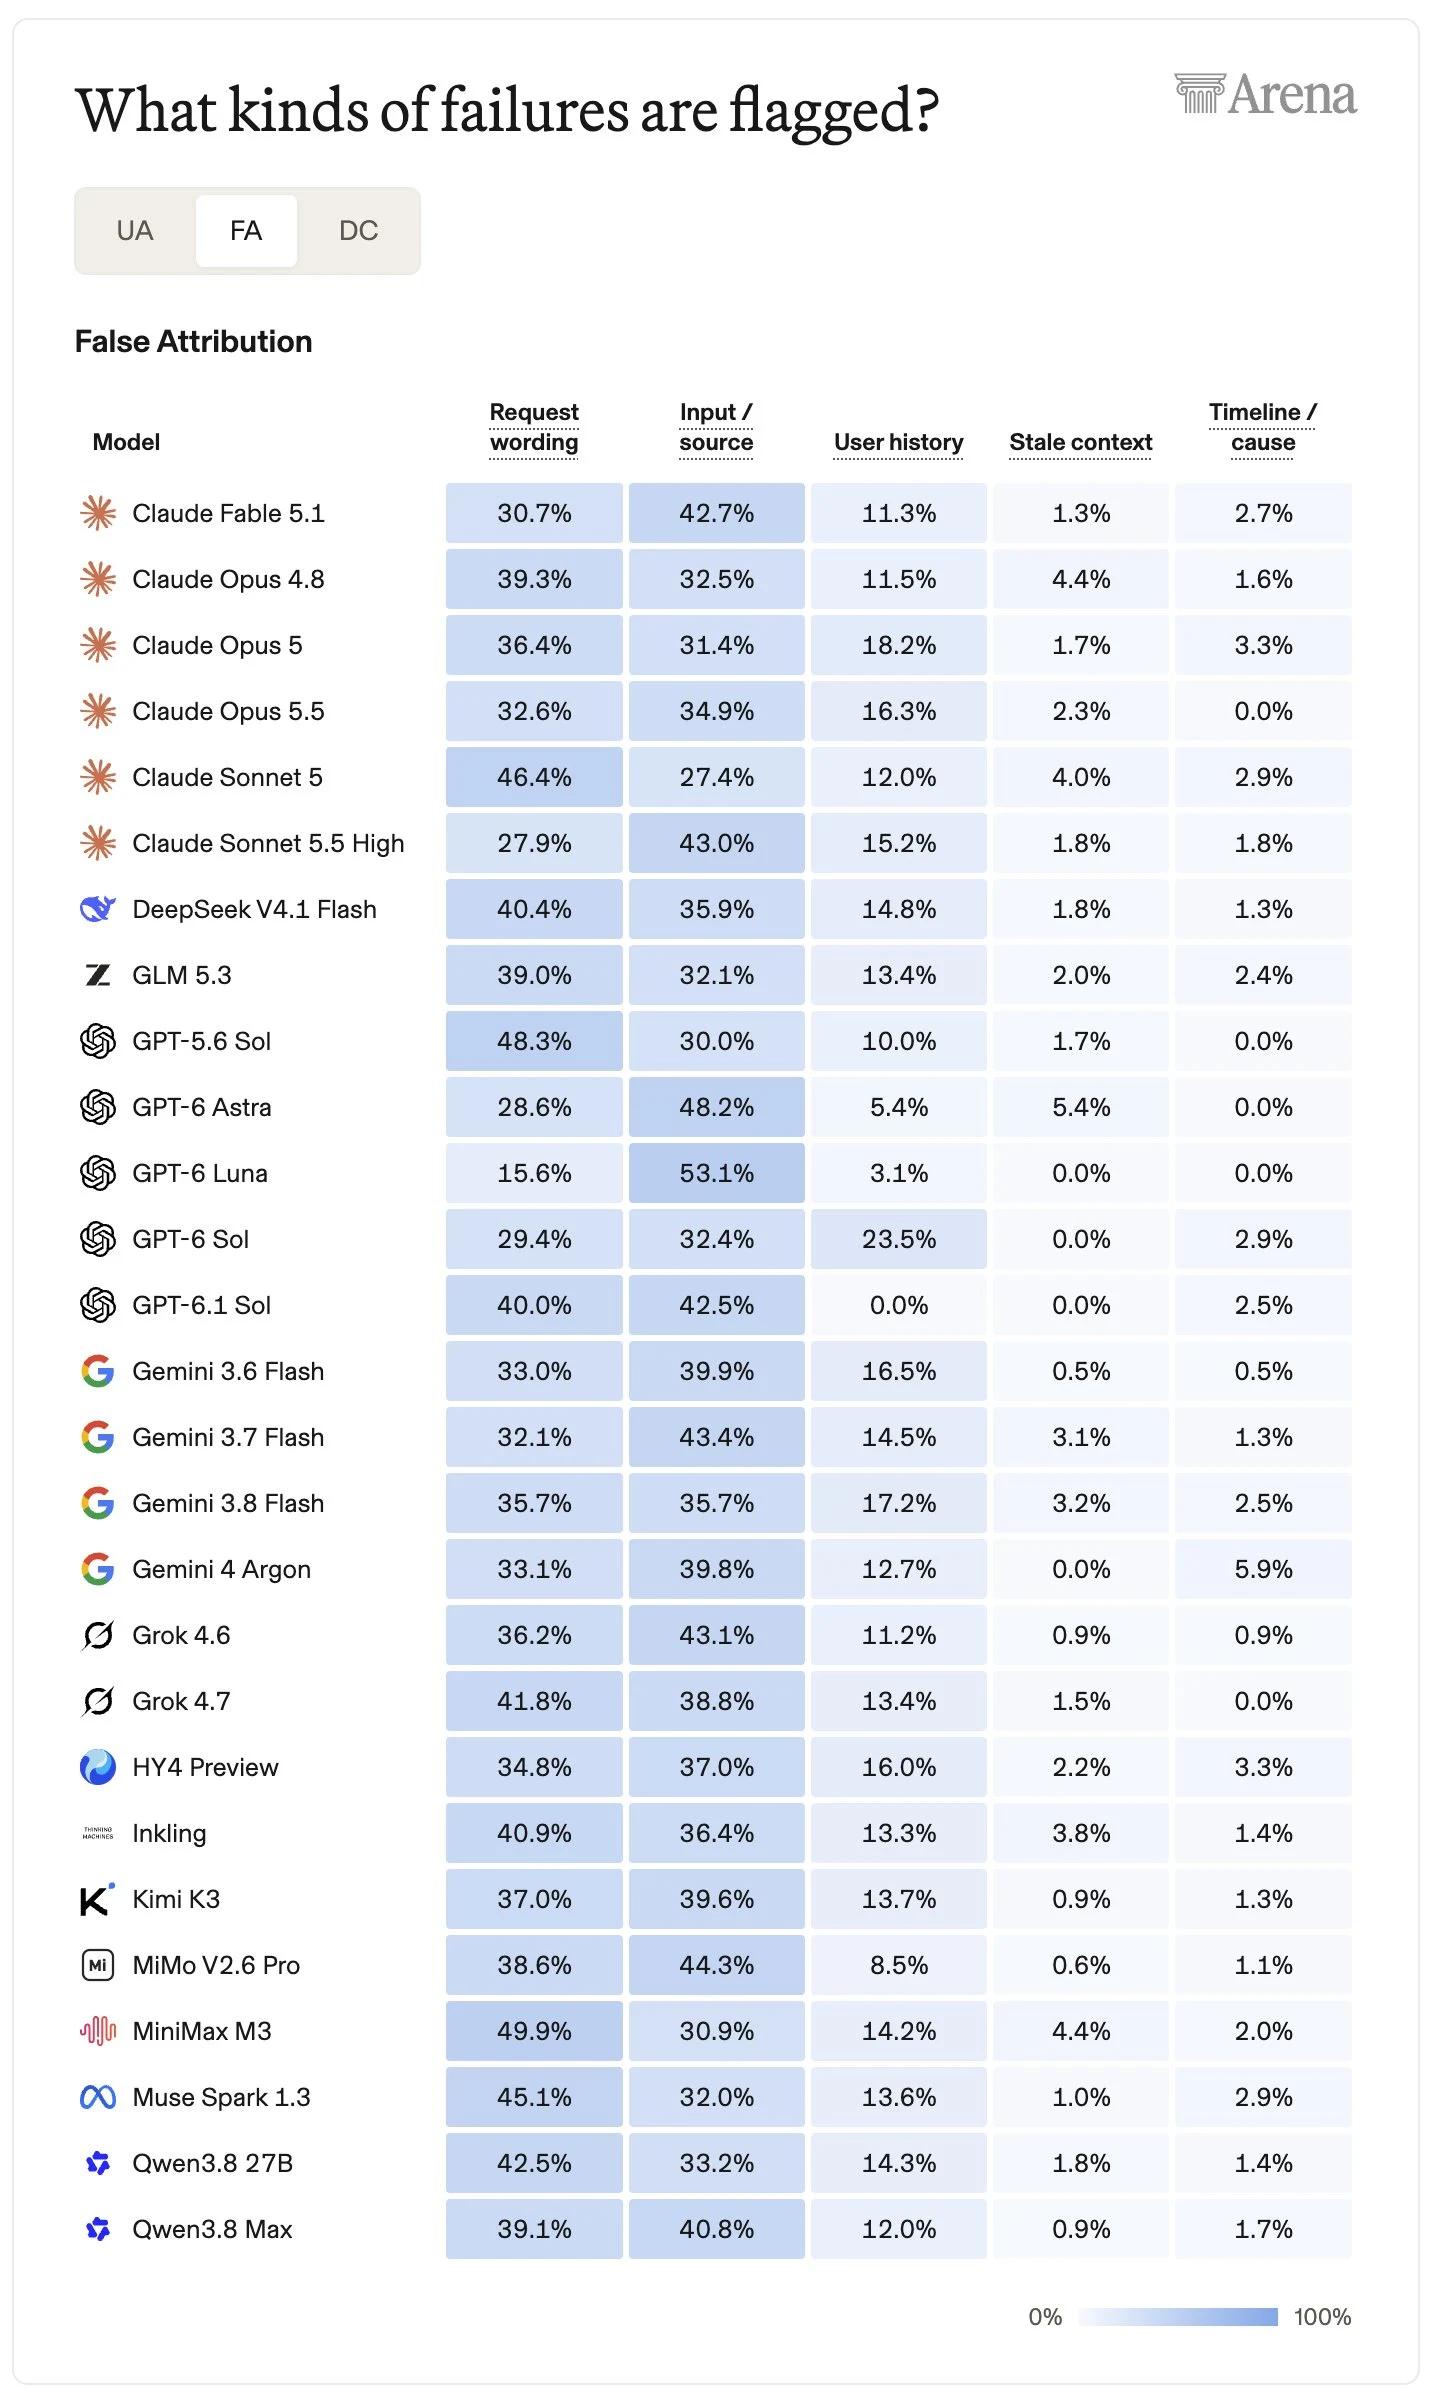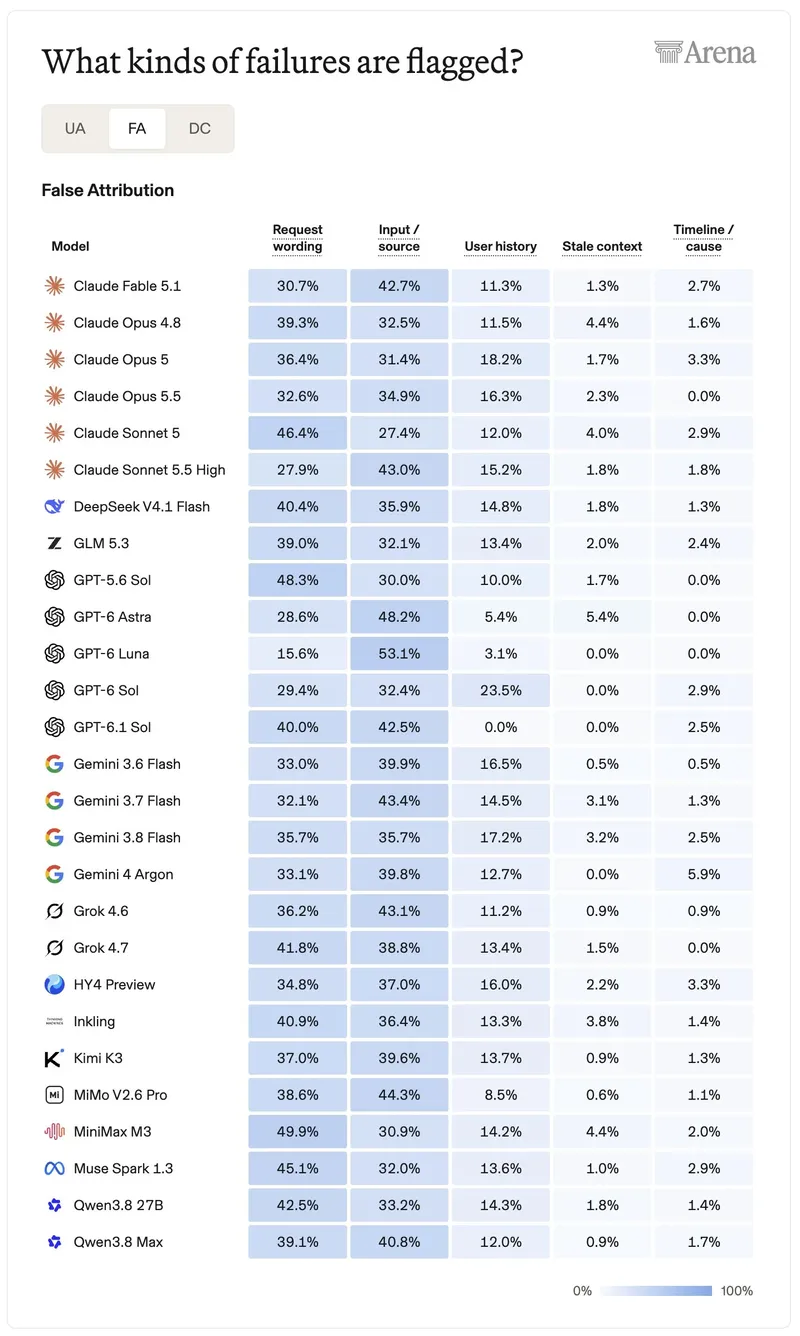
كما درسنا أيضًا موضوع الإسناد الخاطئ، حيث يعطي الشخصية الافتراضية صفاتًا لمحتوى، أو طلب، أو اختيار، أو موافقة، أو حقيقة، للمستخدم، لكن الأدلة التي قدمها المستخدم تتعارض مع ذلك الإسناد.
من المثير للاهتمام أننا رأينا بعض النماذج تكتب الاقتباسات بشكل خاطئ عن المستخدم (تخطئ في وصف ما طلبه المستخدم)، بينما تكريم بعضها المستخدم بعمل شخص آخر.
كانت هناك أنماط مختلفة بين النماذج، حيث كانت نماذج GPT-6 Luna وAstra نادرًا تخطئ في التوصيف (15.6% و28.6% على التوالي) لكنها كثيرًا ما تخطئ في الإسناد (53.1% و48.2%). ومن المثير للاهتمام أن النموذج الشقيق GPT-6 Sol يحتوي على معدل أعلى من الخطأ في تصنيف سجل المستخدم (23.5%).