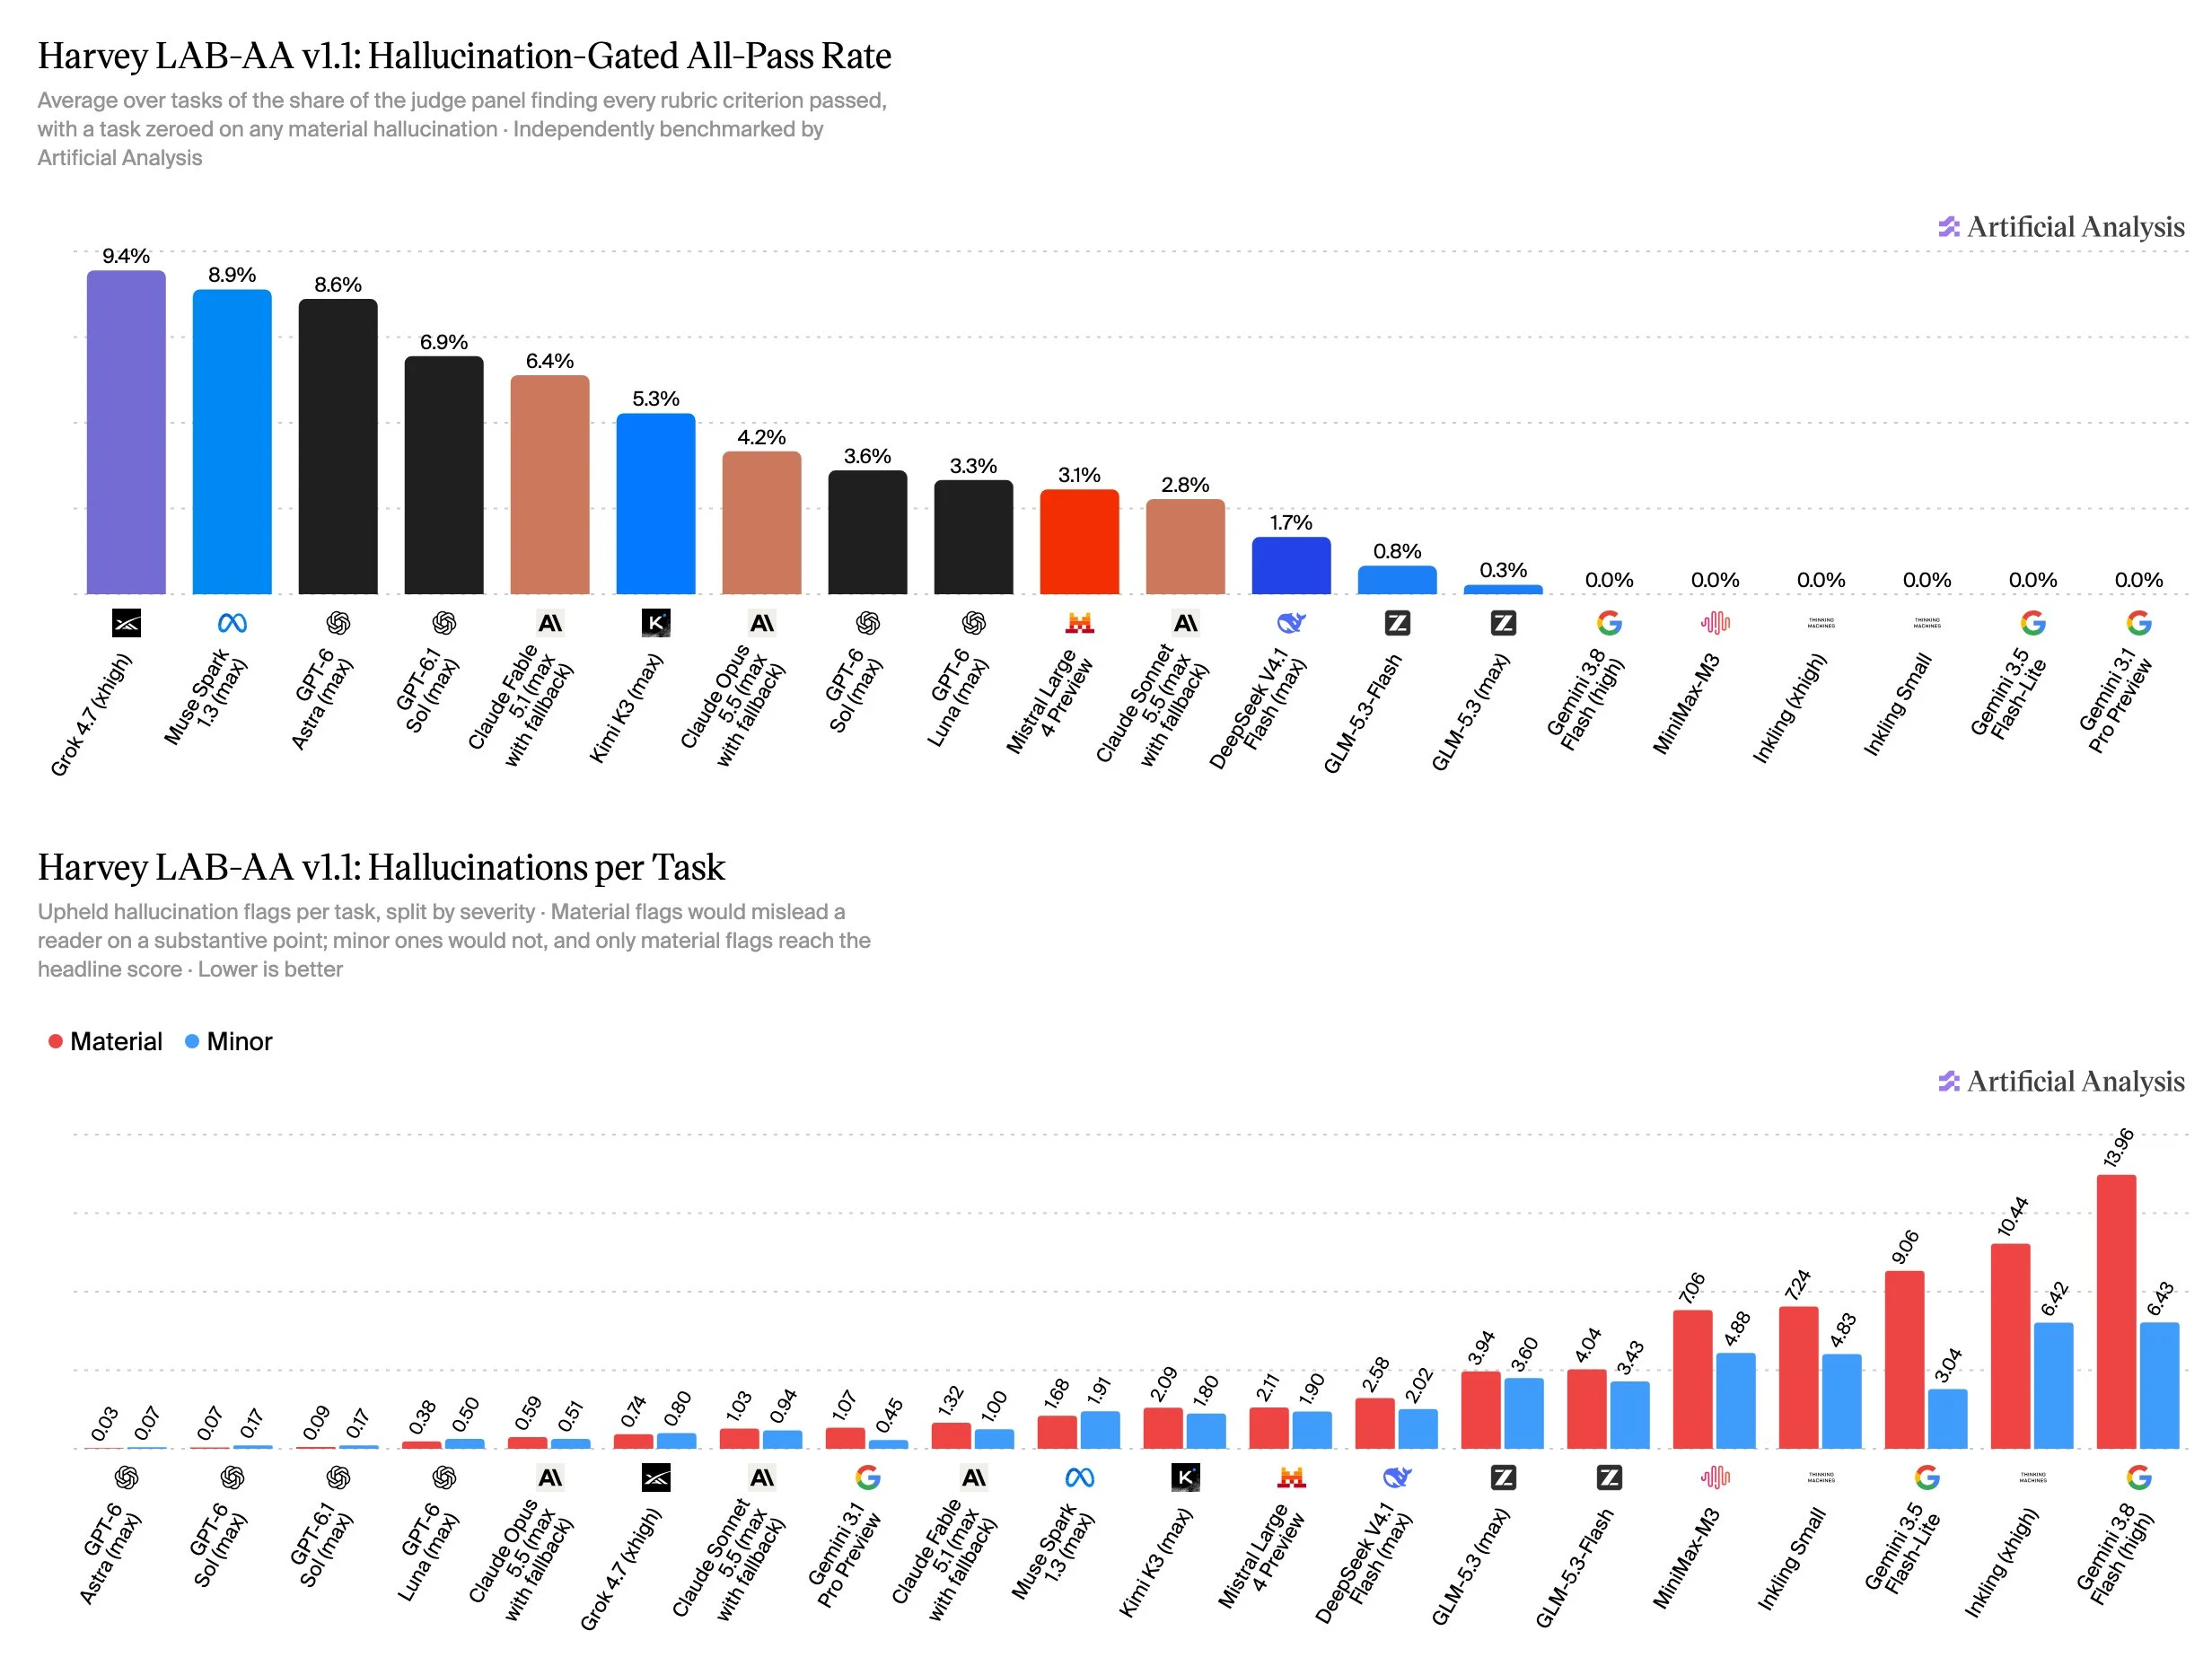
نعلن اليوم عن Harvey LAB-AA v1.1 بالتعاون مع Harvey. يحدّث هذا منهجية التقييم لدينا لمعيار Legal Agent Benchmark (LAB) لإضافة فحص للهلوسة واشتراط ألّا تتضمن الإجابات الصحيحة تحريفات جوهرية. إنّ المقياس الرئيسي الجديد في LAB-AA v1.1، وهو معدل النجاح الكامل المقيّد بالهلوسة، لا يمنح درجة للمهمة إلا عندما تستوفي المخرجات كل معيار من معايير سلم التقييم ولا تحتوي على أي هلوسة جوهرية.
نُعرّف الهلوسة الجوهرية بأنها تلك التي تضلّل القارئ في نقطة جوهرية، مثل تاريخ تعاقدي مطلوب غير صحيح، بينما الهلوسة الطفيفة هي خطأ حقيقي من غير المرجح أن يؤثر بشكل ملموس على التفسير القانوني للمخرجات. تُبلّغ الهلوسات الطفيفة على حدة ولا تؤثر في الدرجة الرئيسية.
يتصدّر Grok 4.7 (xhigh) بمعدل نجاح كامل مقيّد بالهلوسة بلغ 9.4%، كما أن أكثر من 60% من النتائج الناجحة لولا ذلك عبر النماذج التي اختُبرت عند الإطلاق تحتوي على هلوسة جوهرية.
هذه هي الخطوة الأولى في تعزيز منهجية Harvey LAB-AA. في التحديثات المقبلة، نعمل مع Harvey على أن نأخذ بالحسبان على نحو أفضل المجموعة الكاملة من العوامل التي يقدّرها المحامون، بما في ذلك ميزات سهولة الاستخدام كالأسلوب والنبرة.
أبرز النقاط:
➤ صدارة قائمة الترتيب: يتصدّر Grok 4.7 (xhigh) من @SpaceXAI بمعدل نجاح كامل مقيّد بالهلوسة بلغ 9.4%، متقدّمًا بفارق ضيق على Muse Spark 1.3 (max) من @AIatMeta بنسبة 8.9% وعلى GPT-6 Astra (max) من @OpenAI بنسبة 8.6%
➤ الهلوسات تعيد تشكيل قائمة الترتيب: بدون قيد الهلوسة، كان Muse Spark 1.3 (max) سيتصدّر بوضوح بمعدل نجاح كامل بلغ 26.7%، لكن ثلثي تلك النجاحات يتضمن هلوسة جوهرية واحدة أو أكثر، ما يؤدي إلى معدل نجاح كامل مقيّد بالهلوسة يبلغ 8.9%. يحتفظ GPT-6 Astra (max) تقريبًا بجميع نجاحاته بعد قيد الهلوسة (من 8.9% إلى 8.6%) ويتقدّم من المركز 10 المشترك إلى المركز 3
➤ عائلة نماذج GPT-6 هي الأكثر استنادًا إلى الوقائع: يبلغ متوسط الهلوسات الجوهرية في GPT-6 Astra (max) 0.03 هلوسة لكل مهمة (4 عبر جميع المهام البالغ عددها 120)، بينما يبلغ المتوسط في GPT-6 Sol (max) 0.07. وعند مقارنة ستة نماذج مدقّقة على مجموعة فرعية من 20 مهمة، سجّل GPT-6 Astra صفر هلوسة جوهرية لدى كل مدقّق، بما في ذلك Claude Opus 5.5 (high). وبالمقارنة، يبلغ المتوسط في Gemini 3.8 Flash (high) 13.96 هلوسة جوهرية لكل مهمة.
➤ النماذج الأعلى تقييمًا ليست الأغلى ثمنًا: يحتل Grok 4.7 (xhigh) المركز الأول في قائمة الترتيب بكلفة تبلغ نحو $9.50 لكل مهمة، أي أقل من نصف كلفة Claude Fable 5.1 (max with fallback) البالغة نحو $21.70، وهو النموذج الأغلى. ويمثّل Muse Spark 1.3 (max) أداءً قويًا مقابل كلفته، إذ حلّ في المركز الثاني بنحو $4.20 لكل مهمة
شكرًا لكل من @nikogrupen و@ItsJulioPereyra من @harvey على عملهما في Harvey LAB والتعاون.