
تيان يانلين، من قاو فاي سي
QbitAI | الحساب العام QbitAI
يا للعجب! في سباق نماذج العمل العالمية (WAM)، قفز فريق صيني مباشرةً إلى المركز الأول عالميًا؟!
علاوة على ذلك، فقد تُركت هذه المرة وراءنا مجموعة من نماذج التجسيد الرائدة عالميًا مثل GPT-6-Astra وπ0.5 من Physical Intelligence وGR00T-N1.7 من إنفيديا.
من نفّذ ذلك شركة روبوتات صينية —شينغدونغ جييوان (星动纪元)، الشركة التابعة الوحيدة المملوكة لها أسهم من تسينغهوا في مجال الذكاء الجسدي。
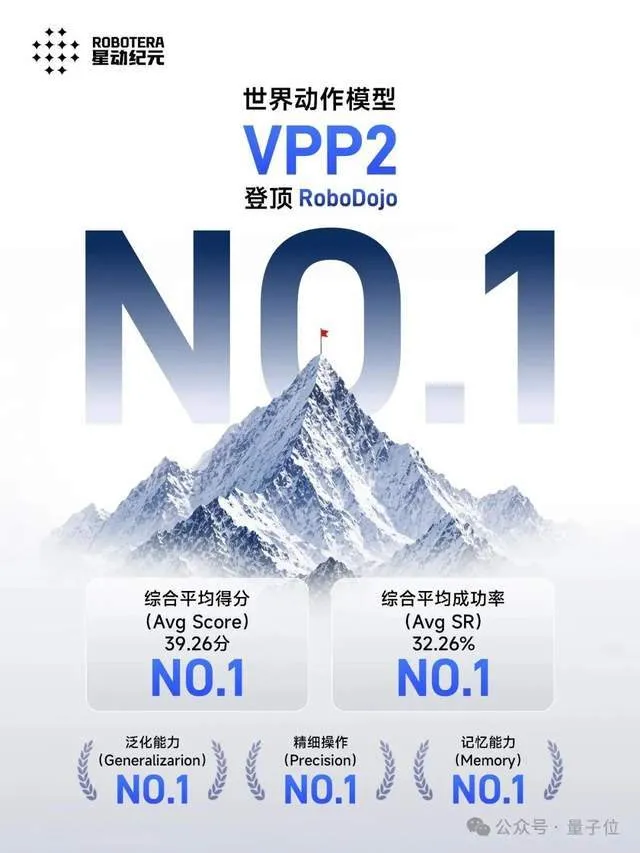
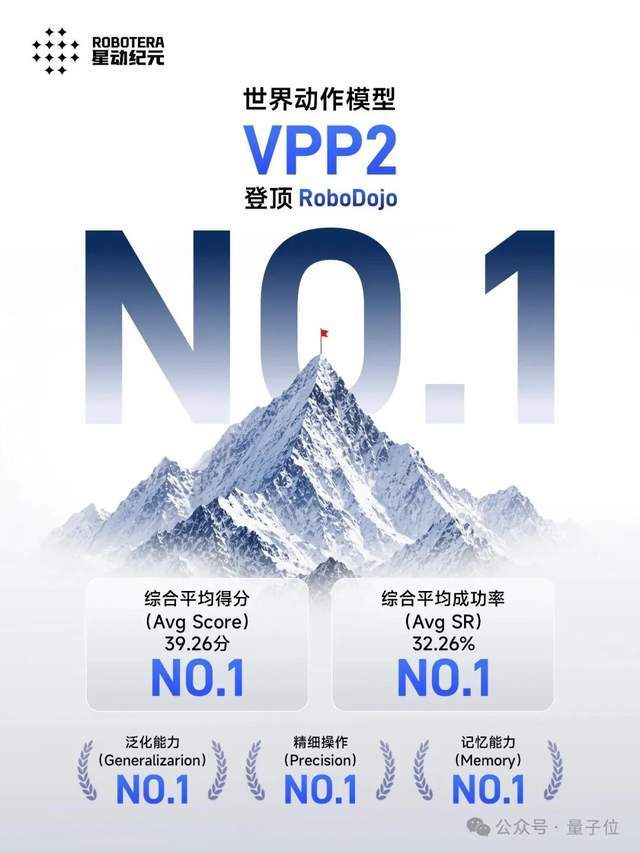
حديثًا، أعلنت شركة Star Era (星动纪元)نموذج الحركة العالمي VPP2 المطوَّر ذاتيًاتصدّر بمحض الصدفة قمةلوحة تصنيفات RoboDojo المحاكية。
بنسبة نجاح مُجمَّعة متوسطة بلغت 32.26% ومتوسط نقاط مُجمَّع بلغ 39.26 نقطة، محققًا المركز الأول في كلا المؤشرين.
والأهم من ذلك أن هذه المسابقة لم تكن سهلة أصلًا.
يُلقَّب RoboDojo بـ«قمة إيفرست» لعالم الذكاء المُجسَّد، وقد أُنشئ بقيادة MMLab التابع لجامعة هونغ كونغ، وبمشاركة نحو 20 مؤسسة أكاديمية عريقة من مختلف أنحاء العالم.
وهو يختبر الروبوتات تحديدًا في نقاط ضعفها: هل لا يزال قادرًا على أداء العمل عند تغيير البيئة؟ هل يستطيع الإمساك بالأشياء بدقة إذا كانت موضوعة بشكل منحرف؟ هل يتذكر ما حدث سابقًا إذا انقطعت المهمة في منتصفها؟
باختصار، لن يمرّ بمجرد التدرّب على الأمور بمهارة وتمويه الناس.
وماذا كانت النتيجة؟
لم يقتصر الأمر على حصول VPP2 من شركة Robot Era على المركز الأول المُجمَّع فحسب، بل تصدّر أيضًاالقدرة على التعميم، والعمليات الدقيقة، وقدرة الذاكرةفي الأبعاد الثلاثة جميعًا.
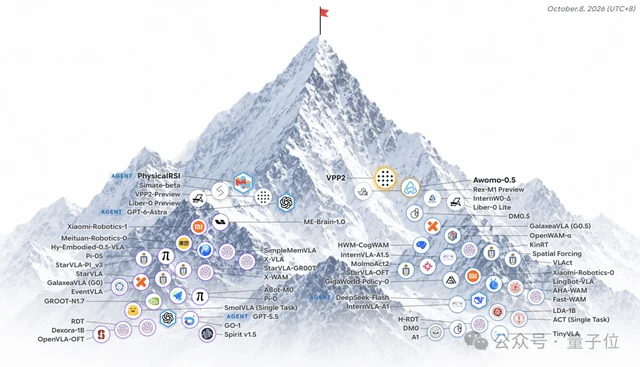
ويُقال إن VPP2 هذه المرةلم يُضف إليه بيانات إضافيةولم يستخدمأي وسائل تعزيزية مثل Agent RSI,بل اعتمد فقط على «مجموعة البيانات القياسية»، ومع ذلك أسقط نخبة من المتميزين في هذا المجال.
وهذا يعني أن نموذج VPP2 قوي بذاته بدرجة كافية، وأن تحسّن الأداء جاء من التدريب المسبق، وأن النموذج الأساسي قابل للتعميم بدرجة كافية، ولذا لم يعتمد على استراتيجيات تعزيزية خارجية، ولا على توسيع البيانات لـ«رفع النقاط».
لحظة، صديقي، كيف بالضبط دُرِّب نموذج بهذا القوة؟؟؟
تعمّقنا في المسار التقني للنظام، ولنقل إن VPP2 حقق هذه المرة اختراقًا فيه ما يستحق الذكر حقًا.
فقد استهدف مشكلة قديمة وعويصة في نماذج العالم: إذا كان التنبؤ خاطئًا، فستكون الحركة خاطئة تبعًا لذلك.
الحل الذي قدّمه VPP2 هو تدريب قدرة التنبؤ بالفيديو أولًا حتى تصل إلى قوة كافية، ثم جعل الروبوت يتحرك فعليًا في بيئات غير مألوفة.
من التنبؤ إلى العمل، تتحسّن قدرتا التعميم معًا.
وبالنظر إلى نتائج الاختبارات المتعددة التي تم الكشف عنها حتى الآن، أصبح VPP2 أحد أكثر المتنافسين تنافسية في مسار نماذج العالم والحركة WAM.
نماذج العالم والحركة WAM: منافسة تُتوّج بطلًا جديدًا
ثمة ظاهرة محرجة إلى حد ما في صناعة الذكاء المُجسَّد.
عروض الروبوتات التوضيحية أصبحت أكثر بريقًا، ودرجات النماذج في قوائم الترتيب ترتفع باستمرار، لكن إذا سألنا بجدية: أي روبوت أكثر ذكاءً وأكثر قدرة على إنجاز العمل؟
فالإجابة ليست سهلة فعلًا.
على سبيل المثال، مطالبة الروبوت بالتقاط كوب. على طاولة شاهدها أثناء التدريب، قد يصيب المئة من المئة. لكن بمجرد تغيير الكوب أو تحريك موضعه، يبدأ فورًا في الشك بقدراته.
لنبحث إذن عن المهام التي تتطلب تنفيذ عدة خطوات متتالية.
ولهذا السبب تستحق منظومة التقييم RoboDojo هذه الاهتمام.
هدفها هو وضع معيار تقييم موحّد وقابل للتكرار للذكاء المُجسَّد، عبر اختبارات المحاكاةالتي تتضمن 42 مهمة تشغيل بذراعينوتغطي خمسة أبعاد: التعميم، والتحكم الدقيق، والمهام طويلة المدى، والذاكرة، وفهم التعليمات ذات المفردات المفتوحة.
ببساطة، الأمر يتعلق بإخراج الروبوت من منطقة الراحة الخاصة به.
قد تحقق نماذج الروبوتات التقليدية درجات شبه كاملة في المهام المألوفة، لكن بمجرد تغيّر البيئة أو مواضع الأجسام أو توليفات المهام، قد ينخفض معدل النجاح بشكل ملحوظ.
ويركّز RoboDojo تحديداً على فحص هذا النوع من الحالات المعقدة، لمعرفة مقدار القدرة على التعميم التي يمتلكها الروبوت عند مواجهة التغيّرات.
أما نتائج VPP2 هذه المرة، فهي لافتة للغاية.
بمعدل نجاح متوسط بلغ 32.26% ومتوسط نقاط قدره 39.26 نقطة، حيث تصدّر المؤشرين معاً.
وللمقارنة، في تقييمات ما بعد التدريب لمعيار RoboDojo المحاكاتي، بلغGPT-6-Astraمعدل النجاح المتوسط 22.48% ومتوسط النقاط 28.97 نقطة.
بينماVPP2يتقدّم بفارق 9.78 نقطة مئوية و10.29 نقطة.
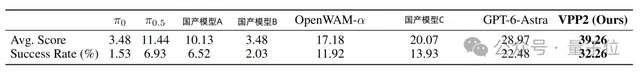
لقطة من الورقة البحثية، بيانات النماذج الأساسية مأخوذة من لوحة الصدارة الرسمية
لكلٍّ من المؤشرين هنا تركيز مختلف: معدل النجاح يرى ما إذا كان الروبوت قادراً على إكمال المهمة بالكامل؛ أما متوسط النقاط فيقيس إلى أي مرحلة وصلت المهمة، فحتى لو لم تكتمل بالكامل، فإنه يعكس الأداء المرحلي.
وكلا المؤشرين يجمعان نتائج الاختبارات عبر خمسة أبعاد للقدرات.
بعبارة أخرى،لا يكتمل VPP2 نسبة إنجاز المهام لديه أعلى فحسب، بل أظهر أيضاً قدرة إنجاز مرحلي أقوى تجاه المهام التي لم يتمكن من إتمامها.
فضلاً عن أن هذا التقدّم لا يقتصر على النتائج الإجمالية.
فعند تفكيك أبعاد القدرات الخمسة، تصدّر VPP2 أيضاً ثلاثة أبعاد: التعميم، والتشغيل الدقيق، والذاكرة.
وهذه القدرات الثلاث تقابل عقبات رئيسية يواجهها الروبوت عند دخوله العالم الحقيقي: هل يمكنه العمل في بيئة مختلفة، وهل يمكن أن تكون عملياته دقيقة، وهل يستطيع تذكّر الخطوات السابقة أثناء تنفيذ المهام المتتالية.
تصدّر في النتائج الإجمالية، وتميّز في القدرات الأساسية أيضاً.
ومع ذلك، مهما كان RoboDojo صعباً، يبقى ساحة الامتحان «بيئة محاكاة». وعند الوصول إلى العالم الفيزيائي، ستنشأ متغيّرات مفاجئة من احتكاك الأجسام وتشوّهها وانحراف مواضعها.
فقدرة التعميم التي أظهرها VPP2 في المحاكاة،هل ستبقى صامدة على الروبوت الحقيقي؟
أجرت شركة 星动纪元 تجارب أيضاً.
هذه المرة، نشر الفريق VPP2مباشرة على روبوت ALOHA الحقيقي ذي الذراعينواختبر 10 فئات من مهام التشغيل بدون أمثلة مسبقة، تشمل الإمساك والوضع والتكديس والطيّ والصب وغيرها.
أي أنه يجب على الروبوت أن يباشر العمل مباشرة دون الحاجة إلى ضبط دقيق إضافي مخصص لمهام الاختبار هذه.
وكانت النتيجة أن VPP2 قدّم نتائج متقدّمة مرة أخرى:معدل نجاح متوسط 58.5%، وهو أعلى من 40% لπ0.5.
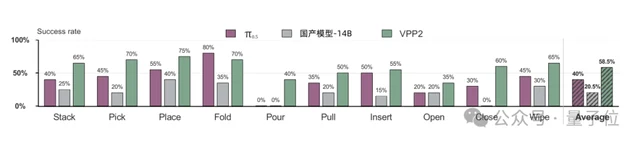
في 10 فئات من المهام، حقق VPP2 أفضل نتيجة في 9 فئات.
وهنا يصبح الأمر مثيراً للاهتمام.
صدارتها للقائمة تثبت قدراتها ضمن أنظمة التقييم المعيارية؛ أما التشغيل الصفري على الآلة الحقيقية فيفحص بدوره ما إذا كانت هذه القدرات قابلة للانتقال إلى البيئة الفيزيائية الواقعية.
عند وضع شهادتي التفوق جنباً إلى جنب، تصبح المزايا التقنية لـVPP2 أكثر جدارة بالتعمق فيها.
وتجدر الإشارة إلى أن VPP2 يتبع نهجنموذج الفعل العالمي (WAM)。
فالفكرة الأساسية لهذا النوع من النماذج هي الاستعانة بالتنبؤ بالفيديو لفهم كيف سيتغير العالم الفيزيائي بعد ذلك، ثم تحويل هذا التنبؤ إلى أفعال يقوم بها الروبوت.
لكن هذا النهج ظل يعاني من مشكلة طويلة الأمد: أن يكون التنبؤ بالفيديو رائعاً لا يعني أن الروبوت سيعمل فعلاً.
وهذه المرة، وجّه VPP2 جهده تحديداً نحو هذه المشكلة.
كيف حقق VPP2 الانتقال من تعميم التنبؤ إلى تعميم الفعل؟
لفهم إنجاز VPP2، فلنبدأ بمهمة بسيطة: أن يضع الروبوت الكوب الموجود على الطاولة داخل صندوق.
بالنسبة للبشر، فإن مدّ اليد والإمساك ورفعه ووضعه في مكانه لا يتطلب أي تفكير تقريباً.
لكن على الروبوت أن يحدّد موقع الكوب، ومسار حركة الذراع الميكانيكية، ومتى تُغلق الفاكمة، كما يجب أن يتنبأ بما سيحدث في العالم الفيزيائي طوال عملية التشغيل بأكملها. أي انحراف في أي خطوة قد يؤدي إلى الفشل.
نماذج الفيديو والحركة الحالية (WAM) هي بالضبط أكثر عرضة للمشكلات هنا.
من جهة، نماذج الفيديو العادية تجيد توليد الصور، لكن ظهور الصورة منطقياً شيء، وامتثالها للقوانين الفيزيائية الحقيقية شيء آخر.
على سبيل المثال، قد يُطلب من النموذج التقاط الكوب الموجود على اليسار، فيتنبأ بالتقاط الكوب الموجود على اليمين. سيظل الفيديو يتولّد، لكن الروبوت سينحرف مباشرة عند التنفيذ.
ومن جهة أخرى، فإن إدخال تعلّم الحركة مباشرة في نموذج الفيديو قد يضر أيضاً بقدرة التعميم الأصلية.
والنتيجة أن النموذج يتعلّم الحركة، لكن الروبوت يفشل في تنفيذها عند تغيير البيئة.
طرح VPP2 حكماً مباشراً جداً:جودة التنبؤ بالفيديو تحدد الحد الأعلى للحركة.
استناداً إلى هذا التفكير، اختارت StarDance Epoch تدريب التنبؤ بالفيديو وتعلّم الحركة على مراحل، حيث لا يتمحور التركيز حول «طهي الفيديو والحركة معاً في قِدر واحد»، بل حول«فصل»الاثنين وإعادة«ترتيبهما».。
صممت StarDance Epoch لهذا الغرض استراتيجيةتدريب من ثلاث مراحل:
- في المرحلة الأولى، التدريب المسبق المستمر على فيديو بمستوى الأحداث، ليتعلم النموذج التنبؤ بعملية التشغيل الكاملة.
- في المرحلة الثانية، التدريب اللاحق والتقطير على فيديو بمدة ثابتة، لجعل قدرة التنبؤ مواكبة لسرعة التنفيذ الفوري للروبوت.
- في المرحلة الثالثة، تدريب خبير الحركة، لتحويل التنبؤ بالفيديو إلى حركات محددة، مع الحفاظ على قدرة التعميم الأصلية قدر الإمكان.
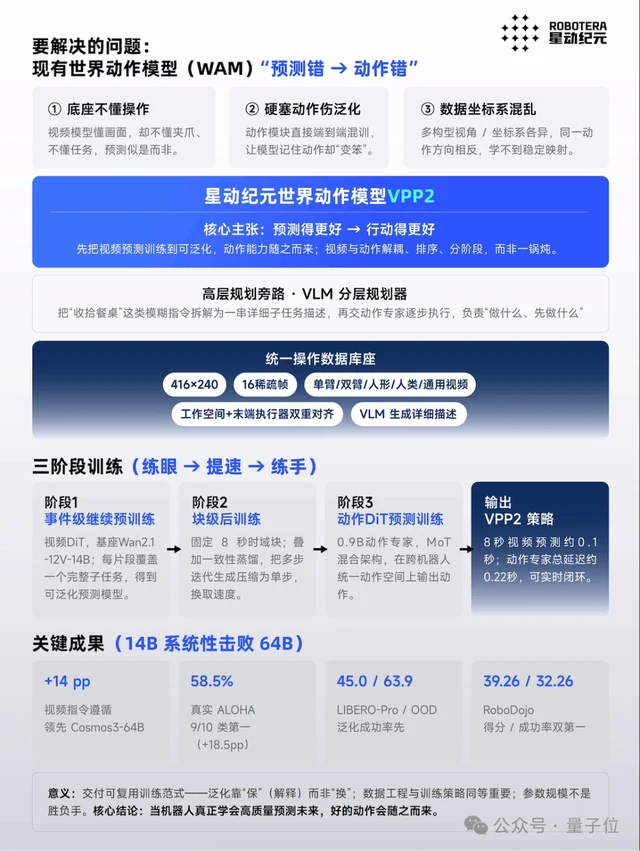
تتدرج المراحل الثلاث طبقة بعد طبقة، لتشير في النهاية إلىاختراقين جوهريين: أن يكون التنبؤ قابلاً للتعميم، وأن تكون الحركة قابلة للتعميم أيضاً.
الاختراق الأول: منح التنبؤ بالفيديو قدرة على التعميم.
ما يتعين على VPP2 حله أولاً هو قدرة الروبوت على التنبؤ بدقة بالتغيرات الفيزيائية في المهام غير المألوفة.
اعتمدت StarDance Epoch على نموذج Wan2.1-I2V-14B مفتوح المصدر من علي بابا كأساس، ودمجت بيانات متنوعة تشمل تشغيل الروبوتات والأنشطة البشرية والفيديو العام، لتغطية أجسام روبوتية وأساليب تشغيل مختلفة.
لكن ما هو مثير للاهتمام حقاً هو طريقة معالجتها للبيانات.
لم يقتصر الفريق على إطعام الفيديوهات للنموذج دفعة واحدة بشكل بسيط، بل قسّم أولاً عمليات التشغيل إلى مقاطع مكتملة دلالياً، ثم أرفقها بأوصاف تفصيلية.
على سبيل المثال، لا يكفي إخبار النموذج بـ«ضع الكوب في الصندوق»، بل يجب توضيح أي ذراع ميكانيكية، وأي كوب، وأي صندوق، ووصف عملية التشغيل بأكملها.
لأن التعليمات الغامضة نفسها قد تقابل مسارات حركة لا حصر لها.
إذا لم يفهم النموذج حتى كائن العملية، فسيكون من الصعب طبعاً أن يتنبأ بالمستقبل بدقة.
فاختار VPP2 وصف المهمة بتفصيل أدق، ليخلق علاقة تقابل أكثر استقراراً بين التعليمات اللغوية والعمليات الفيزيائية.
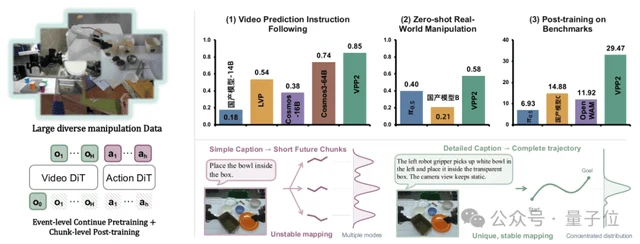
والخطوة الأكثر أهمية هي التدريب على التنبؤ بالفيديو بمستوى الأحداث.
يركّز التنبؤ قصير المدى التقليدي على ما سيحدث في الإطارات القليلة التالية، أما VPP2 فيجعل النموذج يتعلم مباشرة تغيّرات عملية تشغيل كاملة من البداية إلى النهاية.
من اقتراب الذراع الميكانيكية من الكوب، إلى الإمساك به، ثم وضعه في الصندوق، ما يجب على النموذج فهمه هو كيفية حدوث الحدث بأكمله.
بهذه الطريقة، عند مواجهة أجسام أو مواقع جديدة بلوحات حتى مهام تشغيل جديدة، سيكون لديه فرصة أكبر للتنبؤ بالتغيرات الفيزيائية المعقولة.
في اختبار اتباع التعليمات لمقاطع فيديو تشغيل الروبوت،14B معاملمن VPP2 حققت90%نسبة نجاح، بينما حقق نموذج Cosmos3 ذو 64B معامل نسبة 78%.
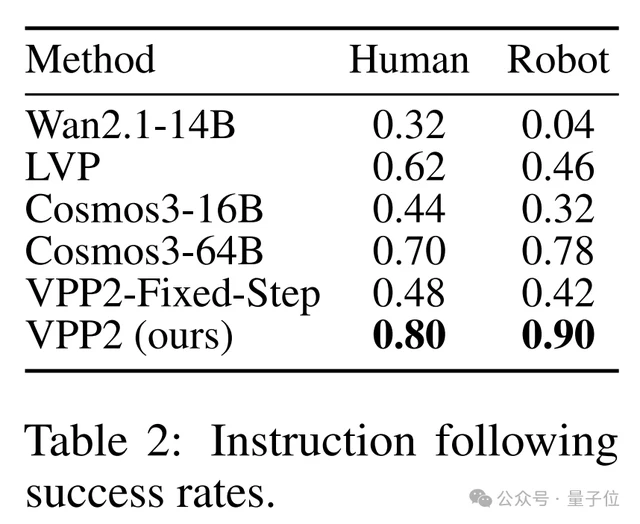
الطراز 14B يهزم الـ64B.
وهذا يوضح أيضاً أنه في التنبؤ بالعمليات الفيزيائية، فإن حجم المعاملات ليس العامل الحاسم الوحيد، فالقدرة على الفهم الحقيقي لعملية التشغيل لا تقل أهمية.
ومع ذلك، مهما كانت دقة التنبؤ، فإنه لن يفيد شيئاً إذا لم يستطع الروبوت التحرك.
الإنجاز الثاني: تحويل تعميم التنبؤ إلى تعميم للعمل
هناك عقبتان هنا، الأولى هيالسرعةوالثانية هيكيفية الحفاظ على قدرة التعميم الأصلية لنموذج الفيديو أثناء تعلم الحركة.
العقبة الأولى سهلة الفهم: إذا كان على الروبوت أداء العمل بينما يستغرق توليد الفيديو عدة ثوانٍ قبل كل حركة، فمن الصعب جداً أن تكون قدرة التنبؤ الأقوى بحال مفيدة عملياً.
اختارت 星动纪元 تسريع نموذج التنبؤ أولاً.
ضبط الفريق نموذج التنبؤ على مستوى الحدث ليصبح تنبؤًا بمقاطع فيديو ثابتة مدتها 8 ثوانٍ، ثم قام بتكثيف الحسابات متعددة الخطوات إلى توليد بخطوة واحدة من خلال تقطير الاتساق.
وأخيرًا، يتوقع التغييرات البصرية خلال 8 ثوانٍ المقبلة، مع استغرق الحساب حوالي 0.12 ثانية.
العقبة الثانية أكثر تعقيدًا بعض الشيء.
بعد أن تعلّم نموذج الفيديو بصعوبة التنبؤ بالمهام غير المألوفة، أدى إضافة تدريب الحركات إلى أن يصبح النموذج قادرًا فقط على تنفيذ العمليات المألوفة.
لقد نضجت القدرة الحركية، لكن هل ضاعت القدرة على التعميم؟ ما تسعى VPP2 إلى تحقيقه هو تجاوز هذين العقبين في آنٍ واحد.
يقدم VPP20.9B من المعلماتمنتشر ديترانسمورمر للحركة (Action DiT)،يتبنى معمارية MoTوتعلّم كيفية توليد حركات الروبوت بناءً على الحالة المستقبلية المتوقعة.
لكن شركة Xingdong Jiyuan لم تدرب مباشرةً نموذج التنبؤ بالفيديو (Video DiT) وخبير الحركة معًا من الصفر.
في المرحلة الأولية من تدريب الحركات، يتم تجميد المعاملات الأساسية لنموذج الفيديو، ويُجرى التكييف فقط عبر LoRA، تجنبًا قدر الإمكان لأن تدريب الحركات يضر بقدرة التعميم التنبؤية الموجودة بالفعل.
يعادل ذلك جعل الروبوت يفهم أولاً كيف يتغير العالم المادي، ثم تدريبه على كيفية تحويل هذا «الفهم» إلى «حركة».
القدرتان تنمو على مراحل، وتتكاملان فيما بينهما.
أخيرًا، تستغرق التنبؤات المرئية حوالي 0.12 ثانية، ويستغرق خبير الحركة حوالي 0.1 ثانية،يبلغ إجمالي تأخير توليد مقاطع الحركة حوالي 0.22 ثانية.
بالتأكيد، مهما كانت البنية الرائعة، فإنه لا بد من النظر إلى النتيجة النهائية.
المذكور سابقًااختبار ALOHA الحقيقي للروبوت بدون عينات تدريبية، وقد أظهرت بالفعل إمكانية VPP2 في تحويل القدرة التنبؤية إلى عمليات على مهام غير مألوفة.
أما اختبا التعميم الآخران، فقد أكّدا هذا المسار بشكل إضافي.
LIBERO-Proعند فحص القدرة على التشغيل بعد تغيّر موضع الجسم ومتطلبات المهمة، حقق VPP2 نسبة نجاح إجمالية قدرها 45.0%، بينما بلغ أعلى معدل لدى النماذج الأساسية الأخرى 11.0%.
LIBERO-OODأما هذا الجزء فيتناول التعميم التركيبي، حيث يُعاد دمج الأشياء والتخطيطات وأهداف المهام المألوفة لتكوين مهام جديدة لم تُر من قبل.
بلغ معدل النجاح الإجمالي لـ VPP2 63.9٪.
عند وضع هذه النتائج معًا، يصبح الأسلوب التقني لـ VPP2 واضحًا.
أولاً، من خلال بيانات متعددة المصادر، وأوصاف تفصيلية للمهام، وتدريب على التنبؤ على مستوى الأحداث، يتم تدريب النموذج على التنبؤ بالتغيرات الفيزيائية بدقة أكبر.
ثم من خلال تسريع التقطير والتعلم التدريجي للأفعال، يتحول هذا النوع من القدرة التنبؤية إلى عمليات فعلية، مع الحفاظ في الوقت نفسه على قدرة التعميم الأصلية قدر الإمكان.
من الواضح أن سقف أداء الذكاء المجسّد لم يصل بعد إلى مرحلة لا يمكن تجاوزها إلا بتكديس الحجم بشكل أعمى.
يوضح VPP2 مرة أخرى أنتحسين خطوط البيانات وتعديل نموذج التدريبوهذه الأساليب الهندسية التي تبدو بسيطةلا تزال لديها فرصة لتحقيق تحسن ملموس في أداء النموذج.
من GPT إلى WAM، الذكاء الاصطناعي الفيزيائي يشكّل نموذجاً جديداً
أن يكون التنبؤ قابلاً للتعميم وأن يكون الفعل قابلاً للتعميم أيضاً، هو الاختراق الأساسي الأبرز في VPP2 كنموذج فعل عالمي WAM.
لكن المهام الواقعية غالباً ما تكون أكثر تعقيداً. فالروبوت لا يجب أن يعرف كيف يفعل الشيء فحسب، بل يجب أيضاً أن يحدد ما يفعله أولاً وما يفعله لاحقاً.
وهذا يتطلب مشاركة قدرات إدراكية وتخطيطية أعلى مستوى.
وهنا قدّمت شركة Xingdong Jiyuan فكرة:GPT مسؤول عن التفكير، وVPP2 مسؤول عن التنفيذ.
الأول مسؤول عن الفهم والاستنتاج والتخطيط، حيث يقسّم المهام المعقدة إلى خطوات واضحة؛ أما الثاني فمسؤول عن التنبؤ بكيفية تغير العالم الفيزيائي، ثم تحويل التخطيط إلى أفعال ملموسة.
وقد حظيت هذه الفكرة بدعم تجريبي أولي في ورقة VPP2 البحثية.
اعتمد الفريق فعلياً على مخطط عالي المستوى يعمل بتقنية VLM، يتولى الفهم الدلالي والذاكرة وتفكيك المهام، ثم يسلّم المهام الفرعية الواضحة إلى VPP2 لتنفيذها.
النتائج بديهية تمامًا. في اختبارات المهام طويلة المدى المحددة في RoboDojo،بعد إدخال تخطيط المهام الفرعية عبر VLMارتفع متوسط معدل النجاح من 27.6% إلى57.6%。
هذا يعني أنه لإنجاز الروبوت المهام المعقدة، لا تكفي القدرة الحركية القوية وحدها؛ فمدى تناغم التخطيط عالي المستوى مع التنفيذ منخفض المستوى يؤثر هو أيضًا في نتائج إنجاز المهمة.
وبمتابعة هذا الخط من التفكير،GPT+VPP2من المرجح أن يشكّل نموذجًاتقنيًا جديدًا للذكاء الاصطناعي الفيزيائي: إدراك عام + تنفيذ فيزيائي عام.
تتولى النماذج العامة مثل GPT فهم النوايا والاستدلال والتخطيط، بينما يتولى WAM مثل VPP2 التنبؤ بالتغيرات الفيزيائية وتوليد الحركات، ثم يواصل الضبط عبر التغذية الراجعة من التنفيذ.
من الإدراك والتخطيط والتنبؤ، إلى التنفيذ والتغذية الراجعة، تتضح تدريجيًا حلقة مغلقة متكاملة للذكاء الاصطناعي الفيزيائي.
وهذا يمنح قيمة WAM مساحة أوسع من التخيل.
يجب أن تتفاعل قدرات النموذج مع العالم الفيزيائي عبر الجسد، والاستخدام الفعلي يكشف بدوره عن الإخفاقات وينتج تغذية راجعة تدفع النموذج والعتاد إلى مواصلة التحسن.
تقوم Xingdong Jiyuan في آن واحد بتطوير الدماغ والجسد واليد البارعة، ويمكن تفسير استراتيجية «التكامل العميق الكامل» ضمن هذا المنطق:فالشركة تحاول إتقان ليس مرحلة التدريب فحسب، بل أيضًا مرحلة ترسيخ القدرات وإعادة تدفق التغذية الراجعة.
u1s1، مهما كانت الخطة التقنية رائعة، فإنها في النهاية لا بد أن تذهب لتشتغل في العالم الحقيقي.
وفي هذا الصدد، أقامت Xingdong Jiyuan بالفعل تعاونًا مع شركات مثل China Post وSF Express، وتعمل بشكل منتظم في5 مقاطعات ومدن على مستوى البلاد، وأكثر من 10 مراكز لوجستية。
ففي السيناريوهات اللوجستية قد تتغير أبعاد البضائع ومواضع وضعها وسير العمليات. فنفس مجموعة العمليات قد تتطلب من الروبوت إعادة التأقلم عند تغيير المستودع.
وهذا يفرض متطلبات أعلى على قدرة الروبوت التعميمية.
فقدرة النموذج على نقل ما تعلمه إلى مهام غير مألوفة تؤثر مباشرة في كفاءة وتكلفة النشر عبر السيناريوهات المختلفة في المستقبل.
بالطبع، فإن التقدم التجاري لأعمال اللوجستيات القائمة لا يعني أن VPP2 قد حققت نشرًا واسع النطاق. فما إذا كان النموذج قادرًا على العمل بشكل مستقر طويل الأمد في المزيد من السيناريوهات الحقيقية لا يزال بحاجة إلى مزيد من التحقق.
لكن إنجاز VPP2 هذه المرة قد أصدر بالفعل إشارة تستحق الانتباه.
فالمنافسة على نماذج الحركة العالمية تنتقل من التنبؤ بالمستقبل إلى خطوة أبعد: تحويل التنبؤ إلى أفعال عامة.
وبالعودة إلى تصدّر RoboDojo القمة، لم يعد ما يستحق الانتباه مجرد مركز أول.
من المحاكاة إلى الآلة الحقيقية، ومن التعميم في التنبؤ إلى التعميم في الفعل، تشير سلسلة التجارب الخاصة بـ VPP2 إلى أن:التدريب المرحلي بين التنبؤ بالفيديو وتعلم الحركة قادر بالفعل على تحسين قدرة الروبوت على الأداء في مهام غير مألوفة.
ومع اندماج أعمق بين نماذج الإدراك العامة مثل GPT ونماذج WAM، يُتوقع أن يشكّل الذكاء الاصطناعي الفيزيائي منظومة قدرات أكثر اكتمالًا.
وفي المحصلة، الجولة التالية من المنافسة على الذكاء المجسد هي ما إذا كانت الروبوتات قادرة على نقل ما تعلمته إلى المزيد من السيناريوهات غير المألوفة.
الدقة في التنبؤ يجب أن يقابلها الإنجاز الفعلي. هذا هو المفتاح لانتقال نماذج الحركة العالمية حقًا إلى العالم الفيزيائي.
ملاحظة:تم إتاحة VPP2 كمصدر مفتوح،يمكن للمهتمين تجربة الأمر بأنفسهم وإعادة إنتاج نتائج الورقة البحثية.
إذا ظهرت لكم أي مفاجأة عند التشغيل، تذكروا أن تعودوا لتخبرنا بها~
1. الكود المفتوح المصدر
: https://github.com/roboterax/video-prediction-policy-2
2. الصفحة الرئيسية للمشروع:
https://robert-gyj.github.io/video-prediction-policy-2