
يدعم vLLM الآن Vera Rubin NVL72!
NVIDIA Vera Rubin هي منصة جديدة من الجيل القادم مُصممة للاستدلال العناصري. منذ الإعلان عنها، قامت شركات NVIDIA وRed Hat ومجتمع vLLM بتطوير vLLM على Vera Rubin NVL72، ويتم تنفيذ vLLM اليوم على Vera Rubin NVL72 مع بناء حاويات يومي ودعم للنماذج من DeepSeek وMoonshot AI وZ.ai وMiniMax.
هذه المنشور هي نظرة مبكرة على الوضع الحالي، وفيما يلي بعض النقاط البارزة من العمل حتى الآن:
- أجهزة Vera Rubin NVL72: 5 أضعاف سرعة NVFP4 FLOPS، حوالي 2.4 مرة عرض النطاق الترددي HBM، و1.7 مرة عرض نطاق NVLink الثنائي الاتجاه لجهاز GB200 NVL72، مع تسارع تكعيبي أسرع بـ 2-4 أضعاف لخاصية softmax.
- دعم يوم-0: تقوم Rubin على عائلة البنائية الخاصة بـ Blackwell، لذلك فإن نواة Blackwell في vLLM متوافقة مع Rubin. ونتيجة لذلك، يدعم vLLM بالفعل نماذج مختلفة مثل DeepSeek وKimi وGLM وMiniMax على Rubin.
- الحزم المعدلة حسب روبين: من خلال FlashInfer 0.7.0، يحصل vLLM على حزم تركيز معدلة حسب روبين، بالإضافة إلى حزم GEMM وMoE. كما قمنا بتعديل حزمة MiniMax Sparse Attention (MSA) الخاصة بنا لكي تكون معدلة حسب روبين أيضًا.
- MoE المعترف بالمكانة: لتحقيق أفضل استفادة من عرض النطاق الترددي المُحسّن لـ Rubin، نستخدم مجالات المكانة في CUDA 13.4 لتقسيم أوزان MoE. هذا يسمح للSMs بقراءة الأوزان فقط من الذاكرة الأقرب إليهم.
- الأداء المبكر: تظهر النتائج المبكرة تحسينات ملحوظة باستخدام vLLM: 7.8 مرة زيادة في الإنتاجية لكل جهاز GPU مقارنة بـ GB200 NVL72 على نظام AgentX، مع تكامل تفاعلي متساوي، وصولًا إلى 3.7 مرة زيادة في إنتاجية VLM مقارنة بـ GB300 NVL72 في اختبار MLPerf. هذه مجرد البداية؛ نتوقع رؤية المزيد من الأداء مع استمرار التحسينات.
ما الذي يغيره روبين في عملية الاستدلال
اضغط لفتحهاالشكل 1. مقارنة لكل وحدة معالجة رسومية بين NVIDIA Vera Rubin NVL72 وGB200 NVL72. انقري فوق مؤشر لتسليط الضوء على جزء الوحدة المعالجة الرسومية؛ خيار “عرض الجدول” يعرض كل القيم. المصادر: NVIDIA فيرا روبين NVL72 و GB200 NVL72 صفحات التفاصيل، ومدونات المطورين لجهاز NVIDIA Rubin.
منصة فيرا روبين
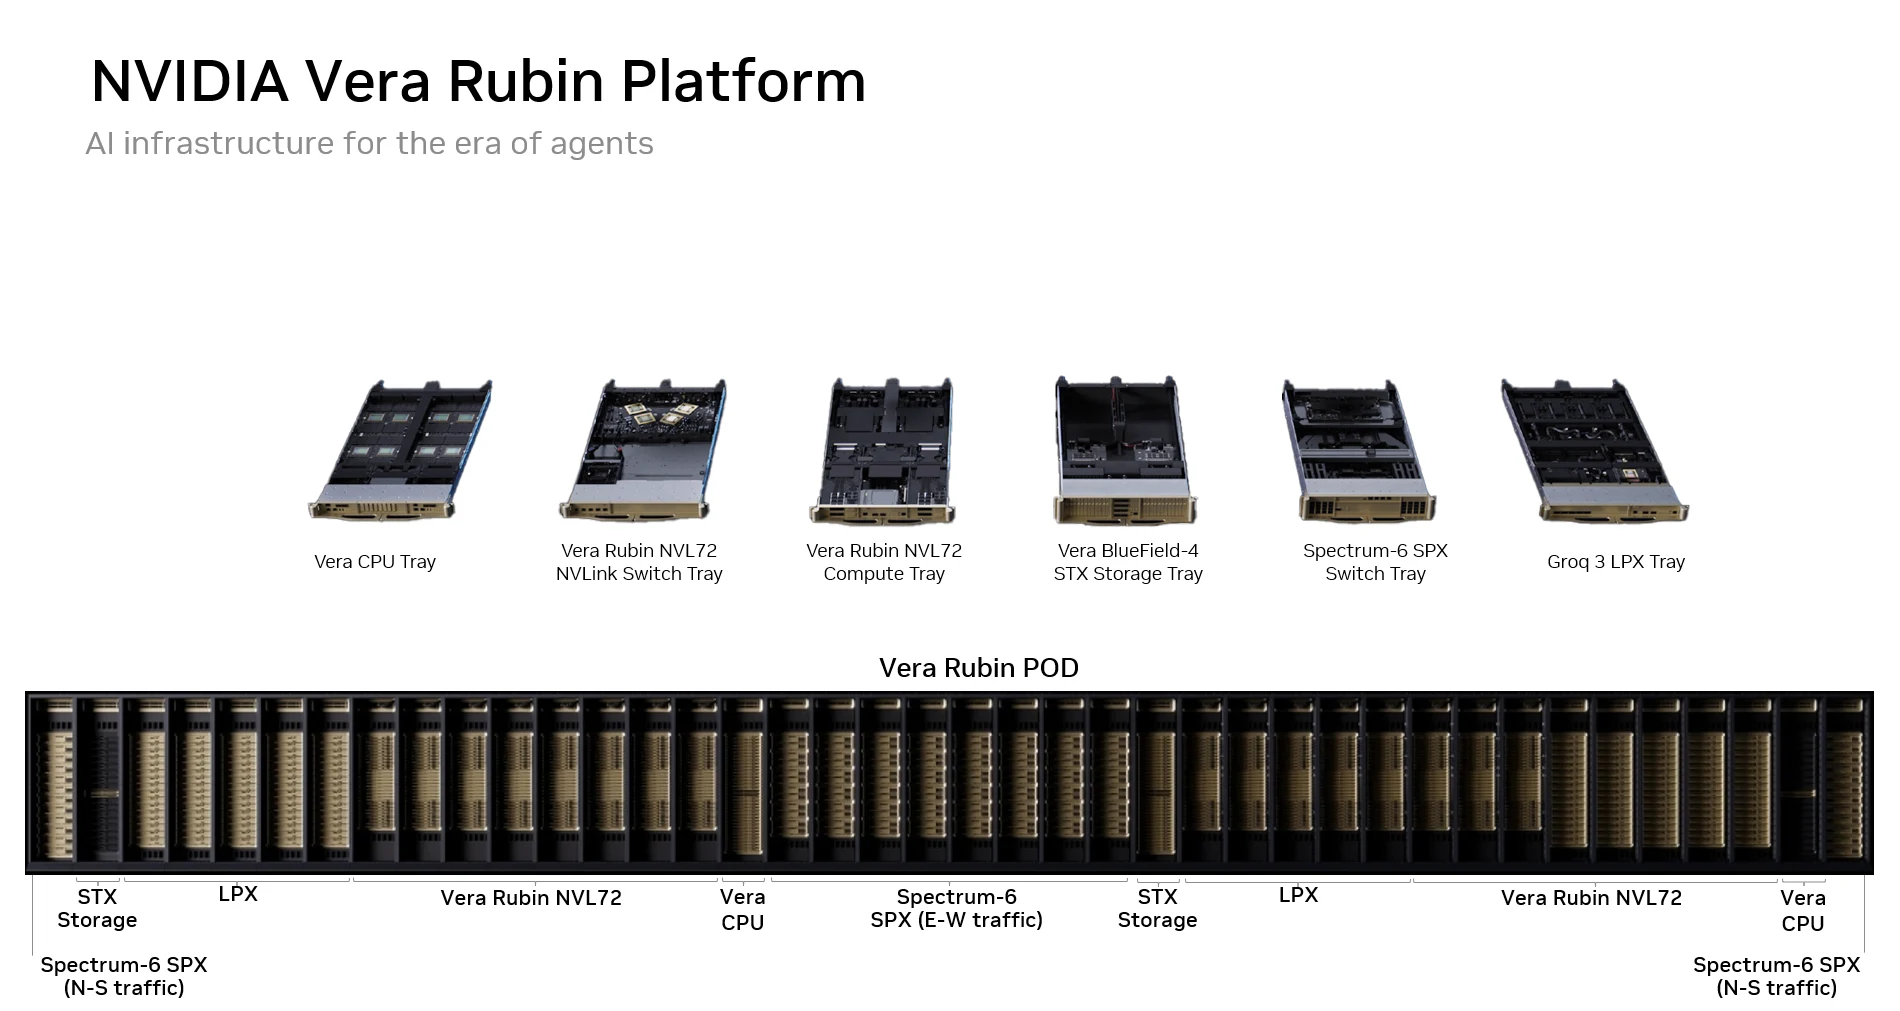
توفر منصة فيرا روبين أداءً ممتازًا من خلال التصميم المشترك الشديد للعناصر الخاصة باللوحة – وتحتوي على خمسة أنظمة جديدة ومميزة مخصصة لأعمال الذكاء الاصطناعي العملياتية: فيرا روبين NVL72، لوحة CPU فيرا، Groq 3 LPX، Spectrum-6 SPX، وBlueField-4 STX Storage.
توفر وحدة Vera Rubin NVL72 واحدة فقط ما يعادل 5 أضعاف عدد FLOPS في استدلالات NVFP4 مقارنة بوحدة GB200 NVL72، كما توفر عرض نطاق التردد للمساحة الداخلية أعلى بنسبة 2.4 مرة. من ناحية الشبكة، فإن وحدة NVLink من الجيل السادس توفر عرض نطاق تردي يصل إلى 1.7 مرة أعلى من Blackwell، مما يؤدي إلى تجربة مستخدم أفضل بشكل ملحوظ في سيناريوهات الخدمة الفورية للأجسام المستخدم.
السوفتماكس. من الجدير بالذكر أن روبين حسّن أيضًا أداء السوفتماكس، وهو عملية أساسية في انتباه نماذج اللغويات الطبيعية. يزيد روبين من الإنتاجية التكعومية، حيث يتجاوز ذلك 2x FP32 و4x BF16/FP16 مقارنةً بنظام NVIDIA GB200، مما يساعد السوفتماكس على مواكبة العمليات المصفوفية الأسرع.
الذاكرة. تم تحديث HBM في Rubin من HBM3e إلى HBM4، مما يوفر عرض نطاق التردد الأعلى بما يصل إلى 2.4 مرة مقارنةً بGB200 NVL72. بالإضافة إلى قدرته الأكبر على الحوسبة، فإن وحدة GPU Rubin تسرع العمليات الأساسية لـ LLM مثل GEMM وMoE (خليط الخبراء) وعمليات الانتباه، وتوفر معدل تدفق أعلى بكثير ووقت تأخر أقل في التشفير (تفاصيل أدناه).
الشبكات. تم تحسين الشبكات بين GPU أيضًا بشكل كبير على منصة روبين. توفر تقنية NVLink من الجيل السادس عرض نطاق ترددي أعلى بـ 1.7 مرة مقارنة بالجيل السابق. هذا سيزيد من سرعة العمليات الجماعية (مثل AllReduce و All2all) والعمليات الاتصال الأخرى، مما يحسن من سرعة وتوسع التحليلات الكبيرة للLLM (مثل تفريغ/تحليل التفريد، والتوازي الواسع للمتخصصين).
حالة دعم vLLM روبين
لقد عمل مجتمع vLLM على تمكين Rubin مباشرة بعد الإعلان عنه علنًا. وبصفتهم أجزاء أساسية من مجتمع vLLM، تعاون مهندسون من NVIDIA وInferact وRed Hat وتقدّموا بما يضمن أن جميع المستخدمين يمكنهم تطبيق النماذج المختلفة على منصة Rubin بسهولة.
في هذا القسم، نسلط الضوء على الدعم المستمر من vLLM للحاسب روبين، وخاصة استغلال مجالات المكانية، بالإضافة إلى تحسينات سهولة الاستخدام لاستخدامه مباشرة على أجهزة روبين.
دعم نطاق المنطقة
منذ عصر أمبير، تتميز وحدات الرسومات NVIDIA بوصول غير متجانس إلى الذاكرة العالمية. يسمح ميزة المجال المحلي في NVIDIA CUDA 13.4 للتطبيقات الاستفادة الكاملة من الوصول غير المتجانس إلى الذاكرة العالمية، وذلك عن طريق وضع العمليات الحسابية والبيانات داخل نفس المجال المحلي. يمكن للوحدات SM الوصول إلى الذاكرة العالمية داخل مجالها المحلي بسرعة عالية ومعدل تأخير منخفض مقارنةً بالذاكرة HBM في المجالات الأخرى. مع السياقات الخضراء وتدفقات CUDA، يمكننا تشغيل نواة واحدة في كل مجال محلي، بحيث يمكن للنواة الوصول إلى الذاكرة المحلية. تسرّع هذه الميزة بشكل رئيسي الأعمال التي تعتمد على الذاكرة، مثل تفسير MoE. يظل المجالات المحلية في مرحلة التصميم والتطوير النشط. في هذا القسم، نستخدم تفسير MoE كمثال للتعمق أكثر.
اضغط لفتحهاالشكل 3: تقنية Split-N في MoE، على حدين محليين. يتم تقسيم الأوزان W إلى أقسام بواسطة الأعمدة عند N/2، ويقرأ SMs كل دومين نصف وزن W فقط في ذاكرته HBM الخاصة، بحيث يستخدم كل دومين عرض نطاق الذاكرة المحلي الخاص به. المدخل X والإخراج C يأتيان من كلا الدومينين. يمكن استخدام خيار Pause، Prev/Next أو الرقائق التصنيفية للمرور عبر الخطوات.
يتم تفسير MoE من خلال قراءة الأوزان من HBM، لذا فإن هدفنا هو تحسين إنتاجية الذاكرة في جميع مجالات التموضع. عند النظر أولاً إلى ميزة التموضع الجديدة لروبين، نستخدم استراتيجية split-N في كلا الخطوتين FC1 وFC2، كما هو موضح في الشكل 3. نقسم الأوزان حسب الصفوف، ونضع كل قسم في الذاكرة العالمية لمجال التموضع، ونحصر SMs لكل مجال في القسم المحلي الخاص به. هذا يلغي معظم استخدامات الذاكرة بين العوالم المختلفة، مما يؤدي إلى تحسين أداء النواة وتوفير الطاقة. نظرًا لأن الذاكرة المؤثرة صغيرة نسبيًا أثناء التفكيك، فإن الحفاظ علىها غير موزعة بين عالمين من الذاكرة سيؤدي إلى استهلاك أقل للطاقة.
لا يمكن دائمًا تقسيم الرسائل النصية إلى مجالات متساوية. عند محاولة إنشاء تقسيمات متساوية، لن يشمل إنشاء مجال المكانية تلك الرسائل النصية. لجعل كلا التقسيمين يحتويان على رسائل نصية متساوية، نحتاج إلى تفعيل cudaDevSmResourceGroupBackfill (وضع الإكمال) أثناء إنشاء المجالات (نشير إلى المستخدمين بوثيقة مجال المكانية الرسمية للحصول على تفاصيل أكثر). خلال دراستنا للأداء، نقوم بإدراج وضع الافتراضية (تُستخدم 200 رسالة نصية فقط في كلا المجالين) ووضع الإكمال (تُستخدم جميع 212 رسائل نصية).
تقارن الشكل 4 الزمن التقدمي للطبقة الأولية MoE (FC1 + FC2) مع مجالات المكانية سواء كانت مفعلة أو غير مفعلة لاستراتيجيات موازية مختلفة. نستخدم أشكال MoE M3 MiniMax كمثال. عند تفعيل مجال المكانية، يمكننا الحصول بشكل مستمر على تسريع بمعدل 1.2x في إعدادات التقدمي للعناصر الصغيرة. ويظل الاتجاه نفسه تقريبًا لاستراتيجيات تقديم TP وEP الأخرى. حتى في الوضع الافتراضي، حيث يتم استخدام 200 من أصل 212 SMs فقط، فإن تفعيل مجال المكانية يوفر مكسب مماثل. السبب الرئيسي هو أن في فك الترميز للعقود الصغيرة، يسيطر تحميل الوزن على المرور الأمامي، بينما تسمح مجالات التحديد المحلية بزيادة معدل الإنتاجية لـ HBM. هذه النتائج المبكرة هي مجرد نقطة انطلاق، مع إمكانية تحسينات وإعدادات إضافية لتعظيم فوائد الأتمتة المحلية على Rubin.
اضغط لفتحهاالشكل 4: التاخير الأولي لـ FC1 + FC2 لكل رتبة على طبقة MiniMax M3 MoE في Rubin، سواء كان غير مُحدد الموقع أو مُحدد الموقع (القيمة الأقل أفضل)، مع الزيادة في السرعة (تاخير غير مُحدد الموقع ÷ تاخير مُحدد الموقع) فوق كل زوج. تتغير الأشرطة لتبديل الاستراتيجيات المتوازية (TP2، TP4، EP2، EP4)؛ وتتغير أجهزة التبديل بين وضع التعبئة الكامل (212 SM) والوضع الافتراضي (200 من 212 SM). التوجيه المتوازن؛ ووقت الاتصال غير مدرج.
جودة الاستخدام يوم-0
القابلية في الاستخدام هي الأولوية الأولى دائمًا لـ vLLM. حتى اليوم، يمكن للمستخدمين استخراج واستخدام الصور الليلية المصنوعة باستخدام CUDA 13.4 وPyTorch 2.15 من Docker Hub الخاص بـ vLLM، وهي vllm/vllm-openai:cu134-nightly، للأجهزة Rubin.
توافق حزمة برمجيات بلاكويل. روبين يعتمد على عائلة البناء الخاصة ببلاكويد، مع توسيعه tcgen05 تعليمات نواة تنسور. إنها هدف تجميع جديد لواجهة GPU (sm107)، لكن الحاويات يمكن أن تعمل عليها أيضًا، الحاويات المصممة للعائلة Blackwell (sm100f). في التطبيق العملي، يمكن لحاويات Blackwell الخاصة بـ vLLM، خاصة تلك التي تعتمد على عملية GEMM مثل التركيز وMoE، أن تعمل على Rubin دون أي تعديلات.
بناء الحاويات اليومي. بناء الحاويات اليومي لـ Rubin متاح بالفعل (#55953)، وتم تفعيله من خلال #53443 و#54640 للطريق التحتوي على Rubin على CUDA 13.4، بالإضافة إلى #56545 و#59288 لتحديثات التبعيات الخاصة بـ Rubin.
نطاق النماذج. مع تركيب هذه الأجزاء، يمكن لvLLM الآن تقديم نماذج متعددة مثل DeepSeek وKimi وGLM وMiniMax على Rubin.
كيرنلات مُعدّلة من روبين
تدريجيًا، يتم إصدار الحلول الأساسية التي تستفيد من قدرات وخصائص الأجهزة الخاصة بـ روبين، وتُنقل إلى مكتبات الحلول الأساسية مثل FlashInfer، وفرع vLLM من MSA (vllm-project/MSA)، وHumming (vllm-project/humming)، وغيرها. وحتى اليوم، قام vLLM بدمج بعض الحلول الأساسية المهمة لتحقيق أقصى أداء لروبين، وتشمل هذه الحلول عملية GEMM باستخدام NVFP4 أو MXFP4، وMoE باستخدام NVFP4، والتعلم العميق باستخدام FP8، وتعبئة مسبقة MSA باستخدام FP8، والعديد من الحلول الأخرى.
الأداء
نقيم أداء vLLM أثناء تشغيله على وحدات GPU Vera Rubin NVL72 باستخدام مقياسين ممثلين: SemiAnalysis AgentX (الموضح في مقالتنا السابقة)، وMLPerf Inference v6.1.
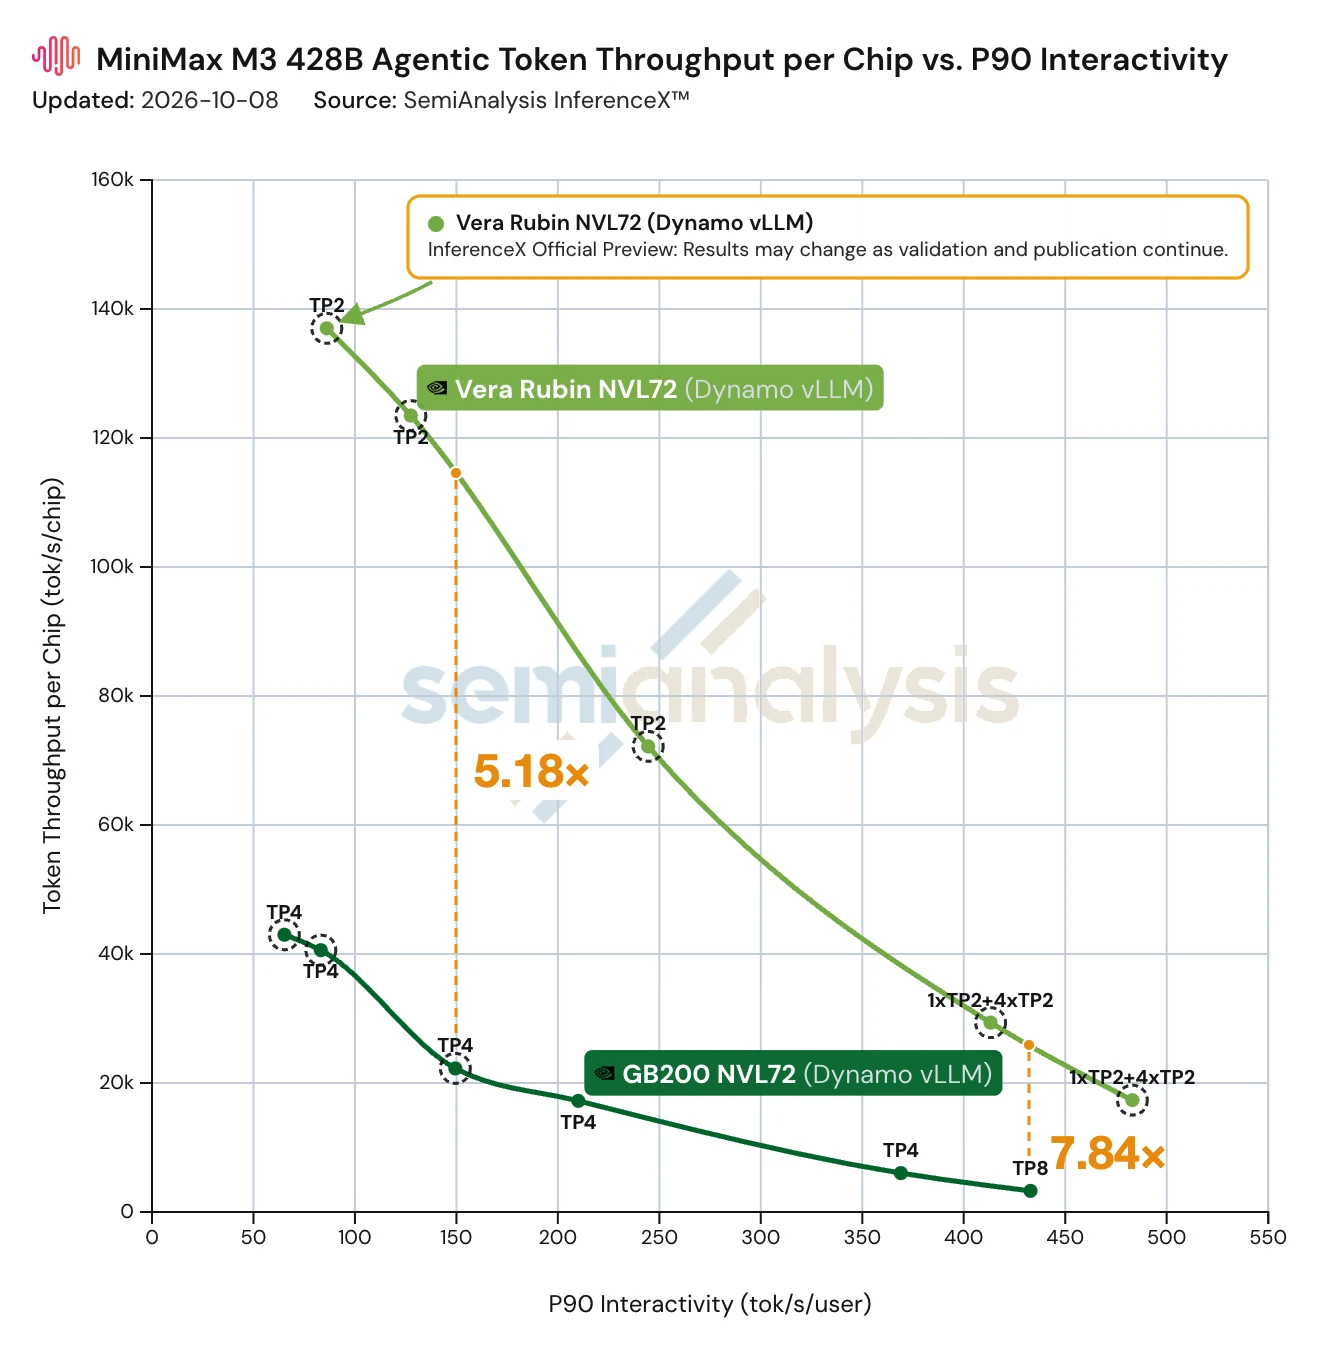
على منصة AgentX، يوفر vLLM تشغيل MiniMax M3 على Vera Rubin NVL72 عائدًا يصل إلى 7.84 مرة العائد لكل NVIDIA GB200 عند نفس مستوى التفاعل، و5.18 مرة العائد أعلى تحت قيود 150 TPS. هذا هو نظرة مبكرة جدًا على قدرات الاستدلال للمنصة. مع اكتسابنا لمزيد من عقد Vera Rubin NVL72، سنوسع الاختبارات وندفع التحسينات، مع توقعات بزيادة أكبر في الأداء مع تقدم هذا العمل.
كان جولة MLPerf Inference v6.1 أول ميدان اختبار لإطلاق vLLM على منصة Vera Rubin NVL72 التابعة لشركة NVIDIA. في اختبار نموذج اللغة البصرية (VLM)، عند تطبيق نموذج Qwen3-VL-235B-A22B عبر vLLM كمحرك للاستدلال الخلفي وDynamo كراوتر الطرفية الأمامي، قدمت Vera Rubin NVL72 معدل تدفق يصل إلى 3.7x أعلى من GB300 NVL72 في السيناريوهات المعزولة والخادمية والتفاعلية. تتوفر تفاصيل نتائج MLPerf Inference v6.1 المنشورة في مقالة مدونة NVIDIA.
الخطوات التالية
“لم يُبنَ روم في يوم واحد”, وترقية قابلية الاستخدام والأداء على بطاقات الرسومات GPU Vera Rubin NVL72 سيكون رحلة مستمرة مليئة بالإثارة. في المستقبل القريب، سنعمل معًا كمجتمع، ونخطط لتفعيل العديد من الميزات الجديدة لبطاقات الرسومات Rubin، بما في ذلك ولكن لا يقتصر على:
- دمج FlashInfer MegaMoE من نوع sm107 في vLLM من خلال FlashInfer.
- تفعيل نطاقات المكانية بالكامل لطبقات MoE.
- اكتشف واستفد من فرص التداخل الأكثر في الطبقات المختلفة أو النواة، من خلال PDL وLamport Sync.
- استكشف العناصر الرئيسية الكبيرة للحالات الاستخدامية التي تتطلب دقة في التأخير.
- حسنِّل نواة KDA وMLA على Rubin لكيمي K3.
- دمج نوافذ Rubin CSA وHCA للنواة DeepSeek-V4.1-Flash.
- أنهي عملية التكامل لحلول تفكيك MSA لروبين.
- دمج كريستال التلوين والكتابة MoE في النواة كلها عبر FlashInfer في vLLM.
شكر وتقدير
هذا العمل هو جهد تعاوني بين Inferact، وNVIDIA، وRed Hat، ومجتمع vLLM الأوسع. نود أن نقدم الشكر الخاص ل:
- نفيديا، للحصول على وصول مبكر لجهاز فيرا روبين NVL72 والتعاون الوثيق طوال مراحل التطوير.
- إنفيراكت وNVIDIA، لقيادة تعاون روبين، وتحسين الأداء، ودمج نواة MSA، وفحص أداء MoE الذي يعترف بالتجزئة.
- NVIDIA وRed Hat، لإعداد وتفعيل بناءات Docker اليومية لـRubin.
- جماعة vLLM، من أجل الدعم المستمر والمساهمات خلال العملية بأكملها.
الملحق: تشغيل vLLM على Vera Rubin NVL72
عرض تكوينات النواة لروبينلقد قام vLLM بتكامل بعض النواة المُحسّنة للغاية لمنصة Rubin. يغطي هذا القسم الإعدادات المناسبة لتفعيلها من أجل تحقيق أقصى أداء على وحدات GPU Rubin.
- CuTe-DSL كثيف NVFP4 أو MXFP4 GEMM. بشكل افتراضي، يكون مفعلاً لنقطة التحقق من نموذج NVFP4/MXFP4، ولكن يمكنك تعيين
--linear-backend flashinfer_cutedslللNVFP4 أو--linear-backend flashinfer_cutlassللMXFP4 لضمان تفعيله. - CuTe-DSL NVFP4 MoE. يمكنك تشغيله عبر
--moe-backend flashinfer_cutedsl. - CuTe-DSL المُقمّط المجمع GEMM لـ NVFP4 W4A4 MoE في الشكل الخبير "المجمّع". ينطبق ذلك على نشر مع
--enable-expert-parallel --data-parallel-size N --all2all-backend deepep_low_latency|nixl_epحيثN>1. في هذه الحالة، سيُحل--moe-backend auto|flashinfer_cutedslكليهما في هذا النواة. - CuTe-DSL FP8 BMM للطبقات الخطية ساكنة لكل تنسور باستخدام FP8 W8A8. يعمل بشكل افتراضي، ويمكن استخدامه من قبل مُحوّل التحسين التلقائي FlashInfer.
- تنبيه Trtllm-gen FP8. لإيقافه، تحتاج إلى استخدام مخزن الذاكرة KV بصيغة FP8 عبر
--kv-cache-dtype fp8أو نقطة توقف تحدد استخدام مخزن الذاكرة KV بصيغة FP8، بالإضافة إلى تعيين--attention-backend FLASHINFER|FLASHINFER_MLA. للتوفير المسبق على نمط DeepSeek-style MLA، يرجى أيضًا إضافة-ac.mla_prefill_backend=TRTLLM_RAGGED -ac.use_prefill_query_quantization=true. - ملء ملف تعريف الذاكرة العشوائية FP8 MSA. لتمكينه، يجب استخدام سحابة كمية-حالة FP8 من خلال
--kv-cache-dtype fp8أو نقطة توقف تحدد سحابة كمية-حالة FP8، بالإضافة إلى تعيين--attention-config.minimax_m3_msa_decode_backend=cutlass.