
تنفق فرق العملاء الآليين كميات هائلة من الرموز لفوائد جودة شبه قابلة للقياس، حسب ما وجدته الأبحاث
 ماتياس باستيان
عرض ملف Matthias Bastian على LinkedIn
11 أكتوبر 2026
تبين الأبحاث أن فرق العملاء الذكيين لا تحقق نتائج أفضل بكثير من العملاء الفرديين.
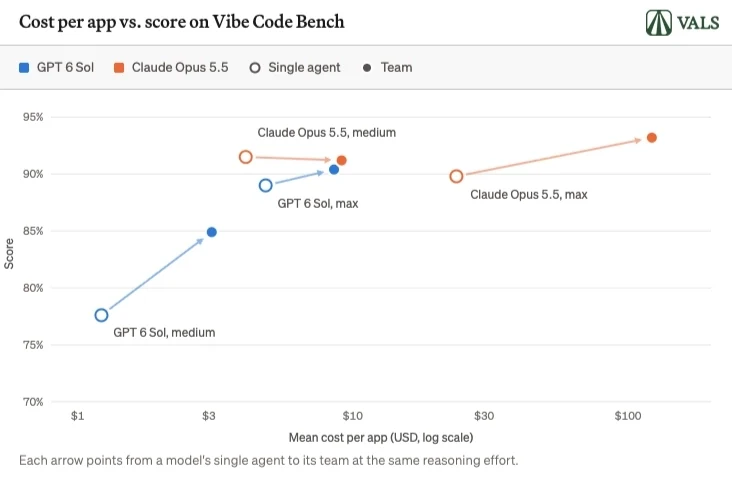
اختبرت شركة Evals Vals AI GPT-6 Sol وClaude Opus 5.5 على “Vibe Code Bench”, سواء بشكل فردي أو كفرق، على مستويين من التفكير: مستوى متوسط ومستوى قصوى من الجهد الفكري. تكلفة الفرق تتراوح بين 1.8x و5.1x من تكلفة العملاء الفرديين.
من أربع مقارنات بين الفرق والوكلاء الفرديين، أظهرت واحدة فقط تحسنًا إحصائيًا مهمًا: GPT-6 Sol في التفكير المتوسط، حيث حصل الفريق على 7.3 نقطة أكثر. وفي التفكير القصوى، لم يمنح إعداد الفريق لكل من Sol وOpus أي ميزة حقيقية بقيمة 5.5. تشير النتائج إلى أن التكلفة الإضافية لفرق الوكلاء لا تستحقها في معظم الحالات، خاصة عندما تعمل النماذج بالفعل بكامل طاقتها الحسابية.
| مهمة مع Opus 5.5 | 1 عامل | 10 وكلاء | 30 عميل | 100 عميل |
|---|---|---|---|---|
| قاعدة المعرفة | 0.53 | 0.70 | 0.71 | 0.74 |
| نظرية التواضع إثبات | 0.39 | 0.66 | 0.66 | 0.68 |
أظهرت القصة 5.1 تحسينات نوعية أقوى في مهمة إثبات النظرية النزيهة عند أكثر من عشرة وكالات، لكنها لا تزال أقل من Opus 5.5 في جميع الاختبارات. أما في مهمة قاعدة المعرفة، فقد انخفضت نتيجة Fable قليلاً عند التوسيع من 30 إلى 100 وكالة.
شراء المزيد من الوكلاء سرعة ولكن ليس نتائج أفضل
أكد الباحث في OpenAI، نوام براون، في بودكاست دواركيش أن الأنظمة متعددة الوكالات تكتسب السرعة فقط، ولا تحقق جودة أفضل. حل أربعة وكالات المهام بسرعة ضعفية، لكنها استهلكت ثمنًا أكبر بقدر الضعف. عند وجود 16 وكالة، استمر النمط نفسه، لكن الكفاءة انخفضت قليلاً.
يعتمد التأثير بشكل كبير على المهمة. البحث على الويب والرياضيات يمكن تطبيقهما بشكل متوازن، لكن كتابة رواية لا يمكن تطبيقها بهذه الطريقة، قال. إلقاء 10,000 عميل على رواية سيكون بلا فائدة مثل إلقاء 10,000 شخص عليها. أقر براون بأن توسيع عدد العمليات إلى أعداد كبيرة جدًا لا يزال غير مستكشف إلى حد كبير، لأن التكاليف مرتفعة للغاية.
حذر مطورو OpenAI، إريك بروفينشير، مؤخرًا من استخدام حشود الوكالات لسبب دقيق هو هذا. وقال إنها على الأرجح مال ضائع، لأن التنسيق بين الوكالات يتعطل. وقد سماه “ضريبة التنسيق”.
أخبار الذكاء الاصطناعي بدون الضجيج – من تجميع البشر
اشترك في THE DECODER للقراءة بدون إعلانات، برنامج نشر إخباري أسبوعي عن الذكاء الاصطناعي، تقرير "AI Radar" الحصري الست مرات في السنة، الوصول الكامل إلى الأرشيف، والوصول إلى قسم التعليقات.
اقرأ المزيد لترى الصورة الكاملة.
اشترك لتحصل على تغطية بدون إثارة.
- الوصول الكامل إلى كل المقالات على THE DECODER
- بدون إعلانات
- انضم إلى التعليقات والمناقشات المجتمعية
- تلخيص أخبار الذكاء الاصطناعي الأسبوعي عبر البريد
- 6 مرات في السنة: “رادار الذكاء الاصطناعي” – دراسات عميقة حول المواضيع المتعلقة بالذكاء الاصطناعي التي تهمنا أكثر
- أخبار الذكاء الاصطناعي اليوم، دائمًا محدثة
- أرشيفنا الكامل لمدة عشر سنوات
- مُغطى من قبل فريق يمتلك أكثر من 10 سنوات من الخبرة في الذكاء الاصطناعي