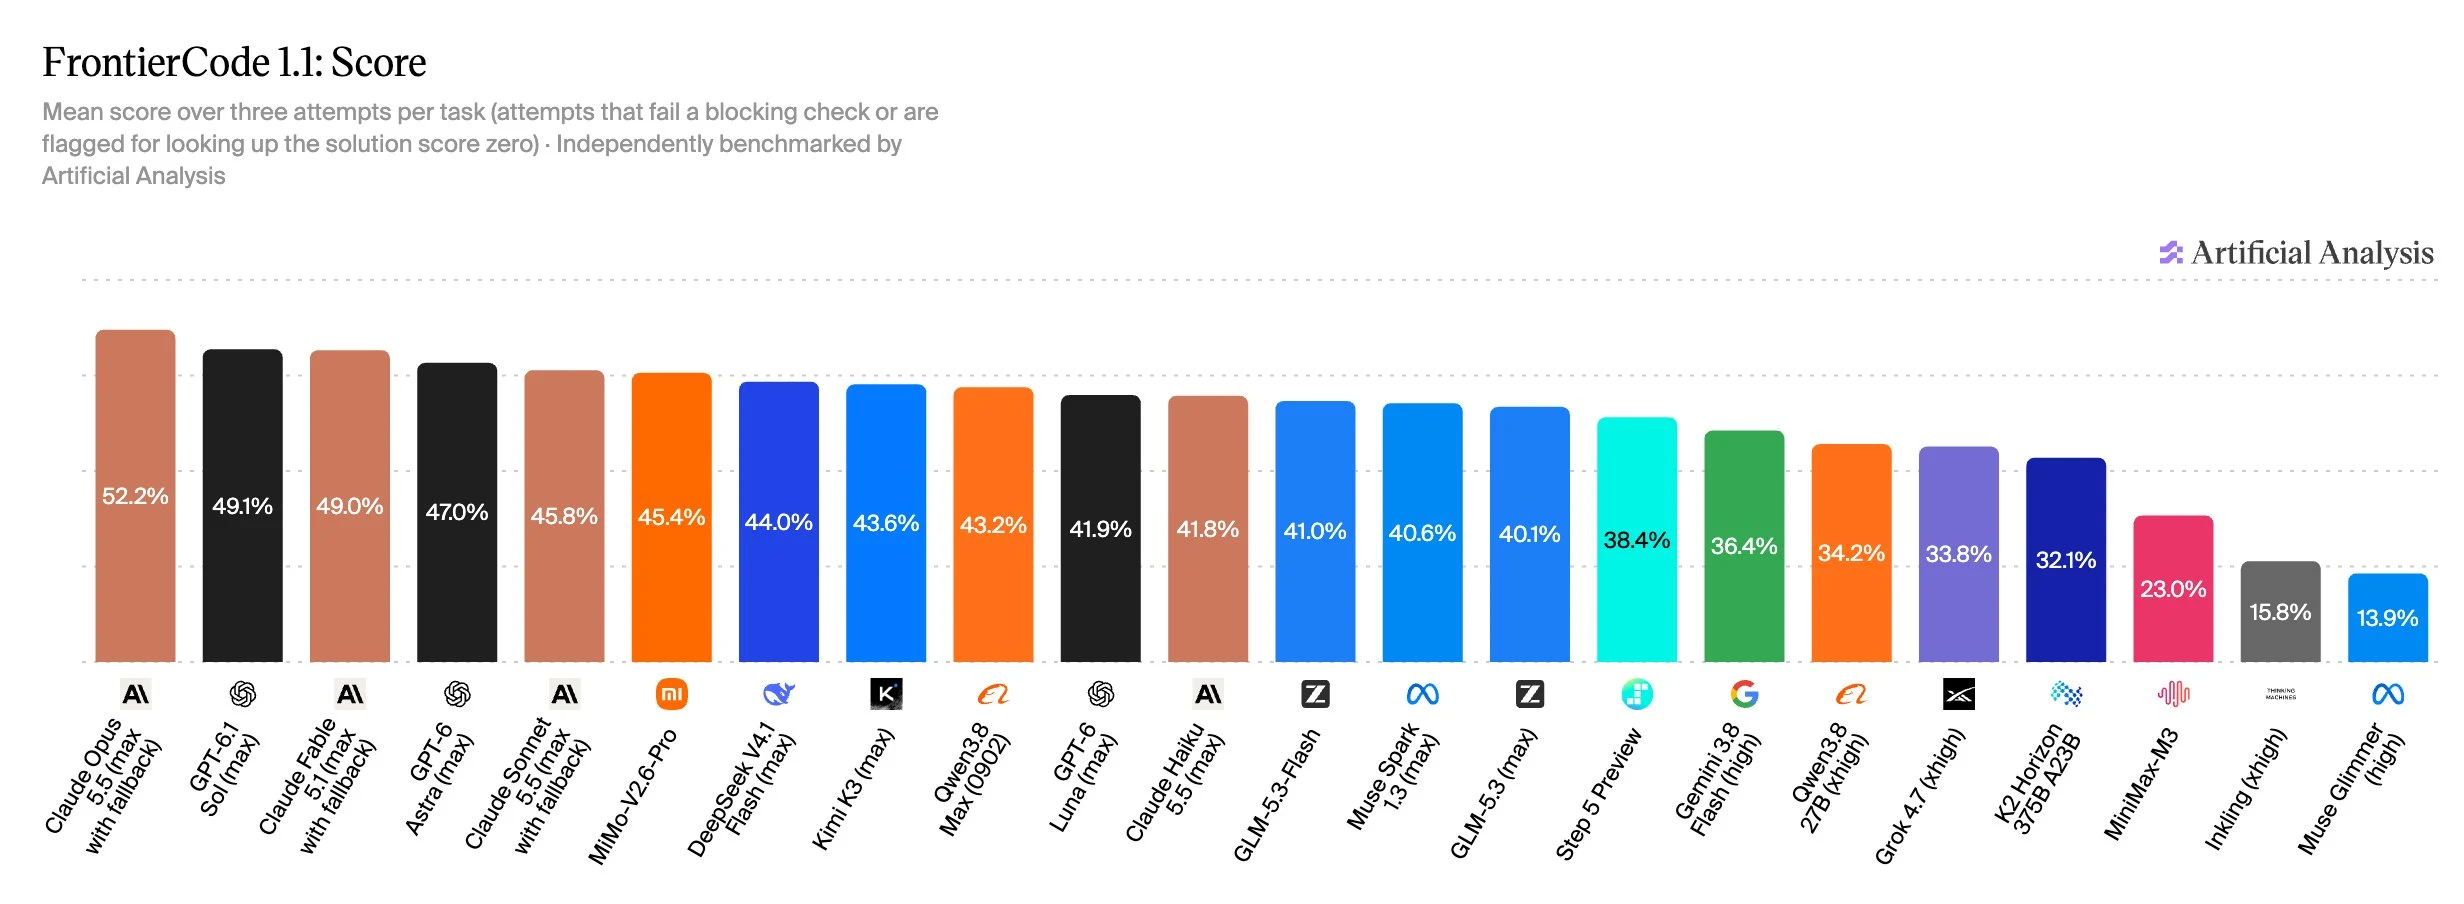
نقوم بإطلاق لوحة الترتيب الخاصة ببروفينتوركود 1.1، وهي تقييم خاص من كوجيتيشن يقوم باختبار النماذج من خلال إكمال مهام البرمجة بطريقة يمكن من خلالها دمجها من قبل أصحاب مستودعات العالم الحقيقي.
أعلن @cognition عن FrontierCode في يونيو 2026، وحدّثه إلى الإصدار 1.1 في يوليو. قامت Cognition ببناء مجموعة البيانات مع مُصممي المصدر المفتوح الذين قضوا أكثر من 40 ساعة على كل مهمة. تتطلب كل مهمة من العميل إجراء تغيير في مستودع المصدر المفتوح الحقيقي، ثم يتم فحص الاختبارات الوحدوية والاختبارات النوعية لما يتطلبه مُصممو المصدر من أجل دمج التغيير.
نقوم بتشغيل FrontierCode 1.1 Main، وهو مجموعة المهام الرئيسية التي تتكون من 100 مهمة من أصل 150 مهمة في الاختبار، باستخدام برنامج Stirrup المفتوح المصدر للتحقق من المقارنة بين النماذج بشكل متساوٍ. جميع المهام سرية لتجنب التلوث. يتم تقييم كل محاولة وفقًا لمعايير الحظر وغير الحظر. المحاولة التي تفشل في أي فحص حظر تحصل على درجة صفر، أما التي تمر بجميع الفحوصات فتحصل على درجة تتراوح بين 70% و100%.
على عكس تقييمات البرمجة الأخرى، يوفر FrontierCode نظرة شاملة أكثر للنجاح بناءً على الاستخدام الفعلي. يجب أن تمر النماذج عبر اختبارات الوحدة، ولكن يتم أيضًا تقييمها من حيث السلوكيات مثل إجراء تغييرات مفرطة وفروق كبيرة، وتعديل الملفات خارج النطاق المناسب، أو إضافة اختبارات غير مفيدة. نعتقد أن هذه الطريقة قيمة في السياق الحالي: فالنماذج أصبحت قادرة جدًا على تنفيذ مهام البرمجة، ولكن تغييراتها لا تزال قد تتطلب تنظيفًا كبيرًا قبل أن يقوم المصمم بدمجها.
النقاط الرئيسية:
➤ الأنظمة الرائدة لا تفشل أكثر من 40% من الوقت: Claude Opus 5.5 (الحد الأقصى مع الاعتماد على بديل) يتصدر بنسبة 52% بعد تجاوز العقبات في 58% من المحاولات. تسعة من أصل 100 مهمة لم تُجتاز بأي محاولة من أي من الأنظمة التي قمنا بتقييمها قبل الإطلاق.
➤ الطبقة العليا في القائمة الرئيسية مكتظة بشدة: تسعة نماذج من ستة معاملات حصلت على درجات تتراوح بين 43% و52%. MiMo-V2.6-Pro هو النموذج الأكثر شعبية في أوزان مفتوحة بدرجة 45%, يليه DeepSeek V4.1 Flash (الحد الأقصى) وKimi K3 (الحد الأقصى) بدرجة 44%.
➤ GPT-6.1 Sol (الحد الأقصى) يقدم أفضل أداء مقابل تكلفته: بتكلفة 0.81 دولار لكل مهمة، يحصل على نسبة 49%، وهي نفس النسبة التي يحصل عليها Claude Fable 5.1 (الحد الأقصى مع الحل البديل). هذا يعني أنه يحقق أداءً مماثلاً للنماذج الرائدة من Anthropic، بتكلفة أقل من عُشر تكلفة كل مهمة.
شكرًا لـ @silasalberti، @ybenpan، @cl571128، وجميع أعضاء فريق Cognition على بناء برنامج FrontierCode والتعاون معنا لإدخاله في علوم التحليل الاصطناعي – نحن نعمل على إضافة برنامج FrontierCode إلى قائمة قادة عاملات البرمجة الخاصة بنا قريبًا.