
تعتمد أحمال العمل الوكيلية متعددة الأدوار على السياق المتراكم حيث يقوم الوكيل بالاستدلال، واستدعاء الأدوات، ودمج النتائج السابقة. ومع كل دورة جديدة، يعيد العميل إرسال تاريخ المحادثة، بما في ذلك تعليمات النظام، والاستدعاءات السابقة، ونتائج الأدوات، واستجابات النموذج، مما يتسبب في معالجة السياق المتنامي بشكل متكرر. In فصل مرحلة التعبئة المسبقة عن فك الترميز (P-D disaggregation)، حيث يتم تقسيم كل طلب عبر عقد متخصصة: تعالج عقدة prefill الموجّه وتبني ذاكرة KV cache الخاصة به، ثم تسترجع عقدة decode تلك كتل KV وتولّد الاستجابة.
غير أنّ التقسيم التقليدي للخدمة (disaggregated serving) ينقل ذاكرة KV المؤقتة في اتجاه واحد فقط: من عقدة التوليد المسبق (prefill) إلى عقدة فك الترميز (decode). هذا التدفق الأحادي الاتجاه يخلق أوجه قصور اثنين لأعباء العمل متعددة الأدوار. أولاً، بعد توليد الاستجابة، تحتفظ عقدة فك الترميز بإدخالات ذاكرة KV المؤقتة لكل من الطلب والرموز المولّدة حديثاً. وعند معالجة الدور التالي، لا تستطيع عقدة التوليد المسبق استرجاع تلك الإدخالات، فتضطر إلى إعادة حساب إسقاطات KV لرموز الاستجابة السابقة. ثانياً، تحتفظ عقدة فك الترميز بحالة الجلسة بينما لا تفعل ذلك عقد التوليد المسبق، مما يزيد احتمال إخلاء الذاكرة المؤقتة للجلسات النشطة على عقد التوليد المسبق. وفي حالة فقدان كامل للذاكرة المؤقتة، يجب على عقدة التوليد المسبق إعادة حساب إسقاطات KV لتاريخ المحادثة بأكمله، بما في ذلك تعليمات النظام وطلبات المستخدم السابقة ونتائج الأدوات والاستجابات المولّدة من النموذج. ومع نمو المحادثة، يستهلك هذا العمل الزائد المزيد من قدرة المسرّع ويزيد الوقت حتى أول رمز (TTFT).
بالنسبة للعملاء الذين يبنون مساعدين محادثة وتطبيقات وكلاء ذكية، يمكن لسجلات التفاعل الأطول أن تزيد من زمن الاستجابة وتستهلك قدرة المسرّعات من خلال حسابات التعبئة المسبقة المتكررة. في هذا المنشور، نوضح كيف نقل ذاكرة التخزين المؤقت KV ثنائي الاتجاه يمكّن عُقد prefill وعُقد decode من إعادة استخدام السياق المحسوب مسبقًا عبر الأدوار المتتالية، مما يحسّن استغلال المسرّعات ويساعد التطبيقات على الحفاظ على زمن TTFT سريع الاستجابة مع نمو المحادثات.
في اختباراتنا متعددة الأدوار على نشر 1P1D باستخدام مثيلات Amazon EC2 P5en المتصلة عبر AWS Elastic Fabric Adapter (AWS EFA، شبكة RDMA منخفضة الكمون المستخدمة عبر الخوادم في AWS)، خفّض نقل KV ثنائي الاتجاه زمن TTFT بنسبة تصل إلى 1.6x لنموذج Qwen3-32B وبنسبة تصل إلى 3.3x للنموذج zai-org/GLM-5-FP8 (انظر قسم بيانات الأداء )؛ وتعتمد النتائج على عبء العمل والتكوين.
بنينا هذه الميزة في الأصل وتحققنا منها على مجموعات مثيلات AWS Trainium المتصلة عبر EFA وساهمنا بها في vLLM كقدرة مستقلة عن المُسرِّع. النتائج المعروضة هنا من مجموعة GPU من نوع Amazon EC2 P5en مزوّدة بـ EFA، مما يُظهر أن الفوائد تنطبق أيضاً على وحدات GPU. يشرح هذا المنشور بنية النقل ثنائي الاتجاه، وتدفق البيانات الوصفية عبر الموجّه، والاحتفاظ بكتل KV وضوابط إعادة الحساب، ونتائج الأداء، وكيفية إعادة إنتاج الاختبار المرجعي.
نقل KV ثنائي الاتجاه
نقل KV ثنائي الاتجاه هو آلية تتيح لعقدة فك الترميز (decode) إعادة KV المحسوب مسبقاً إلى عقدة التعبئة المسبقة (prefill) في الأدوار اللاحقة من المحادثة، متجنّبةً بذلك إعادة حساب السياق المشترك على عقدة prefill، وذلك تحت سيطرة عتبة إعادة حساب KV قابلة للتهيئة. وهذا يخفف من كلا سيناريوي التكرار الحسابي الموصوفين سابقاً، ويتطلب تحقيق ذلك بقاء KV بعد الدور الذي أنتجه وسفرَه في الاتجاه المعاكس، بتنسيق من موجّه واعٍ بذاكرة KV المؤقتة.
تحسينات موصّل NIXL KV للنقل ثنائي الاتجاه
وسّعنا موصّل KV الخاص بمكتبة NVIDIA Inference Xfer Library (NIXL) KV connector ليسمح لعقد prefill باستهلاك كتل KV البعيدة، على غرار الطريقة التي تستهلك بها عقد decode بالفعل كتل KV التي توفرها عقدة prefill. ولا يعد هذا تغييراً بسيطاً، لأن نوعي العقدتين يختلفان معمارياً: تحسب عقد prefill تمثيلات KV للرموز الجديدة في الموجّه (prompt) ويمكنها توفير كتل KV كاملة للموجّه. بينما تفتقر عقد decode إلى القدرة (أو الكفاءة) على توليد تمثيلات KV كاملة ويمكنها فقط تقديم كتل KV المخزّنة مؤقتاً سابقاً. نتيجة لذلك، لا تزال عقد prefill وdecode تحملان أدوارهما ومنطقهما الخاصين لحساب البيانات الوصفية لكتل KV البعيدة والمحلية. أما آلية نقل KV الفعلية (NIXL READ) فهي مشتركة بين الاتجاهين P->D و D->P على حدٍّ سواء.
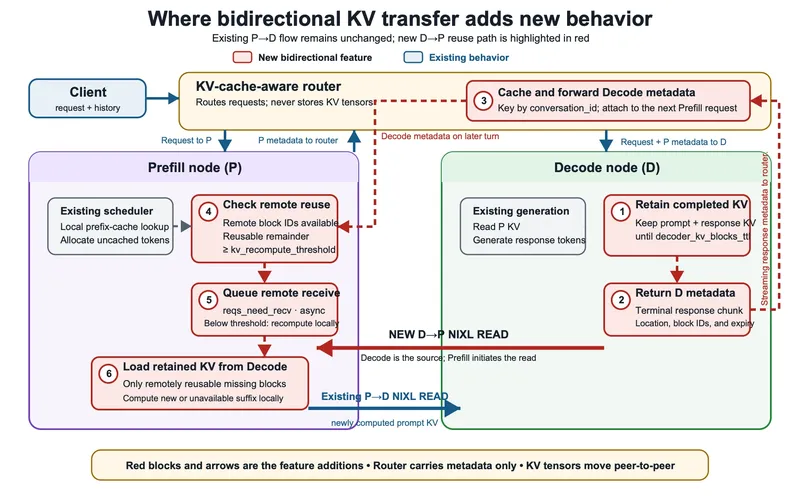
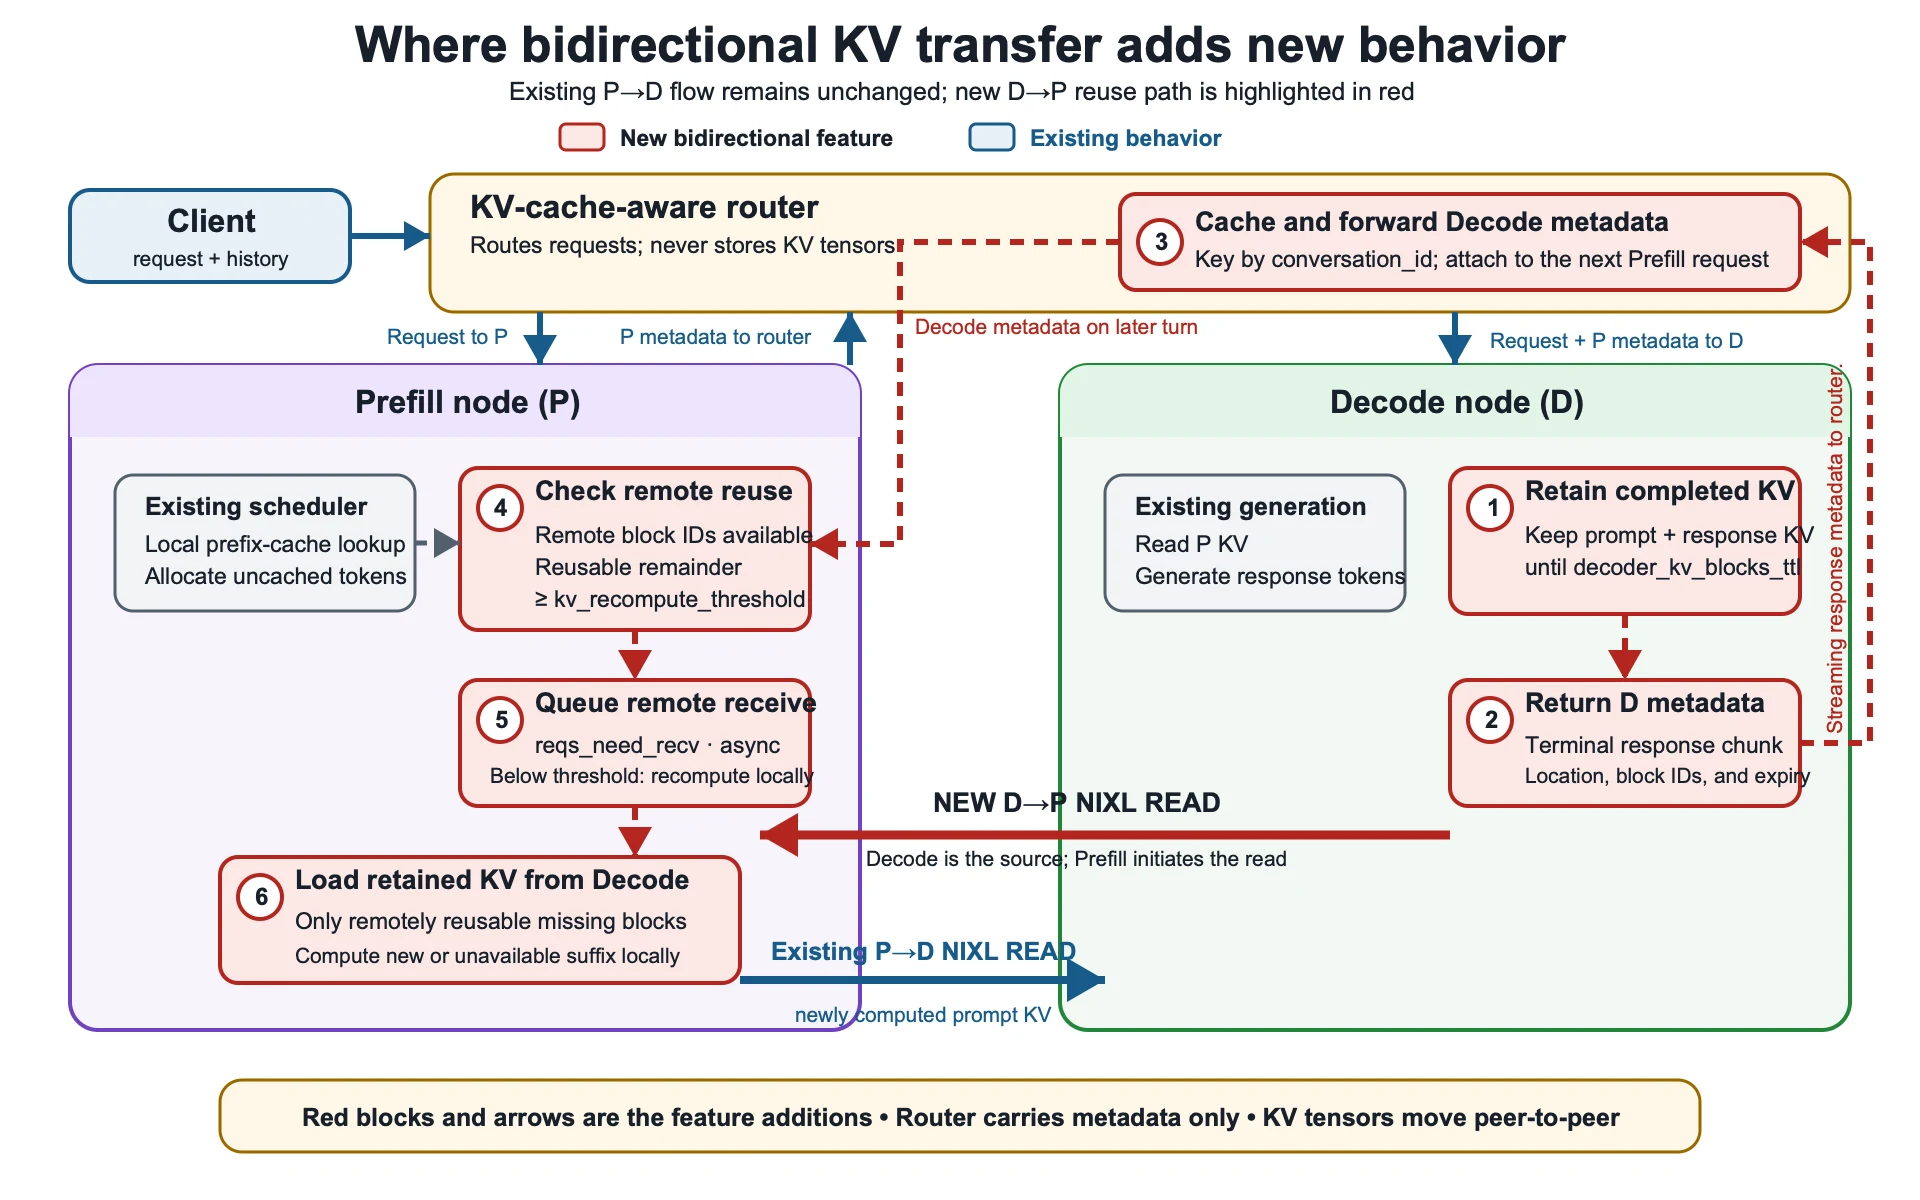
يوضّح المخطط التالي أولاً التدفق الحالي باللون الأزرق: يرسل الموجّه الطلب إلى عقدة prefill، فتحسب عقدة prefill أزواج KV للموجّه وتعيد بياناتها الوصفية للكتل، ثم يمرّر الموجّه الطلب والبيانات الوصفية إلى عقدة decode لإجراء NIXL READ القياسي في اتجاه P→D. ويوضّح المسار الأحمر المرقّم إضافات نقل KV ثنائي الاتجاه: (1) تحتفظ عقدة decode بكتل KV المؤهلة بعد التوليد، (2) وتعيد بياناتها الوصفية في استجابة البث، و(3) يخزّن الموجّه تلك البيانات الوصفية لطلب prefill التالي. ثم تقوم عقدة prefill بـ (4) فحص KV القابلة لإعادة الاستخدام عن بُعد بعد تطبيق مطابقات الذاكرة المؤقتة المحلية، و(5) وضع استقبال غير متزامن في قائمة الانتظار عندما يستوفي عدد الرموز القابلة لإعادة الاستخدام العتبة، و(6) تنفيذ NIXL READ في اتجاه D→P قبل حساب اللاحقة المتبقية.
الموجّه المدرك لذاكرة KV
يضم vLLM دعمًا من جهة الموصّل لنقل KV ثنائي الاتجاه، بينما يتطلب تنسيق إعادة استخدام KV عبر أدوار المحادثة موجّهًا مدركًا لذاكرة KV. يوفر vLLM على GitHub بروكسي مثال ينفّذ التدفق المستخدم في هذه التدوينة ويمكن تكييفه مع بيئتك.
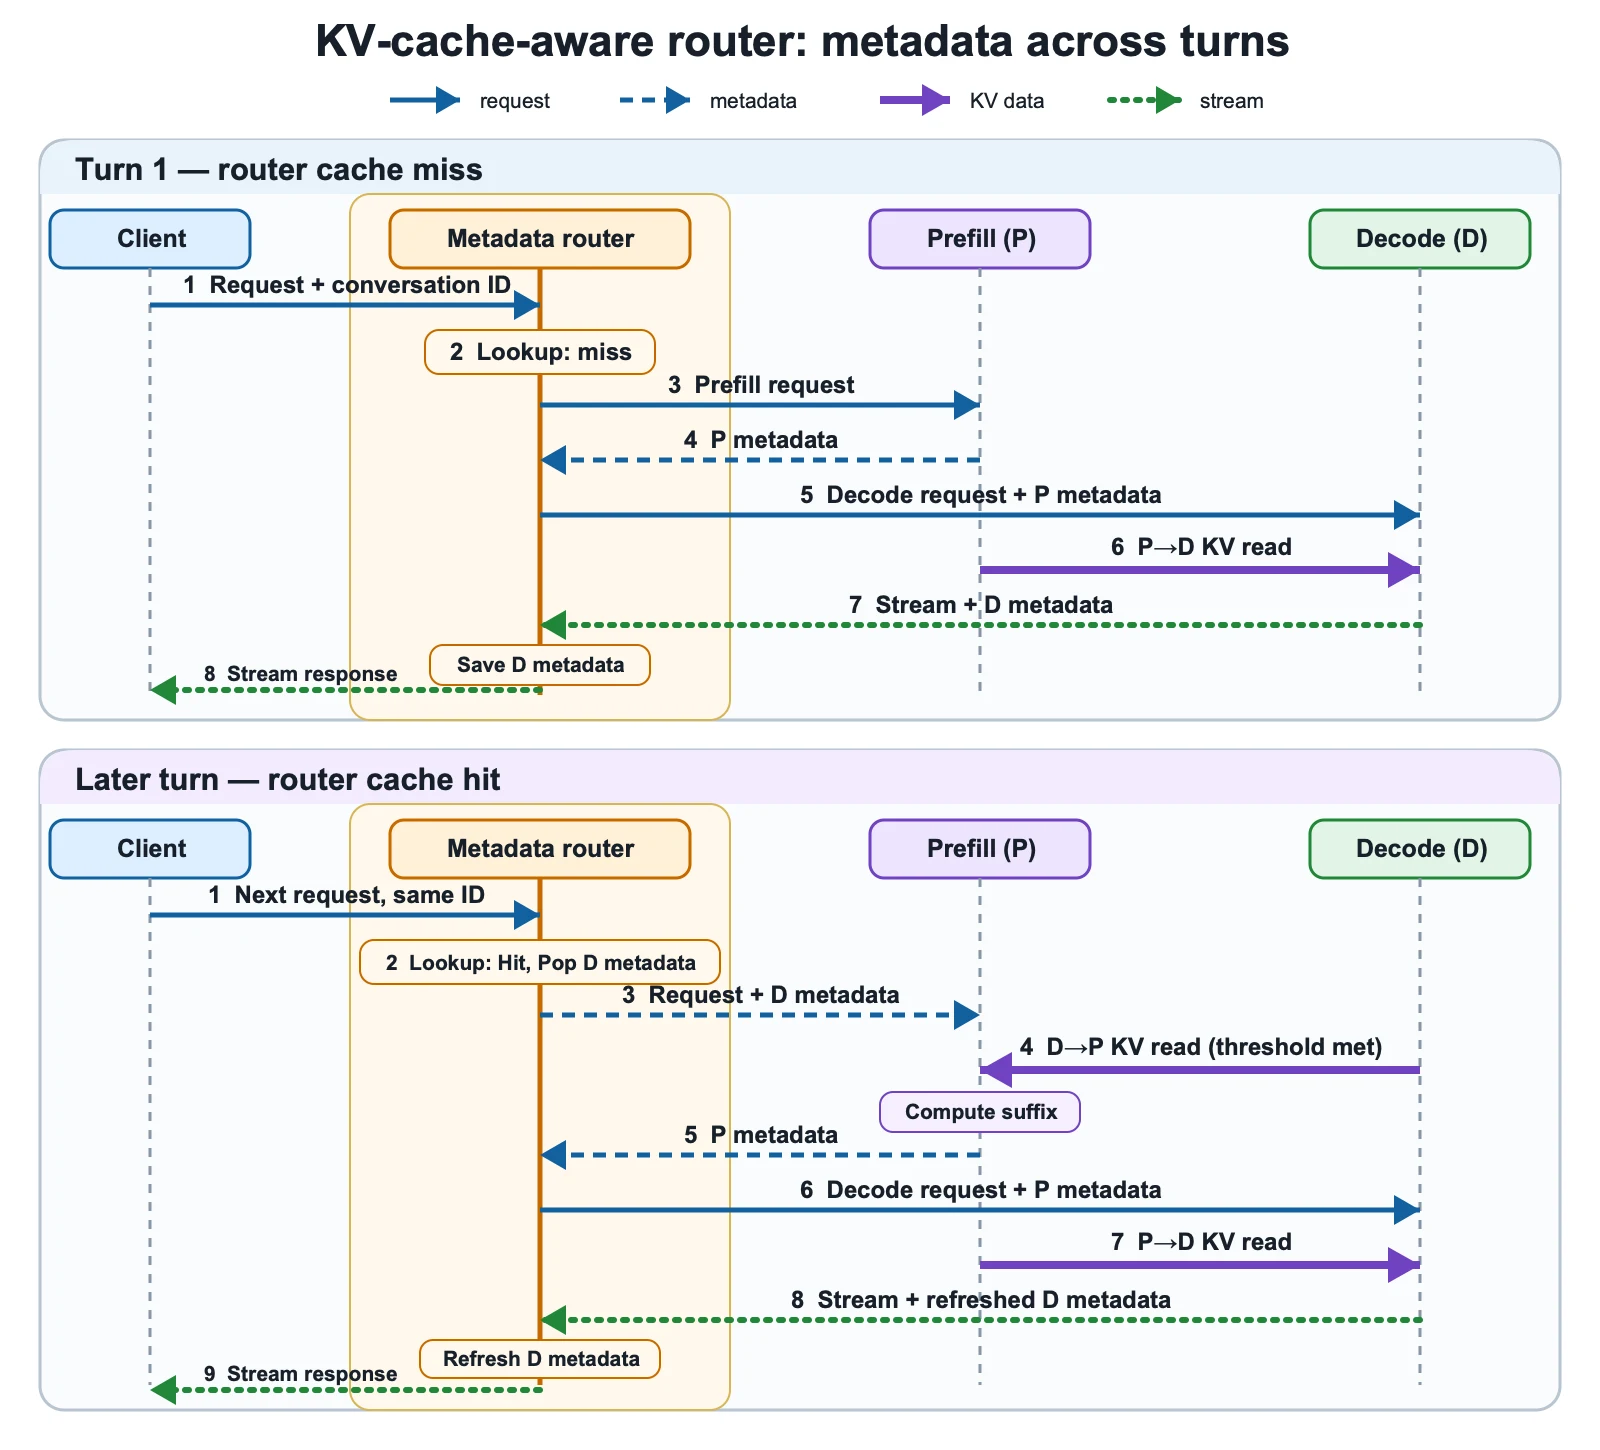
الموجّه المدرك لذاكرة KV هو مكوّن تحكم خفيف الوزن وذو حالة يقع بين العميل وعقدتي prefill وdecode. يحافظ على تعيين في الذاكرة من المعرف المقدّم من العميل conversation_id إلى kv_transfer_paramsالخاص بـ decode. يخزّن الموجّه البيانات الوصفية لمواقع الكتل فقط، لا مقاطع KV، ويحصل على تلك البيانات الوصفية من تدفق الاستجابة بدلًا من الاستعلام عن عقدة decode بشكل منفصل.
يوضح المخطط التالي كيف يدير الموجّه البيانات الوصفية لـ KV عبر أدوار المحادثة. في الدور الأول، تفشل عملية البحث في ذاكرة التخزين المؤقت ويتابع الطلب تدفق P→D القياسي؛ ثم يحفظ الموجّه البيانات الوصفية لـ decode من تدفق الاستجابة. في الأدوار اللاحقة، يسترجع الموجّه تلك البيانات الوصفية باستخدام conversation_idمما يمكّن prefill من إعادة استخدام KV من decode، ويحدّث البيانات الوصفية بعد التوليد للدور التالي.
مدة الاحتفاظ بالكتل TTL
في الحالات العادية، تحرّر نسخة decode كتل الطلب فور انتهاء التوليد. وفي الوضع ثنائي الاتجاه، تحتفظ بها لمدة قابلة للتهيئة (decoder_kv_blocks_ttl، افتراضيًا 480 ثانية) وتنشر موقعها ووقت انتهاء صلاحيتها، بحيث تبقى KV المحادثة، سواء بادئة الموجّه أو الاستجابة المولّدة، متاحة للدور التالي. فعند وصول دور قبل انتهاء صلاحية TTL، تعيد عقدة prefill استخدام KV؛ أما الدور الذي يصل لاحقًا فيعود إلى prefill العادية. ولأن مدة TTL هذه ثابتة ولا تُجدد، فاضبطها على الفاصل الزمني المتوقع بين الأدوار لموازنة إعادة استخدام KV مقابل استهلاك ذاكرة المسرّع. والتحسين الطبيعي التالي هو تمديد الإيجار المُجدد عبر نبضات القلب إلى جانب decode، بحيث تستعيد نسخة decode الكتل فور خمول المحادثة بدلًا من نهاية مؤقّت ثابت.
عتبة إعادة حساب KV
إعادة استخدام KV ليست دائمًا أسرع من إعادة الحساب محليًا. فبالنسبة لبادئة قصيرة قابلة لإعادة الاستخدام، قد تتجاوز تكاليف الاتصال البيني والتنسيق الوقت اللازم لإعادة حساب الرموز. ويتحكم في هذا القرار الإعداد kv_recompute_threshold ، الذي يكون افتراضيًا 64 رمزًا. تعيد عقدة prefill الحساب عندما يكون عدد الرموز المطلوب حسابها أقل من العتبة، وتسحب KV من عقدة decode عندما يساوي العتبة أو يزيد عليها. ويمكن للنشرات ضبط هذه القيمة بناءً على زمن حساب النموذج وحجم KV وأداء الاتصال البيني.
بيانات الأداء
للتقييم، استخدمنا نموذجي Qwen3-32B وGLM-5-FP8 على نشر بنمط 1P1D باستخدام نسخ Amazon EC2 P5en المتصلة عبر EFA. وللمحاكاة الحالات التي تكون فيها عقدة prefill قد أزالت ذاكرة التخزين المؤقت المحلية أو يختار فيها الموجّه عقدة prefill مختلفة لا تملك كتل KV للمحادثة، عطّلنا التخزين المؤقت للبادئات على عقدة prefill باستخدام --no-enable-prefix-caching.
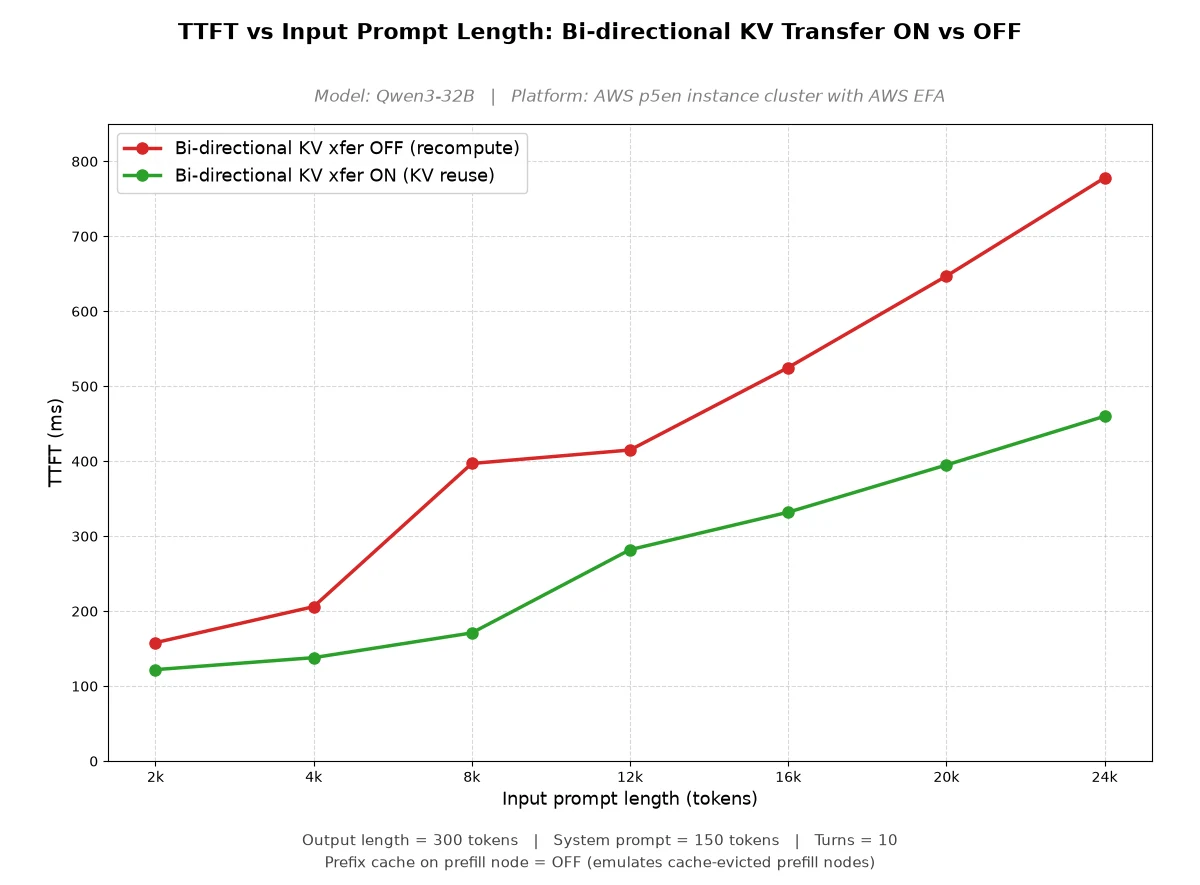
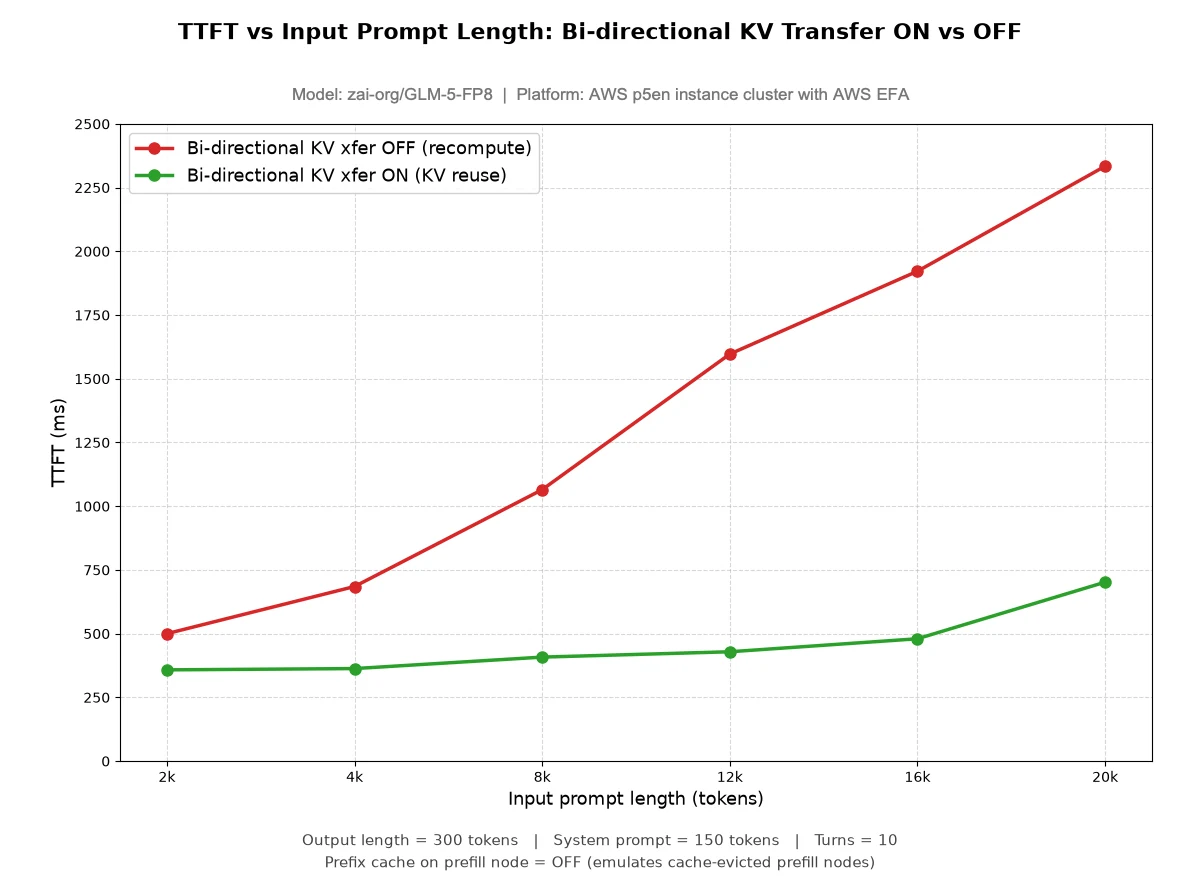
في كلا النموذجين، يؤدي تشغيل نقل KV ثنائي الاتجاه إلى تقليل حسابات prefill في المحادثات متعددة الأدوار، وتزداد الفائدة عادةً مع طول الموجّه. مع إيقاف الميزة، تعيد نسخة prefill حساب السياق المتنامي بالكامل في كل دور، فيرتفع TTFT بشكل حاد: يتدرّج Qwen3-32B من 158 ملي ثانية عند 2k إلى 778 ملي ثانية عند 24k، وGLM-5-FP8 من 500 ملي ثانية عند 2k إلى 2,334 ملي ثانية عند 20k. ومع تشغيلها، تُعاد استخدام KV المحتجزة لدى نسخة decode بدلًا من إعادة حسابها، فيبقى TTFT أكثر استواءً بكثير: يرتفع Qwen3-32B فقط من 122 ملي ثانية إلى 460 ملي ثانية عبر النطاق نفسه (نحو خفض بمقدار 1.6x عند أطول موجّه)، بينما يرتفع GLM-5-FP8 من 358 ملي ثانية إلى 702 ملي ثانية ويعمل بما يصل إلى 3.3x أقل من مسار إعادة الحساب عند الموجّهات الطويلة. ويوضح تفصيل مدة prefill السبب.
يضيف النقل ثنائي الاتجاه وقتاً صغيراً لنقل KV (حوالي 30 ms إلى 130 ms للطراز Qwen3-32B؛ وحوالي 29 ms إلى 110 ms للطراز GLM-5-FP8)، لكن الحسابات الحسابية لمرحلة prefill التي يلغيها تفوق ذلك الوقت المنقضي في نقل KV بكثير. ونتيجة لذلك، تبقى المدة الإجمالية لمرحلة prefill مع تفعيل النقل (Qwen3-32B: من 128 ms إلى 414 ms؛ GLM-5-FP8: من 316 ms إلى 541 ms) أقل بكثير من مسار إعادة الحساب فقط (Qwen3-32B: من 153 ms إلى 744 ms؛ GLM-5-FP8: من 500 ms إلى 2,331 ms). ويُظهر النموذج الأكبر GLM-5-FP8 فجوة أكبر مطلقة ونسبياً، لأن ارتفاع وقت إعادة الحساب لكل رمز فيه يجعل إعادة استخدام KV أكثر جدوى كلما تزايد حجم النماذج وسياقاتها.
Qwen3-32B
يرسم المخطط أدناه TTFT مقابل طول المطالبة للطراز Qwen3-32B، مقارنةً بين تفعيل نقل KV ثنائي الاتجاه وإيقافه.
يُفصّل المخطط التالي مدة مرحلة prefill لنفس التشغيلات إلى مكوّني إعادة الحساب ونقل KV.
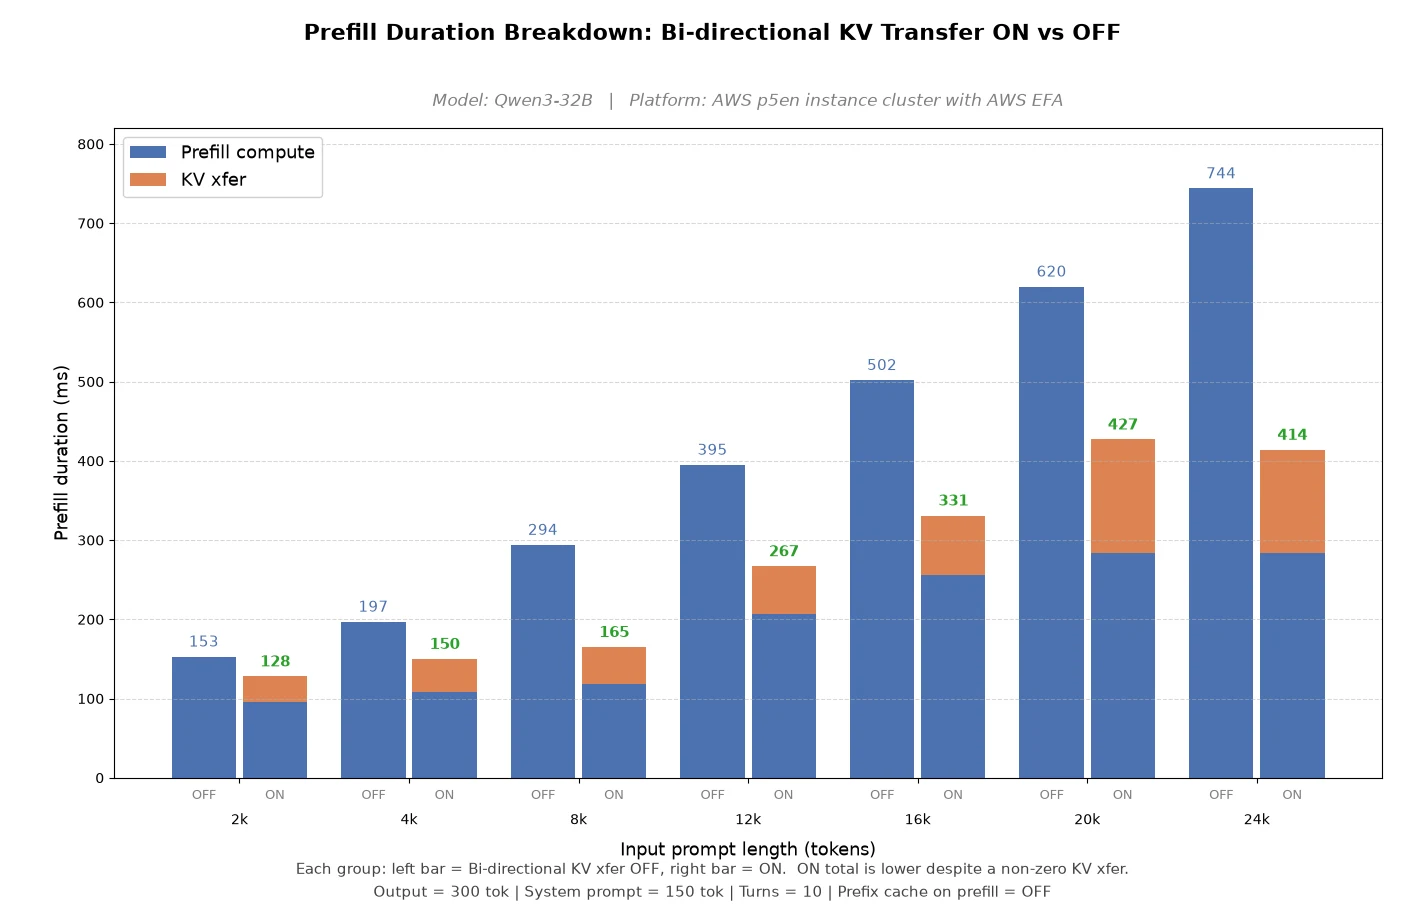
تُظهر المخططات مجتمعةً بقاء TTFT شبه ثابت مع تفعيل الميزة بينما يرتفع مسار الإيقاف بشكل حاد مع نمو السياق، لأن الوقت الصغير المنقضي في نقل KV يتفوق عليه بكثير الحساب الذي يلغيه.
zai-org/GLM-5-FP8
يأتي فيما يلي المنظوران نفسهما للطراز GLM-5-FP8. يرسم الأول TTFT مقابل طول المطالبة مع تفعيل الميزة مقابل إيقافها.
يفصّل الثاني مدة مرحلة prefill إلى مكوّني إعادة الحساب ونقل KV.
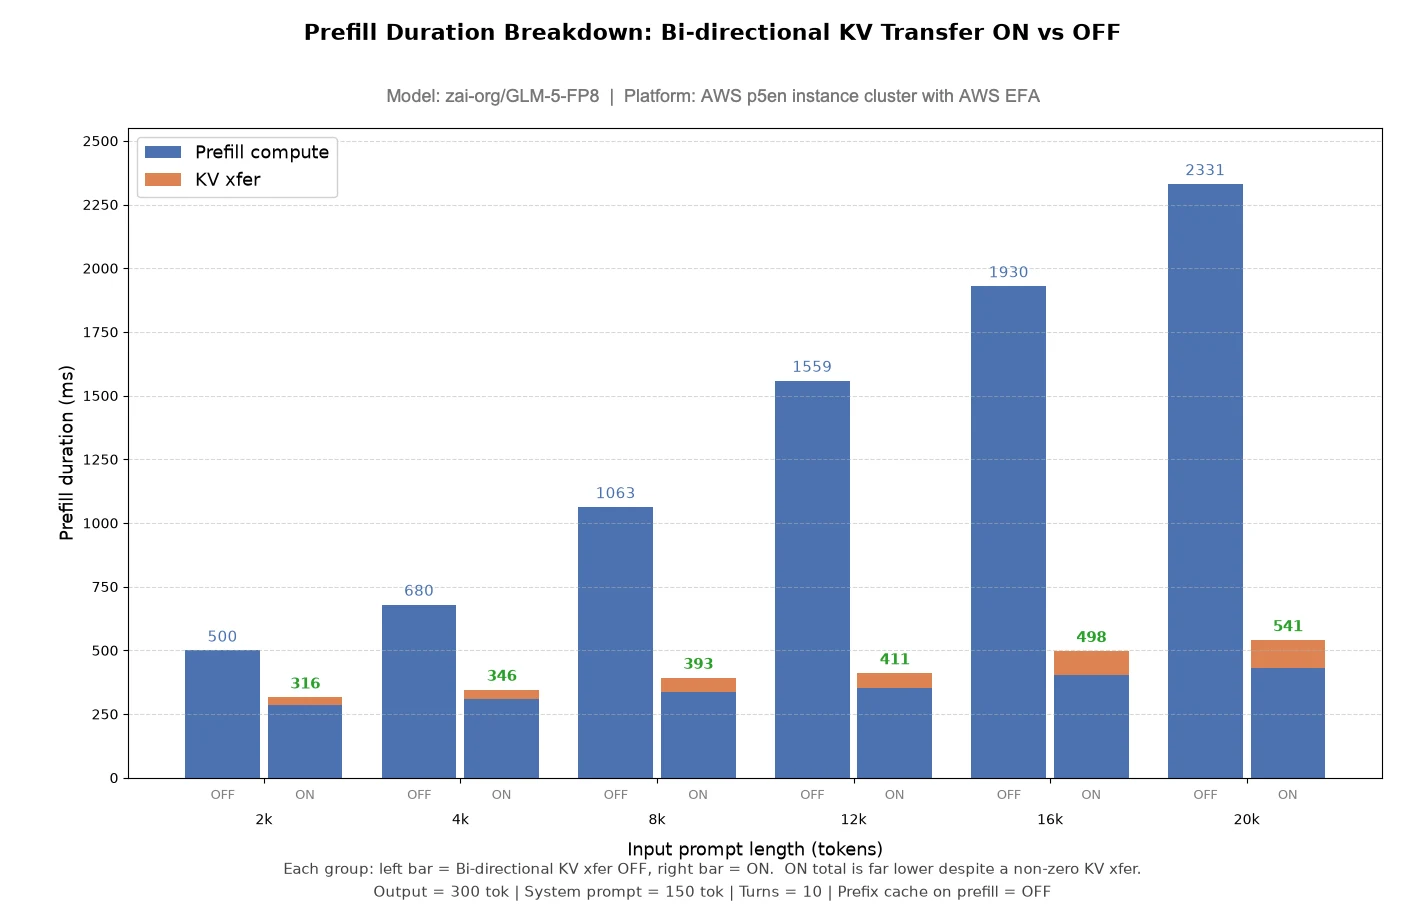
يُظهر GLM-5-FP8 فجوة أكبر بكثير من Qwen3-32B، إذ يصل الانخفاض إلى نحو 3.3x في TTFT عند المطالبات الطويلة، لأن ارتفاع وقت إعادة الحساب لكل رمز فيه يجعل إعادة استخدام KV أكثر جدوى كلما زاد طول السياق.
كيفية تشغيل المعيار المرجعي
لإعادة إنتاج تكوين المعيار المرجعي لدينا 1P1D، أي عقدة prefill واحدة وعقدة decode واحدة، باستخدام مثيلات Amazon EC2 P5en مع EFA، اتبع التعليمات خطوة بخطوة في إعادة إنتاج نتائجنا الدليل أدناه. يغطي الدليل إعداد البيئة، وإطلاق خوادم vLLM لكل من prefill وdecode، وتشغيل المعيار المرجعي، وجمع النتائج. يمكن تشغيل الميزة على تكوينات أخرى مدعومة، لكن ستختلف نتائج الأداء تبعاً للعتاز والموديل وحِمل العمل وإعداد الشبكة.
الخلاصة
في هذه التدوينة، عرضنا كيف يمكن لنقل ذاكرة التخزين المؤقت KV ثنائي الاتجاه أن يقلل TTFT مع نمو سجل محادثة الوكيل. في عمليات النشر المفككة P-D، تتيح الميزة لعقدة prefill إعادة استخدام كتل KV المحتفظ بها لدى عقدة decode عبر الأدوار، ما يقلل الحسابات المتكررة. وتحدد عتبات الاحتفاظ بالكتل القابلة للتهيئة وعتبات إعادة الحساب متى يحدث الحجز. في عملية نشر 1P1D باستخدام مثيلات Amazon EC2 P5en المتصلة عبر EFA، وفي أطول أطوال المطالبات المُختبَرة، لاحظنا انخفاضات في TTFT بلغت 1.6x للطراز Qwen3-32B و3.3x للطراز zai-org/GLM-5-FP8؛ وتعتمد النتائج على حِمل العمل وإعداد النشر. لتنفيذ ذلك في بيئتك، استخدم vLLM v0.21.0 أو أحدث مع NixlConnector، وفعّل bidirectional_kv_xfer على خوادم prefill وdecode معاً، واستخدم موجّهاً واعياً بذاكرة التخزين المؤقت KV، واتبع دليل إعادة الإنتاج.
موارد ذات صلة
- AWS EFA
- خدمة مفككة Prefill-Decode (P-D)
- معيار مرجعي لمزج ذاكرة التخزين المؤقت KV مع المحادثات متعددة الأدوار
شكر وتقدير
نشكر Nicolò Lucchesi (Mistral) وMark McLoughlin (Red Hat) ومجتمع vLLM على دعمهم في صيانة هذه الميزة.
ملحق: إعادة إنتاج نتائجنا
يتمثل التصميم الشبكي في مثيلي AWS p5en (prefill على :8100، وdecode على :8200) مع تمكين EFA، إضافة إلى عقدة صغيرة ثالثة تشغّل الوسيط وعميل المعيار المرجعي على :8000.
ثلاثة سكربتات تُرفق مع هذا المنشور: serve_pd_multiturn.sh يُطلق أيًّا من الطرفين مع تفعيل الميزة أو تعطيلها، run_multiturn_sweep.sh يقود مسح طول المطالبة، و cleanup.sh يفرغ النشر بالكامل.
بيئة الاختبار
تم إعداد كلتا عقدتي الـ GPU بطريقة متطابقة:
| نوع المثيل | p5en.48xlarge (8x NVIDIA H200)، واحدة للـ prefill وواحدة للـ decode |
| المنطقة / منطقة التوافر | ap-south-1 (مومباي)، ap-south-1b (معرّف منطقة التوافر aps1-az3)، كلتا العقدتين في نفس منطقة التوافر |
| التوزيع | لا توجد مجموعة توزيع عنقودية؛ تم تشغيل كلا المثيلين في حجز سعة On-Demand مستهدف بإيجار افتراضي |
| صورة AMI | صورة AWS ParallelCluster 3.14.2 عامة لـ Ubuntu 24.04 x86_64، aws-parallelcluster-3.14.2-ubuntu-2404-lts-hvm-x86_64-202602121713 (ami-0133f195033a4baae في ap-south-1؛ تختلف معرفات AMI حسب المنطقة). تأتي بنواة 6.14.0-1018-aws، وبرنامج تشغيل NVIDIA 570، وCUDA 12.8، لذا قم بترقية برنامج التشغيل وCUDA toolkit ومثبت EFA إلى الإصدارات أدناه. |
| نظام التشغيل / النواة | Ubuntu 24.04.4 LTS، 6.14.0-1018-aws |
| برنامج تشغيل NVIDIA / CUDA | برنامج التشغيل 580.126.16 (واجهة برمجة تطبيقات CUDA 13.0 driver API)؛ CUDA toolkit 13.0 |
| واجهات EFA | 16 لكل مثيل، واحدة لكل بطاقة شبكة (البطاقات 0-15، وكلها من نوع الواجهة efa)، بسرعة 200 جيجابت/ثانية لكل منها ليصبح المجموع 3.2 تيرابت/ثانية. توجد 8 واجهات على كل عقدة NUMA، وكل GPU يتشارك مفتاح PCIe مع 2 منها. |
| برمجيات EFA | مثبت EFA 1.50.0, وحدة نواة EFA 3.3.0g, libfabric 2.6.0amzn1.0, rdma-core 64.0amzn0 |
اختيار أجهزة EFA بواسطة NIXL. تفتح الواجهة الخلفية LIBFABRIC جميع أجهزة EFA الـ 16 كمسارات باستخدام المزود efa للمزود. ثم يسجّل ذاكرة KV cache لكل GPU فقط على الـ 2 rails اللذين يتشاركان مفتاح PCIe الخاص بذلك الـ GPU، بحيث تبقى كل عملية نقل محلية ضمن PCIe. لم يتم تعيين أي تجاوزات لأجهزة NIXL أو libfabric؛ وهذا هو الاختيار الافتراضي. للتأكد من ذلك على عقدك الخاصة، شغّل الخوادم مع NIXL_LOG_LEVEL=DEBUG وتحقق من أسطر التسجيل:
grep -E "Created rail [0-9]+ \(device=|mapped to rail" server.log1. تجهيز العقد
قم بتثبيت مجموعة برمجيات EFA في مساحة المستخدم على كلا عقدتي GPU وتأكد من وجود المزود. استخدمنا المثبت 1.50.0:
curl -O https://efa-installer.amazonaws.com/aws-efa-installer-1.50.0.tar.gz
tar -xf aws-efa-installer-1.50.0.tar.gz && cd aws-efa-installer
sudo ./efa_installer.sh -y
fi_info --version         # libfabric 2.6.0amzn1.0
fi_info -p efa -t FI_EP_RDM            # verify the EFA provider is present on both GPU nodes
2. تثبيت vLLM وNIXL على كلا عقدتي GPU
python3 -m venv ~/venv-pd && source ~/venv-pd/bin/activate
pip install --upgrade pip && pip install vllm==0.29.0 nixl==1.4.1
طبّق PR الخاص بـ vLLM #40186 مرة واحدة على كلتا العقدتين. يضيف kv_transfer_params إلى بث الاستجابات، وهو ما يحتاجه الوكيل متعدد الأدوار لربط الأدوار: يستعلم الوكيل دائمًا عقدة فك التشفير باستخدام stream=True، لذا بدون هذه الرقعة لا تُعيد عقدة فك الترميز (decode) بيانات الكتلة الوصفية أبدًا وينتهي كل دور كم إخفاق في ذاكرة التخزين المؤقت (cache miss).
SITE=$(python -c 'import site; print(site.getsitepackages()[0])')
curl -sL https://github.com/vllm-project/vllm/pull/40186.diff -o /tmp/40186.diff
patch -p1 -d "$SITE" --fuzz=3 < /tmp/40186.diff
3. تنزيل النموذج
export HF_HOME=/fsx/huggingface        # a large shared volume
hf download Qwen/Qwen3-32B
4. تشغيل زوج P/D
Run serve_pd_multiturn.sh مرة واحدة لكل عقدة GPU. BIDIR هو الشيء الوحيد الذي يتغير بين الساقين من اختبار A/B، ويجب أن يتطابق على العقدتين:
# on the prefill node
P_IP=<P_IP> D_IP=<D_IP> ROLE=prefill BIDIR=false ./serve_pd_multiturn.sh
# on the decode node
P_IP=<P_IP> D_IP=<D_IP> ROLE=decode  BIDIR=false ./serve_pd_multiturn.sh
والذي يتوسع إلى، على جانب prefill:
export FI_PROVIDER=efa
export VLLM_NIXL_SIDE_CHANNEL_HOST=<P_IP> VLLM_NIXL_SIDE_CHANNEL_PORT=5600
vllm serve Qwen/Qwen3-32B --served-model-name Qwen --dtype bfloat16 \
  --tensor-parallel-size 8 --max-model-len 32768 --max-num-seqs 8 \
  --no-enable-prefix-caching --port 8100 \
  --kv-transfer-config '{"kv_connector":"NixlConnector","kv_buffer_device":"cuda",
    "kv_role":"kv_producer","engine_id":"prefill-engine-001","kv_rank":0,
    "kv_parallel_size":2,"kv_connector_extra_config":{"backends":["LIBFABRIC"],
    "kv_recompute_threshold":64,"decoder_kv_blocks_ttl":480,
    "bidirectional_kv_xfer":false}}'
--no-enable-prefix-caching يُضبط على عقدة prefill فقط — وهذا هو سيناريو إخلاء ذاكرة التخزين المؤقت الذي يحاكيه الاختبار المعياري. اترك تمكين التخزين المؤقت للبادئة (prefix caching) على عقدة decode. انتظر حتى تُرجع كلا /health النقطتين النهائيتين الرمز 200.
5. بدء تشغيل الوكيل متعدد الأدوار
python3 -m venv ~/venv-proxy && source ~/venv-proxy/bin/activate
pip install fastapi uvicorn httpx pandas numpy aiohttp transformers tqdm
sudo dnf install -y jq || sudo apt-get install -y jq
git clone --depth 1 --branch v0.29.0 https://github.com/vllm-project/vllm.git ~/vllm_src
export VLLM_SRC=~/vllm_src

python3 $VLLM_SRC/examples/disaggregated/disaggregated_serving/disagg_proxy_multiturn.py \
  --port 8000 --prefiller-host <P_IP> --prefiller-ports 8100 \
  --decoder-hosts <D_IP> --decoder-ports 8200 \
  2>&1 | tee ~/proxy_$(date +%Y%m%d_%H%M%S).log
يأخذ الوكيل المضيفات والمنافذ، وليس عناوين URL. يُدفع إعادة الاستخدام من قِبل العميل عبر إرسال conversation_id، لذا لا توجد علامة لتمكينه هنا.
6. تشغيل ساق OFF ثم ساق ON
VLLM_SRC=~/vllm_src LEG=off ./run_multiturn_sweep.shبالنسبة لساق ON، أوقف كلا الخادمين والوكيل، وأعد تشغيل الخطوة 4 مع BIDIR=true على كل عقدة، وأعد تشغيل الوكيل (ذاكرة التخزين المؤقت للمحادثة الخاصة به داخل العملية)، ثم:
VLLM_SRC=~/vllm_src LEG=on ./run_multiturn_sweep.shكرر الساقين لـ GLM-5-FP8 مع MODEL=zai-org/GLM-5-FP8 SERVED_NAME=GLM.
7. جمع الأرقام
ثلاث كميات، واحدة لكل مصدر:
- TTFT، من ملف JSON الخاص بإحصاءات كل طلب في الاختبار المعياري المكتوب بواسطة
--stats-json-output. تحمل كل سجلttft_msبجانبinput_num_tokensوconversation_id. هذا هو المحور العمودي (y-axis) في مخططات TTFT. - مدة الـ prefill، من سجل الوكيل، الذي يُبلّغ عن ساق prefill لكل طلب على شكل
Prefill done in <N>ms. هذا هو الارتفاع الكلي لكل عمود في تفصيل مدة الـ prefill. - زمن وحجم نقل KV، من سجل عقدة الـ prefill، الذي يُبلّغ عن أسطر
KV Transfer metrics:متضمنة متوسط زمن النقل وP90 وعدد البايتات لكل نقل ومعدل النقل. هذا هو مكوّن KV-xfer لكل عمود ON.
يتم تسجيل قياسات NIXL telemetry من قبل الجهة التي تبدأ النقل، لذا يظهر القراءة العكسية D->P في سجل عقدة prefill بينما يظهر السحب المعتاد P->D في سجل عقدة decode.
احسب متوسط كل قيمة لكل طول prompt، ثم ارسم: TTFT مقابل طول الـ prompt كخطين (ON و OFF)، ومدة prefill كأعمدة مكدّسة متزاوجة لكل طول prompt، مع تقسيم عمود ON إلى حساب prefill ونقل KV. الفرق بين المنظورين هو بيت القصيد — تكلفة النقل التي تكشفها الأعمدة هي ما تحوّله خطوط TTFT إلى توفير.
استكشاف الأخطاء وإصلاحها
- يسجل البروكسي دائمًا
cache MISSفي تشغيل ON — العنصر مفقود--send-conversation-id، أو لم يتم تطبيق PR #40186 على كلا العقدتين، أوBIDIR=falseمتروك على عقدة decode، وفي هذه الحالة لا يُرجع أيkv_transfer_paramsعلى الإطلاق. Declining expired remote readعلى عقدة prefill — انتهت صلاحية كتل عقدة decode قبل وصول الدور التالي. ارفعdecoder_kv_blocks_ttl(الافتراضي 480 ثانية) وأبقِ TTL لذاكرة التخزين المؤقت للبروكسي أقل منه.fi_info -p efaفارغ أو يرجع إلى sockets — موفّر EFA مفقود. أعد تثبيتaws-efa-installerوتأكد من أن المثيلات قد أُطلقت بواجهات مفعّلة مع EFA؛ بدونه يفشل NIXL إما في التهيئة أو يعمل بصمت عبر TCP، مما يجعل أرقام النقل بلا معنى.
التنظيف
./cleanup.sh proxy      # on the proxy / benchmark driver node
./cleanup.sh server     # on each GPU node
ثم أنهِ المثيلات وتحقق من عدم بقاء أي منها قيد التشغيل.