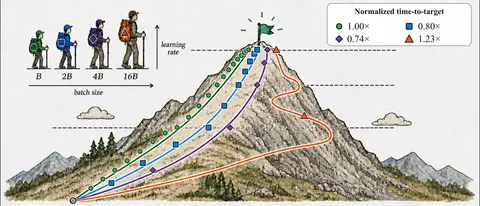
تتيح الـ batch الأكبر معالجة تسلسلات أكثر في كل تحديث، وبالتالي الاستفادة من موارد حوسبة متوازية أكثر؛ لكن عند ثبات ميزانية العينات، ينخفض عدد المرات التي يمكن فيها للنموذج أن يُحدَّث. في التعلم المعزز، متى تكون زيادة الـ batch قادرة على تقليص الوقت الفعلي اللازم للوصول إلى الأداء المستهدف؟ وفيما يتعلق بالنماذج اللغوية الكبيرة، يجب أيضًا مراعاة أن مسارات التدريب تحتاج إلى توليدها عبر الإنترنت، وأن احتياجات التوليد والتدريب من الموارد الحاسوبية ليست متماثلة. أنشأنا إطارًا تحليليًا يربط عدد العينات اللازمة للوصول إلى الهدف مع الإنتاجية من البداية إلى النهاية: لا يمكن للـ batch الأكبر تسريع التدريب إلا إذا تجاوزت مكاسب الإنتاجية كلفة العينات الإضافية. ويقدم هذا أيضًا تسلسلًا عمليًا لضبط المعاملات: أولًا إيجاد النطاق الذي يبقى فيه تأثير التعلم شبه دون تغيير عند تغير حجم الـ batch، ثم تحسين الإنتاجية ضمن هذا النطاق. تُظهر تجارب GRPO وPPO أنه بعد إعادة ضبط معدل التعلم، تتقارب منحنيات التعلم ل的不同 أحجام الـ batch بشكل تقريبي عند مقارنتها وفق عدد العينات التراكمي ضمن نطاق معين. على عتاد ثابت، أدت زيادة الـ batch إلى رفع إنتاجية التوليد بما يصل إلى 2.29 مرة؛ وأفضل إعداد GRPO قسناه قلّص الوقت اللازم للوصول إلى نفس هدف التحقق بنسبة 29% دون زيادة عدد وحدات الـ GPU.