
Mistral Large 4 ist Europas Billionen-Parameter-Antwort auf US-Modelle, die Sicherheitsarbeit verweigern
 Jonathan Kemper
LinkedIn-Profil von Jonathan Kemper ansehen
6. Oktober 2026
 Nano Banana Pro, prompting durch THE DECODER
Kernpunkte
- Mistral hat eine Vorschau von Mistral Large 4 veröffentlicht, einem Modell mit einer Billion Parametern, das in Europa trainiert wurde. Die Modellgewichte werden Ende Oktober erwartet.
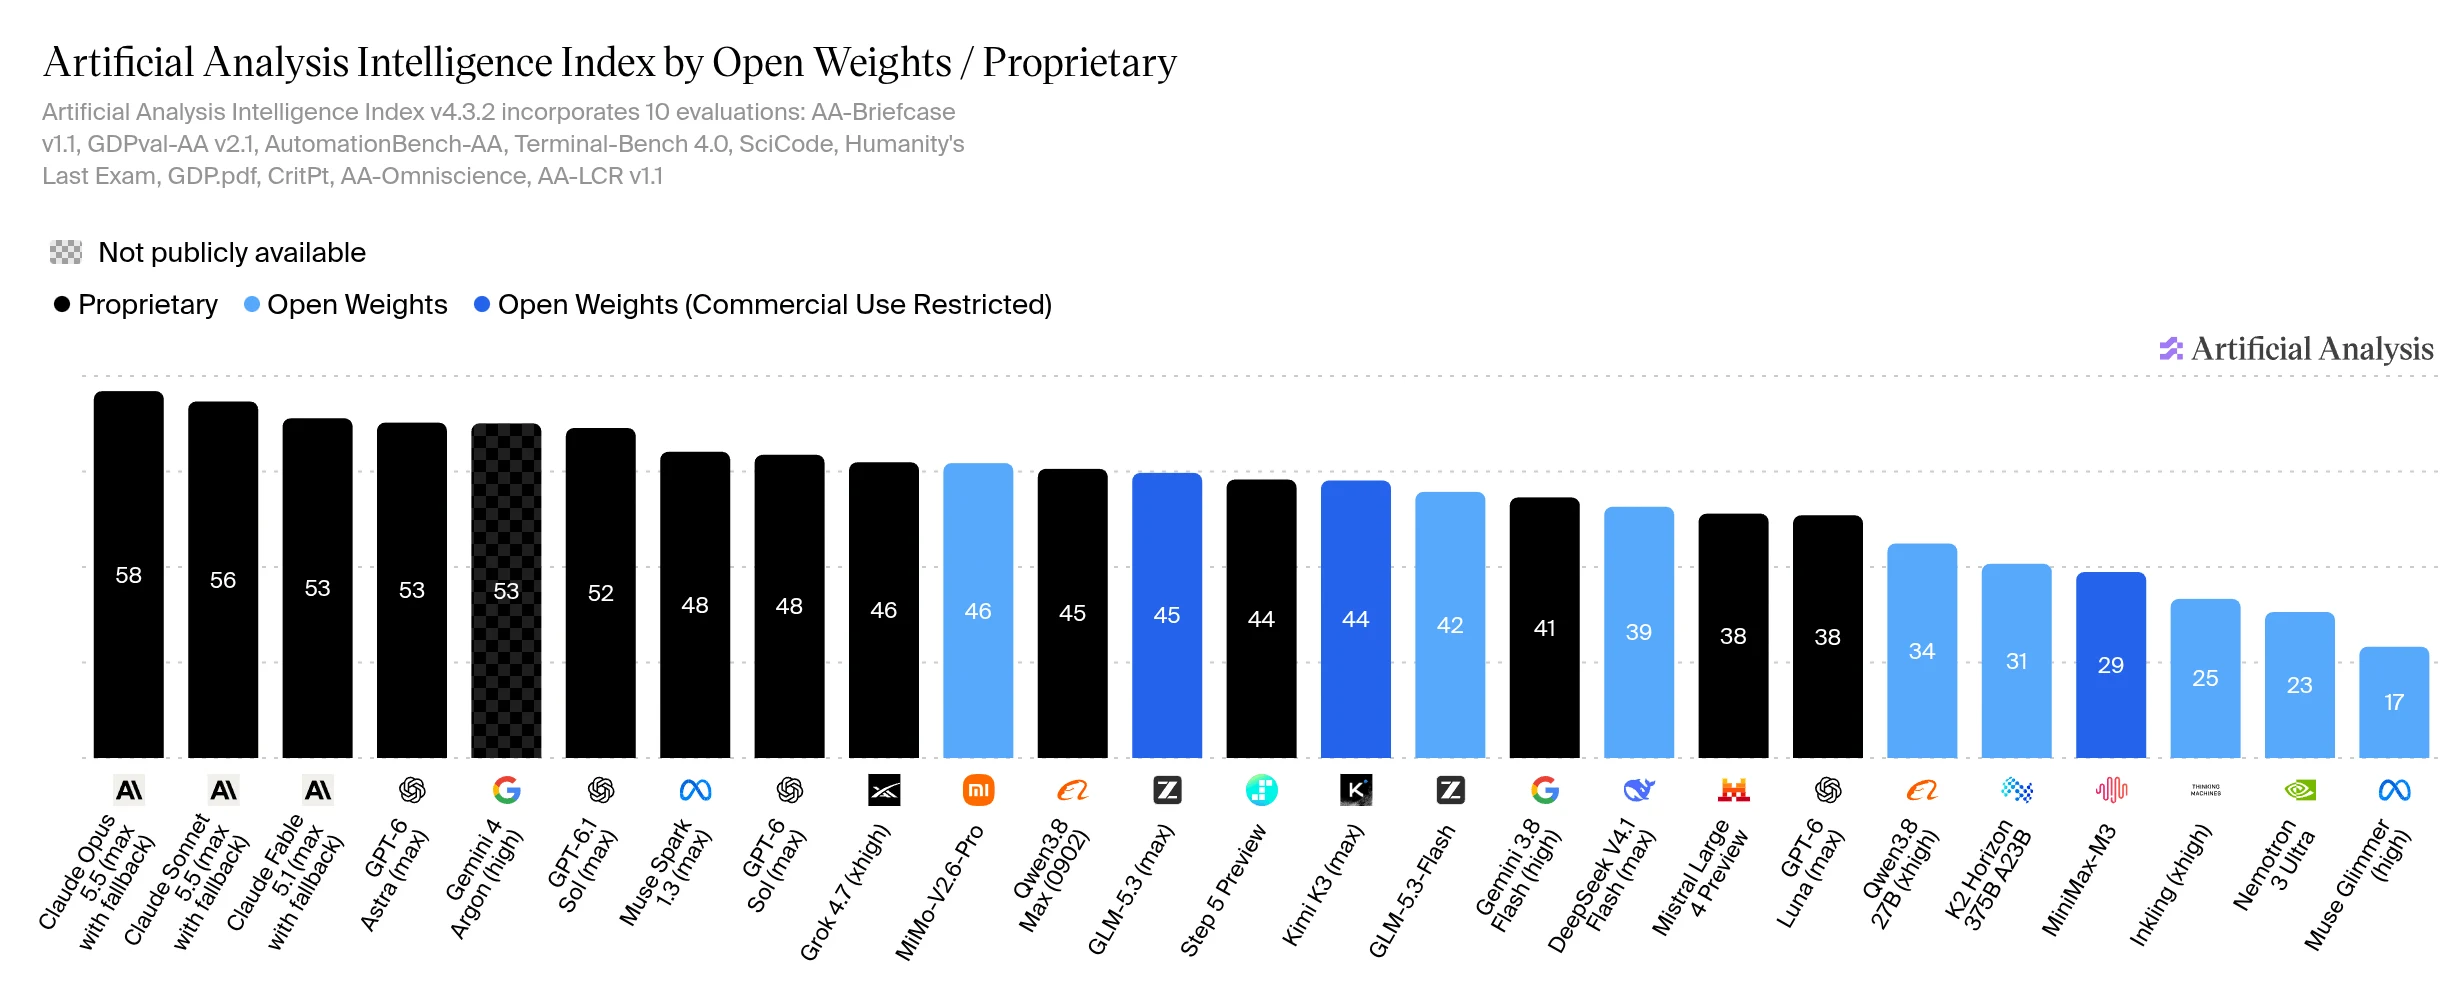
- Im Artificial Analysis Intelligence Index springt das Modell auf 38 Punkte, liegt aber weiterhin mit großem Abstand hinter führenden geschlossenen Modellen wie Claude Opus 5.5 zurück.
- Mistrals Hauptargument ist IT-Sicherheit: Das Modell reproduziert und patcht Software-Schwachstellen, die Konkurrenten wie Claude und GPT-6 wegen ihrer Sicherheitsfilter nicht anfassen.
Mistral hat Mistral Large 4 vorgestellt, sein bislang größtes Modell. Es hat eine Billion Parameter und wurde in den eigenen europäischen Rechenzentren des Unternehmens trainiert. In einem unabhängigen Index legt das Modell einen großen Sprung nach vorn hin, bleibt aber weiterhin deutlich hinter den führenden geschlossenen Modellen zurück. Mistrals Hauptargument ist, dass es Sicherheitsaufgaben bewältigt, die Claude und GPT-6 nicht anfassen wollen.
Mistral hat eine öffentliche Vorschau von Mistral Large 4 (ML4) mit dem Spitznamen "le Chonk" veröffentlicht. Die API ist jetzt über Mistral Studioverfügbar. Die Modellgewichte werden voraussichtlich Ende Oktober folgen.
Laut Mistral ist ML4 ein nativ multimodales Modell mit einer Billion Parametern, von denen 49 Milliarden aktiv sind. Auf Xsagt das Unternehmen, ML4 sei das beste Open-Weight-Modell aus den USA oder Europa über aggregierte Benchmarks hinweg. Es beansprucht State-of-the-Art-Leistung in Cyberabwehr, Fertigung und Finanzen und sagt, dass es sogar geschlossene Frontier-Modelle beim Visual Grounding schlägt.
Ein großer Sprung für Mistral, aber Claude führt weiterhin mit 20 Punkten
Einen unabhängigen Blick liefert der Intelligence Index von Artificial Analysis, der zehn Benchmarks aus verschiedenen Bereichen zusammenfasst. ML4 erzielt dort 38 Punkte. Das ist ein großer Schritt nach vorn für Mistral: Sein Vorgänger, Mistral Large 3, erreichte nur 9 Punkte im Index, und das jüngste Mistral Medium 3.5 erreichte 14. Mit 38 Punkten zieht ML4 auch an GLM-5.2 von Z.ai vorbei, das Mistral auf seiner eigenen Plattform anbietet. Doch der Abstand zur Spitze ist weiterhin groß. Claude Opus 5.5 (Max) führt mit 58 Punkten.Werbung
Bis die Gewichte ausgeliefert werden, testet Mistral das Modell im Red-Teaming mit Sicherheitsfirmen, geprüften Partnern und Regierungsbehörden. Diese Gruppen erhalten dieselbe Version mit reduzierter Moderation und erweiterten Cyber-Fähigkeiten.
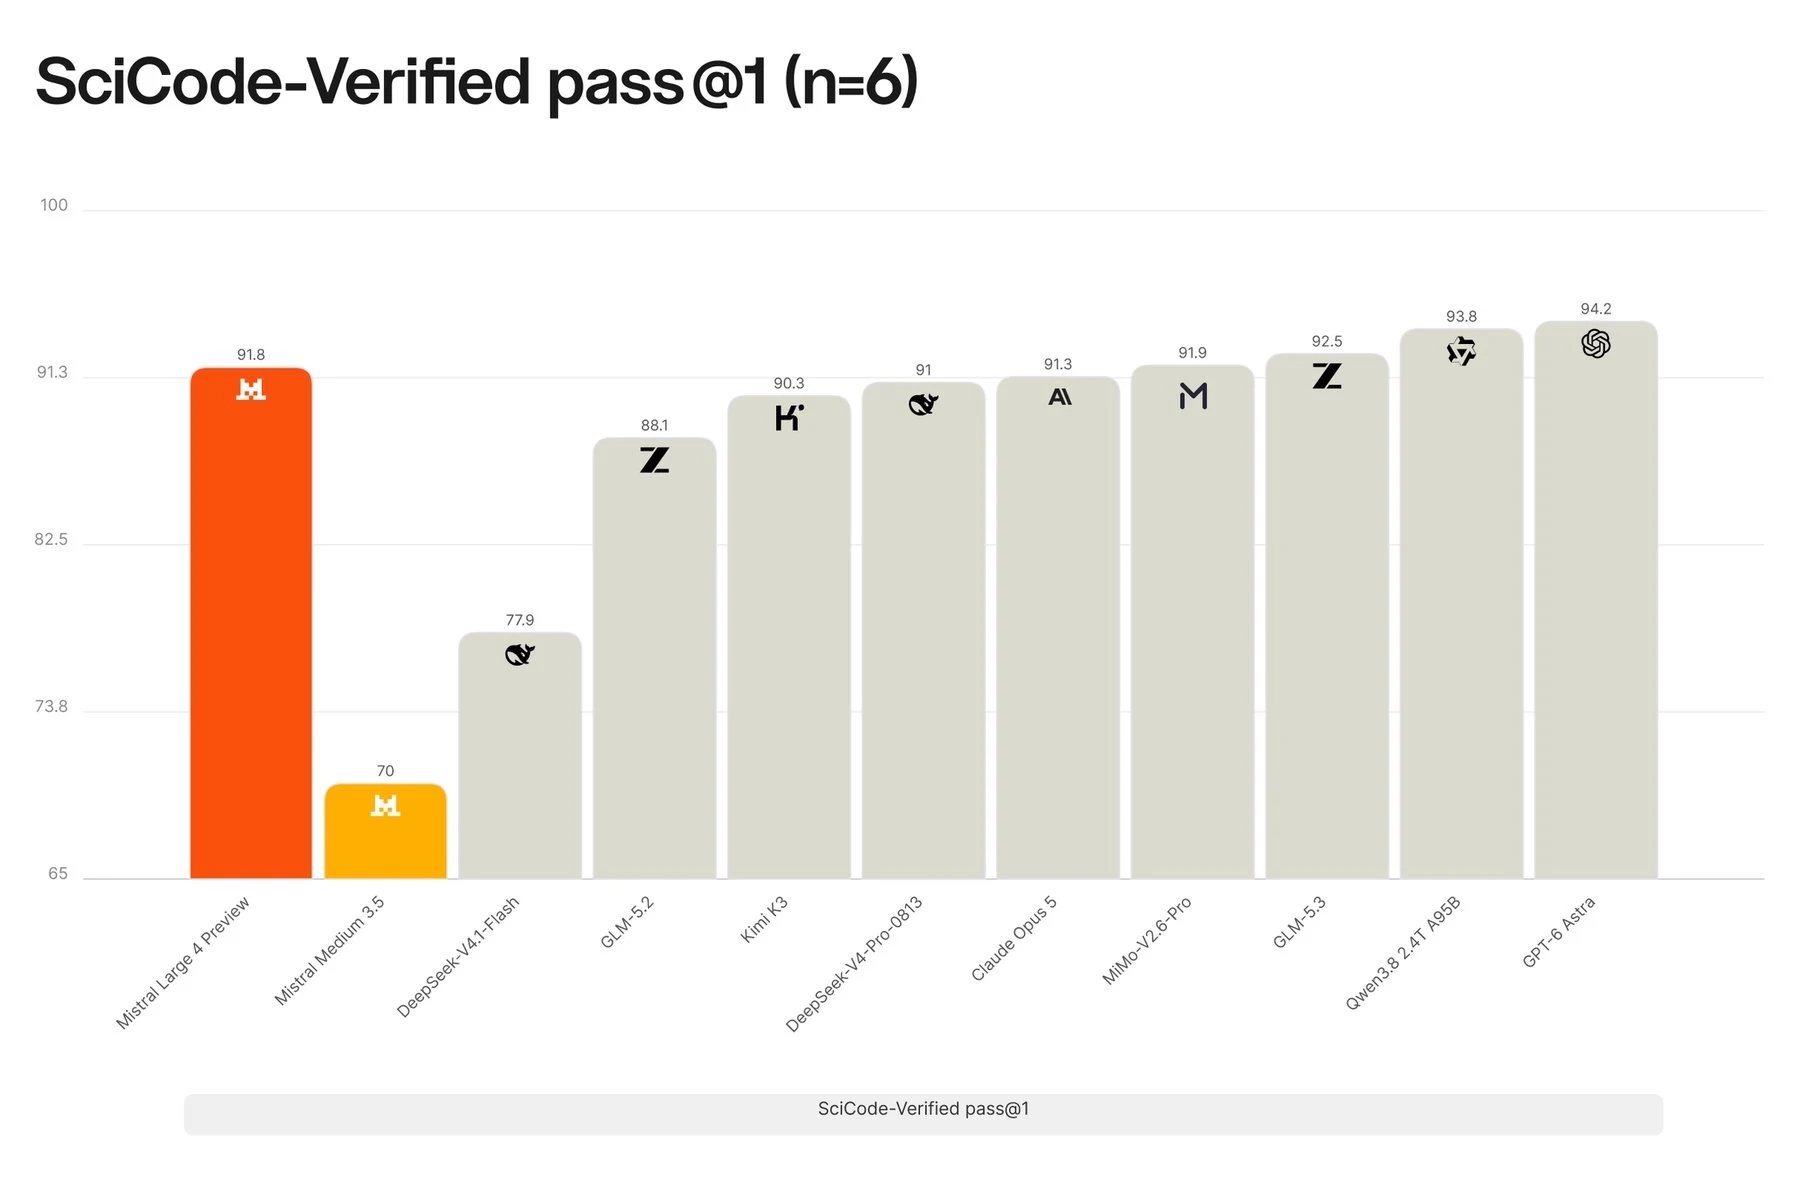
Mistral's Cybersecurity-Vorteil entsteht teilweise dadurch, dass Wettbewerber die Aufgabe ablehnen
Mistral widmet den Großteil seiner Ankündigung der IT-Sicherheit. Im Artificial Analysis Cyber Index gehört ML4 laut dem Unternehmen zu den fünf besten Modellen weltweit. Unter Open-Weight-Modellen, die außerhalb Chinas entwickelt wurden, führt es mit großem Abstand.
Ein Test verlangt von einem Modell, eine echte Schwachstelle in Open-Source-Software nachzubilden und sie dann zu patchen. ML4 erreicht 82 Prozent, die höchste Punktzahl aller Modelle. Der Grund ist jedoch ungewöhnlich. Laut Mistral lehnen Claude Opus 5.5 und GPT-6 Astra die Aufgabe vollständig ab und erreichen daher nahezu null Punkte. Der Test misst also genauso die Richtlinien der Anbieter wie die Fähigkeiten der Modelle.
Mistral macht daraus ein Verkaufsargument. Verteidigungssoftware beginne oft damit, zu beweisen, dass eine Schwachstelle real ist, argumentiert das Unternehmen. Die Sicherheitsfilter geschlossener Modelle blockierten genau diese Art von Arbeit, während Angreifer dieselben Modelle ohnehin jailbreaken. Der Verlust des Zugangs zu einem Anbieter mitten in einem Vorfall könne selbst zu einem Sicherheitsrisiko werden, fügt Mistral hinzu. ML4 ist so konzipiert, dass es auch in privaten Clouds oder on-premise laufen kann.Ad
Gleichzeitig preist Mistral hohe Verweigerungsraten an. Bei bösartigen Cyber-Prompts aus JailbreakBench, StrongREJECT und AgentHarm verweigert ML4 häufiger als jedes andere offene Modell. Wie das Modell legitime Schwachstellenforschung zuverlässig von Angriffsvorbereitungen unterscheidet, erklärt Mistral nicht. Im B3 AI Security Benchmark von Lakera blockiert ML4 laut dem Unternehmen 93.3 Prozent der Angriffe.
ML4 belegt den zweiten Platz beim Programmieren, vor Deepseek und Qwen
Beim Programmieren erreicht ML4 49.8 Prozent im Artificial Analysis Coding Agent Index und liegt damit vor Deepseek V4 Pro und Qwen3.8 Max. Mistral führte auch eine blinde Evaluation mit Surge AI durch, bei der professionelle Annotatoren die Codequalität bewerteten, ohne zu wissen, welches Modell sie erstellt hatte. ML4 landete unter fünf Modellen auf dem zweiten Platz mit 3.74 von 5 Punkten, vor GLM-5.3 und Kimi K3. Claude Opus 5 führte mit 4.22 Punkten.
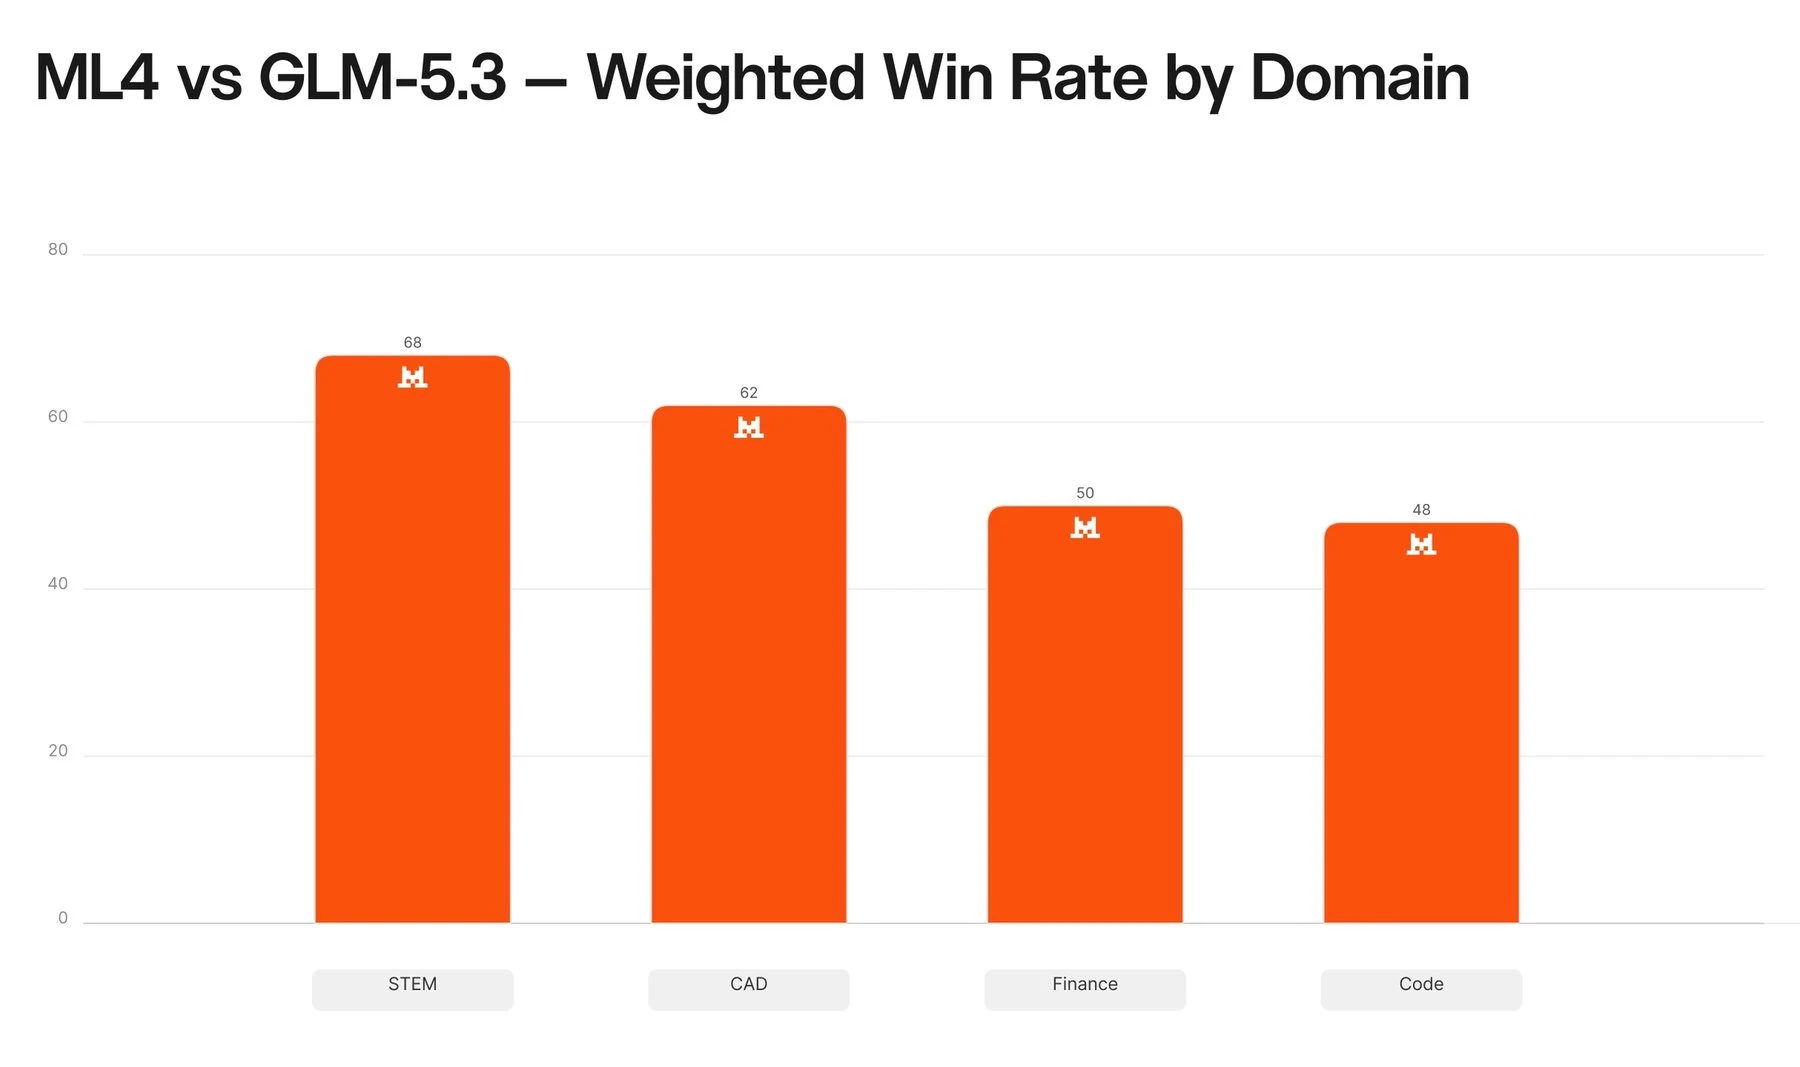
Beim Bildverständnis beansprucht Mistral eine große Verbesserung. ML4 soll Dokumente, Diagramme, Gigapixel-Satellitenbilder und technische Zeichnungen analysieren und dabei selbstständig hineinzoomen und Details prüfen können. Der Vorsprung gegenüber geschlossenen Modellen ist allerdings gering. Beim Dense 200 Benchmark erzielt ML4 42 Prozent, während GPT-6 Astra auf 41 Prozent kommt. Laut einer Evaluation von Vals.ai schlägt ML4 GPT-6 Astra auch bei juristischen und finanziellen Aufgaben.
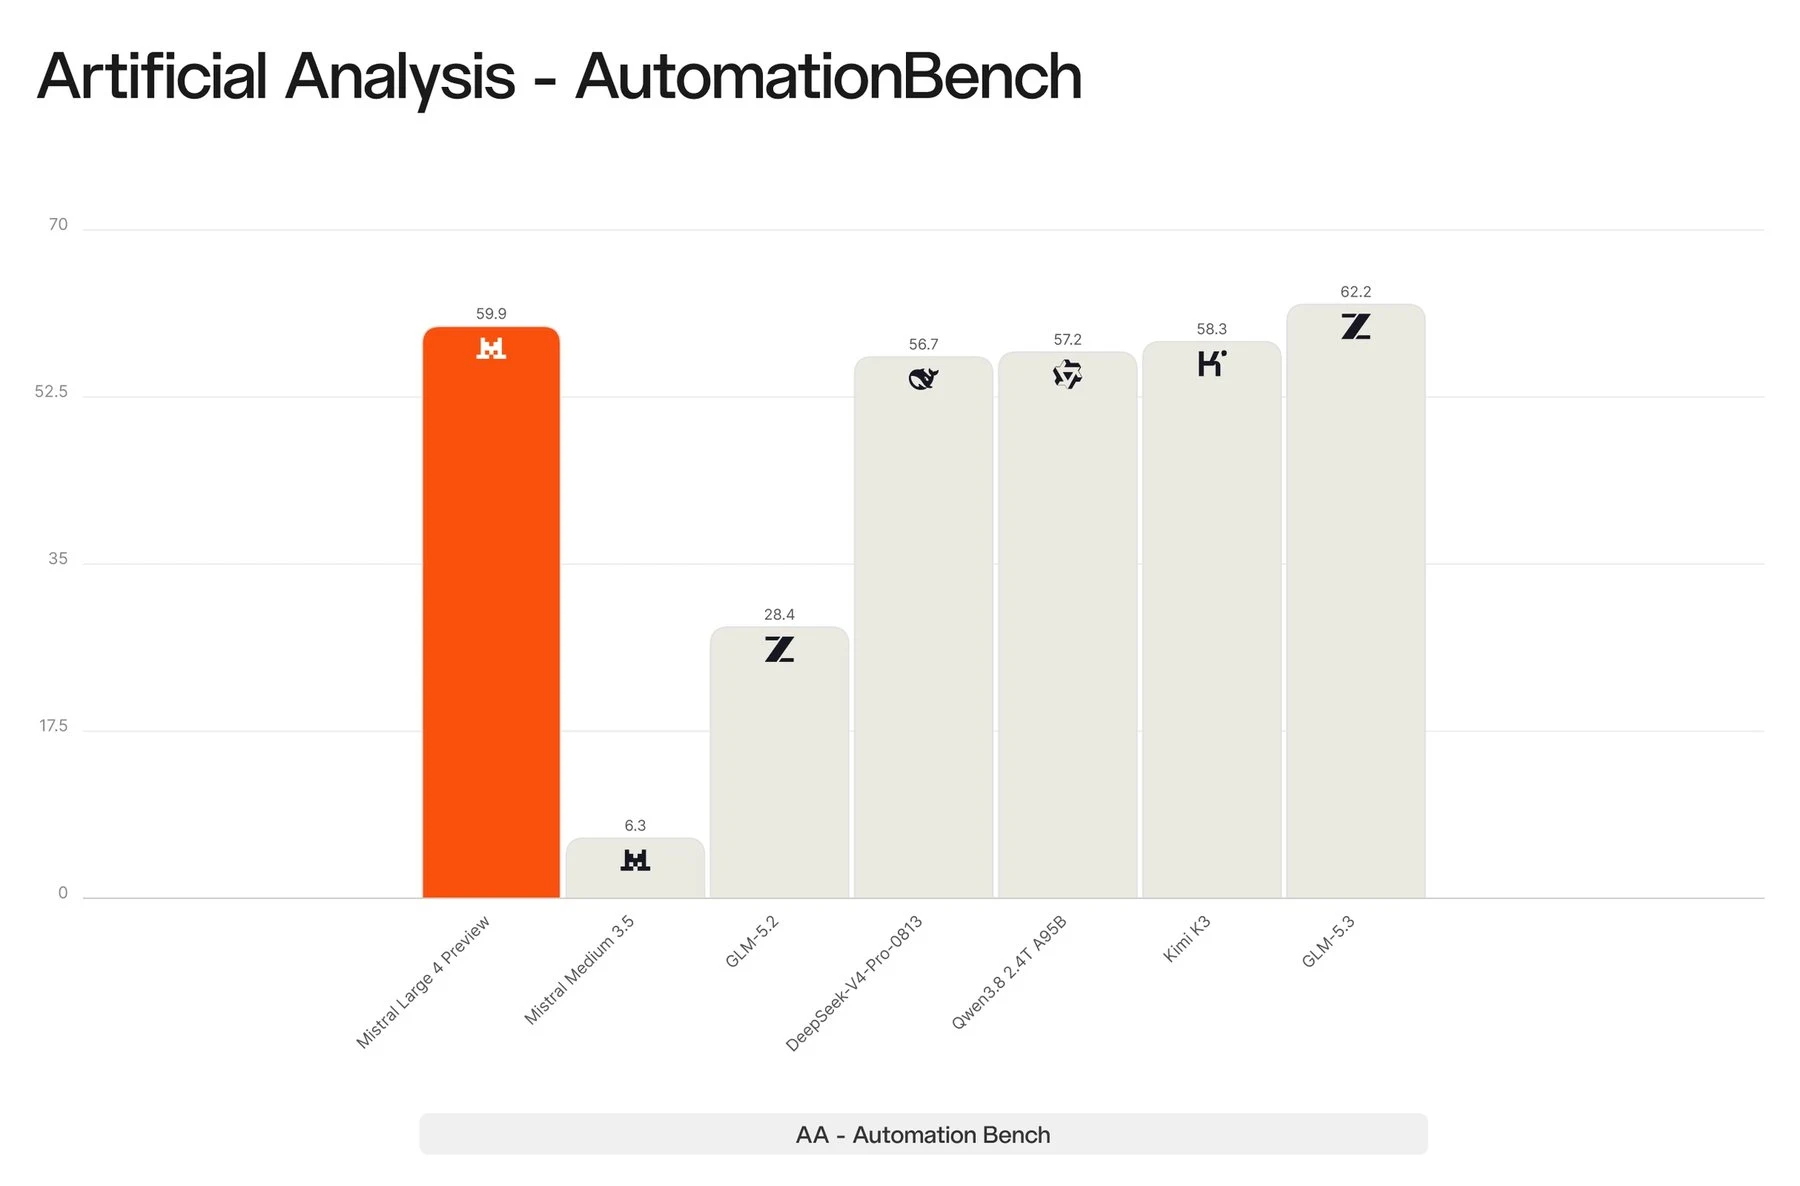
Europäische Souveränität als Geschäftsmodell
Mistral sagt, ML4 sei von Grund auf auf 3,800 Nvidia Grace Blackwell GPUs in den eigenen europäischen Rechenzentren trainiert worden. Die Vorschau läuft auf derselben Infrastruktur. Neben Angeboten in mehreren Regionen plant Mistral eine europäische Variante, die es vollständig selbst betreibt, unabhängig von anderen Dienstleistern und nach europäischem Recht. Die Trainingsdaten umfassen mehr als 160 Sprachen, darunter alle offiziellen EU-Sprachen.
Das Training fand laut Mistral in Zusammenarbeit mit Unternehmen aus Finanzen, Fertigung, Logistik, Pharma, Schifffahrt und dem öffentlichen Sektor statt. Das Unternehmen verwendete dieselbe Trainings- und RL-Umgebung, die es Kunden über Mistral Forge anbietet. Für das Reinforcement-Learning-Post-Training nutzt Mistral etwa 3,000 GPUs. Ein einzelner Trainingslauf erzeugt grob 33 Milliarden Token pro Tag.
Das Training ist noch nicht abgeschlossen
Der RL-Lauf hinter der Vorschau läuft noch und zeigt keine Anzeichen eines Plateaus, sagt Mistral. Das Unternehmen erwartet in den kommenden Wochen erhebliche Verbesserungen. Die Rechenkapazitätserweiterung wird durch die Series-D-Runde über 3 Milliarden Eurofinanziert, die größte Beteiligungsrunde, die je ein europäisches Tech-Unternehmen aufgenommen hat.
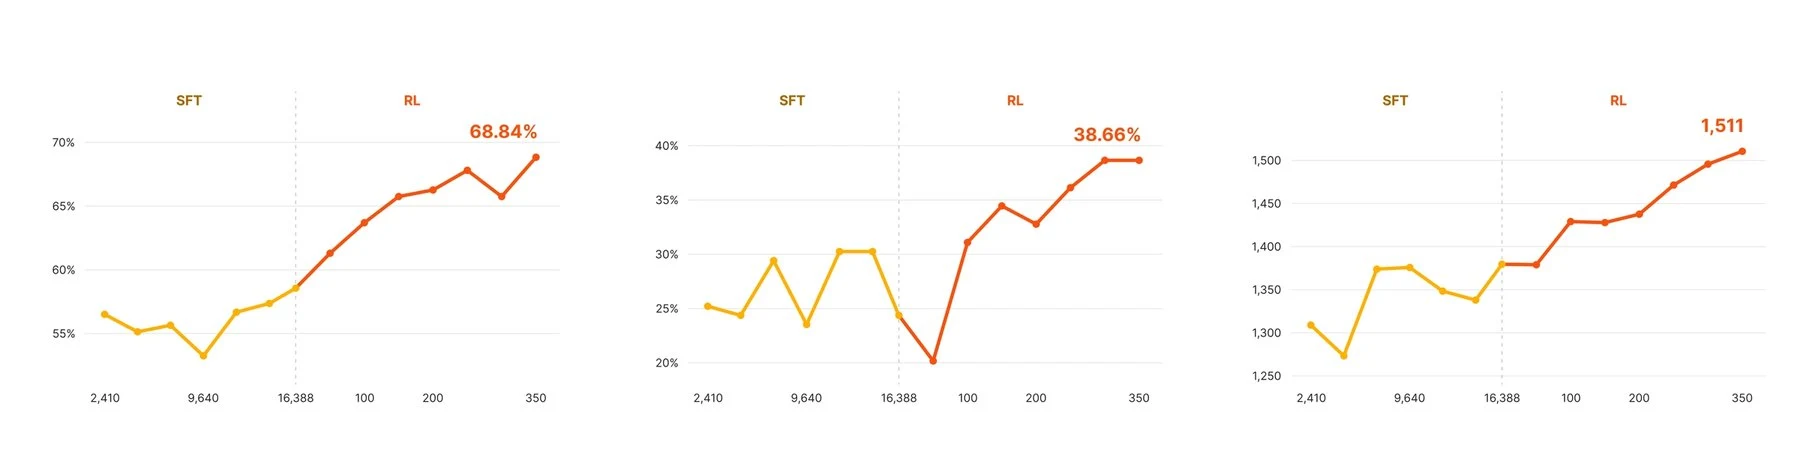
Vieles bleibt vorerst unklar. Laut der Modelldokumentationverwendet ML4 eine feingranulare Mixture-of-Experts-Architektur mit insgesamt 1.05 Billionen Parametern und einem Vision-Encoder mit 1.6 Milliarden Parametern. Das Kontextfenster umfasst eine Million Token. Mistral plant, Architekturdetails, die Lizenz und die Post-Training-Methoden zusammen mit den Gewichten Ende des Monats zu veröffentlichen.
Während der Vorschau berechnet Mistral $0.68 pro Million Eingabe-Token und $2.09 pro Million Ausgabe-Token. Zwischengespeicherte Eingaben kosten $0.07. Die Dokumentation listet auch Preise zum Doppelten dieser Sätze auf: $1.36 für Eingaben, $4.18 für Ausgaben und $0.14 für zwischengespeicherte Eingaben. ML4 soll zudem als Grundlage für eine neue Generation spezialisierter Mistral-Modelle dienen.
Mistral baut seit Monaten seine eigene Infrastruktur in Europa auf. Im März nahm das Unternehmen einen Kredit über $830 Millionen für ein Rechenzentrum bei Parisauf, mit einer Rechenkapazität von 200 Megawatt in Europa, die bis Ende 2027 geplant ist. Das Unternehmen verlagert seinen Fokus offenbar von Verbrauchern hin zu Unternehmenskunden. Im Mai benannte Mistral seinen Chatbot Le Chat in Vibe um und baute ihn zu einem Arbeitstool um.
Im selben Monat warnte Mistral-CEO Arthur Mensch eine französische Parlamentskommission, dass Europa Gefahr läuft, bei der Cybersicherheit von US-Modellen abhängig zu werden. Die Codebasen des französischen Militärs sollten nicht von Anthropics Mythos gescannt werden, sagte Mensch. Mistrals eigene Modelle könnten dieselben Schwachstellen finden, die mit Mythos in Verbindung gebracht worden sind, fügte er hinzu.
KI-News ohne Hype – kuratiert von Menschen
Abonniere THE DECODER für werbefreies Lesen, einen wöchentlichen KI-Newsletter, unseren exklusiven „AI Radar“-Frontier-Report sechs Mal im Jahr, vollen Archivzugang und Zugang zu unserem Kommentarbereich.
Quelle: Mistral