
Kommerzielle KI-Assistenten können individuelle Fragen gut beantworten, aber sie sind an einer anderen Ebene versagt: der Kontinuität. Stellen Sie heute eine staatenlose Assistentin nach Ihrem Garten eine Frage – sie hat keine Ahnung, dass Sie vor drei Wochen über die schnell austrocknenden Beete gesprochen haben, dass Sie nur organischen Dünger verwenden und dass Ihre Petunien unter einem Hitzegewitter leiden. Jede Unterhaltung beginnt von vorne, und die Last der erneuten Erklärung des Kontexts fällt auf den Benutzer.
Das Problem ist nicht die Qualität der Antworten, sondern dass der Assistent keine Erinnerung an dich hat. Dieser Artikel zeigt, wie ein persönlicher Assistent entwickelt werden kann, der den Kontext mit OpenClaw sammelt – einem open-source Agent-System, das auf dem AgentCore-Runtime läuft, einer Funktion von Amazon Bedrock AgentCore. Die AgentCore-Erinnerung, ebenfalls eine Funktion von Amazon Bedrock AgentCore, verwandelt weggegebene Chats in dauerhafte Wissen. Du wirst auch sehen, wie diese Erinnerungen mit strukturiertem Metadaten markiert werden können, um die relevanten Aufzeichnungen für die aktuelle Frage abzurufen.
Unser laufendes Beispiel ist Sprout, ein Gartenhilfsmittel, aber die Architektur ist domainunabhängig. Wenn man die Persönlichkeit und das Skills-Manifest austauscht, dient dieselbe Pipeline einem Support-Bot, einem Fitnesscoach oder einem internen Helpdesk. Das gesamte System existiert in einem einzigen AWS CloudFormation-Template, wird mit einer einzigen Befehl deployed und läuft auf einem Kostenmodell, das für leichtes persönliches Verwendung nur wenige Dollar pro Monat kostet. Unterwegs teilen wir Designrichtlinien mit, die Sie auf die Assistenten anwenden können, die Sie mit dieser Stack-Architektur erstellen.
Lösungsüberblick
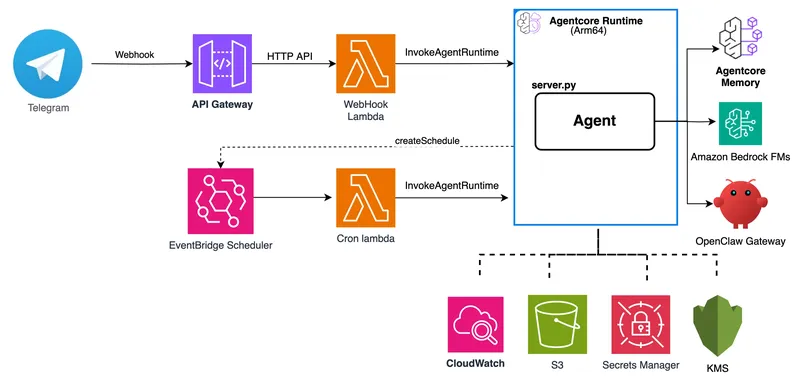
AgentCore ist eine Plattform zur Erstellung, Verbindung und Optimierung von Agenten in großem Maßstab, mit jedem Framework oder Modell. Das folgende Diagramm zeigt den End-to-End-Anforderungsfluss, von einem eingehenden Telegram-Webohook über den AgentCore-Runtime und die damit verbundenen AWS-Dienste.
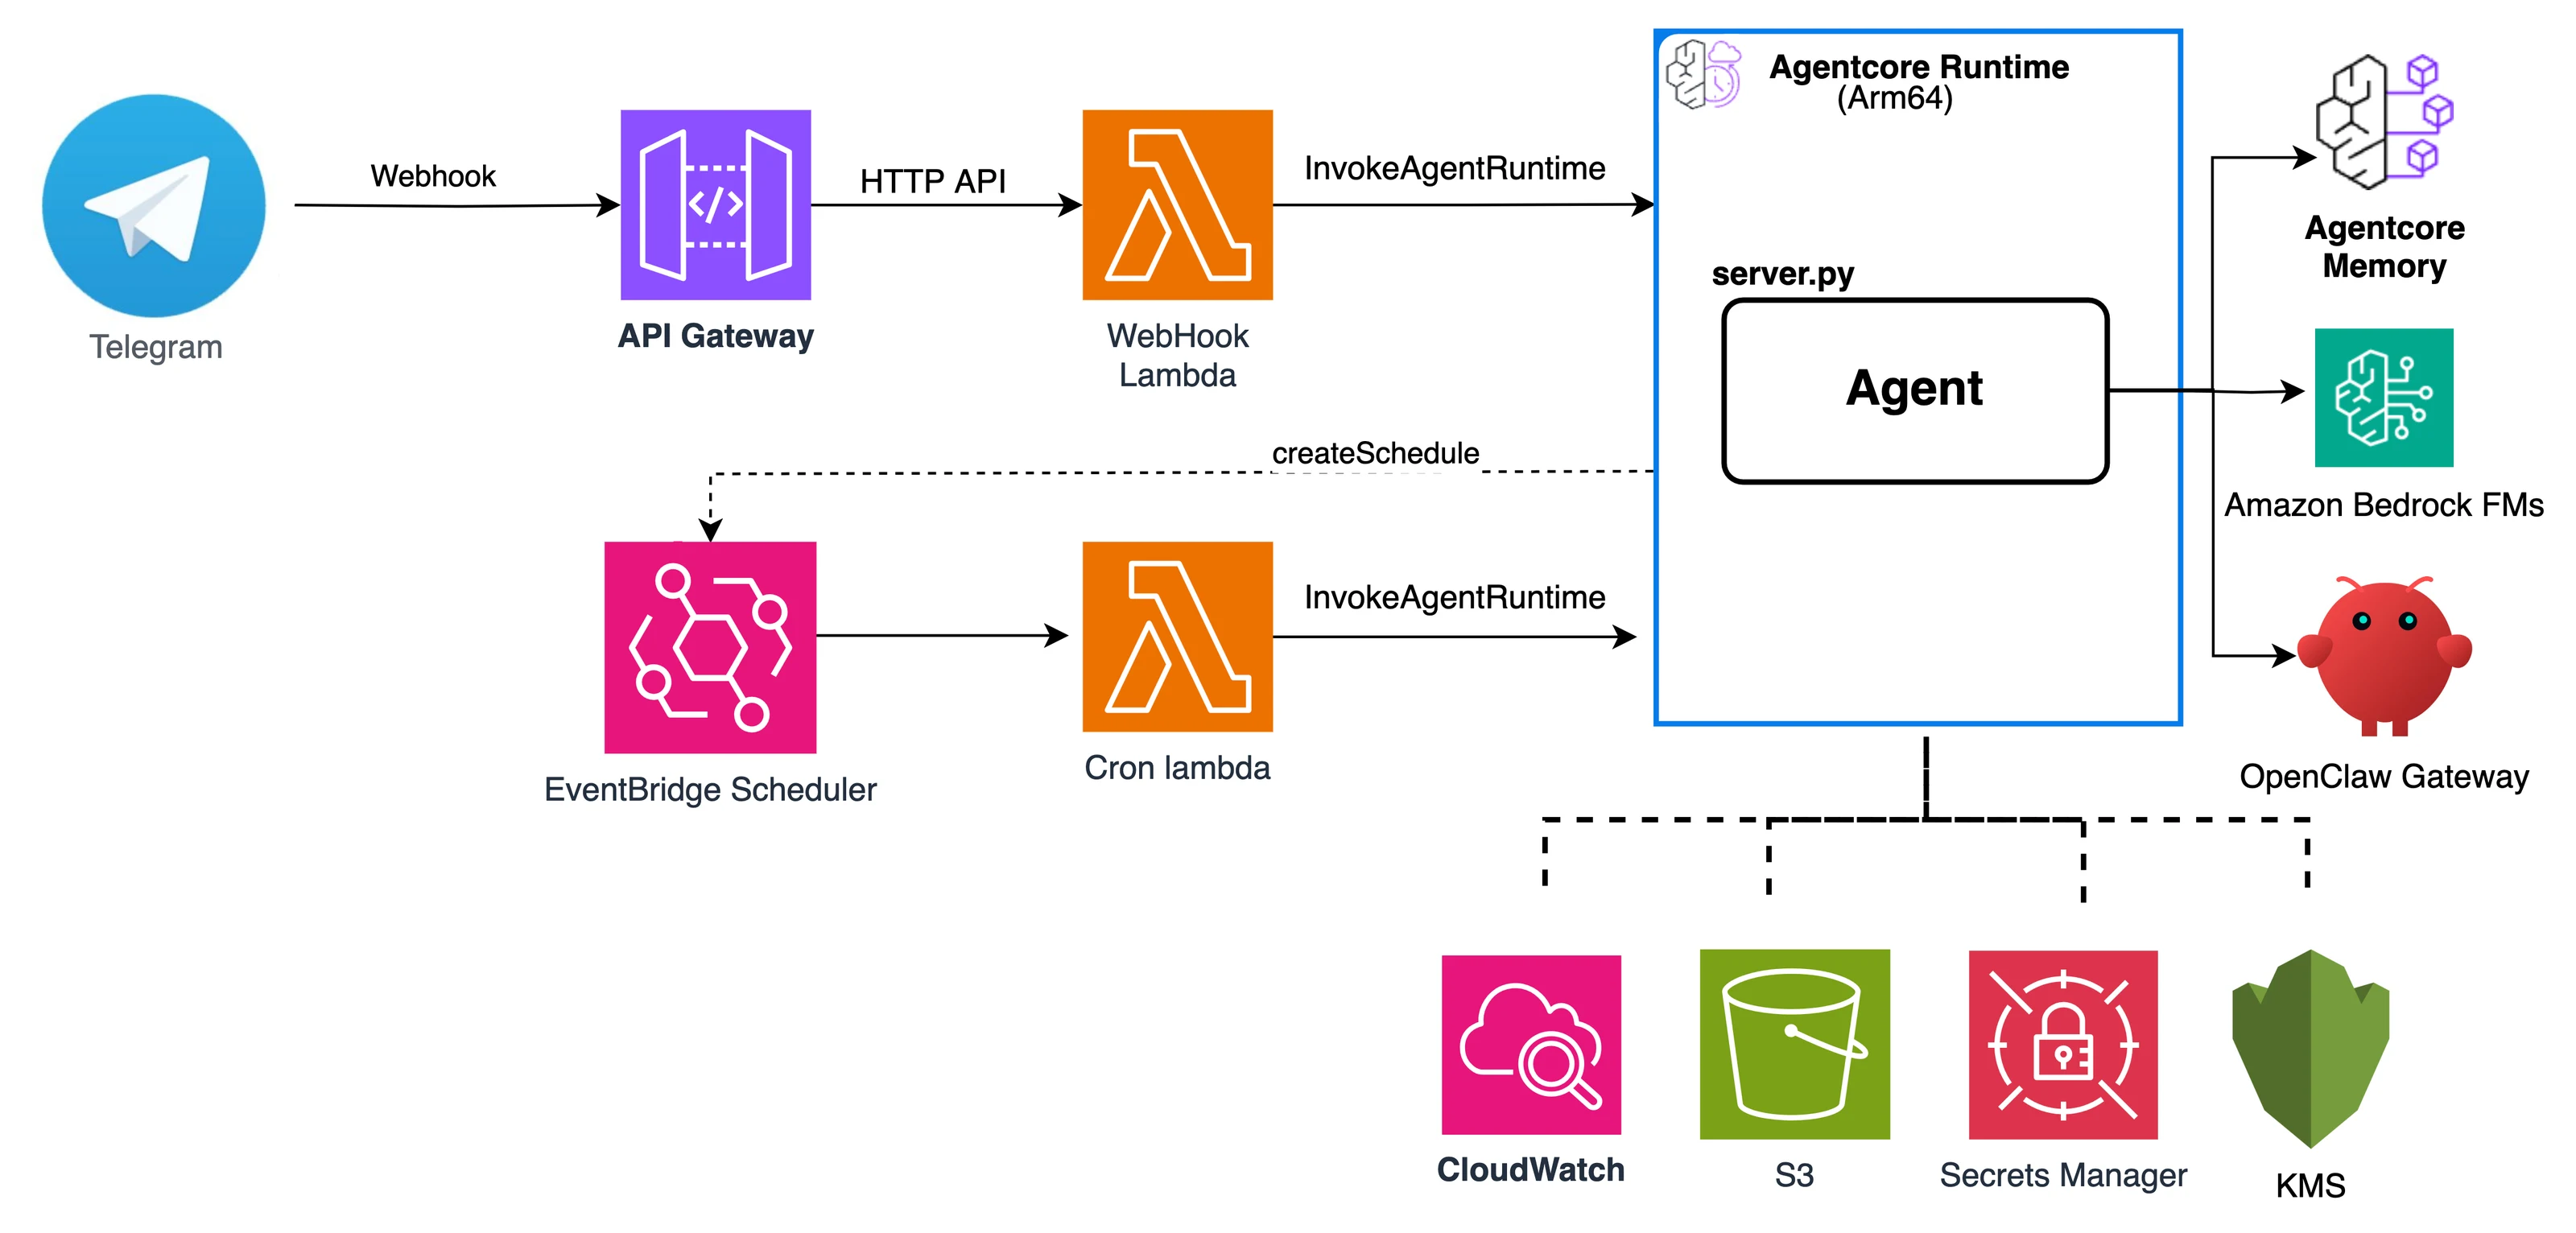
Abbildung 1: Telegram-Webhooks und Amazon EventBridge-Skalen verwenden beide denselben AgentCore-Runtime-Agent, der den OpenClaw-Gateway, den AgentCore-Memory und Amazon Bedrock koordiniert
Zwei Eingangspunkte konvergieren in einen Agenten. Telegram-Mitteilungen erreichen den Agenten durch das Amazon API Gateway und eine Webhook-Funktion von AWS Lambda, während geplante Aufgaben wie die Nachrichten über das Wasser gießen am Morgen durch den Amazon EventBridge Scheduler und eine cronjob-Lambda-Funktion geliefert werden. Beide verwenden die InvokeAgentRuntime API im AgentCore-Runtime, wo ein dünner server.py-Prozess den OpenClaw-Gateway, das AgentCore-Memory und die Amazon Bedrock Converse API koordiniert. Das Amazon Simple Storage Service (Amazon S3) stellt den Arbeitsplatzspeicher bereit, der AWS Key Management Service (AWS KMS) kümmert sich um die Verschlüsselung, der AWS Secrets Manager speichert das Bot-Token und Amazon CloudWatch sammelt Logs und Metriken.
Voraussetzungen
Um die eigene Version mit dem „Launch Stack“-Button oder den Skripten/deploy.sh ( wie in der „Grow your own“-Sektion beschrieben ), benötigen Sie:
- Amazon Bedrock AgentCore-Zugriff, einschließlich AgentCore-Runtime und AgentCore-Memory.
- Modellzugriff gewährt für die Modelle, die Sie routen wollen: Claude Haiku 4.5 für Text und Claude Sonnet 4.5 für Vision (oder die Äquivalente im Ihren Account).
- Docker mit Unterstützung für die
linux/arm64-Build-Option sowie der konfigurierten AWS Command Line Interface (AWS CLI). Dies ist nur erforderlich, wenn Sie planen, Ihre eigene Image zu bauen und zu pushen. - Ein Telegram-Bot-Token (von BotFather) als Eingangstor für den Assistenten.
- Grundlegende Kenntnisse in Konzepten der Agent-Orchestrierung und CloudFormation.
Die Architektur: Ein serverlose Agent auf der AgentCore-Runtime
Jeder Komponente existiert in einem einzigen CloudFormation-Template, und es ist keine Build-Tooling erforderlich, um sie zu starten. Die folgenden Abschnitte führen durch die Entscheidungen bezüglich der Lastaufnahme.
AgentCore-Runzeit: Zahlen nur für aktive Berechnungen
Der Agent lebt in einem Container auf der AgentCore-Runtime, die eine nach Verbrauch basierte Preisgestaltung verwendet. Ihnen wird nur für den Rechenaufwand berechnet, den der Agent aktiv verbraucht, nicht für die Gesamtlaufzeit, und Sie zahlen nicht für die Zeit, in der man auf I/O-Operationen wie Modellantworten wartet. Für einen persönlichen Assistenten, der nur kurzzeitig genutzt wird, ist das der Unterschied zwischen einer ungefähr $1–2 pro Monat als Basis und einer ungefähr $35 pro Monat für eine immer aktiv laufende Amazon Elastic Compute Cloud (Amazon EC2)-Instanz. Diese Zahlen sind Schätzungen für leichtes persönliches Verwendung bis Juli 2026. Weitere Informationen zu den aktuellen Preisen finden Sie unter AgentCore-Preiskalkulation.
Der Laufzeitprozess führt ein minimales Container-Contract ein: Die Konsole muss auf Port 8080 laufen, und GET /ping sollte für die Gesundheitsüberprüfung verfügbar sein, während POST /invocations als Eingangspunkt des Agents dient. Unser Container ist linux/arm64, erstellt aus der offiziellen OpenClaw-Image und einer Python-Schicht in mehreren Schritten.
OpenClaw als Agent-Substrat
OpenClaw bietet den Agent-Loop, Werkzeugnutzung und ein Fähigkeitssystem. Es läuft einen Wrapper.server.py) das es anpasst AgentCore HTTP-Protokollvertrag:
- Beim Start des Containers startet
server.pyopenclaw gateway runals Subprozess und führt Health-Checks durch. GET /pinggibt schnell eine gesunde Antwort zurück, sodass der AgentCore-Readiness-Test besteht.POST /invocationserledigt die eigentliche Arbeit: Er verarbeitet den Payload, holt sich die Memorie, sammelt den Kontext zusammen, übermittelt die Anfrage an das Gateway und speichert das Ergebnis. Eine Anmerkung: AgentCore kann einen gefrorenen Container auftauen, dessen Unterprozess beendet ist. Daher setzt der Anrufpfad nicht voraus, dass das Gateway aktiv ist; es ruft einenensure_openclaw_ready()-Helfer auf, der die Gesundheit erneut überprüft (und das Gateway bei Bedarf neu startet), bevor die Anfrage weitergeleitet wird.
Dieses Wrapper-Muster kann auf andere Einsatzszenarien erweitert werden. Jedes Agent-Framework, das als lokaler Prozess läuft, kann auf dieselbe Weise an den AgentCore-Runtime angepasst werden, ohne das Framework selbst zu verändern.
Zwei Modelle, nach Aufgaben eingeteilt
Text- und Bildverständnis haben unterschiedliche Kosten und Qualitätskompromisse, daher leitet der Assistent sie an verschiedene Claude-Modelle auf Bedrock weiter:
- Claude Haiku 4.5 für Text: Schnell und kostengünstig für die hohen Datenmengen bei Gesprächen, die im täglichen Gebrauch vorkommen.
- Claude Sonnet 4.5 für Vision: Stärkere Multimodale-Rationalisierung für die seltener vorkommende, aber schwierigere Aufgabe, nämlich das Diagnostizieren einer Pflanze aus einem Foto.
Der Text fließt durch den OpenClaw-Gateway, der Fähigkeiten und Sitzungszustände bereitstellt. Das Bild ruft das große Sprachmodell (LLM) von Bedrock direkt aus server.py ab und übermittelt die Bildbytes als multimodale Inhaltsblöcke. Wir leiten die Bilder bewusst durch den Gateway: Die in der Container-OpenClaw-Installation wurden die image_url-Inhaltsteile vor dem Eintreffen bei Bedrock entfernt, sodass die Converse-API direkt aus server.py aufgerufen wird, um sicherzustellen, dass das Modell die echten Pixel sehen kann. Beide Wege teilen denselben Systemprompt (Persona plus Memory), sodass die Erfahrung konsistent bleibt.
Die Modell-IDn sind Umgebungsvariablen (MODEL_ID, VISION_MODEL_ID), sodass Sie die Modelle bei jeder Bereitstellung austauschen können, ohne das Image neu erstellen zu müssen.
Fähigkeiten als wiederverwendbare Funktionsunit
Die Fähigkeiten werden in einem community-skills.json Manifest als Fähigkeiten deklariert. Ein Skript zum Deployment transformiert sie in den Container und registriert sie in der OpenClaw-Konfiguration, bevor das Bild erstellt wird. Sprout enthält zur Zeit der Veröffentlichung dieses Artikels Fähigkeiten wie Wetter, Erinnerungen und Pflanzennotizen. Der Manifest wechselt, und derselbe Pipeline bedient einen anderen Bereich. Das macht das Ganze zu einem wiederverwendbaren Muster und nicht nur zu einem einzigen Bot.
Telegram als serverlose Eingangstür
Telegram ist ein praktischer Kanal für einen persönlichen Assistenten, da er auf Webhooks basiert und alles serverlos abläuft. Es erfordert keine Client-Entwicklung, funktioniert auf jedem Gerät, das der Benutzer besitzt, und unterstützt Text, Bilder sowie ausgefeilte Formatierung über eine einfache Bot-API. BotFather erstellt einen Bot-Token, der im Secrets Manager gespeichert wird. Die Ausführung registriert einen Webhook, der Telegram an den API-Gateway-Endpunkt verweist. Wenn der Benutzer eine Nachricht sendet, übermittelt Telegram diese an die Lambda-Funktion des Webhooks, um den Payload zu validieren und InvokeAgentRuntime aufzurufen. Die Antwort gelangt wieder durch die Telegram-Bot-API zurück.
Eine Formatierungslektion, die beachtet werden muss: Das alte Markdown-Modell von Telegram ist hart gegenüber unverpackten Zeichen. Ein einziger versteckter Unterstrich in einer Modelantwort kann dazu führen, dass der gesamte Nachrichtenversand fehlschlägt. Die Darstellung von Antworten als HTML ist zuverlässig, daher wandelt das Assistenten das Modellergebnis vor dem Versand in HTML um, das für Telegram geeignet ist.
Speicher: In diskrete Chats zu dauerhaftes Wissen verwandeln
Die bisher beschriebene Architektur ist ein leistungsfähiger, kostengünstiger, serverloser Agent, aber allein kann er Sie zwischen Gesprächen vergessen. Die Speicherung ist es, die das ändert. Stellen Sie sich vor, dass Sie vor Wochen erwähnt haben, dass Sie organische Dünger verwenden, und heute der Assistent eine Behandlung empfiehlt und zusätzlich anmerkt, dass er die organische Option gewählt hat, weil Sie keine synthetischen Düngemittel verwenden. Ein statelesses Modell kann das nicht tun.
Das mentale Modell: Kurzfristige Ereignisse, langfristige Auswirkungen
Die AgentCore-Memorie hat zwei Schichten. Kurzzeitgedächtnis Speichert jede Gesprächsrunde als Ereignis ab CreateEvent, abgelegt nach actorId (das Telegram-Chat-ID) und sessionId. Dies ist die Rohtranskription. Die Langzeitgedächtnis wird asynchron erzeugt durch verwaltete Extraktionstrategien in nachhaltige, strukturierte Aufzeichnungen. Wir haben drei Strategien konfiguriert:
USER_PREFERENCE: die ausdrücklichen Wünsche des Gärtners (“Ich verwende nur biologischen Dünger”).SEMANTIC: abgeleitete Fakten (“wächst mexikanische Petunien in einem Corten-Stahlbeet”).SUMMARIZATION: Episodische Sitzungsummenberichte (“Diskussion über das Gelbwerden der unteren Blätter während einer Hitzewelle”).
Namensraum: Ein Garten pro Gärtner
Die Sprout-Dateien werden in die Benutzer-Namespaces gespeichert, sodass sich keine zwei Chats jeweils vermischen:
sprout/{chat_id}/long_term: Vorlieben und semantische Fakten.sprout/{chat_id}/episodic/{session_id}: Sitzungszusammenfassungen.
Die Chat-ID ist das einzige variabele Segment, was die Isolierung einfach zu verstehen und zu testen macht: Jeder einzigartige Gärtner entspricht genau einem Namensraum, und keine zwei Gärtner kollidieren miteinander.
Der Abtrag, die Zusammenfassung und die Injektion-Prozess
Bei jeder Runde holt der Agent die relevanten langfristigen Aufzeichnungen ab, ordnet sie ein und fügt sie dem System-Prompt hinzu. Hier ist, was bei jedem einzelnen Nachricht innerhalb von server.py geschieht:
- Abrufen. Rufen Sie
RetrieveMemoryRecordsan aufsprout/{chat_id}/long_term, verwenden Sie das Nachrichtensignal des Benutzers als Suchanfrage, limitieren Sie die Anzahl der Ergebnisse auf 50 und verlangen Sie eine Laufzeit von unter 3 Sekunden. Falls die Abrufzeiten auslaufen oder Fehler auftreten, wird das System sanft abgebremst und antwortet ohne Speicher, anstatt zu versagen.
try:
    records = memory_client.retrieve_memory_records(
        memoryId=MEMORY_ID,
        namespace=f'sprout/{chat_id}/long_term',
        searchCriteria={
            'searchQuery': user_message,
            'topK': 50,
            'metadataFilters': []
        },
    )  # 3s timeout
except Exception:
    records = []  # fall back to answering without memory
Snippet 1: Die Suche nach langfristigen Aufzeichnungen für die aktuelle Runde (repräsentativ). Die vollständige Quelle finden Sie im Repo.
Die Assembler-Funktion fügt zusätzliche benutzerdefinierte Logik hinzu. Wir wollen, dass die expliziten Präferenzen vor den abgeleiteten Fakten an erster Stelle stehen, die Reihenfolge innerhalb jeder Klasse ist stabil, und das Ergebnis wird vor der Injektion begrenzt:
def assemble(records, cap=50):
    explicit = [r for r in records if r.type == 'USER_PREFERENCE']
    inferred = [r for r in records if r.type != 'USER_PREFERENCE']
    # explicit beats inferred; stable order within each class
    ordered = explicit + inferred
    return ordered[:cap]
Snippet 2: Die Assemblungsstufe ordnet expliziten Präferenzen vor abgeleiteten Fakten an.
Metadaten: Untergruppenung von Erinnerungen innerhalb eines Namensraums
Namensräume geben an, woran die Erinnerung erinnert, aber Metadaten geben an, worum es geht. Innerhalb von sprout/{chat_id}/long_term würde eine semantische Suche nach „meine Petunien welken“ alles zurückgeben, was in Bezug darauf bedeutet. Für einen Gärtner bedeutet das, dass eine Düngungsvorlieben seit März sowie Anmerkungen zur Scheinbaumpflege neben den wirklich wichtigen Erinnerungen geordnet werden. Und strukturierte Metadaten helfen uns dabei, den Umfang der Erinnerungen vor dem Eintreffen im Prompt einzugrenzen.
Eine Regel bestimmt hier jede Entscheidung. Eine Metadaten-Schlüssel ist nur auf Serverseite filterbar, wenn man ihn als indexierten Schlüssel deklariert. Weitere Informationen finden Sie in Structured memory filtering with metadata in Amazon Bedrock AgentCore Memory. In diesem Fall verwendet Sprout drei indexierte Schlüssel:
IndexedKeys:  # on the AWS::BedrockAgentCore::Memory resource
  - Key: type  # seperate the kinds of records
    Type: STRING
  - Key: section  # which bed or area it describes
    Type: STRING
  - Key: plants  # what is growing there
    Type: STRINGLIST
Jeder Eintrag bezeichnet einen Schlüssel, der mit einem indexierten Schlüssel übereinstimmen muss, damit er gefiltert werden kann, und setzt extractionType entweder auf STRICTLY_CONSISTENT, der über das Event übertragen wird, oder auf LLM_INFERRED, der aus dem Gespräch extrahiert wird. Für gefilterte Schlüssel kann die Extraktionseinstellung die Werte auf eine feste Liste beschränken. Sprout tut genau das, sodass beide Schreibwege dasselbe Wortschatz erzeugen und die Filterung dieselbe Bedeutung hat, unabhängig davon, welche Seite das Record erstellt hat.
Das Umlaufende beibehalten und den Kreis schließen
Nachdem das Modell reagiert hat, ruft server.py CreateEvent mit der Anweisung „User-Turn“ und „Assistent-Turn“ auf. Dieser neue Ereignis liefert die Extraktionstrategien, die den langfristigen Speicher für die nächste Zeit bereichern.
memory.create_event(
    memoryId=MEMORY_ID,
    actorId=chat_id,
    sessionId=session_id,
    payload=[
        {'role': 'user', 'content': user_message},
        {'role': 'assistant', 'content': reply},
    ],
)  # feeds USER_PREFERENCE / SEMANTIC / SUMMARIZATION extraction; errors are logged, never fatal
Snippet 3: Das Richtung zu persistieren, damit die Extraktionstrategien asynchron die langfristige Erinnerung bereichern können.
Die Extraktion ist asynchrone, sodass ein in dieser Sitzung erwähntes Faktum typischerweise in einer späteren Sitzung wieder zugänglich wird. Gestalten Sie für diese Verzögerung: Kurzfristige Sitzungsereignisse umfassen die aktuelle Konversation, und langfristige Aufzeichnungen umfassen alles davor.
Zusammengefasst: Ein personalisierter Bewässerungsplan
Hier funktioniert der gesamte Prozess von Anfang bis Ende. Durch einige Gespräche katalogisiert man den gesamten Garten – ein Pflanze nach der anderen – in einfacher Sprache. Jeder Hinweis wird zu einem Ereignis. Die Extraktionstrategien extrahieren Informationen über die Pflanze, ihre Lage und ihre Sonneneinstrahlung in sprout/{chat_id}/long_term. Heute Morgen stellt der Benutzer eine Frage: „Erinnerst du dich an die anderen Pflanzen im Garten?“ Die Abrufaktion holt die Daten zurück, ordnet sie und gibt sie in das System ein. Der Assistent antwortet mit der Lage des Benutzers, der Sonneneinstrahlung, der Bodenkonstruktion, dem Bodenverhalten und dem Pflanzenbestand – Dinge, die nicht im eigenen Nachrichtensetzer erschienen sind.
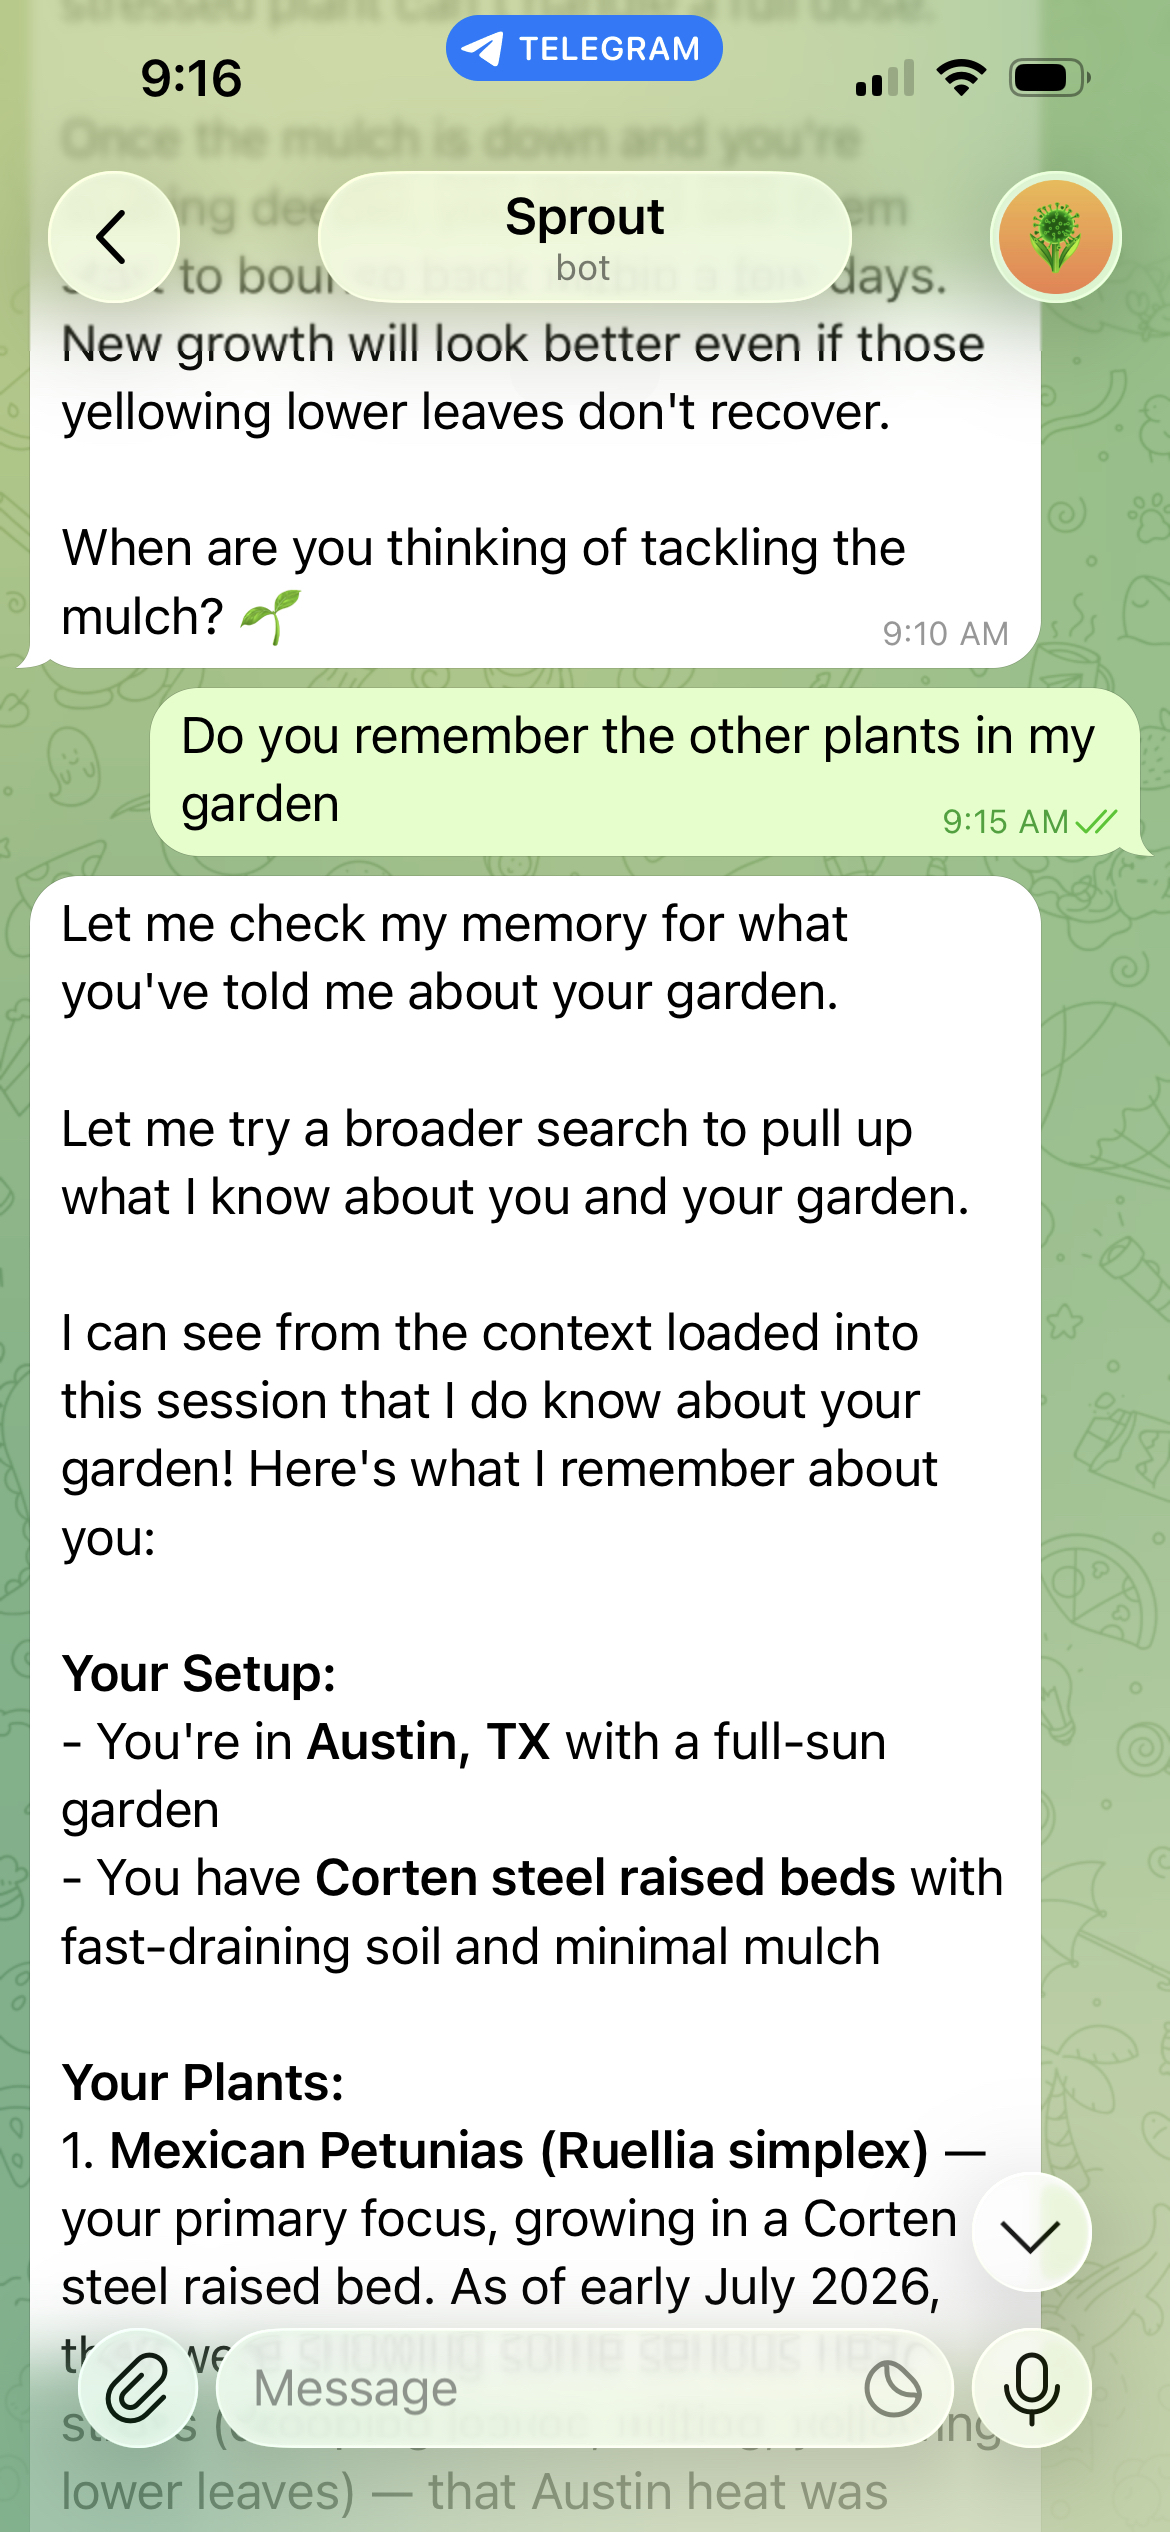
Abbildung 2: Sprout beantwortet eine Frage über den Garten, indem er die gespeicherte Pflanzenliste und die Wachstumsbedingungen anruft.
Durch die Fähigkeit des Planers auf dem Weg von Amazon EventBridge → Cron kann Sprout auch diesen Plan in proaktive Erinnerungen umwandeln („Ignorieren der Kräuter, der Boden ist noch feucht vom Vortag“) und diese an die Wetterfähigkeit anpassen, wenn Regen oder eine Hitzewelle kommen.
Memoria und Sehen kombinieren sich auch miteinander. Wenn der Benutzer eine Foto von einer welkenden Pflanze sendet, wird das Bild an Claude Sonnet 4,5 weitergeleitet, während der Systemvorschlag immer noch alles enthält, was die Memoirenklärung kennt. Der Assistent passt das Foto zu den mexikanischen Petunien, die bereits im gespeicherten Inventar des Benutzers sind, und diagnostiziert den Welke Stress im Kontext, anstatt eine anonyme Pflanzenfoto kalt zu analysieren.
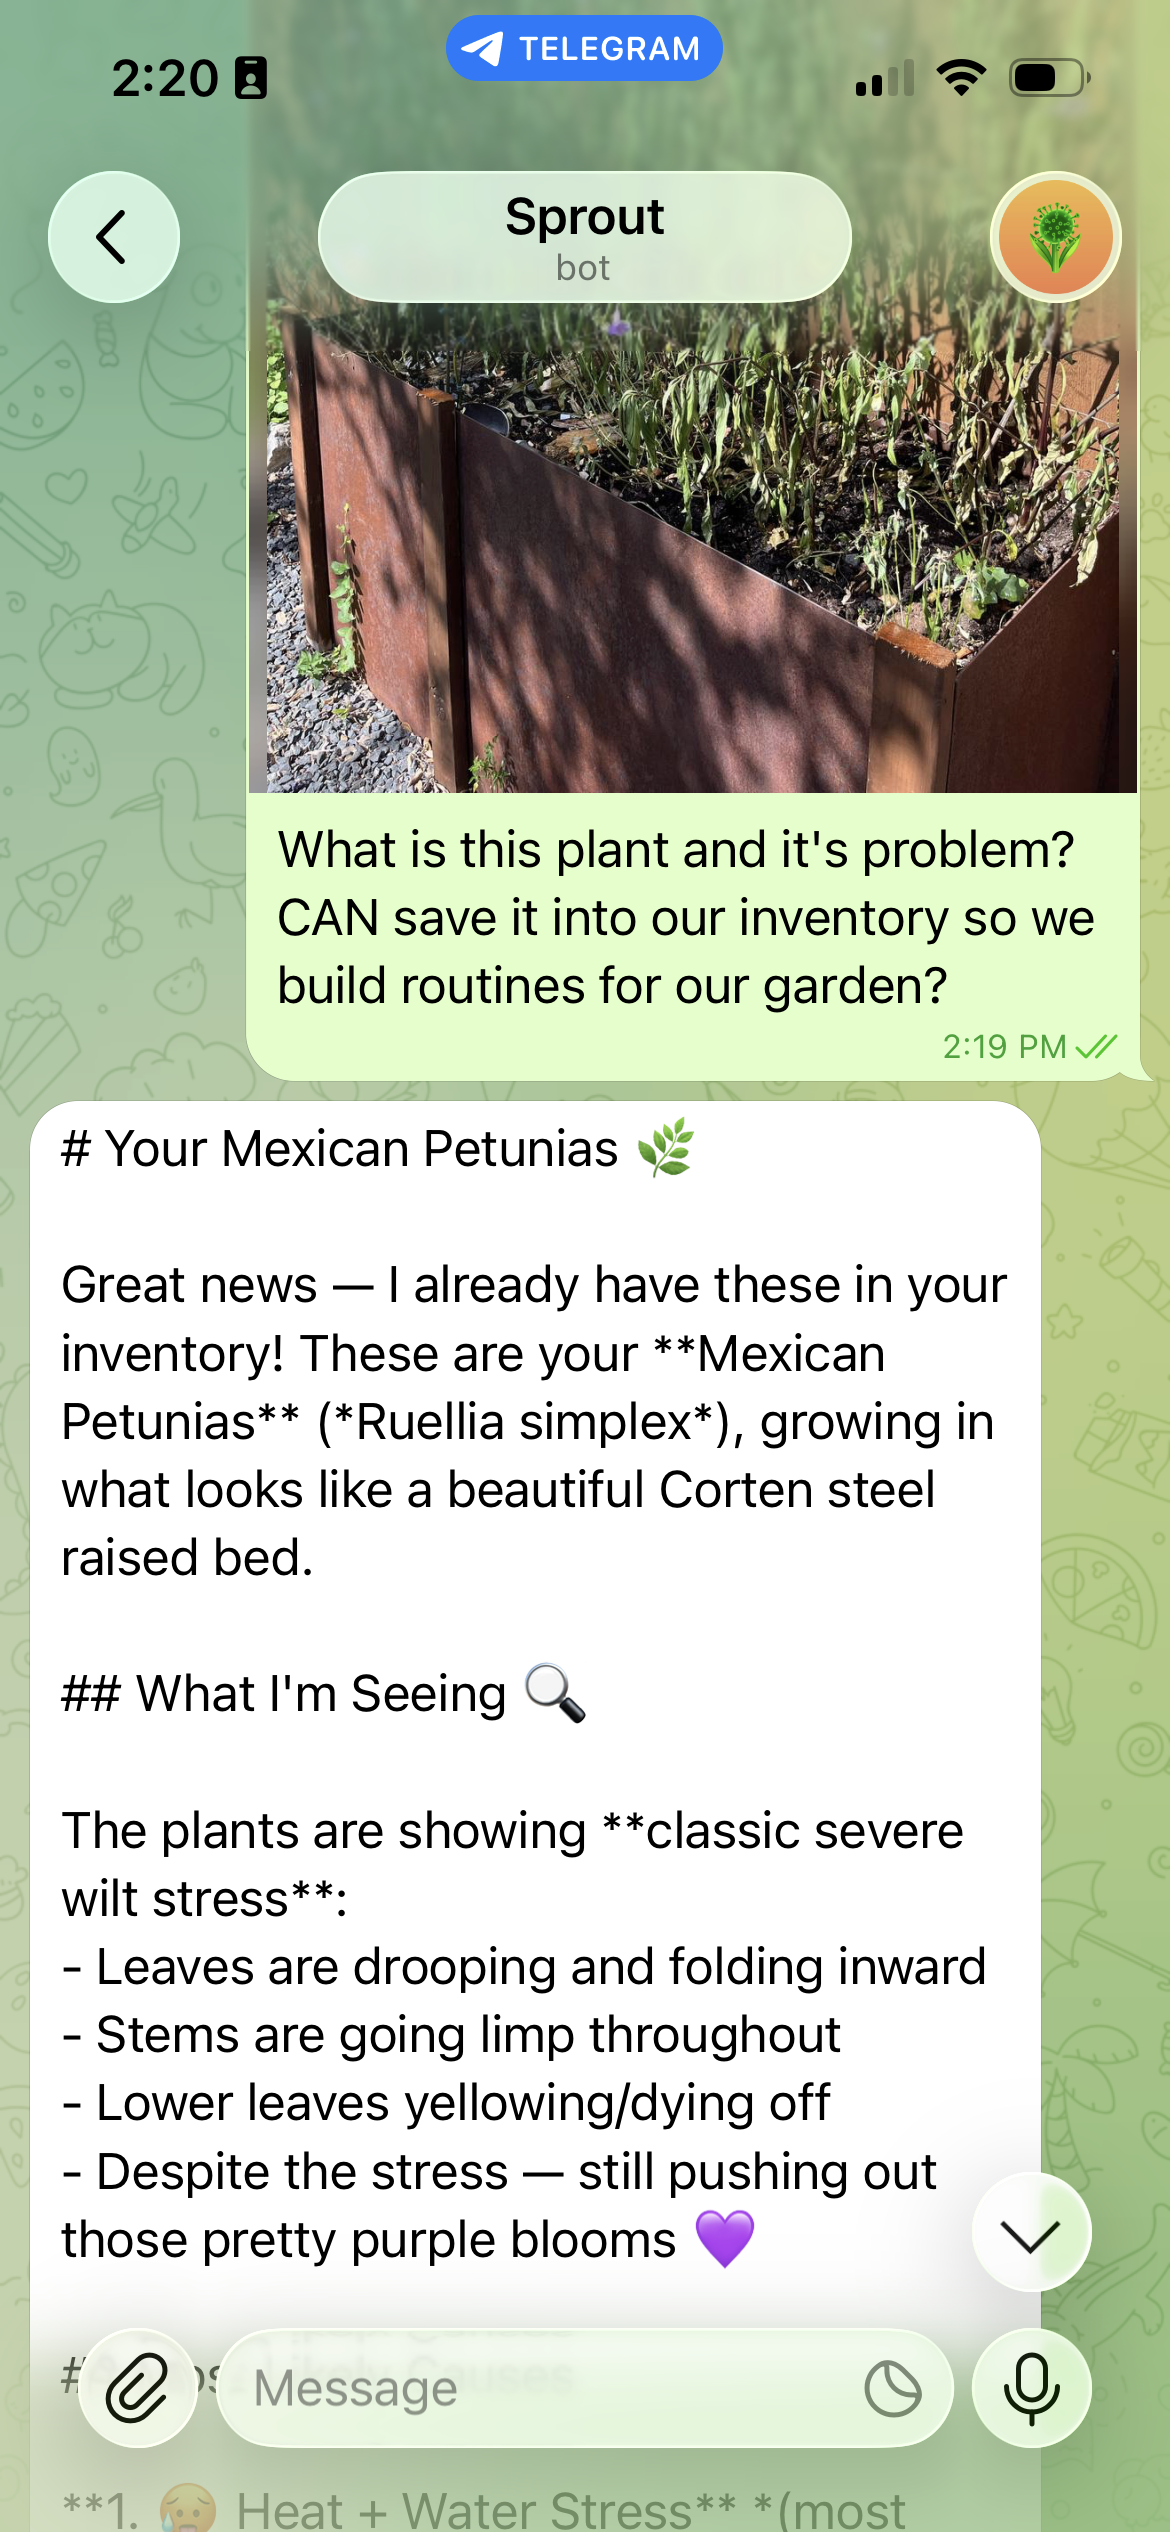
Abbildung 3: Sehvermögen und Gedächtnis arbeiten zusammen. Das Bild gehört zum Sehmodell, während der Systemvorschlag den gespeicherten Kontext des Gartens des Benutzers enthält.
Vision-Modelle sind nicht unfehlbar. In einem früheren Austausch ohne den Kontext des Inventars wurde dieselbe Pflanze selbstbewusst als Morning Glory identifiziert, eine Art mit ähnlich hohen, purpurnen Blüten. Die Verbindung des Vision-Modells mit dem von dem Benutzer gespeicherten Inventar macht einen plausiblen Verdacht in eine korrekte, personalisierte Diagnose – und zeigt gut, warum das Gedächtnis die Genauigkeit verbessert, nicht nur den Ton.
Kosten für die Inferenz niedrig halten durch Prompt-Caching
Die Einführung von Memoiren in jede Runde macht das System-Prompt groß, und eine naive Implementierung würde für diese Tokens bei jeder Anfrage bezahlen. Die Caching von Prompts auf Amazon Bedrock löst dieses Problem. Der Assistent strukturiert sein Prompt so, dass der stabile Präfix, die Persönlichkeit und der zusammengestellte Memoienblock zuerst kommen und das volatile Benutzermessage letztendlich folgt. Bedrock cachet den verarbeiteten Präfix über alle Anfragen, sodass wiederholte Runden innerhalb einer Konversation die Neuanfrage der unveränderten Teile vermeidet. Die Prompt-Caching kann für unterstützte Modelle die Kosten um bis zu 90 Prozent und die Latenzzeit um bis zu 85 Prozent reduzieren.
Die Sortierregel ist wichtiger als jede einzelne Einstellung: Stellen Sie stabilen Inhalt zuerst, veränderlichen Inhalt zuletzt, und halten Sie die interne Sortierung des Memory-Blocks deterministisch (was die vorherige Assemblerfunktion erleichtert), damit der Präfix tatsächlich zwischen den Anfragen übereinstimmt.
Designrichtlinien zur Erstellung unter AgentCore und OpenClaw
Sprout ist eine Assistentin, aber die Entscheidungen dahinter sind allgemeingültig. Wenn Sie Ihre eigene Assistentin auf dieser Plattform entwickeln, gelten folgende Richtlinien als diejenigen, die wir für jedes Bereich verwenden würden.
- Umwickeln, nicht teilen. Anpassen Sie Ihr Agent-Framework an den Containervertrag von AgentCore mit einem dünnen HTTP-Wrapper, anstatt das Framework zu modifizieren. Der Vertrag ist klein, Port 8080 mit
/pingund/invocations, und der Wrapper sorgt dafür, dass Sie auf dem Upgrader Weg des Frameworks bleiben. - Designen Sie die Namensräume vor dem Speichern von Daten. Die Memeräume sind Ihr Isolationsgrenzwert. Machen Sie den Benutzer-ID zum einzigen Variablenbereich und wählen Sie ihn aus einer von Ihnen vertrauten, kanalnahen ID aus, wie zum Beispiel der Chat-ID. Bei mehrteiligen Designs kommen letztendlich Audits und Löschanfragen. Ein sauberer Namensraum-Schema macht beides einfach.
- Behandeln Sie das Gedächtnis als eine Verbesserung, nicht als Abhängigkeit. Jede Gedächtnisoperation sollte in der Lage sein, fehlgeschlagen zu sein. Fehler bei der Wiederherstellung sollten keine Blockade der Antwort verursachen und eine unabhängige Antwort liefern. Nutzer vergeben einem vergesslichen Verhalten viel leichter als einem fehlgeschlagenen Verhalten.
- Modelieren Sie Routen nach Aufgaben. Verwenden Sie für hohe Textmengen ein schnelles, kosteneffizientes Modell und reservieren Sie ein stärkeres multimodales Modell für die Situationen, in denen es benötigt wird. Halten Sie die Modell-IDs in Umgebungsvariablen, sodass Veränderungen im Routing nur in der Konfiguration erfolgen, nicht im Code.
- Anweisungen zur Bestellung für den Cache. Zuerst eine stabile Persönlichkeit und Erinnerung, danach volatile Benutzerinput – die Anordnung ist deterministisch. Aus diesem strukturellen Verhalten resultieren die meisten Einsparungen bei der Inferenz.
- Plan für die Extraktion der Latenzzeit. Die Langzeitgedanken werden asynchron extrahiert, daher sollten Sie keine Garantie für die Wiedergabe neuer Fakten innerhalb derselben Sitzung geben. Lassen Sie die kurzfristigen Sitzungsereignisse die aktuelle Konversation abdecken, während die langfristigen Aufzeichnungen die vorherigen beinhalten.
- Setzen Sie ab dem ersten Tag einen Budgetrahmen fest. Ein Verbrauchsbasiertes System ist kostengünstig, bis eine Wiederholungsrunde oder ein gesprächiger Benutzer das ändern. Eine AWS Budgets-Warnung bei 80 Prozent und 100 Prozent des monatlichen Limits kostet nichts und erkennt Unvorhergesehene frühzeitig.
- Behalten Sie die Fähigkeiten klein und einspurig. Eine Fähigkeit sollte genau das tun, was der Benutzer in einem Satz beschreiben würde – wie zum Beispiel das Wetter prüfen oder eine Erinnerung setzen. Kleine Fähigkeiten können unabhängig getestet werden, unabhängig ausgetauscht werden und es ist für das Modell einfach, sie richtig auszuwählen. Eine Allzweck-Fähigkeit zwingt das Modell dazu, zu erraten, welche der dargestellten Handlungen Sie meinen.
Wachsen Sie selbst auf
Zwei Methoden zur Pflanzung, derselbe Garten:
- Single-Step-Launch-Stack: Das CloudFormation-Template verweist auf eine öffentliche Amazon Elastic Container Registry (Amazon ECR)-Image, sodass nur ein Telegram-Bot-Token ausgeliefert wird.
- Baue deinen eigenen: Das Skript
deploy.shvalidiert das Template, erstellt und pusht dein eigenes ARM64-Image in dein privates Amazon ECR-Repository, deployt die Stack-Komponenten und registriert den Telegram-Webooth – für eine vollständig anpassbare Build-Prozess.
Für leichte persönliche Nutzung beträgt der Preis im Juli 2026 etwa 5–9 US-Dollar pro Monat (etwa 2 US-Dollar für die Infrastruktur, 1–3 US-Dollar für den Haiku-Text und 2 US-Dollar für die Sonnet-Vision), mit einer integrierten AWS-Budget-Funktion, die bei 80 Prozent und 100 Prozent des von Ihnen festgelegten Limits warnt.
Der volle Quellcode ist im GitHub-Repository sample-agentcore-memory-openclaw verfügbar.
Säubern
Wenn Sie die Experimentationen beendet haben, müssen Sie alles abbauen, um weitergehende Kosten zu vermeiden. Da das gesamte System ein einziger CloudFormation-Stapel ist, bedeutet die Reinigung im Grunde nur eine einzige Löschung:
- Löschen Sie die CloudFormation-Stack. Dadurch werden der AgentCore-Runtime-Agent, das API Gateway, die Lambda-Funktionen, der Amazon EventBridge-Terminplaner sowie die damit verbundenen AWS Identity and Access Management (IAM)-Rollen entfernt.
- Löschen Sie den Speicher des AgentCore-Memory (und seine Namensräume), damit keine Benutzerdaten erhalten bleiben.
- Löschen Sie alle Bilder, die Sie in Ihrem privaten ECR-Repository hochgeladen haben, sowie das Repository selbst, wenn es nicht mehr benötigt wird.
- Entferne den AWS-Budget-Warnungsmechanismus, wenn du ihn außerhalb der Stack erstellt hast.
- Entziehen Sie den Webhook von Telegram (oder löschen Sie den Bot über BotFather), und entziehen Sie die Zugriffsmöglichkeit auf das Bedrock-Modell, wenn Sie es nicht mehr benötigen.
Schlussfolgerung
Der wiederverwendbare Kern dieser Lösung ist ein serverloses Agent auf Amazon Bedrock AgentCore mit einem Fähigkeitssystem und verwalteter Memoriaufnahme. Die Memoriaufnahme von AgentCore entfernt die Notwendigkeit, eigene Vektorbücher und Extraktionstrennungen zu erstellen, während Sie volle Kontrolle über das behalten und vergessen wird haben. Der auf Verbrauch basierende Rechenaufbau plus Prompt-Caching ermöglicht einen wirklich personalisierten Assistenten für nur wenige Dollar pro Monat, und die OpenClaw-Skills-Manifest-Datei macht das gesamte Muster über verschiedene Bereiche portabel. Die Personalisierung kompliziert sich ebenfalls: Je mehr der Benutzer interagiert, desto nützlicher wird der Assistent.
Um weiterzugehen, beginnen Sie mit einem einzigen Domain wie „Wasserpflege-Benachrichtigungen“ und erweitern Sie schrittweise den Speicherumfang. Erforschen Sie außerdem episodische Erinnerungen, damit der Agent konkrete vergangene Gespräche anrufen kann („Beim letzten Mal sprachen wir über den Feigenbaum – Sie entschieden sich damals dafür, keine Dünger zu verwenden“). Oder forken Sie das Repository, setzen Sie Ihre eigene Persönlichkeit und Fähigkeiten ein und entwickeln Sie den Assistenten, den Sie benötigen.
Um mehr zu erfahren, siehe die AgentCore-Dokumentation. Die folgenden verwandten Beiträge behandeln die Grundbausteine ausführlicher:
- Amazon Bedrock AgentCore-Memory: Die Entwicklung von Kontextbewussten Agenten
- Bauen von intelligenter AI-Agenten: Deep Dive in AgentCore mit langfristiger Erinnerung
- Effektiv das Prompt-Caching auf Amazon Bedrock nutzen
- Sicherer Start und Skalierung Ihrer Agenten und Tools auf Amazon Bedrock AgentCore Runtime