
Über den ersten Blick
- Harnessed Agentic RL: Microsoft Research Asia präsentiert ein Trainingsparadigma, in dem der gleiche Agent, der bei der Implementierung verwendet wurde, direkt am Reinforcement Learning teilnimmt – dadurch entfällt die Notwendigkeit, den Agenten erneut im Trainingsrahmen zu implementieren.
- Leichtgewichtig von Design: Der Agent Lightning v1.0 bietet ein vollständiges Agent-RL-Kontrollsystem in etwa 3.500 Zeilen Code.
- Native Kubernetes-Unterstützung: Agenten laufen als standardmäßige Kubernetes-Arbeitsaufgaben auf selbst verwalteten Clustern, Cloud-Kubernetes oder lokaler Infrastruktur, ohne Abhängigkeit von bezahlten kommerziellen Sandbox-Diensten.
- Dateneffiziente Trainingsmethode: ein end-to-end Kodieragent-Pipeline brachte Qwen3.5-9B von 41,8 % auf 56,4 % Pass@1 auf SWE-bench Verified, eine Zunahme von 14,6 Prozentpunkten, indem nur etwa 6.000 Trainingsbeispiele auf einem offen verfügbaren Datensatz verwendet wurden.
Künstliche Intelligenz-Agenten haben sich von einzelnen Modellen zu komplexen Full-Stack-Systemen entwickelt, die aus Modellen, Werkzeugen und Ausführungsumgebungen bestehen. Ihre Fähigkeiten hängen zunehmend vom Agent-Netzwerk ab, das sie von außerhalb des Modells koordiniert. Verstärkungsschulung (RL) ist ein Ansatz, bei dem KI-Systeme durch Versuch und Irrtum lernen, angeleitet durch Belohnungen und Strafen für ihre Handlungen. RL kann diese Agenten verbessern, aber die meisten Agent-RL-Systeme erfordern, dass Entwickler den Agenten innerhalb des Trainingsrahmenwerks neu implementieren. Das ist kostspielig und bedeutet, dass der trainierte Agent nicht genau der Agent ist, der in der Praxis eingesetzt wird.
Um dieses Problem zu lösen, haben Forscher von Microsoft Research Asia das Harnessed Agentic RL-Training-Modell eingeführt und ein vollständig neu konstruiertes Agent Lightning v1.0 (öffnet sich in neuem Tab) frei zugänglich gemacht. Im Vergleich zum ursprünglichen Agent Lightning v1.0 legt es mehr Wert auf Leichtgewicht, auf die Integration mit echten Traktoren sowie auf einen vollständigen und reproduzierbaren Agent RL-Training-Prozess.
Agent Lightning v1.0 wurde umfassend neu entwickelt auf der Grundlage von Harnessed Agentic RL, mit wichtigen Verbesserungen:
- Leichtgewichtig: Das gesamte Framework umfasst etwa 3.500 Zeilen Code. Agent Lightning v1.0 implementiert ein vollständiges Harnessed Agentic RL-System in einem Codebase, der klein und klar genug ist, um verstanden, angepasst und erweitert werden zu können.
- Training auf einem echten Agent-Harness: Die Agenten erreichen das Modell durch den Proxy des großen Sprachmodells (LLM) in Agent Lightning v1.0, wobei der bestehende Harness-Code unverändert bleibt.
- Nativer Kubernetes-Unterstützung: Die Agenten laufen direkt als Kubernetes-Jobs, ohne externe kommerzielle Sandbox-Dienste. Sowohl selbst verwaltete Clustere als auch lokale Infrastruktur können Umsetzungen in großem Maßstab unterstützen.
- Ein vollständiges Beispiel für die Ausbildung eines Codieragenten: ein end-to-end-Pipeline, der auf Qwen3.5-9B basiert, erhöhte Pass@1 auf SWE-bench Verified von 41,8% auf 56,4%, was eine absolute Steigerung von 14,6 Prozentpunkten bedeutet, und dazu wurden nur etwa 6.000 Trainingsbeispiele verwendet.
Die Grenzen der traditionellen Agenten-Random-Strategie
Die traditionelle agentische RL-Technik geht davon aus, dass das Trainingsframework die Interaktionsschleife mit der Umgebung kontrolliert. In einer ReAct-artigen Schleife generiert das Modell eine Handlung, die Umgebung liefert eine Beobachtung, diese Beobachtung wird zum Kontext hinzugefügt und das Modell generiert die nächste Handlung – so führt das gesamte Vorgehen zu einer kontinuierlichen Tokentrajectory. Frühe RL-Systeme wie verl, AReaL und slime wurden auf diese Weise entwickelt, was bedeutet, dass das Trainieren eines Agenten erforderte, seine Schleife innerhalb des RL-Frameworks neu zu erstellen.
Echte Steuerungssysteme haben diese Annahme überholt. Agenten wie mini-SWE-agent, OpenHands, OpenCode, Claude Code und Codex bringen jeweils ihre eigene Kontextverwaltung, Toolprotokolle, Ausführungslogik und Abhängigkeiten mit sich – genauso wie allgemeine Agentensysteme. Die Rekonstruktion eines solchen Systems für das Training ist kostspielig, und der neu konstruierte Agent kann nicht mehr so verhalten wie der aktuell eingesetzte Agent.
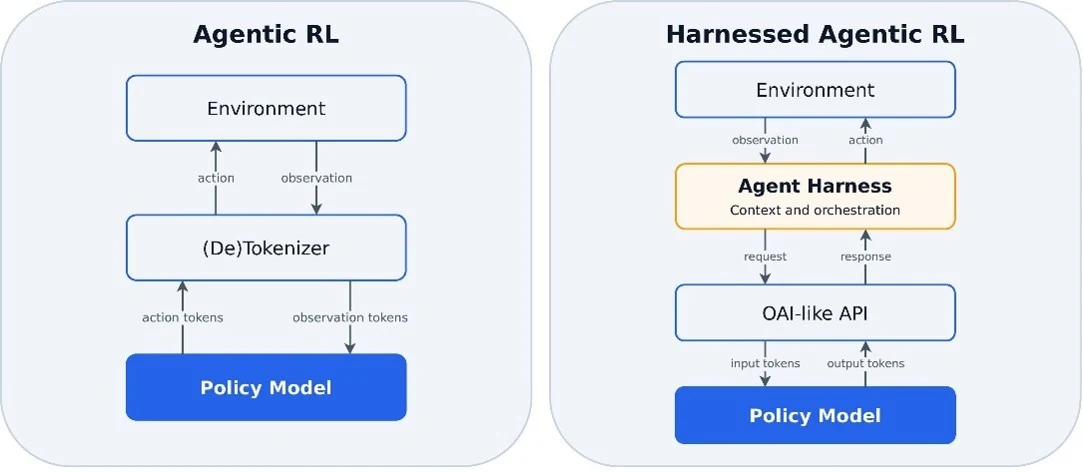
Der Agent Lightning nimmt einen anderen Weg. Er platziert einen LLM-Proxy zwischen dem Agent und dem Modell. Der Agent läuft weiterhin wie zuvor: Man richtet einfach den Endpunkt aus, der zuvor die Model-API angerufen hat, auf Agent Lightning, und das Trainingsframework kann seine Model-Aufrufe beobachten und aufzeichnen. In v1.0 gehen die Forscher noch einen Schritt weiter und definieren dieses Paradigma formell als Harnessed Agentic RL: Jeder Agent, der bei der Implementierung verwendet wird, ist derjenige, der direkt am Reinforcement-Learning während des Trainings beteiligt ist (Abbildung 1).
Vier Herausforderungen bei der Ausbildung mit echten Tragerädern
Der wesentliche Unterschied zwischen Harnessed Agentic RL und traditioneller agentischer RL besteht darin, dass der Interaktionszyklus mit dem Umfeld vom Agent-Harness übernommen wird, nicht vom Trainingsframework. Das Trainingssystem kann nur eine Reihe von Paaren aus LLM-Anfragen und -antworten beobachten, sodass eine einzige Rollout-Phase in eine variable Anzahl von Trainingsbeispielen unterteilt werden kann. Dies bringt vier wichtige Herausforderungen mit sich:
- Retokenisierung und Samplerückmischung: Die Harness-Technologie behält den Kontext als Text bei, aber die RL-Trainierung benötigt die Token-IDs, die während der Ausführung gesammelt wurden. Das Durchlaufen des Textes durch das Chat-Template und den Tokenizer kann die Token-Grenzen verändern, sodass benachbarte Anfragen nicht immer in einen einzigen Samplerückmischungsprozess überführt werden können.
- Vorteilsberechnung: Retokenisierung, Subagenten und Kontextsummierung können eine einzige Rollout-Phase in mehrere Samples aufteilen. Die Berechnung von Baselines und Vorteilen direkt auf dem Sample-Niveau führt dazu, dass die Rollouts, die mehr Samples erzeugen, wiederholt gezählt werden, was die ursprünglichen statistischen Beziehungen auf Rollout-Ebene verändert.
- Verlustnormalisierung: Die Durchschnittlichkeit des Verlusts nach der Anzahl der Sample verleiht den Implementierungen, die mehr Samples erzeugen, mehr Gewicht. Da die Anzahl der Samples oft nur ein Produkt des Verhaltens des Harnesses ist, muss die Verlustnormalisierung auch nicht durch dieses verzerrt werden.
- Training der Backend-Scheduling: Die Anzahl und Länge der Beispiele sind erst nach Abschluss des Harness bekannt, während die GPU-Anzahl sowie die parallelen Konfigurationen für Daten/Tensor in der Regel festgelegt sind. Der Backend muss eine variable Arbeitslast auf feste Ressourcen umwandeln.
Spotlight: Microsoft Forschungsnewsletter
Microsoft Research Newsletter
Abonnieren Sie heuteErstellen eines vollständigen Agent-RL-Kontrollplans mit 3.500 Zeilen Code
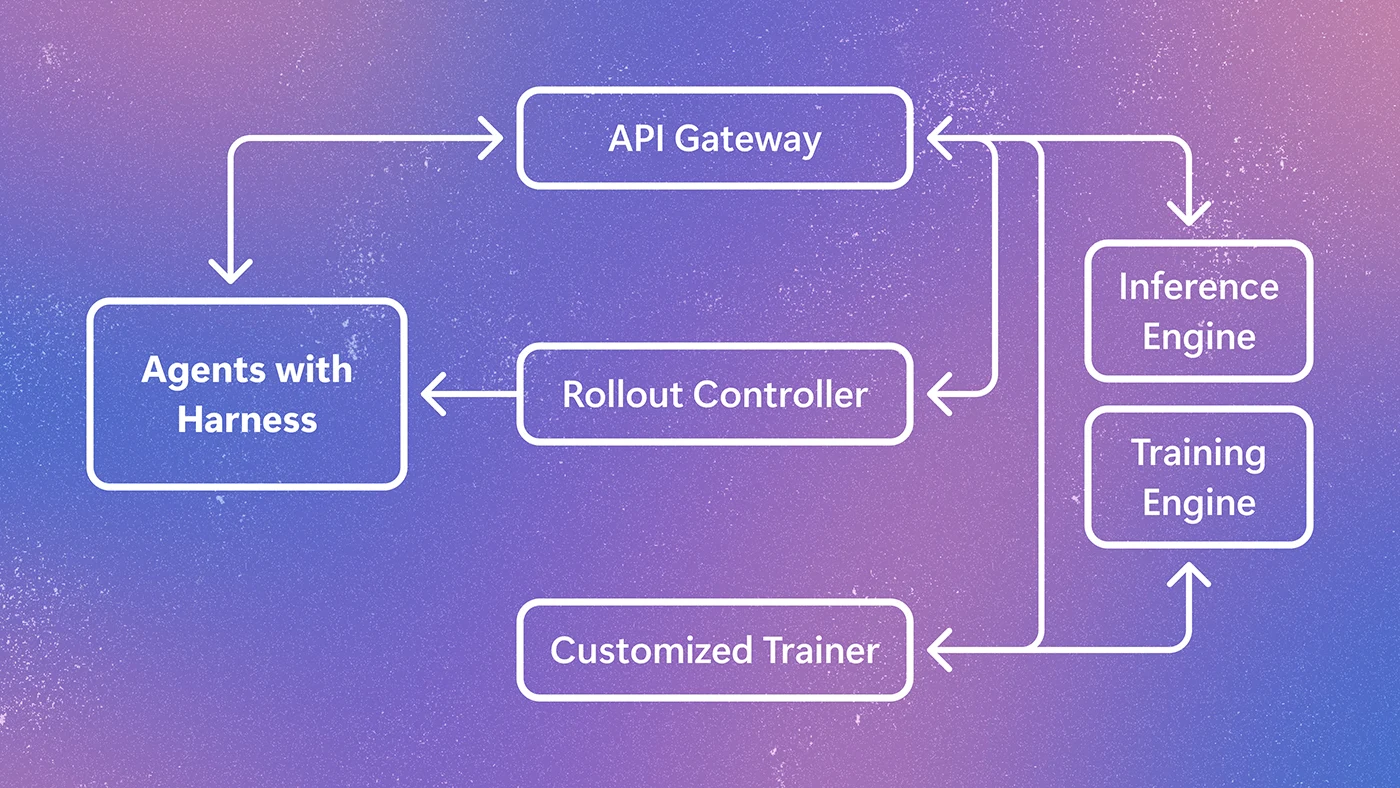
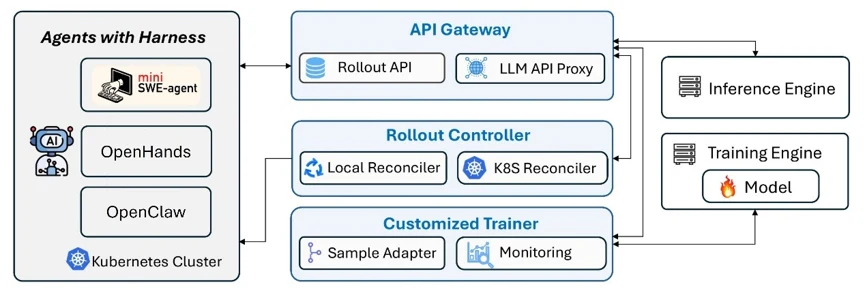
Im Systemdesign behandelt Agent Lightning v1.0 die Einfachheit als seine erstes Prinzip. Das gesamte Framework umfasst etwa 3.500 Zeilen Code und besteht aus drei Kernkomponenten: dem API Gateway, dem Rollout-Controller und dem Customized Trainer (Abbildung 2).
Die API-Gateway speichert Rollouts, Modelle und Ereignisse und dient als Proxy für einen OpenAI-kompatiblen LLM. Sie verbindet jede Modellanfrage vom Harness mit ihrem Rollout und dokumentiert die Prompts, Antworten und Log-Probabilitäten, die für das Training benötigt werden. Der Rollout-Controller startet und verwaltet die Ausführung des Agenten – entweder als lokale Prozesse oder als standardmäßige Kubernetes-Jobs – wobei die Ausführung des Agenten vom Trainer getrennt bleibt. Der personalisierte Trainer, der auf Verl basiert, erstellt Ausführungen, wartet darauf, dass sie abgeschlossen sind, sammelt Proben und assembliert die endgültigen Trainingsproben über einen Sample-Adapter. Infolgedessen reicht es für ein bestehendes Agent-Harness, den Model-Endpunkt auf den Agent Lightning Proxy zu richten, um schnell mit dem RL-Training zu verbinden.
Kollokierte asynchrone RL
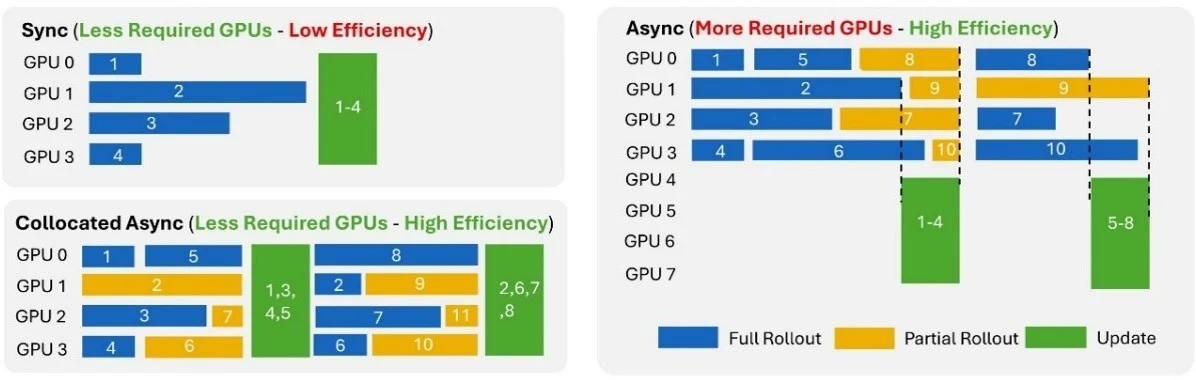
Die Ausführungszeiten variieren stark zwischen den Agenten. Synchroner RL wartet auf den langsamsten Agenten in einer Charge und lässt die GPUs unbenutzt, während vollständig asyncher RL die Nutzung erhöht – allerdings benötigt er separate GPU-Pools für die Ausführung und das Training. Als Antwort führt Agent Lightning v1.0 Collocated Async RL ein, durch das die Ausführung und die Modellupdates denselben GPU-Set teilen können.
Sobald das System genügend Rollouts gesammelt hat, beginnt die Aktualisierung: Das API Gateway hört auf neue Anfragen zu akzeptieren und wartet darauf, dass die bereits im Gange befindlichen Anfragen abgeschlossen werden. Die Rollout-Prozess wird nach Abschluss der Aktualisierung wieder fortgesetzt. Die gesamte Zustandsübergangskette ist für den externen Agenten sichtbar. In Experimenten erreichte diese Methode eine etwa 2x höhere End-to-End-Speedup im Vergleich zu synchronem RL, während weniger GPUs als bei herkömmlichem asynchronem RL verwendet wurden (Abbildung 3).
Agenten ausführen auf Kubernetes
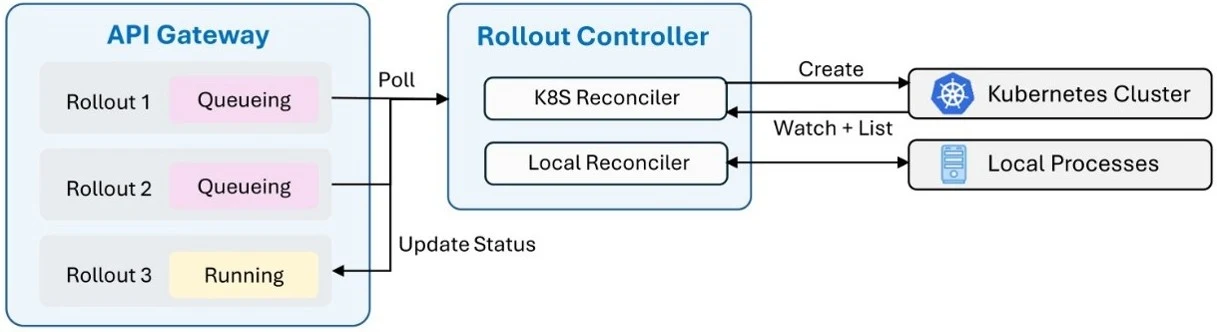
Es erfordert die Ausführung vieler Agenten gleichzeitig, um ausreichende Rollouts zu erhalten, was erhebliche CPU-, Speicher- und Rechenressourcen verbraucht. Andere Harnessed Agentic RL-Frameworks hosten diese Agenten oft auf kommerziellen Sandbox-Diensten wie Modal Sandbox oder E2B, wobei die Kosten mit der Größe schnell ansteigen. Stattdessen läuft Agent Lightning v1.0 sie als standardmäßige Kubernetes-Jobs aus, indem es bestehende selbstverwaltete Clustere, Cloud-Kubernetes oder lokale Infrastruktur wieder verwendet (Abbildung 4). Die bestehenden Rechenressourcen werden effizienter genutzt, die Kosten für große Rollout-Projekte sind niedriger, und der gesamte Prozessablauf bleibt Open Source und reproduzierbar.
6.000 Trainingsbeispiele, ein Leistungsgewinn von 14,6 Punkten
Um den Ansatz zu testen, baute das Forschungsteam eine vollständige Pipeline unter SWE-smith, mini-SWE-agent und Qwen3.5-9B auf, die Datenbereinigung, die Umgebungskonstruktion, Sicherheitsmaßnahmen für Belohnungsanpassungen und RL-Training umfasst. Das Trainingsset enthält etwa 6.000 Beispiele und benötigt keine großflächige Rechenleistung. Allein das RL-Training erhöhte Qwen3.5-9B auf SWE-bench Verified von 41,8 % auf 56,4 %, was einem Anstieg von 14,6 Prozentpunkten entspricht.
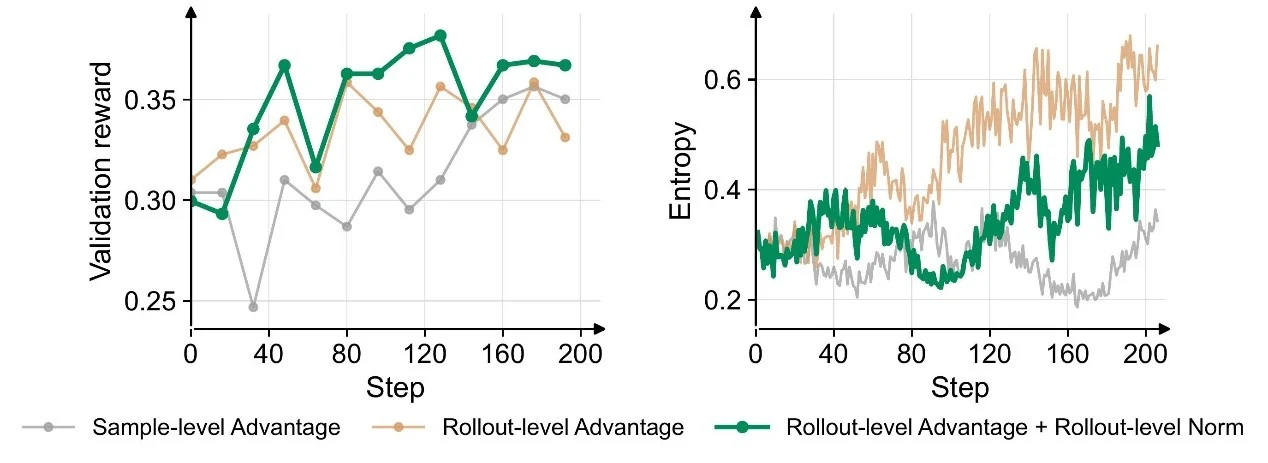
Die weiteren Experimente des Kompilierungsagenten bestätigen die frühere Analyse von zwei Herausforderungen: der Vorteilsberechnung und der Verlustnormalisierung. Im Vergleich zur Bearbeitung auf Stichprobenniveau führt die Verwendung von Vorteilen auf Rollout-Ebene in Kombination mit Normalisierung auf Rollout-Ebene zu einer höheren Validierungsbelohnung und erhält die Policy-Entropie während des Trainings stabiler (Abbildung 5).
Die Erstellung der Artikel Agent Lightning v1.0: Ein 3.500-Linien-gewichtiges leichte Agentisches RL-Framework zur Ausbildung von Agenten mit echten Steuergriffen erschien zunächst in Microsoft Research.