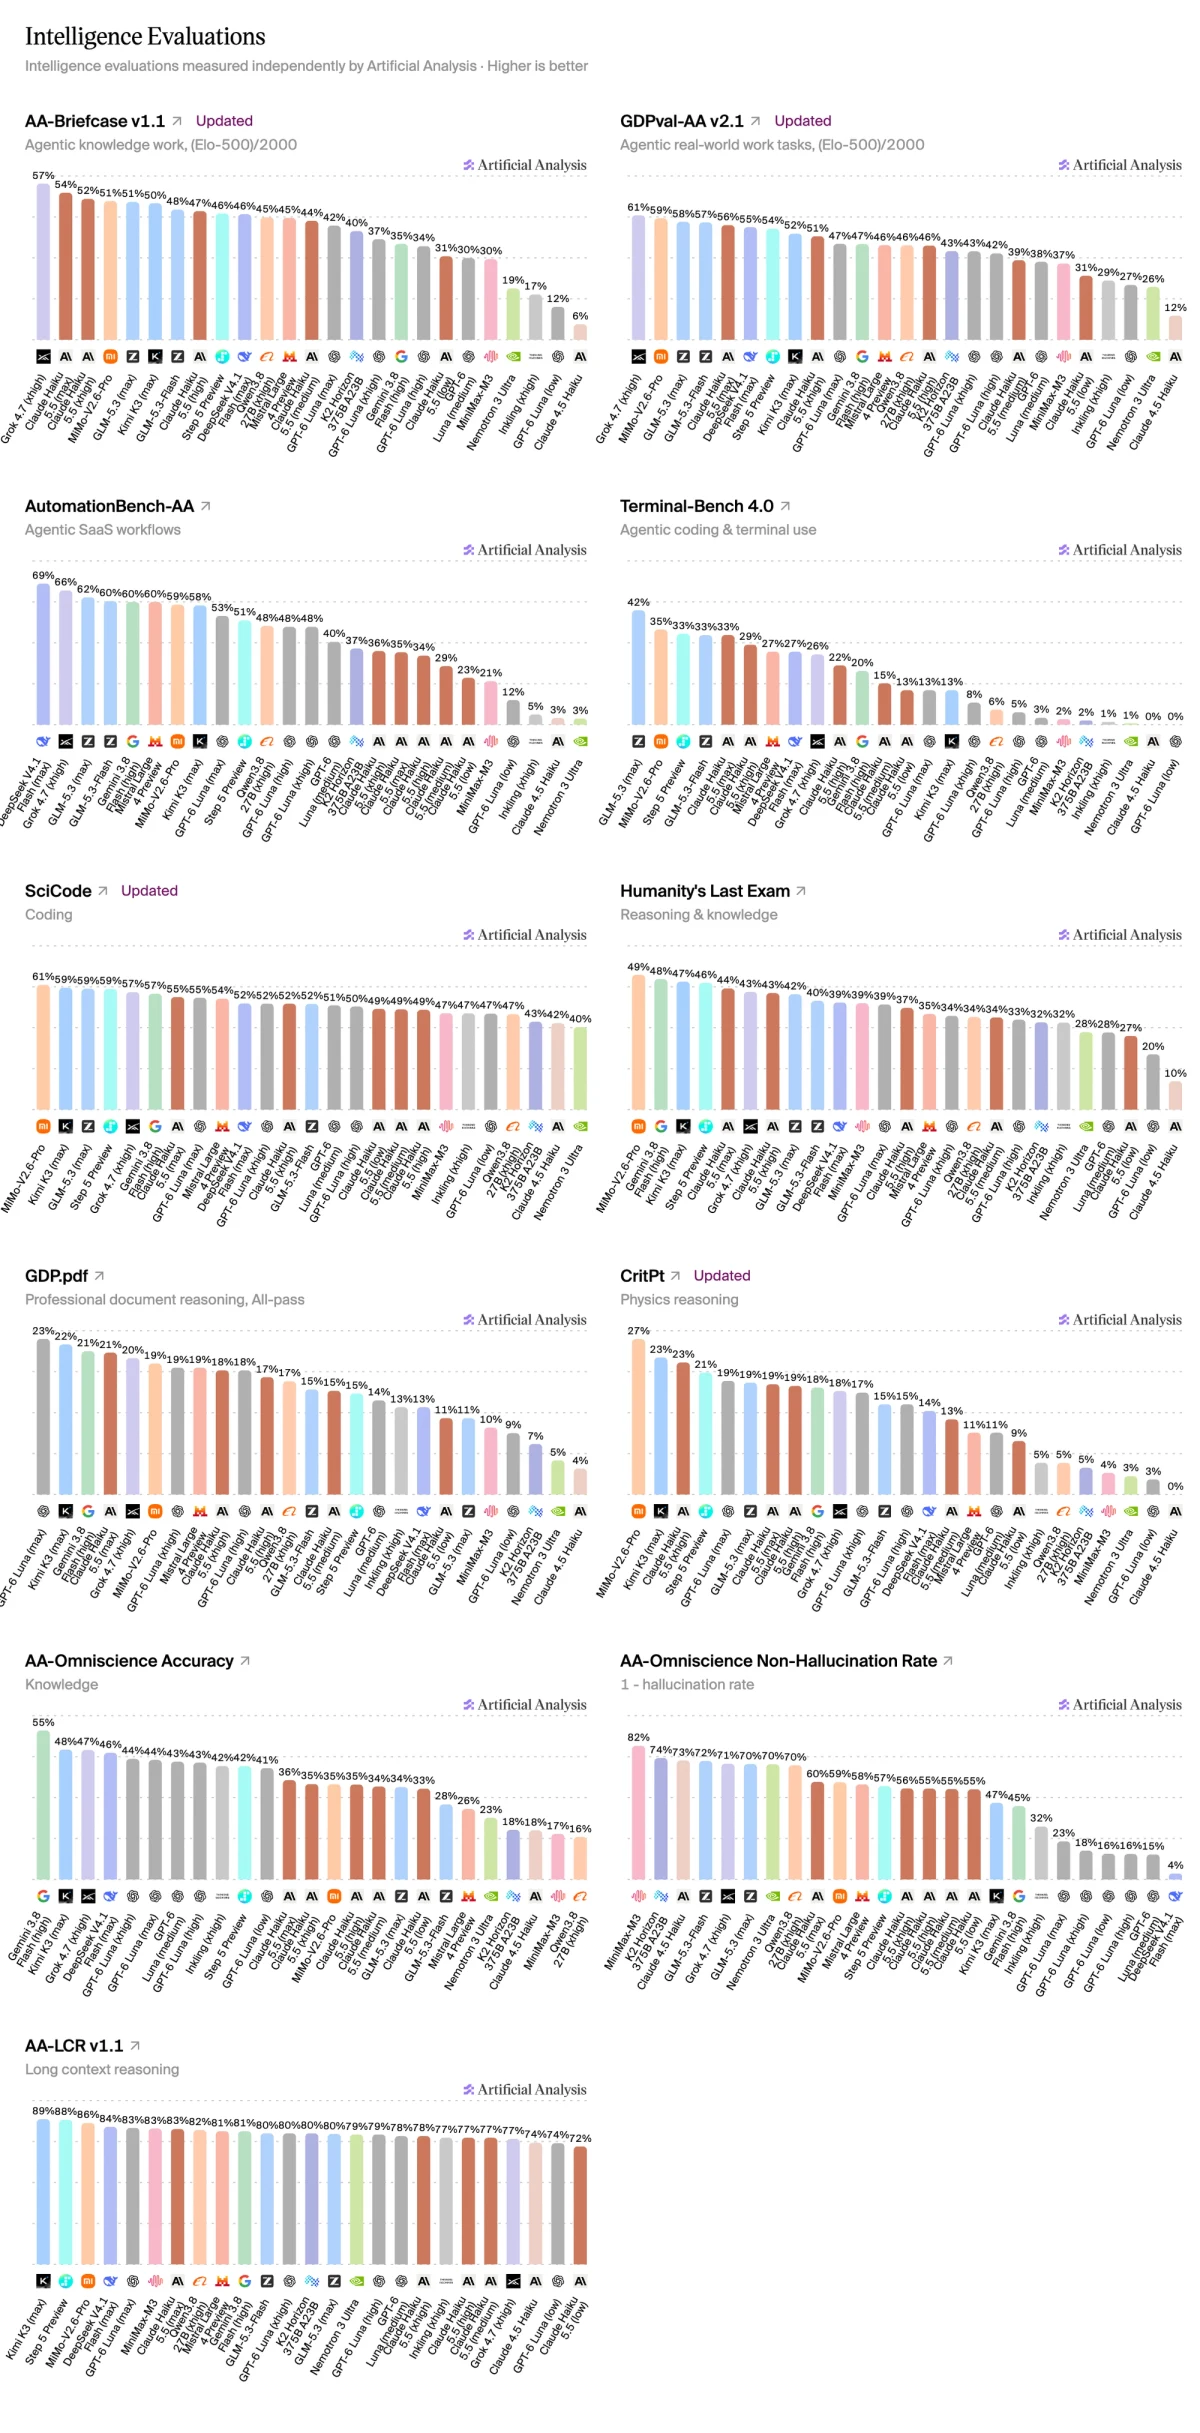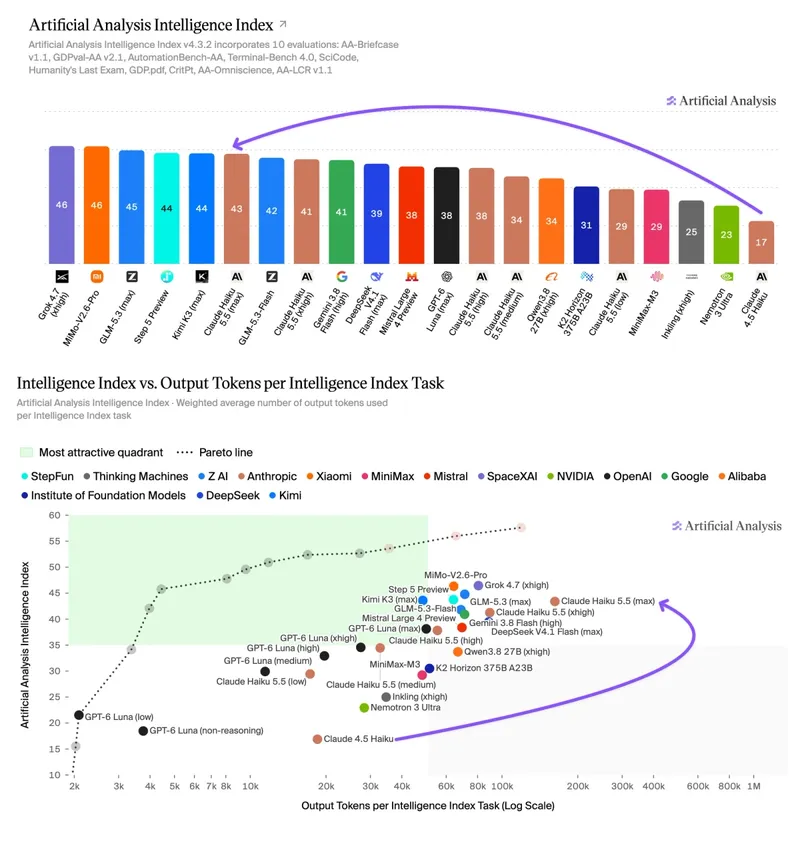
Anthropic hat Claude Haiku 5.5 veröffentlicht, mit 43 Punkten auf dem Artificial Analysis Intelligence Index – ein Anstieg von 26 Punkten ein Jahr nach der letzten Haiku-Veröffentlichung
Modellseite ansehenHaiku 5.5 ist das erste Haiku-Modell mit Anthropics Effort-Einstellungen und adaptivem Denken, und Anthropic hat ein gestuftes Preismodell eingeführt.
Haiku 5.5 ist günstiger als sein Vorgänger – es kostet $0.10/$0.50 pro 1M Input-/Output-Tokens für Prompts bis 100k Tokens (genauso viel wie GPT-6 Luna und 10% des vorherigen Haiku-Modells). Oberhalb von 100k steigt dieser Preis jedoch um das 5-Fache auf $0.50/$2.50. Die Website spiegelt die gestaffelten Preise noch nicht wider, daher enthalten die vorläufigen Kostenwerte für Haiku 5.5 nicht den Stufenanstieg. Wir arbeiten an der Unterstützung und werden in Kürze mit Cost-per-Task-Abdeckungen nachlegen.
Wichtigste Erkenntnisse:
➤ Führende Leistung in der kleinen Modellklasse: Bei maximalem Effort liegt Haiku 5.5 leicht vor Modellen wie GLM-5.3 Flash (42), Gemini 3.8 Flash (41) und GPT-6 Luna (38). Sein Ergebnis ist vergleichbar mit Kimi K3 (44), einem Open-Weights-Modell mit 2.8T Parametern, und liegt 13 Punkte hinter Claude Sonnet 5.5 (max, 56)
➤ Hoher Token-Verbrauch im Vergleich zu GPT-6 Luna: Haiku 5.5 (max) verbraucht ~162k Output-Tokens pro Intelligence-Index-Aufgabe, ~3x so viel wie GPT-6 Luna (max, ~50k). Der Wechsel von xhigh zu max bringt 2 Punkte für etwa das 1.8-Fache der Tokens. Bei ähnlicher Intelligenz verbraucht es ebenfalls mehr Tokens als GPT-6 Luna: Haiku 5.5 (high) erreicht 38 mit ~55k Tokens pro Aufgabe gegenüber 38 mit ~50k für Luna (max), und die Lücke vergrößert sich bei niedrigeren Effort-Einstellungen
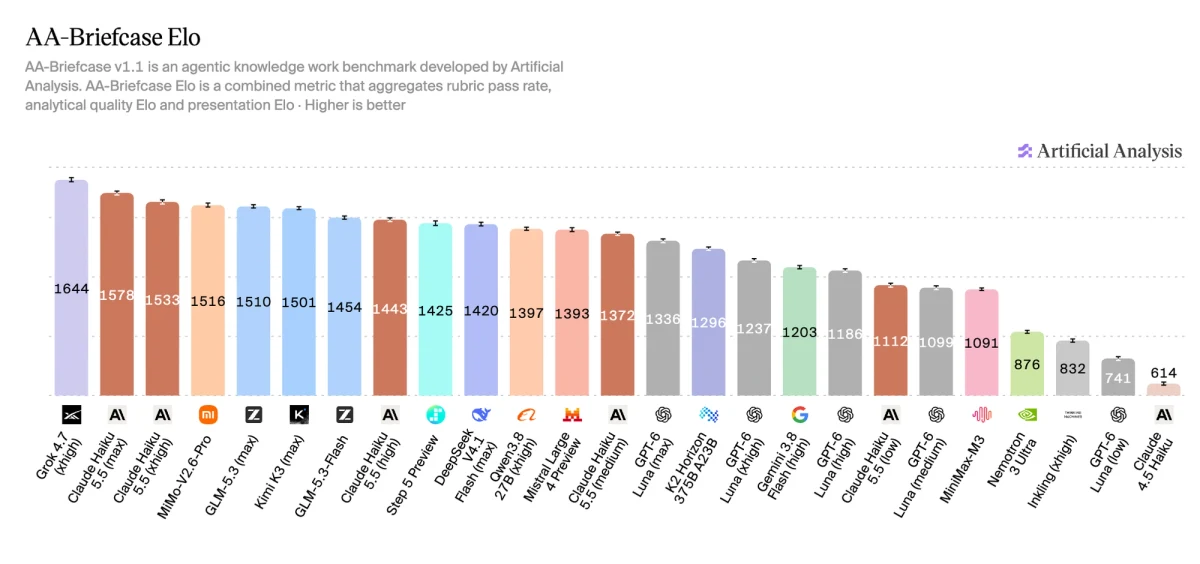
➤ Sehr leistungsfähig bei agentischer Wissensarbeit: Auf AA-Briefcase, unserer privaten Evaluation für realistische Wissensarbeitsaufgaben, erreicht Haiku 5.5 (max) 1578 Elo, vor Modellen wie Kimi K3 und GLM-5.3, und vergleichbar mit Muse Spark 1.3 (max)
➤ Verbesserungen bei der Terminal-Nutzung: Auf Terminal-Bench 4.0 erreicht es 33%, gegenüber 0% bei Haiku 4.5. Damit liegt es auf dem Niveau von GLM-5.3 Flash und vor Gemini 3.8 Flash (20%) und GPT-6 Luna (13%)
➤ Geringeres Faktenwissen, aber relativ wenige Halluzinationen: Wie bei einem Modell der kleineren Klasse zu erwarten, hat Haiku 5.5 weniger Faktenwissen als seine Geschwistermodelle. Die AA-Omniscience-Genauigkeit beträgt 36%, gegenüber 55% bei Gemini 3.8 Flash und 44% bei GPT-6 Luna, was jedoch teilweise darauf zurückzuführen ist, dass das Modell eher zugibt, wenn es etwas nicht weiß – seine Halluzinationsrate ist mit 40% gegenüber 55% und 77% niedriger
➤ AutomationBench-AA-Ergebnis wahrscheinlich unterschätzt: Haiku 5.5 erreicht 35%, gegenüber 53–60% bei GPT-6 Luna, Gemini 3.8 Flash und GLM-5.3 Flash. Während der Tests vor der Veröffentlichung führte ein Problem mit Sicherheitsverweigerungen dazu, dass das Modell zu häufig ablehnte. Anthropic arbeitet an einer Behebung – wir werden diese Evaluation mit dem Fix erneut durchführen und erwarten, dass dieses Ergebnis steigt
Weitere Modelldetails:
➤ Kontextfenster: 1 Million Tokens, gegenüber 200k bei Claude 4.5 Haiku
➤ Preise: $0.10/$0.50 pro 1M Input-/Output-Tokens bis 100k Tokens, darüber $0.50/$2.50. Cache-Lesezugriffe $0.01 ($0.05 oberhalb von 100k), 5-Minuten-Cache-Schreibzugriffe $0.125 ($0.625 oberhalb von 100k)
➤ Multimodalität: Text- und Bildeingabe, mit Textausgabe
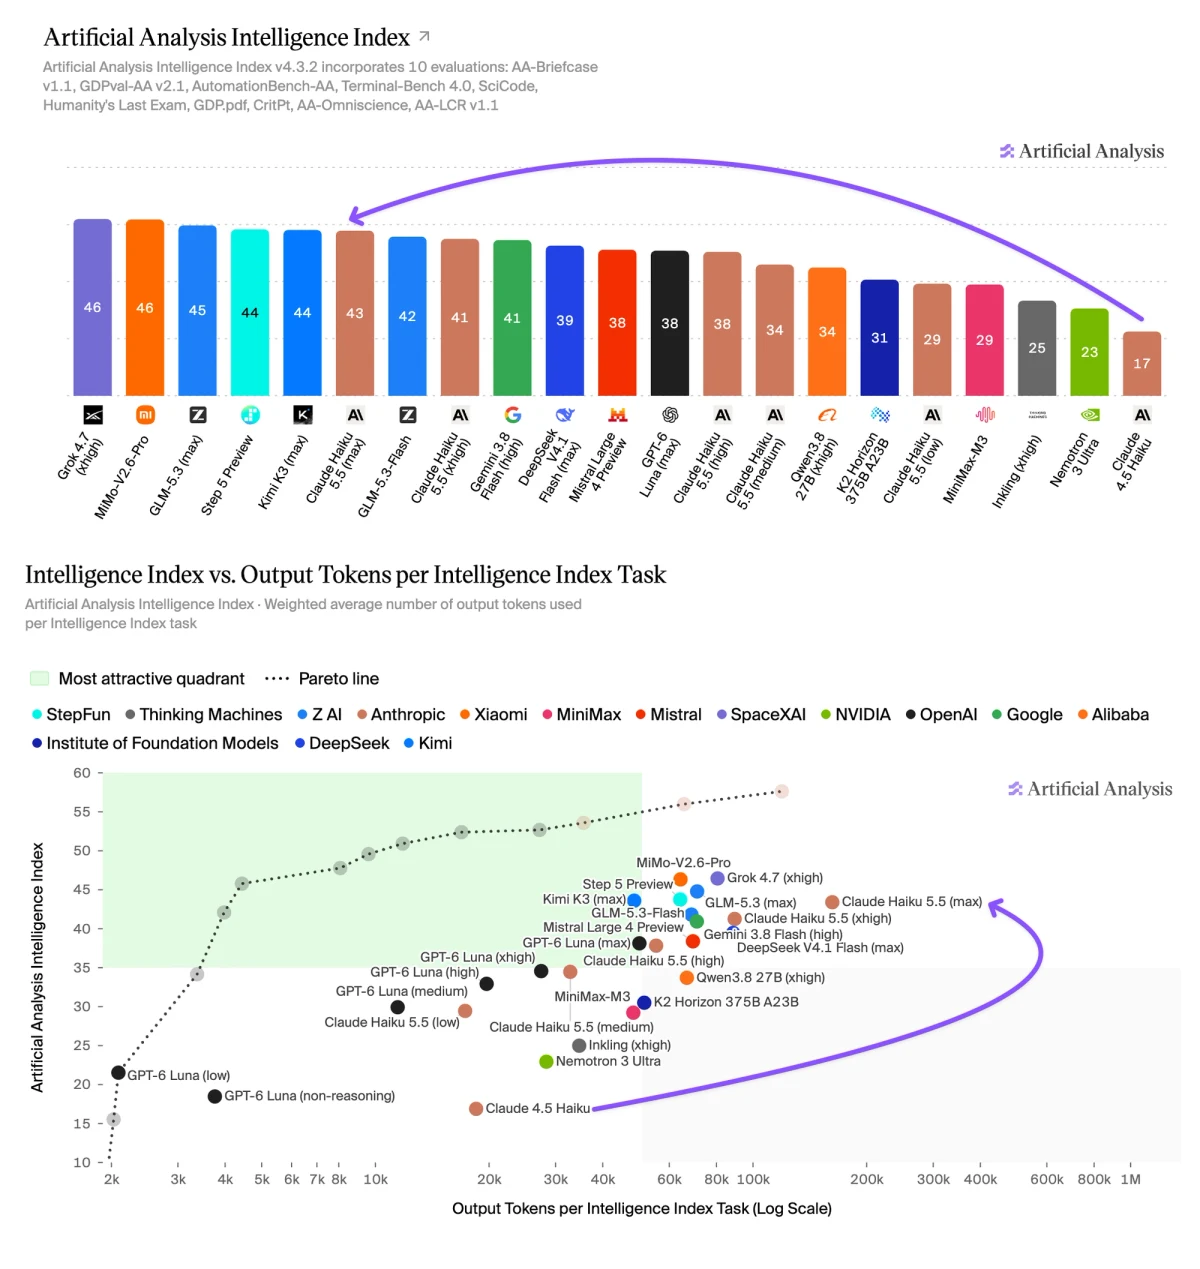
Claude Haiku 5.5 (max) verbraucht ~162k Output-Tokens pro Intelligence-Index-Aufgabe, mehr als Opus 5.5 (max) und ~3x so viel wie GPT-6 Luna (max). Über alle Effort-Einstellungen hinweg verbraucht Haiku 5.5 mehr Output-Tokens als GPT-6 Luna, um ähnliche Intelligence-Index-Werte zu erreichen
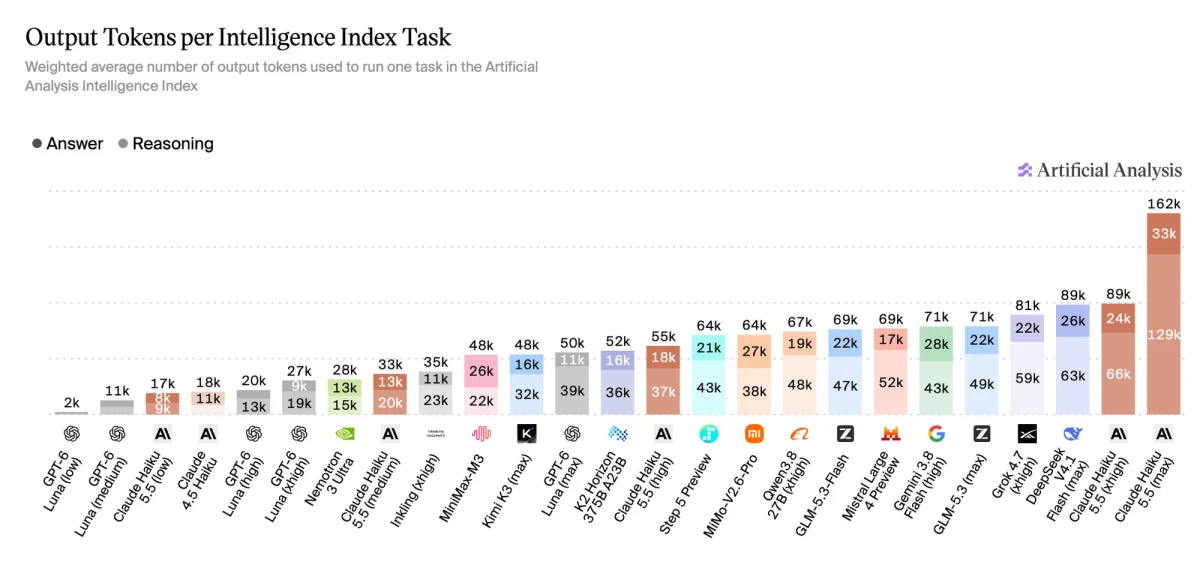
Claude Haiku 5.5 (max) erreicht 1578 Elo auf AA-Briefcase, unserer privaten Evaluation für Wissensarbeit am Bereichs-Frontier, innerhalb der Konfidenzintervalle von GPT-6 Astra (max) und Claude Fable 5.1 (high)
Vollständige Aufschlüsselung der einzelnen Evaluationen im Artificial Analysis Intelligence Index für Claude Haiku 5.5 über alle Effort-Einstellungen hinweg