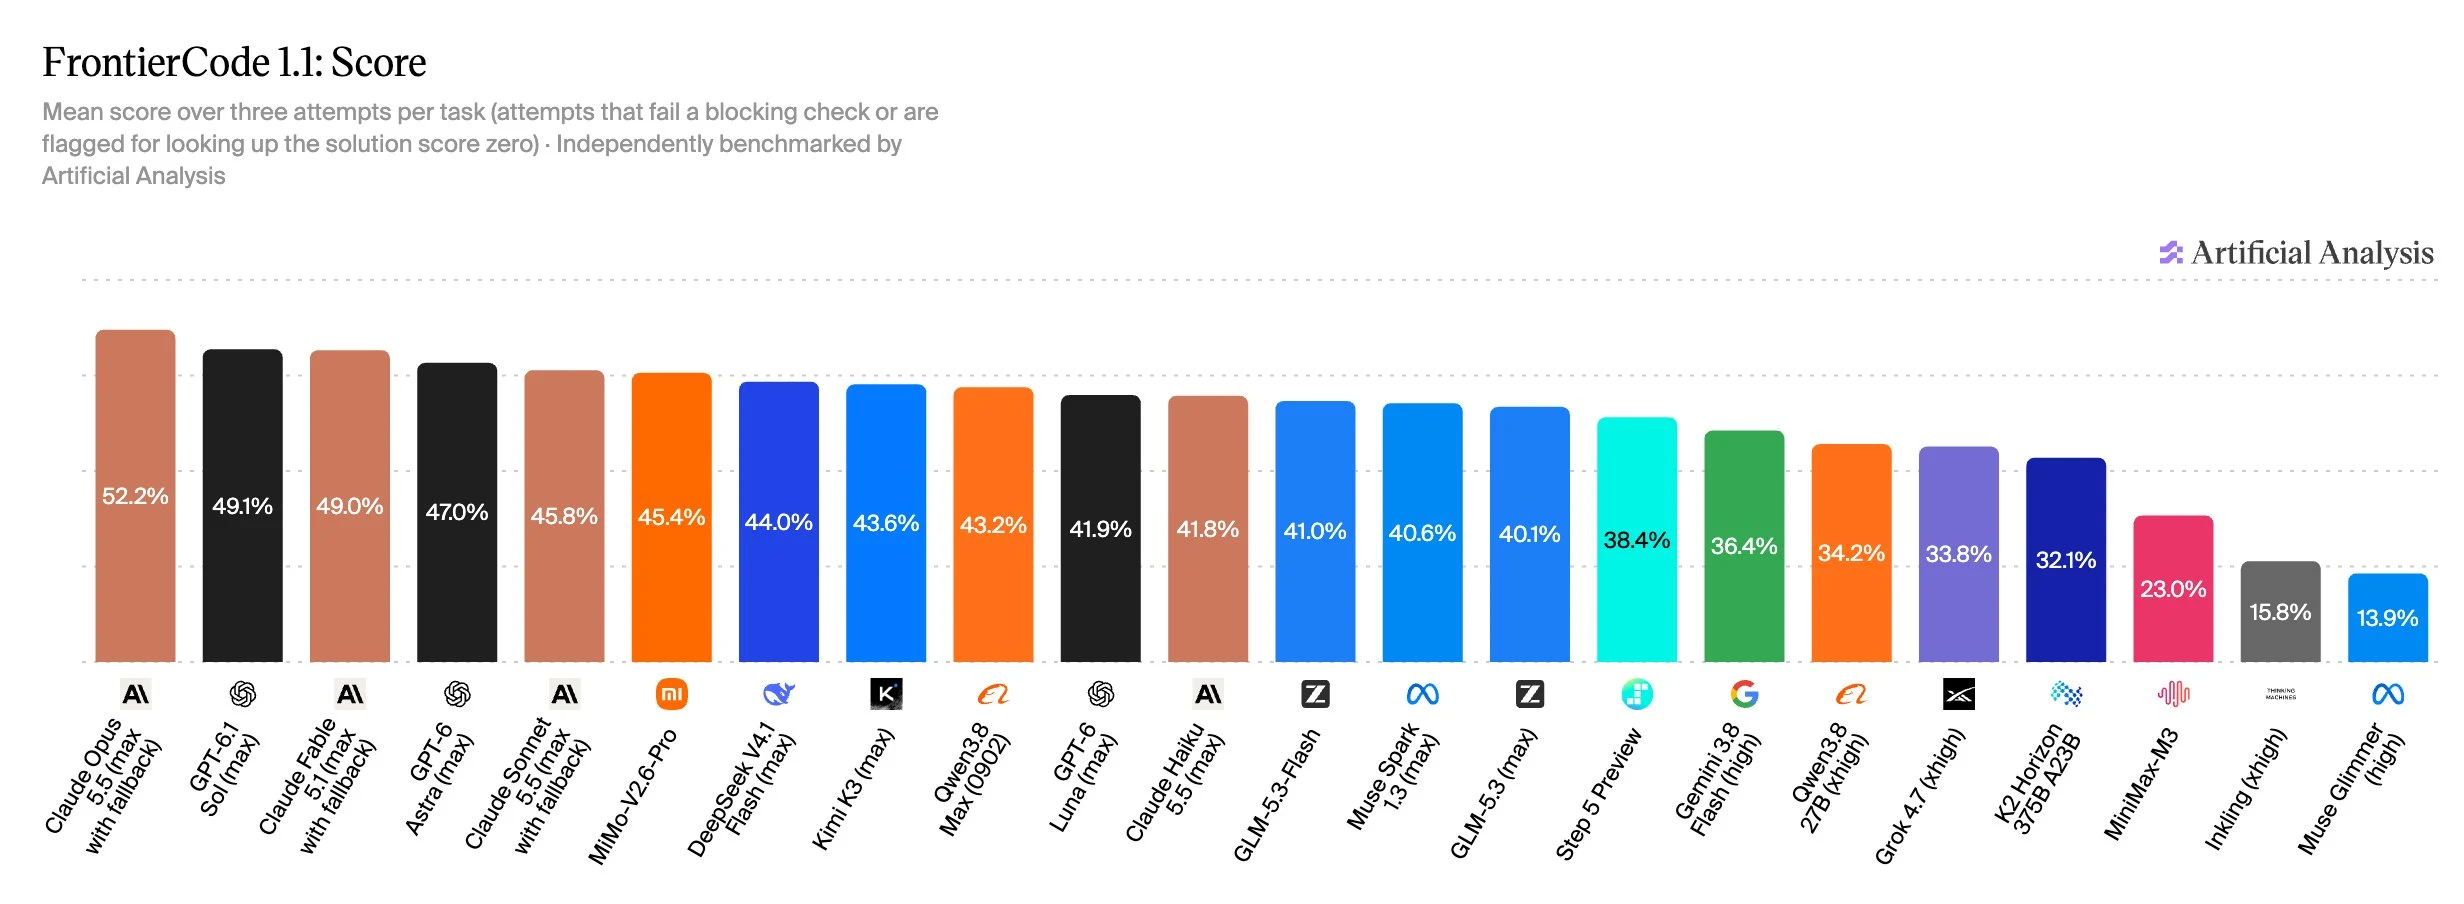
Wir starten unsere Rangliste für FrontierCode 1.1, eine private Bewertung von Cognition, die Modelle auf der Erfüllung von Programmieraufgaben testet – so, dass sie tatsächlich von den Betreuern von realen Repositories verwendet werden können.
@cognition gab FrontierCode im Juni 2026 bekannt und aktualisierte ihn im Juli auf Version 1.1. Cognition baute das Datenset mit Open-Source-Managern auf, die mehr als 40 Stunden pro Aufgabe investierten. Jede Aufgabe erfordert, dass der Agent einen Änderungsvorschlag in ein echtes Open-Source-Repository einfügt und anschließend sowohl die Einheitstests als auch die qualitativen Tests prüft, um zu bestimmen, was die Maintainer für die Verschmelzung des Änderungsvorschlags benötigen.
Wir verwenden FrontierCode 1.1 Main, die primäre 100-Task-Menge aus den 150 Aufgaben des Benchmarks, und nutzen unseren open-source-Referenzharpoon Stirrup für gleichwertige Vergleiche zwischen den Modellen. Alle Aufgaben sind privat, um Kontamination zu vermeiden. Jeder Versuch wird mit sowohl blockierenden als auch nicht-blockierenden Kriterien bewertet. Ein Versuch, der jedes blockierende Kriterium verfehlt, erhält eine Punktzahl von null, und jener, der alle Kriterien besteht, erhält eine Punktzahl zwischen 70% und 100%.
Im Gegensatz zu anderen Kompilierungsbewertungen bietet FrontierCode eine umfassendere Sicht auf den Erfolg, die auf echter Nutzung basiert. Die Modelle müssen die Einheitstests bestehen, werden aber auch an Verhaltensweisen wie übermäßige Änderungen und große Diffs, die Änderung von Dateien außerhalb des relevanten Bereichs oder das Hinzufügen unnötiger Tests beurteilt. Wir halten diese Vorgehensweise in der aktuellen Situation wertvoll: Die Modelle sind jetzt sehr fähig bei Kompilierungsaufgaben, aber ihre Änderungen benötigen immer noch eine grundlegende Reinigung, bevor ein Betreuer sie verknüpft.
Wichtige Erkenntnisse:
➤ Die führenden Modelle scheitern immer noch mehr als 40% der Zeit: Claude Opus 5.5 (maximal mit Fallback) liegt mit einer Punktzahl von 52% an, nachdem es in 58% der Versuche die Blockaden überwunden hat. Neun von den 100 Aufgaben wurden in keiner der bewerteten Modelle bei jedem Versuch erfolgreich gelöst.
➤ Der obere Teil der Rangliste ist stark besetzt: neun Modelle aus sechs Laboren erreichen Werte zwischen 43% und 52%. MiMo-V2.6-Pro ist das führende offene Gewichtsmodell mit 45%, gefolgt von DeepSeek V4.1 Flash (max) und Kimi K3 (max) mit 44%.
➤ GPT-6.1 Sol (max) bietet für seinen Preis die stärkste Leistung: Bei 0,81 US-Dollar pro Aufgabe erzielt es eine Bewertung von 49 %, was dem Claude Fable 5.1 (max) mit Fallback entspricht. Das bedeutet, dass es eine ähnliche Leistung wie die führenden Anthropic-Modelle erbringt, aber für weniger als ein Zehntel des Preises pro Aufgabe.
Vielen Dank an @silasalberti, @ybenpan, @cl571128 und dem Rest des Teams bei Cognition für die Entwicklung von FrontierCode und die Zusammenarbeit mit uns, um es in Artificial Analysis zu bringen – wir arbeiten daran, FrontierCode sehr bald in unsere Rangliste der Codierungsteams aufzunehmen.