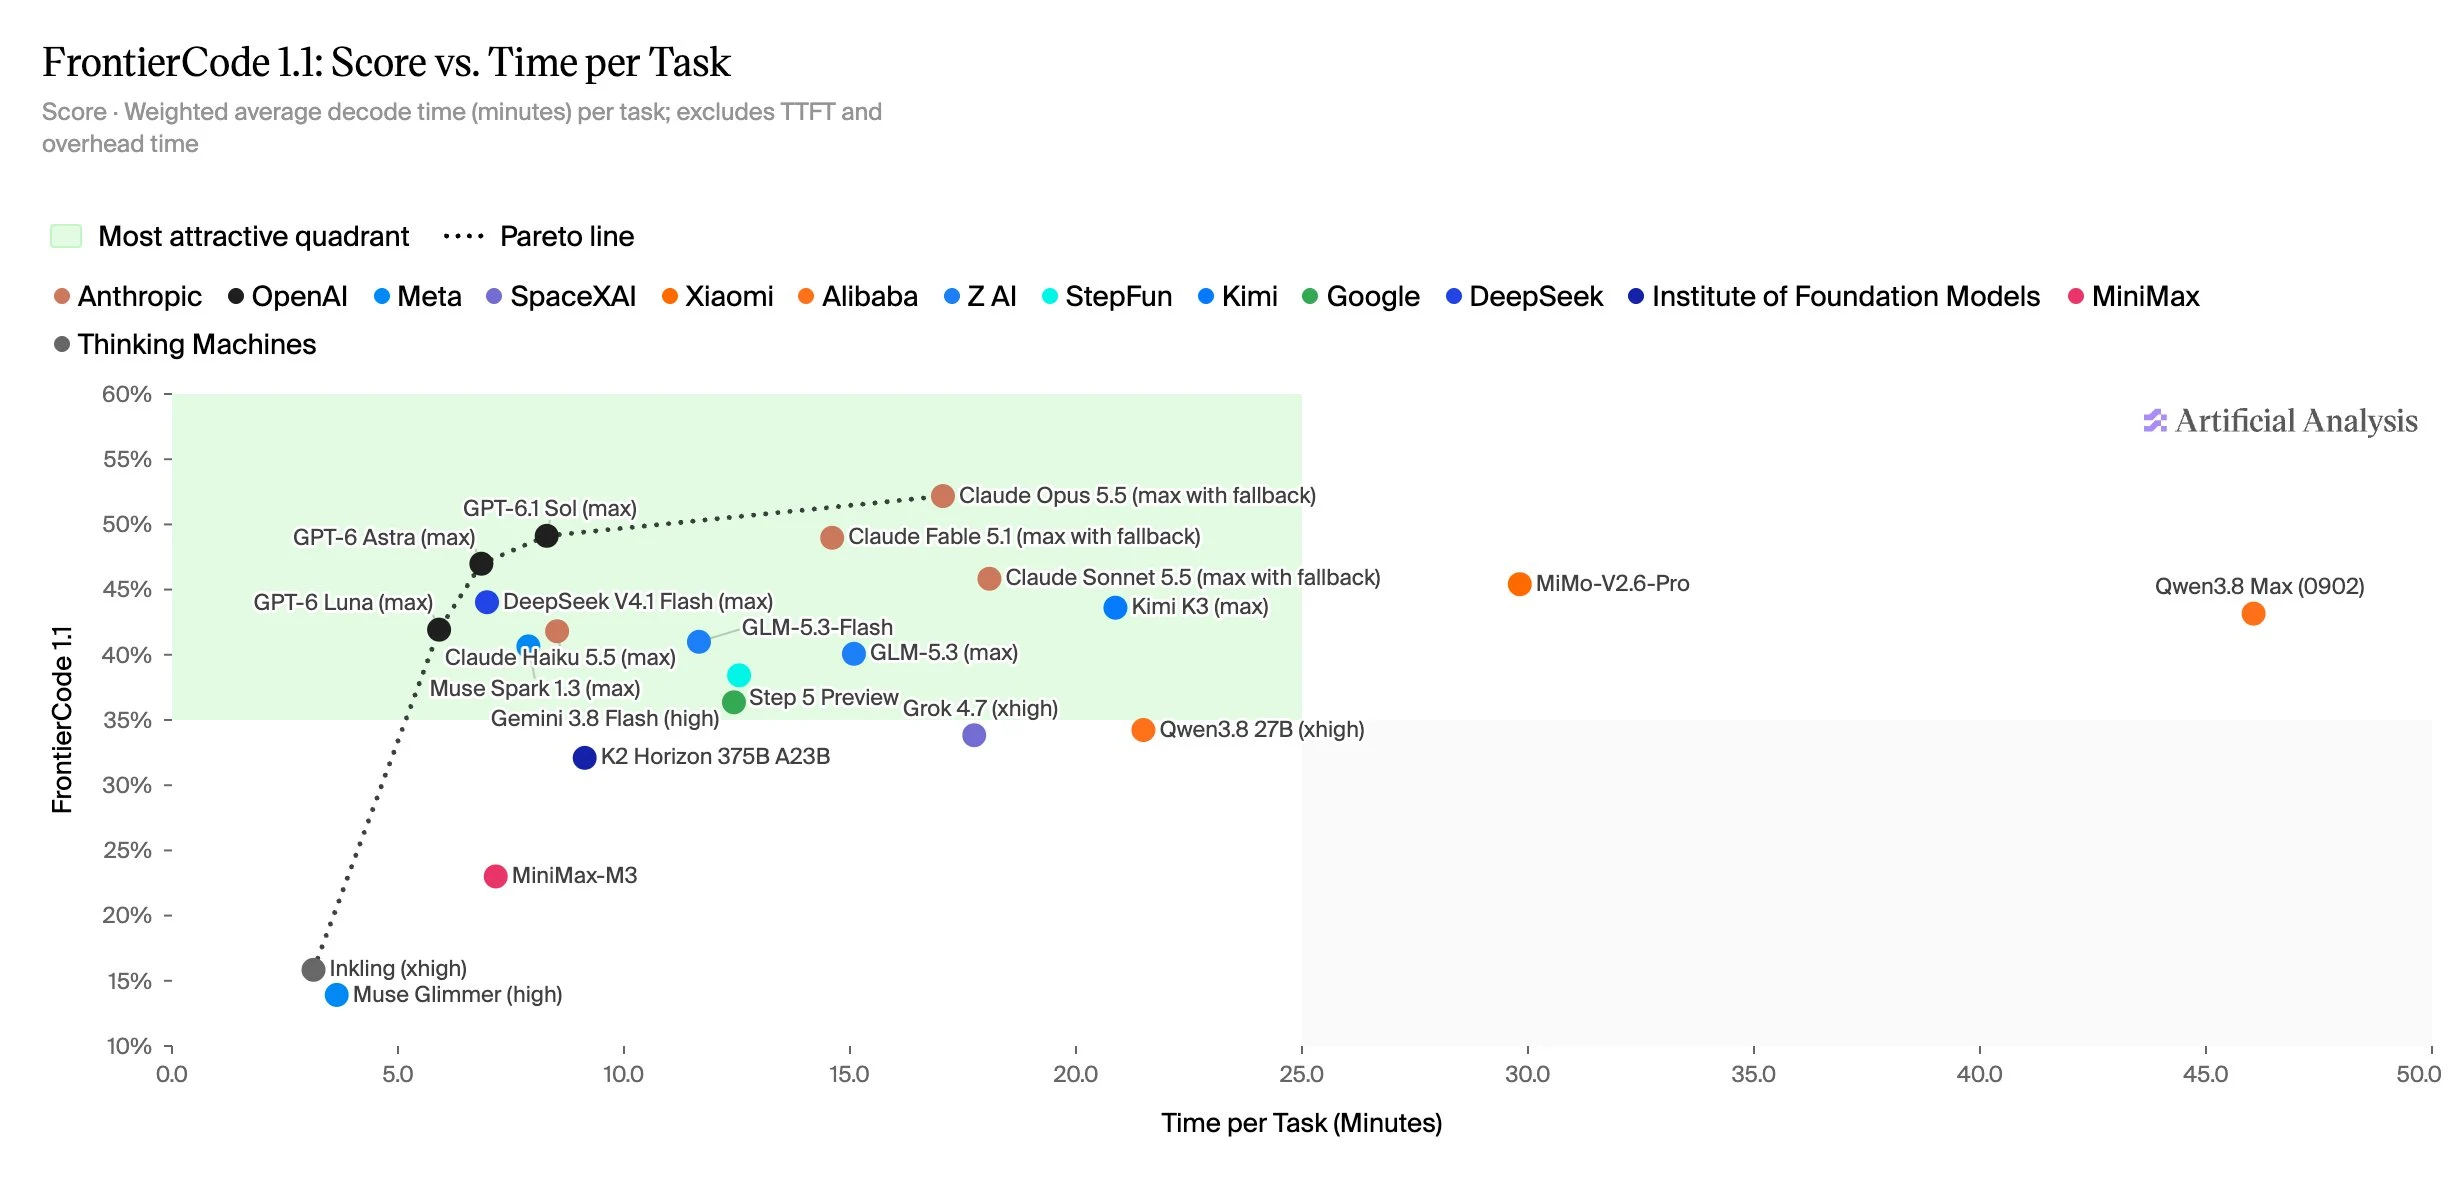
GPT-6 Luna (max), GPT-6 Astra (max), GPT-6.1 Sol (max) und Claude Opus 5.5 (max mit Fallback) stehen an der Peripherie des Pareto-Grenzwerts bezüglich der Punktzahl und der Zeit pro Aufgabe. Wir schätzen die Zeit pro Aufgabe anhand des Tokenverbrauchs jedes Modells und unserer Messungen der Ausgabengeschwindigkeit. Die GPT-6-Modelle sind schnell, weil sie wenige Tokens verwenden – 27k bis 48k Ausgabetokens pro Aufgabe. DeepSeek V4.1 Flash (max) verwendet ~119k, wird aber schnell bereitgestellt, mit einer durchschnittlichen Dauer von ~7 Minuten pro Aufgabe, was etwa 40% der Zeit von Claude Opus 5.5 (max mit Fallback) entspricht, bei ~17 Minuten.