
Multi-Turn-Agentic-Workloads bauen auf angesammeltem Kontext auf, während ein Agent argumentiert, Tools aufruft und frühere Ergebnisse einbezieht. Bei jedem neuen Schritt sendet der Client den Konversationsverlauf erneut, einschließlich Systemanweisungen, früheren Prompts, Tool-Ergebnissen und Modellantworten, wodurch der wachsende Kontext wiederholt verarbeitet wird. In Prefill-Decode (P-D) Disaggregationwird jede Anfrage auf spezialisierte Knoten aufgeteilt: Der Prefill-Knoten verarbeitet den Prompt und erstellt dessen KV-Cache, dann ruft der Decode-Knoten diese KV-Blöcke ab und generiert die Antwort.
Konventionelles disaggregiertes Serving überträgt den KV-Cache jedoch nur in eine Richtung: vom Prefill- zum Decode-Knoten. Dieser einseitige Fluss erzeugt zwei Ineffizienzen bei Multi-Turn-Workloads. Erstens hält der Decode-Knoten nach dem Generieren einer Antwort KV-Cache-Einträge sowohl für den Prompt als auch für die neu generierten Token. Bei der Verarbeitung des nächsten Schritts kann der Prefill-Knoten diese Einträge nicht abrufen und muss daher die KV-Projektionen für die vorherigen Antwort-Token neu berechnen. Zweitens hält der Decode-Knoten den Sitzungszustand, während die Prefill-Knoten dies nicht tun, was die Wahrscheinlichkeit einer Cache-Verdrängung aktiver Sitzungen auf den Prefill-Knoten erhöht. Bei einem vollständigen Cache-Miss muss der Prefill-Knoten die KV-Projektionen für den gesamten Konversationsverlauf neu berechnen, einschließlich Systemanweisungen, früherer Benutzeranfragen, Tool-Ergebnisse und modellgenerierter Antworten. Mit wachsender Konversation verbraucht diese redundante Arbeit mehr Rechenkapazität und erhöht die Time to First Token (TTFT).
Für Kunden, die Konversationsassistenten und Agentic-Anwendungen entwickeln, können längere Interaktionsverläufe die Latenz erhöhen und durch wiederholte Prefill-Berechnungen Rechenkapazität beanspruchen. In diesem Beitrag zeigen wir, wie bi-direktionale KV-Cache-Übertragung es Prefill- und Decode-Knoten ermöglicht, zuvor berechneten Kontext über Schritte hinweg wiederzuverwenden, wodurch die Auslastung der Beschleuniger verbessert und Anwendungen geholfen wird, eine reaktionsschnelle TTFT bei wachsenden Konversationen aufrechtzuerhalten.
In unseren Multi-Turn-Benchmarks auf einer 1P1D-Bereitstellung mit Amazon EC2 P5en-Instanzen, verbunden mit dem AWS Elastic Fabric Adapter (AWS EFA, dem RDMA-Netzwerk mit geringer Latenz, das in AWS serverübergreifend eingesetzt wird), reduzierte die bi-direktionale KV-Übertragung die TTFT um bis zu 1,6-fach für Qwen3-32B und um bis zu 3,3-fach für zai-org/GLM-5-FP8 (siehe Abschnitt Performance-Daten ); die Ergebnisse hängen von Workload und Konfiguration ab.
Wir haben die Funktion ursprünglich auf AWS Trainium-Instanzclustern, verbunden mit EFA, entwickelt und validiert und als beschleunigeragnostische Funktion zu vLLM beigetragen. Die hier präsentierten Ergebnisse stammen aus einem Amazon EC2 P5en-GPU-Cluster mit EFA und zeigen, dass die Vorteile auch auf GPUs übertragbar sind. Dieser Beitrag erläutert die Architektur der bi-direktionalen Übertragung, den Router-Metadatenfluss, die KV-Block-Rückhaltungs- und Neuberechnungssteuerung, die Leistungsergebnisse und wie man das Benchmark reproduziert.
Bi-direktionale KV-Übertragung
Die bi-direktionale KV-Übertragung ist ein Mechanismus, der es einem Decode-Knoten ermöglicht, in nachfolgenden Schritten einer Konversation zuvor berechnete KV an einen Prefill-Knoten zurückzugeben, wodurch eine Neuberechnung des geteilten Kontexts auf dem Prefill-Knoten vermieden wird, gesteuert durch einen konfigurierbaren KV-Recompute-Schwellenwert. Dies mindert beide zuvor beschriebenen Szenarien rechnerischer Redundanz, und dessen Umsetzung erfordert, dass die KV den Schritt, der sie erzeugt hat, überdauert und in die Gegenrichtung übertragen wird, koordiniert durch einen KV-Cache-bewussten Router.
NIXL-KV-Connector-Erweiterungen für bi-direktionale Übertragung
Wir haben den NVIDIA Inference Xfer Library (NIXL) KV-Connector erweitert, damit Prefill-Knoten entfernte KV-Blöcke konsumieren können, ähnlich wie Decode-Knoten bereits KV-Blöcke konsumieren, die der Prefill-Knoten bereitstellt. Dies ist keine triviale Änderung, da die beiden Knotentypen architektonisch unterschiedlich sind: Prefill-Knoten berechnen KV-Repräsentationen für neue Prompt-Token und können vollständige Prompt-KV-Blöcke bereitstellen. Decode-Knoten verfügen nicht über die Fähigkeit (oder Effizienz), vollständige KV-Repräsentationen zu erzeugen, und können nur zuvor zwischengespeicherte KV-Blöcke bereitstellen. Infolgedessen behalten Prefill- und Decode-Knoten weiterhin ihre eigenen Rollen und Logiken zur Berechnung der Metadaten entfernter und lokaler KV-Blöcke. Der eigentliche KV-Übertragungsmechanismus (ein NIXL READ) ist jedoch für beide Richtungen, P->D und D->P , gemeinsam.
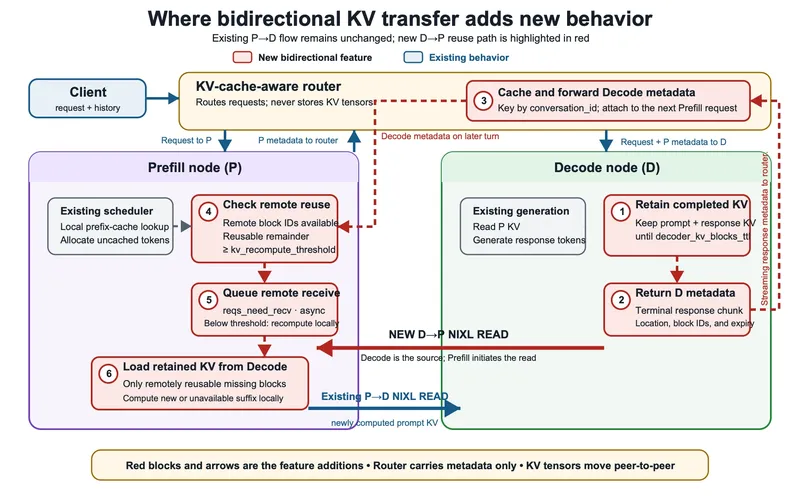
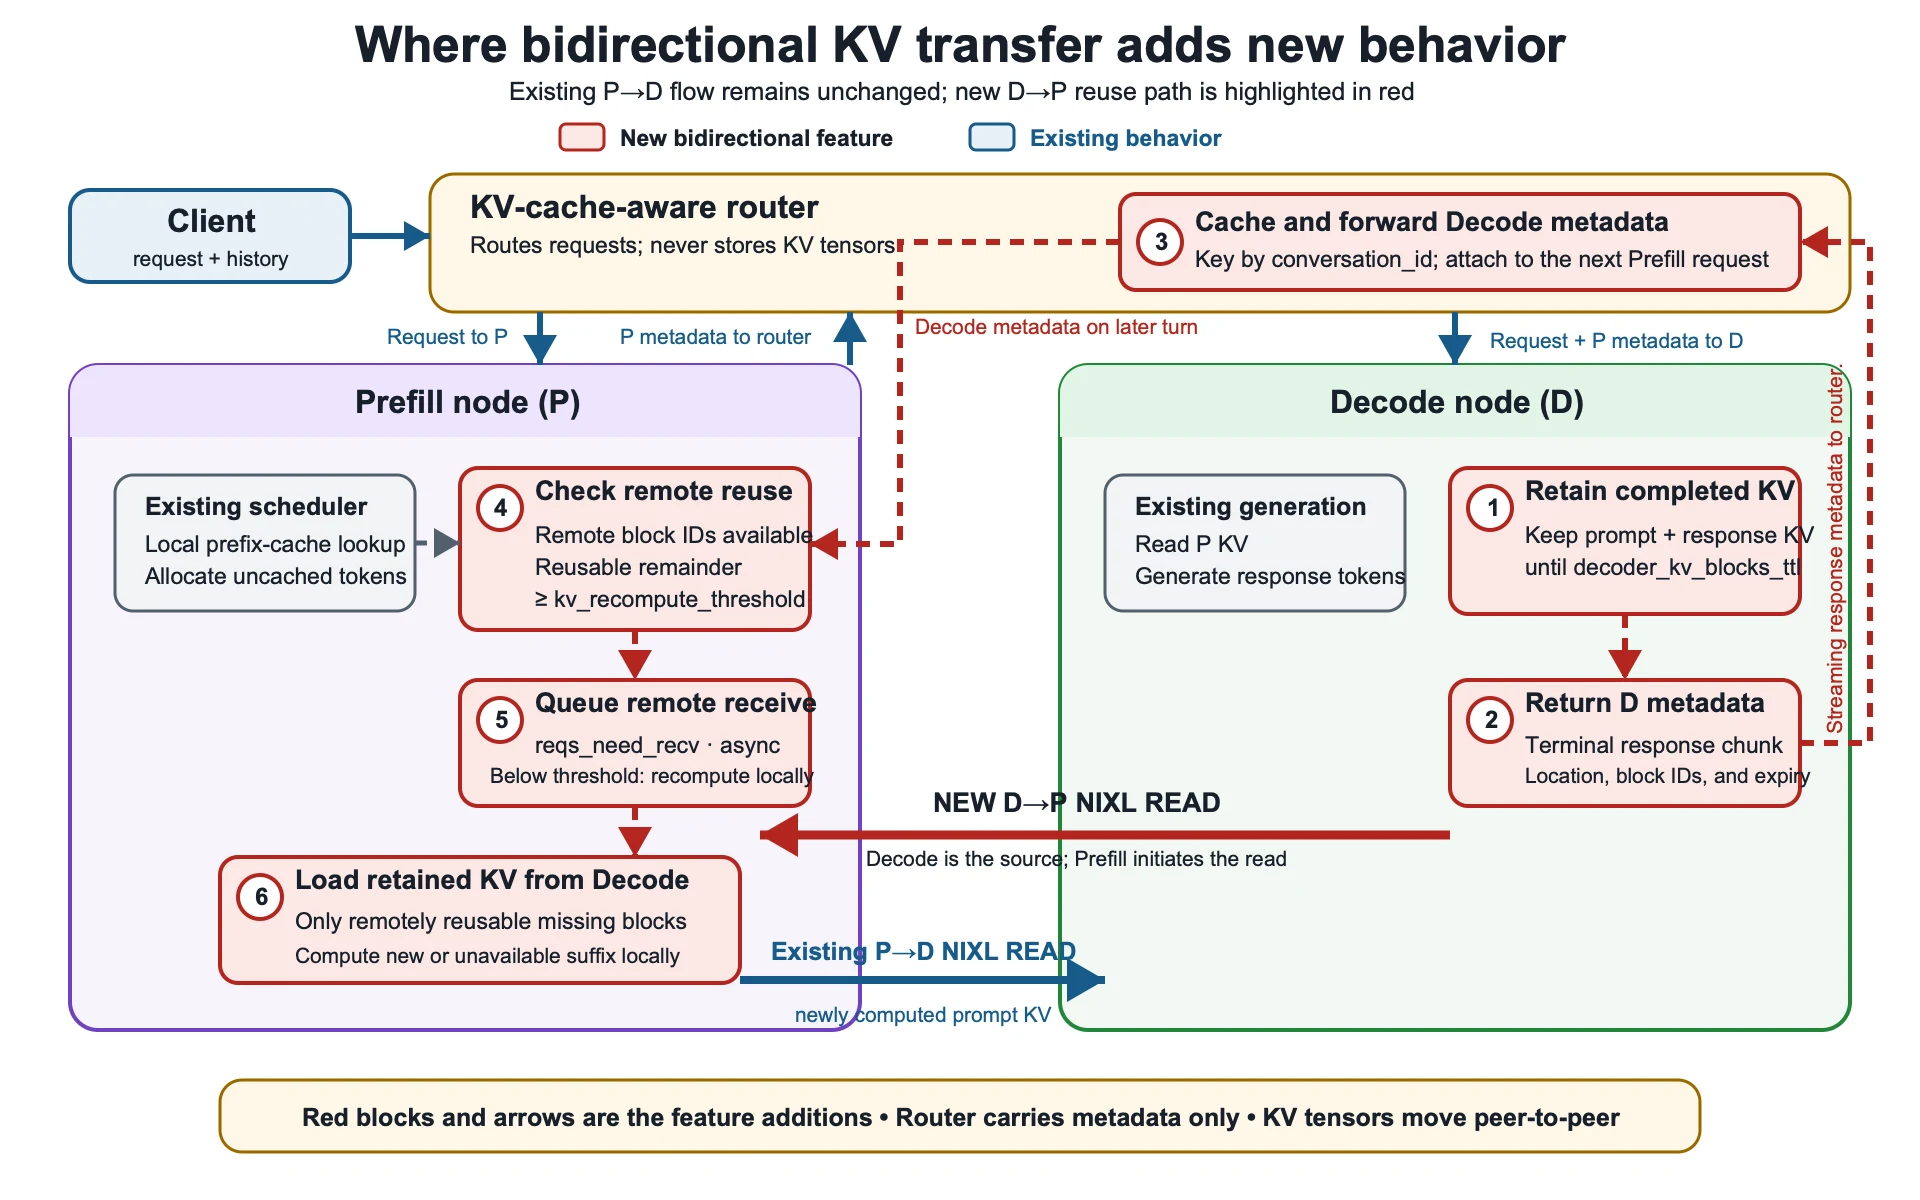
Das folgende Diagramm zeigt zuerst den bestehenden Fluss in Blau: Der Router sendet die Anfrage an den Prefill-Knoten, der Prefill-Knoten berechnet den Prompt-KV und gibt dessen Blockmetadaten zurück, und der Router leitet die Anfrage und Metadaten an den Decode-Knoten für den standardmäßigen P→D NIXL READ weiter. Der nummerierte rote Pfad veranschaulicht die Ergänzungen der bi-direktionalen KV-Übertragung: (1) Der Decode-Knoten behält qualifizierte KV-Blöcke nach der Generierung bei, (2) gibt deren Metadaten in der Streaming-Antwort zurück, und (3) der Router speichert diese Metadaten für die nächste Prefill-Anfrage im Cache. Der Prefill-Knoten (4) prüft die remote wiederverwendbaren KV, nachdem er lokale Cache-Treffer angewendet hat, (5) stellt eine asynchrone Empfangsoperation in die Warteschlange, wenn die wiederverwendbare Token-Anzahl den Schwellenwert erreicht, und (6) führt einen D→P NIXL READ durch, bevor er das verbleibende Suffix berechnet.
KV-Cache-bewusster Router
vLLM enthält Connector-seitige Unterstützung für bidirektionale KV-Übertragung, während die Koordinierung der KV-Wiederverwendung über Gesprächsrunden hinweg einen KV-Cache-bewussten Router erfordert. vLLM GitHub stellt einen Beispiel-Proxy bereit, der den in diesem Beitrag verwendeten Ablauf implementiert und an Ihre Umgebung angepasst werden kann.
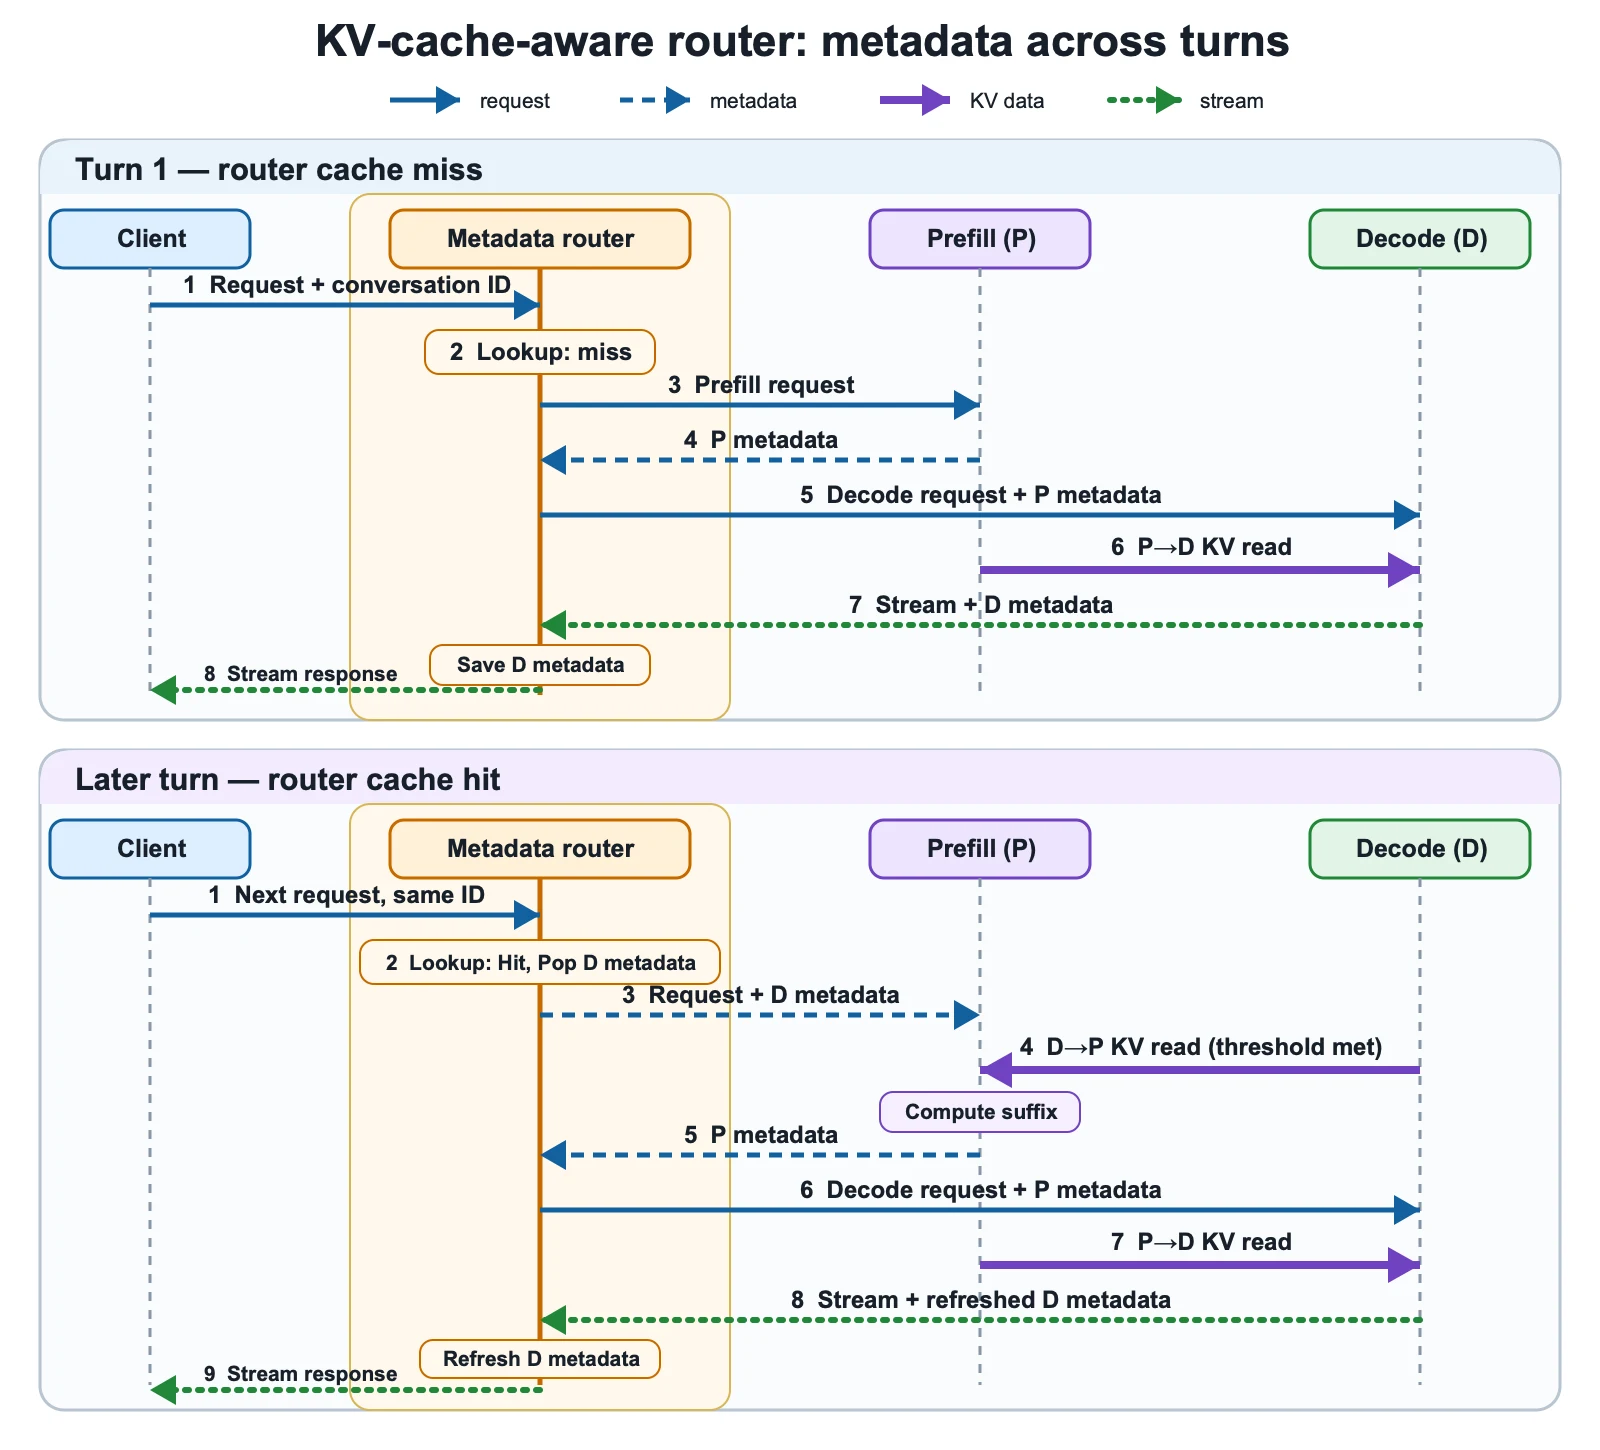
Der KV-Cache-bewusste Router ist eine leichtgewichtige, zustandsbehaftete Control-Plane-Komponente zwischen Client, Prefill- und Decode-Knoten. Er verwaltet eine In-Memory-Zuordnung von dem vom Client bereitgestellten conversation_id zu decode's kv_transfer_params. Der Router speichert nur Blockpositionsmetadaten, keine KV-Tensoren, und bezieht diese Metadaten aus dem Antwortstrom, statt den Decode-Knoten separat abzufragen.
Das folgende Diagramm zeigt, wie der Router KV-Metadaten über Gesprächsrunden hinweg verwaltet. In der ersten Runde verfehlt der Cache-Lookup und die Anfrage folgt dem Standard-P→D-Ablauf; der Router speichert dann decode's Metadaten aus dem Antwortstrom. In späteren Runden ruft der Router diese Metadaten über die conversation_idab, wodurch Prefill KVs aus Decode wiederverwenden kann, und aktualisiert die Metadaten nach der Generierung für die nächste Runde.
Block Retention TTL
Normalerweise gibt eine Decode-Instanz die Blöcke einer Anfrage frei, sobald die Generierung abgeschlossen ist. Im bidirektionalen Modus hält sie sie für eine konfigurierbare Lebensdauer (decoder_kv_blocks_ttl, Standardwert 480 Sekunden) und veröffentlicht deren Position und Ablaufzeit, sodass die KVs der Konversation, sowohl der Prompt-Präfix als auch die generierte Antwort, für die nächste Runde verfügbar bleiben. Für eine Runde, die vor Ablauf der TTL eintrifft, verwendet der Prefill-Knoten die KVs wieder; eine, die später eintrifft, greift auf normales Prefill zurück. Da diese TTL fest ist und nicht erneuert wird, stimmen Sie sie auf die erwartete Zeit zwischen Runden ab, um KV-Wiederverwendung gegen Beschleunigerspeichernutzung abzuwägen. Eine naheliegende nächste Verbesserung wäre, die durch Heartbeat erneuerte Lease auf die Decode-Seite auszuweiten, sodass eine Decode-Instanz Blöcke zurückfordert, sobald eine Konversation inaktiv wird, statt am Ende eines festen Timers.
KV-Recompute-Schwellenwert
Die KV-Wiederverwendung ist nicht immer schneller als die lokale Neuberechnung. Bei einem kurzen wiederverwendbaren Präfix können Interconnect- und Koordinierungsaufwand die Zeit übersteigen, die für die Neuberechnung der Token benötigt wird. Die kv_recompute_threshold Einstellung, die standardmäßig auf 64 Token steht, steuert diese Entscheidung. Der Prefill-Knoten berechnet neu, wenn die zu berechnende Tokenanzahl unter dem Schwellenwert liegt, und zieht KVs vom Decode-Knoten, wenn sie bei oder über dem Schwellenwert liegt. Deployments können diesen Wert basierend auf Modellberechnungszeit, KV-Größe und Interconnect-Leistung anpassen.
Leistungsdaten
Für die Evaluierung verwendeten wir die Modelle Qwen3-32B und GLM-5-FP8 auf einem 1P1D-Deployment mit Amazon EC2 P5en-Instanzen, verbunden über EFA. Um Szenarien zu emulieren, in denen der Prefill-Knoten seinen lokalen Cache evakuiert hat oder der Router einen anderen Prefill-Knoten auswählt, der die KV-Blöcke der Konversation nicht besitzt, deaktivierten wir das Prefix-Caching auf dem Prefill-Knoten mit --no-enable-prefix-caching.
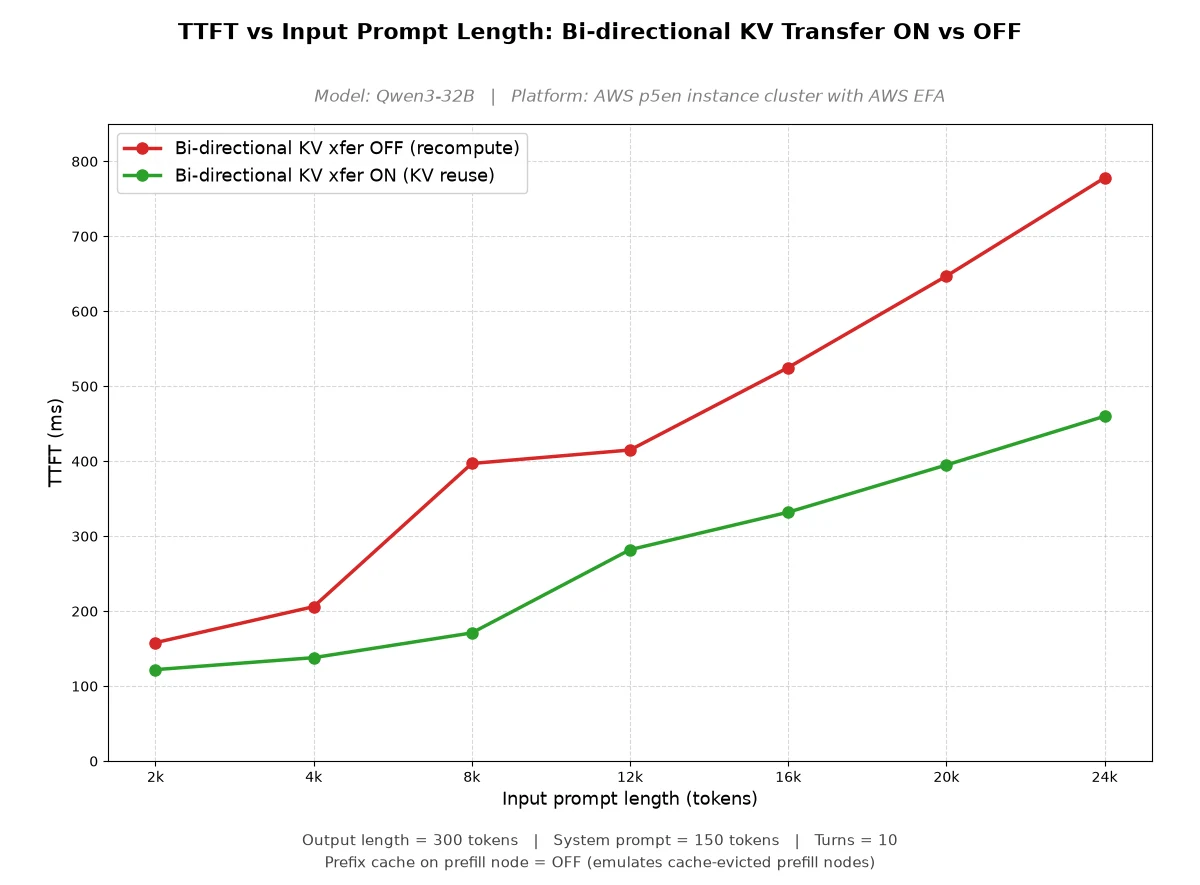
Bei beiden Modellen reduziert die Aktivierung der bidirektionalen KV-Übertragung die Prefill-Berechnung bei Konversationen mit mehreren Runden, und der Vorteil wächst typischerweise mit der Promptlänge. Bei ausgeschaltetem Feature berechnet die Prefill-Instanz bei jeder Runde den gesamten gewachsenen Kontext neu, sodass die TTFT steil ansteigt: Qwen3-32B steigt von 158 ms bei 2k auf 778 ms bei 24k, und GLM-5-FP8 von 500 ms bei 2k auf 2,334 ms bei 20k. Bei eingeschaltetem Feature wird stattdessen die von der Decode-Instanz vorgehaltene KV wiederverwendet statt neu berechnet, wodurch die TTFT deutlich flacher bleibt: Qwen3-32B steigt über denselben Bereich nur von 122 ms auf 460 ms (etwa eine 1.6-fache Reduzierung beim längsten Prompt), während GLM-5-FP8 von 358 ms auf 702 ms steigt und bei langen Prompts bis zu 3.3-fach unter dem Recompute-Pfad bleibt. Die Aufschlüsselung der Prefill-Dauer erklärt warum.
Die bidirektionale Übertragung fügt eine kleine KV-Übertragungszeit hinzu (etwa 30 ms bis 130 ms für Qwen3-32B; etwa 29 ms bis 110 ms für GLM-5-FP8), doch die Prefill-Berechnung, die sie einspart, übersteigt diese KV-Übertragungszeit bei weitem. Infolgedessen bleibt die gesamte Prefill-Dauer mit aktivierter Übertragung (Qwen3-32B: 128 ms bis 414 ms; GLM-5-FP8: 316 ms bis 541 ms) deutlich unter dem reinen-Recompute-Pfad (Qwen3-32B: 153 ms bis 744 ms; GLM-5-FP8: 500 ms bis 2,331 ms). Das größere Modell GLM-5-FP8 zeigt eine größere absolute und relative Lücke, da seine höhere Recompute-Zeit pro Token die KV-Wiederverwendung umso mehr belohnt, je stärker Modelle und Kontexte skalieren.
Qwen3-32B
Das folgende Diagramm stellt den TTFT gegen die Prompt-Länge für Qwen3-32B dar und vergleicht bidirektionale KV-Übertragung EIN versus AUS.
Das nächste Diagramm zerlegt die Prefill-Dauer derselben Läufe in ihre Komponenten Recompute und KV-Übertragung.
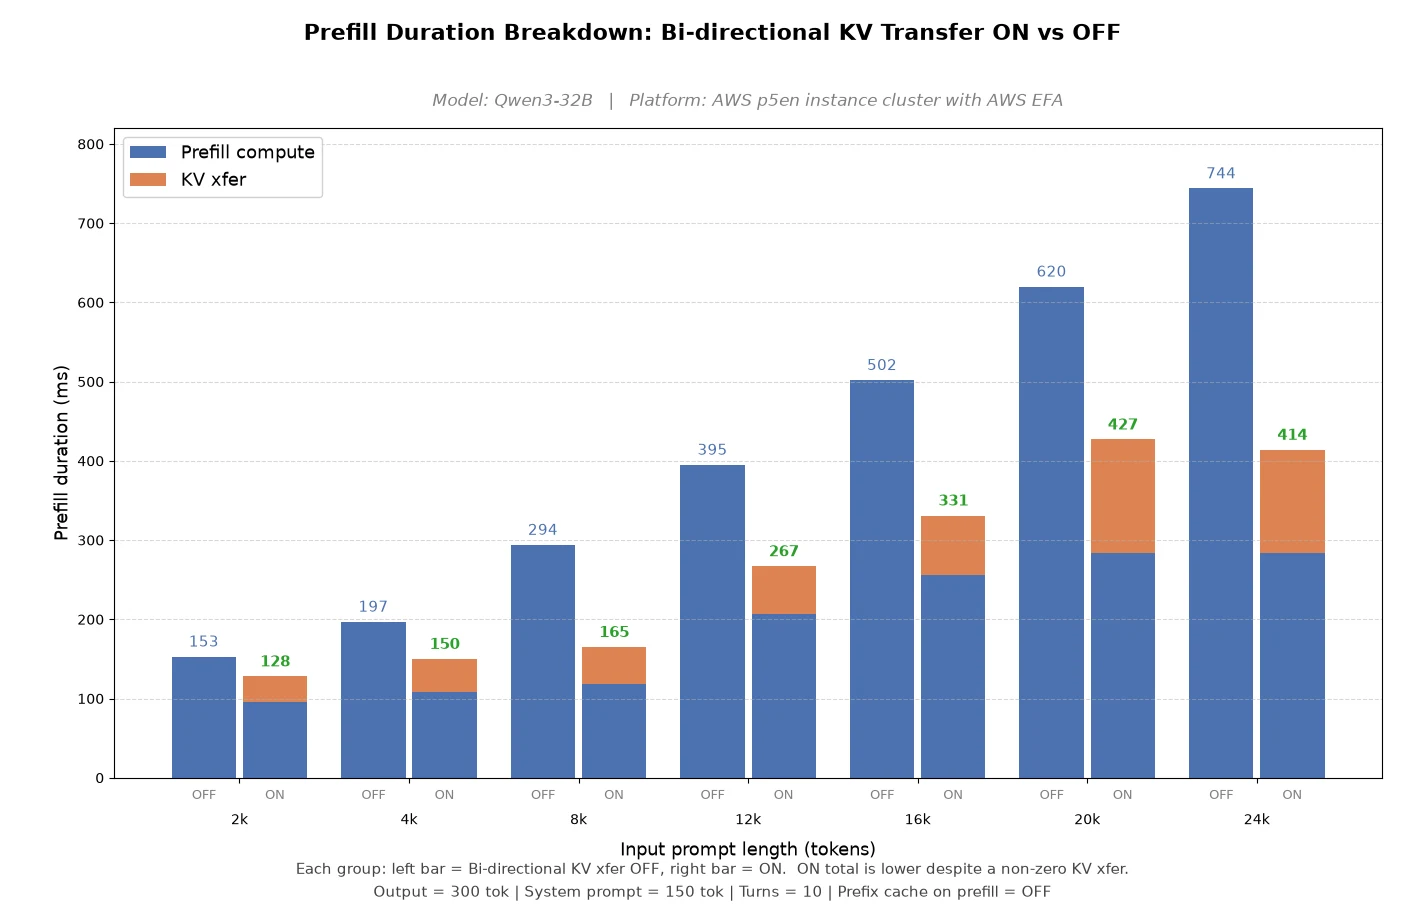
Zusammen zeigen die Diagramme, dass der TTFT bei aktivierter Funktion nahezu flach bleibt, während der Pfad mit deaktivierter Funktion bei wachsendem Kontext steil ansteigt, da die kleine KV-Übertragungszeit durch die eingesparte Recompute-Berechnung bei weitem aufgewogen wird.
zai-org/GLM-5-FP8
Dieselben beiden Ansichten folgen für GLM-5-FP8. Das erste Diagramm stellt den TTFT gegen die Prompt-Länge mit aktivierter versus deaktivierter Funktion dar.
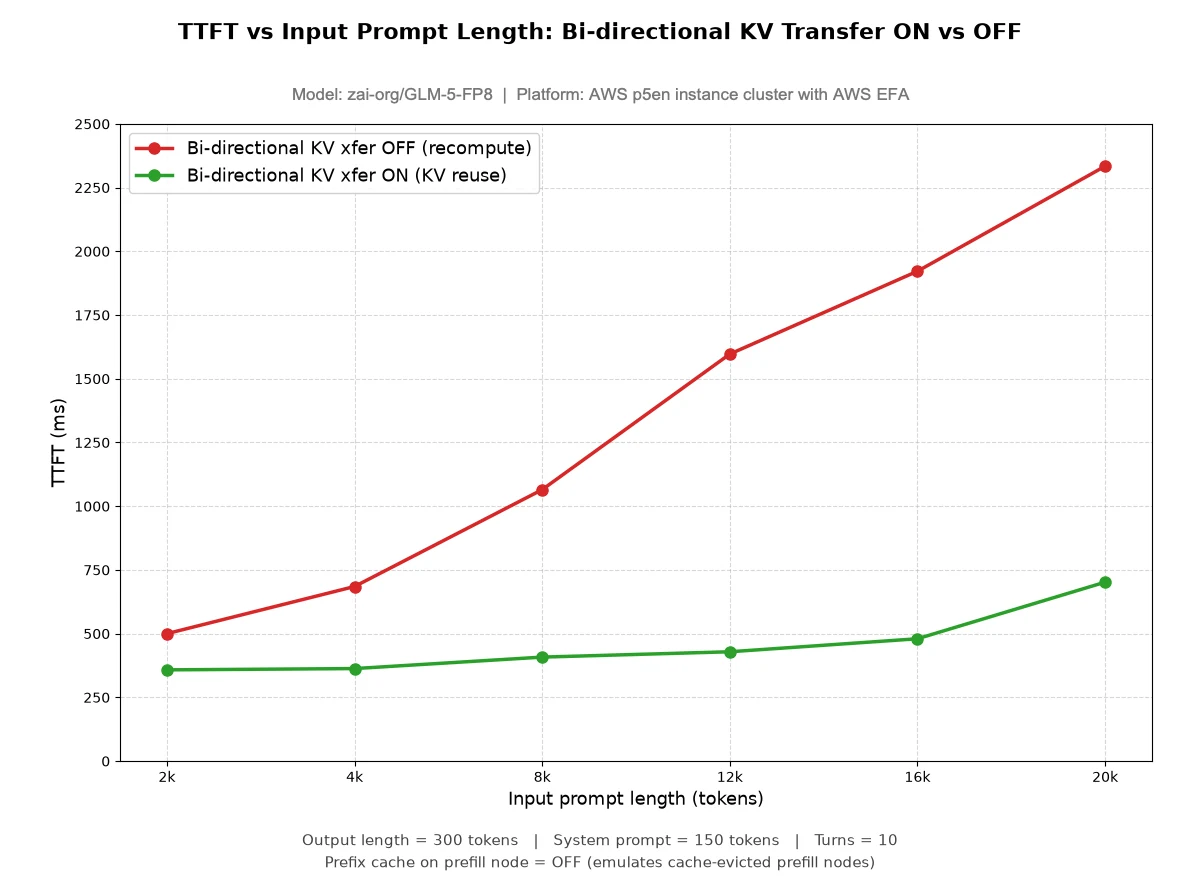
Das zweite Diagramm zerlegt die Prefill-Dauer in ihre Komponenten Recompute und KV-Übertragung.
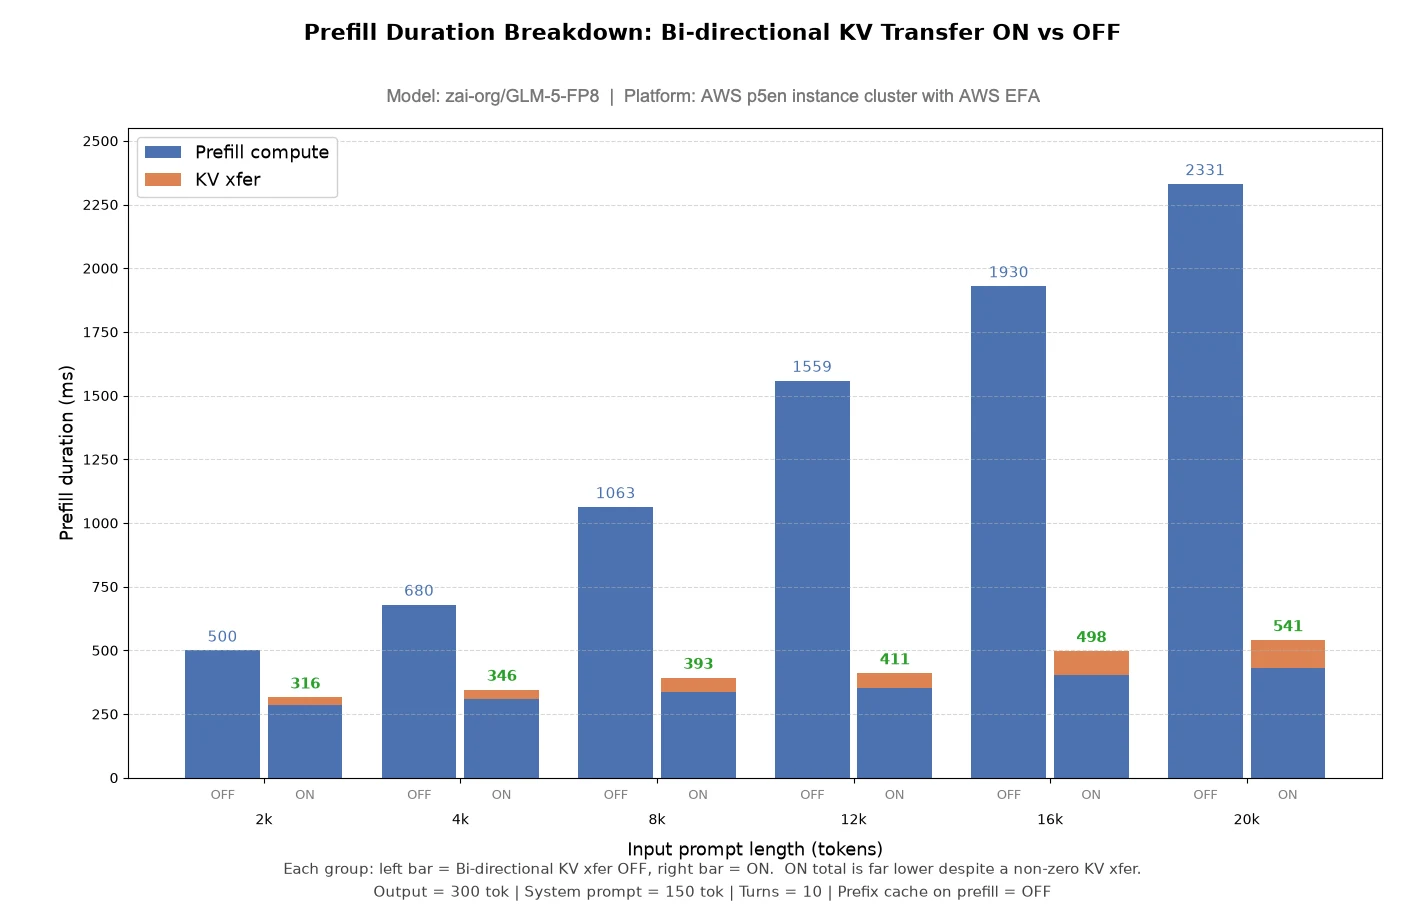
GLM-5-FP8 zeigt eine viel größere Lücke als Qwen3-32B, mit bis zu etwa 3.3x niedrigerem TTFT bei langen Prompts, da seine höhere Recompute-Zeit pro Token die KV-Wiederverwendung umso mehr belohnt, je mehr die Kontextlänge wächst.
Benchmark ausführen
Um unsere 1P1D-Benchmark-Konfiguration – ein Prefill-Knoten und ein Decode-Knoten – mit Amazon EC2 P5en-Instanzen mit EFA zu reproduzieren, folgen Sie den Schritt-für-Schritt-Anleitungen im Reproducing our results Leitfaden unten. Der Leitfaden behandelt die Einrichtung der Umgebung, das Starten der vLLM-Prefill- und Decode-Server, das Ausführen des Benchmarks und das Sammeln der Ergebnisse. Die Funktion kann auf anderen unterstützten Konfigurationen laufen, aber die Leistungsergebnisse variieren je nach Hardware, Modell, Workload und Netzwerkkonfiguration.
Fazit
In diesem Beitrag haben wir gezeigt, wie die bidirektionale KV-Cache-Übertragung den TTFT reduzieren kann, wenn der Konversationsverlauf eines Agenten wächst. In P-D-disaggregierten Bereitstellungen ermöglicht die Funktion dem Prefill-Knoten, die vom Decode-Knoten über mehrere Runden hinweg vorgehaltenen KV-Blöcke wiederzuverwenden, wodurch wiederholte Berechnungen reduziert werden. Konfigurierbare Block-Retention- und Recompute-Schwellenwerte bestimmen, wann die Wiederverwendung erfolgt. Bei einer 1P1D-Bereitstellung mit Amazon EC2 P5en-Instanzen, die über EFA verbunden sind, beobachteten wir bei den längsten getesteten Prompt-Längen TTFT-Reduktionen von 1.6x für Qwen3-32B und 3.3x für zai-org/GLM-5-FP8; die Ergebnisse hängen vom Workload und der Bereitstellungskonfiguration ab. Um dies in Ihrer Umgebung umzusetzen, verwenden Sie vLLM v0.21.0 oder höher mit NixlConnector, aktivieren bidirectional_kv_xfer sowohl auf den Prefill- als auch auf den Decode-Servern, verwenden Sie einen KV-cache-bewussten Router und folgen Sie dem Reproduktionsleitfaden.
Verwandte Ressourcen
- AWS EFA
- Prefill-Decode (P-D) disaggregiertes Serving
- Benchmark KV Cache Offloading with Multi-Turn Conversations
Danksagungen
Wir danken Nicolò Lucchesi (Mistral), Mark McLoughlin (Red Hat) und der vLLM-Community für ihre Unterstützung bei der Pflege dieser Funktion.
Anhang: Reproducing our results
Die Topologie besteht aus zwei AWS-p5en-Instanzen (Prefill auf :8100, Decode auf :8200) mit aktiviertem EFA, sowie einem dritten kleinen Knoten, auf dem der Proxy und der Benchmark-Client auf :8000.
Mit diesem Beitrag werden drei Skripte mitgeliefert: serve_pd_multiturn.sh startet entweder Leg mit aktivierter oder deaktivierter Funktion, run_multiturn_sweep.sh steuert den Durchlauf der Prompt-Längen-Sweep, und cleanup.sh nimmt die Bereitstellung zurück.
Testumgebung
Beide GPU-Knoten wurden identisch konfiguriert:
| Instanztyp | p5en.48xlarge (8x NVIDIA H200), einer für Prefill und einer für Decode |
| Region / AZ | ap-south-1 (Mumbai), ap-south-1b (AZ ID aps1-az3), beide Knoten in derselben AZ |
| Platzierung | Keine Cluster-Platzierungsgruppe; beide Instanzen wurden in eine gezielte On-Demand Capacity Reservation mit Standard-Tenancy gestartet. |
| AMI | Öffentliches AWS ParallelCluster 3.14.2-Image für Ubuntu 24.04 x86_64, aws-parallelcluster-3.14.2-ubuntu-2404-lts-hvm-x86_64-202602121713 (ami-0133f195033a4baae in ap-south-1; AMI-IDs unterscheiden sich je nach Region). Es wird mit Kernel ausgeliefert 6.14.0-1018-aws, NVIDIA-Treiber 570 und CUDA 12.8 vor; aktualisieren Sie daher Treiber, CUDA-Toolkit und EFA-Installer auf die unten angegebenen Versionen. |
| Betriebssystem / Kernel | Ubuntu 24.04.4 LTS, 6.14.0-1018-aws |
| NVIDIA-Treiber / CUDA | Treiber 580.126.16 (CUDA 13.0 driver API); CUDA-Toolkit 13.0 |
| EFA-Schnittstellen | 16 pro Instanz, eine pro Netzwerkkarte (Karten 0-15, alle vom Schnittstellentyp efa), jeweils 200 Gb/s, insgesamt 3.2 Tb/s. 8 Schnittstellen sitzen auf jedem NUMA-Knoten, und jede GPU teilt sich einen PCIe-Switch mit 2 davon. |
| EFA-Software | EFA-Installer 1.50.0, EFA-Kernelmodul 3.3.0g, libfabric 2.6.0amzn1.0, rdma-core 64.0amzn0 |
EFA-Geräteauswahl durch NIXL. Das LIBFABRIC-Backend öffnet alle 16 EFA-Geräte als Rails mit dem efa -Provider. Anschließend registriert es den KV-Cache jeder GPU nur auf den 2 Rails, die sich den PCIe-Switch dieser GPU teilen, sodass jede Übertragung PCIe-lokal bleibt. Es wurden keine NIXL- oder libfabric-Geräte-Overrides gesetzt; dies ist die Standardauswahl. Um dies auf Ihren eigenen Knoten zu bestätigen, starten Sie die Server mit NIXL_LOG_LEVEL=DEBUG und prüfen Sie die Registrierungszeilen:
grep -E "Created rail [0-9]+ \(device=|mapped to rail" server.log1. Knoten bereitstellen
Installieren Sie den EFA-Userspace-Stack auf beiden GPU-Knoten und bestätigen Sie, dass der Provider vorhanden ist. Wir verwendeten Installer 1.50.0:
curl -O https://efa-installer.amazonaws.com/aws-efa-installer-1.50.0.tar.gz
tar -xf aws-efa-installer-1.50.0.tar.gz && cd aws-efa-installer
sudo ./efa_installer.sh -y
fi_info --version         # libfabric 2.6.0amzn1.0
fi_info -p efa -t FI_EP_RDM            # verify the EFA provider is present on both GPU nodes
2. vLLM und NIXL auf beiden GPU-Knoten installieren
python3 -m venv ~/venv-pd && source ~/venv-pd/bin/activate
pip install --upgrade pip && pip install vllm==0.29.0 nixl==1.4.1
Wenden Sie vLLM PR #40186 einmal auf beiden Knoten an. Es hängt kv_transfer_params an Streaming -Antworten, was der Multi-Turn-Proxy benötigt, um Turns zu verknüpfen: Der Proxy fragt den Decode-Knoten immer mit stream=True, sodass ohne diesen Patch der Decode-Knoten nie die Block-Metadaten zurückgibt und jeder Turn als Cache-Miss landet.
SITE=$(python -c 'import site; print(site.getsitepackages()[0])')
curl -sL https://github.com/vllm-project/vllm/pull/40186.diff -o /tmp/40186.diff
patch -p1 -d "$SITE" --fuzz=3 < /tmp/40186.diff
3. Modell herunterladen
export HF_HOME=/fsx/huggingface        # a large shared volume
hf download Qwen/Qwen3-32B
4. Das P/D-Paar starten
Ausführen serve_pd_multiturn.sh einmal pro GPU-Knoten. BIDIR ist das Einzige, was sich zwischen den beiden Durchläufen des A/B-Tests ändert, und es muss auf beiden Knoten übereinstimmen:
# on the prefill node
P_IP=<P_IP> D_IP=<D_IP> ROLE=prefill BIDIR=false ./serve_pd_multiturn.sh
# on the decode node
P_IP=<P_IP> D_IP=<D_IP> ROLE=decode  BIDIR=false ./serve_pd_multiturn.sh
Was sich auf der Prefill-Seite ausklappt zu:
export FI_PROVIDER=efa
export VLLM_NIXL_SIDE_CHANNEL_HOST=<P_IP> VLLM_NIXL_SIDE_CHANNEL_PORT=5600
vllm serve Qwen/Qwen3-32B --served-model-name Qwen --dtype bfloat16 \
  --tensor-parallel-size 8 --max-model-len 32768 --max-num-seqs 8 \
  --no-enable-prefix-caching --port 8100 \
  --kv-transfer-config '{"kv_connector":"NixlConnector","kv_buffer_device":"cuda",
    "kv_role":"kv_producer","engine_id":"prefill-engine-001","kv_rank":0,
    "kv_parallel_size":2,"kv_connector_extra_config":{"backends":["LIBFABRIC"],
    "kv_recompute_threshold":64,"decoder_kv_blocks_ttl":480,
    "bidirectional_kv_xfer":false}}'
--no-enable-prefix-caching wird nur auf dem Prefill-Knoten gesetzt — das ist das Cache-Eviction-Szenario, das der Benchmark emuliert. Lassen Sie Prefix-Caching auf dem Decode-Knoten aktiviert. Warten Sie, bis beide /health endpoints den Status 200 zurückgeben.
5. Den Multi-Turn-Proxy starten
python3 -m venv ~/venv-proxy && source ~/venv-proxy/bin/activate
pip install fastapi uvicorn httpx pandas numpy aiohttp transformers tqdm
sudo dnf install -y jq || sudo apt-get install -y jq
git clone --depth 1 --branch v0.29.0 https://github.com/vllm-project/vllm.git ~/vllm_src
export VLLM_SRC=~/vllm_src

python3 $VLLM_SRC/examples/disaggregated/disaggregated_serving/disagg_proxy_multiturn.py \
  --port 8000 --prefiller-host <P_IP> --prefiller-ports 8100 \
  --decoder-hosts <D_IP> --decoder-ports 8200 \
  2>&1 | tee ~/proxy_$(date +%Y%m%d_%H%M%S).log
Der Proxy nimmt Hosts und Ports entgegen, keine URLs. Die Wiederverwendung wird gesteuert, indem der Client conversation_idsendet, daher gibt es hier kein Flag zum Aktivieren.
6. Den OFF-Durchlauf ausführen, dann den ON-Durchlauf
VLLM_SRC=~/vllm_src LEG=off ./run_multiturn_sweep.shFür den ON-Durchlauf stoppen Sie beide Server und den Proxy, starten Schritt 4 neu mit BIDIR=true auf jedem Knoten, starten den Proxy neu (sein Conversation-Cache liegt im Prozess), und dann:
VLLM_SRC=~/vllm_src LEG=on ./run_multiturn_sweep.shWiederholen Sie beide Durchläufe für GLM-5-FP8 mit MODEL=zai-org/GLM-5-FP8 SERVED_NAME=GLM.
7. Die Zahlen erfassen
Drei Größen, eine pro Quelle:
- TTFT, aus der per-request stats JSON des Benchmarks, geschrieben von
--stats-json-output. Jeder Datensatz enthältttft_mszusammen mitinput_num_tokensundconversation_id. Dies ist die y-Achse der TTFT-Diagramme. - Prefill-Dauer, aus dem Proxy-Log, das den Prefill-Teil jeder Anfrage als
Prefill done in <N>msausweist. Dies ist die Gesamthöhe jedes Balkens in der Prefill-Duration-Aufschlüsselung. - KV-Transferzeit und -volumen, aus dem Log des Prefill-Knotens, der
KV Transfer metrics:Zeilen mit durchschnittlicher und P90-Transferzeit, Bytes pro Transfer und Durchsatz meldet. Dies ist die KV-xfer-Komponente jedes ON-Balkens.
NIXL-Telemetrie wird von der Seite aufgezeichnet, die die Übertragung initiiert, daher erscheint der D->P-Readback im Log des Prefill-Knotens, während der normale P->D-Pull im Log des Decode-Knotens erscheint.
Mitteln Sie jede Größe pro Prompt-Länge und tragen Sie dann auf: TTFT gegen die Prompt-Länge als zwei Linien (ON und OFF) sowie die Prefill-Dauer als gepaarte gestapelte Balken pro Prompt-Länge, wobei der ON-Balken in Prefill-Compute und KV-Transfer aufgeteilt ist. Der Unterschied zwischen den beiden Ansichten ist der Punkt — die Übertragungskosten, die die Balken offenlegen, sind das, was die TTFT-Linien in eine Einsparung umsetzen.
Fehlerbehebung
- Der Proxy protokolliert immer
cache MISSin einem ON-Lauf — fehlt--send-conversation-id, wurde PR #40186 nicht auf beiden Knoten angewendet, oderBIDIR=falseauf dem Decode-Knoten belassen, in welchem Fall er gar keinekv_transfer_paramszurückgibt. Declining expired remote readauf dem Prefill-Knoten — die Blöcke des Decode-Knotens sind abgelaufen, bevor der nächste Turn eintraf. Erhöhen Siedecoder_kv_blocks_ttl(Standard 480 s) und halten Sie die Cache-TTL des Proxys darunter.fi_info -p efaist leer oder fällt auf Sockets zurück — der EFA-Provider fehlt. Installieren Sieaws-efa-installerneu und bestätigen Sie, dass die Instanzen mit EFA-fähigen Schnittstellen gestartet wurden; ohne sie schlägt die Initialisierung von NIXL entweder fehl oder es läuft still über TCP, was die Transferzahlen bedeutungslos macht.
Aufräumen
./cleanup.sh proxy      # on the proxy / benchmark driver node
./cleanup.sh server     # on each GPU node
Beenden Sie dann die Instanzen und überprüfen Sie, dass keine mehr ausgeführt wird.