
Muse Wonder und Muse Wonder Full: ein materieller Sprung in der Intelligenz gegenüber früheren Meta-Modellen
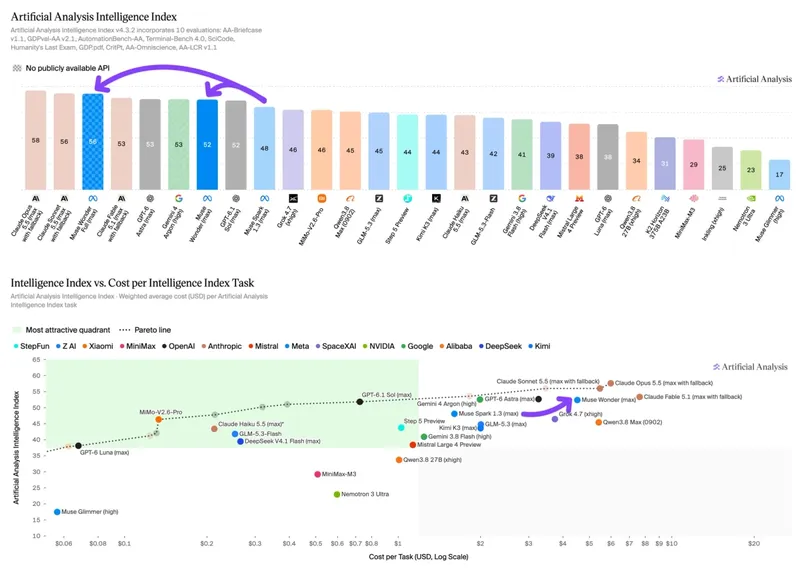
Modellseite ansehenMeta hat Muse Wonder und Muse Wonder Full veröffentlicht und erreicht damit im Artificial Analysis Intelligence Index v4.3 Punkte von 52 und 56 bei maximaler Reasoning-Anstrengung – jeweils ein materieller Zugewinn gegenüber Muse Spark 1.3 (max) mit 48, bei einem Veröffentlichungsabstand von nur 6 Wochen
Muse Wonder ist für Nutzer über Metas First-Party-API verfügbar, während Muse Wonder Full derzeit nur für Muse-Code-Nutzer verfügbar ist. Meta weist darauf hin, dass jedes Modell für den persönlichen und beruflichen Agenteneinsatz konzipiert ist
Wichtigste Erkenntnisse:
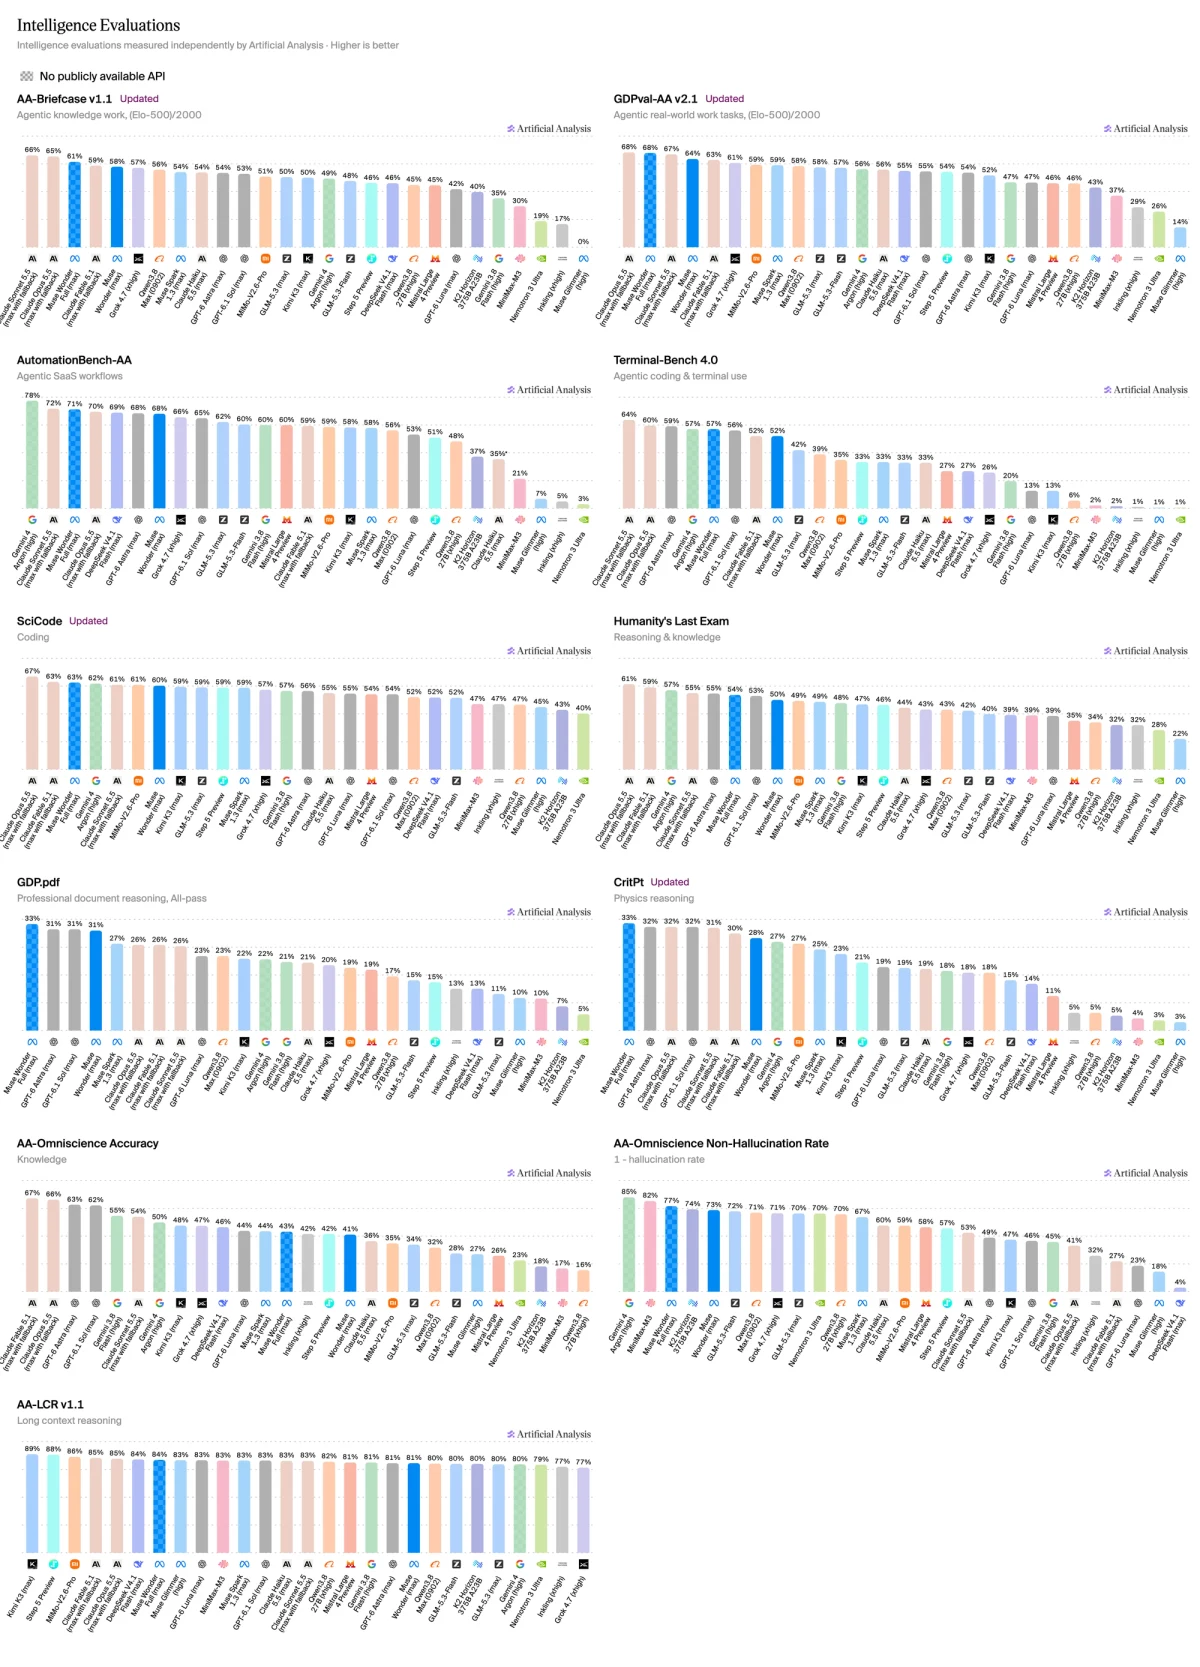
➤ Beide Modelle zeigen einen materiellen Sprung im gesamten Intelligence-Index-Score. Muse Wonder Full (max) verbessert sich gegenüber Muse Spark 1.3 (max) in allen zehn Intelligence-Index-Bewertungen und gewinnt 8 Punkte bis auf 56. Die größten Zuwächse wurden bei agentischen Bewertungen erzielt: Terminal-Bench 4.0 (+24 Punkte, 33% auf 57%), GDPval-AA v2.1 (+176 Elo, 1681 auf 1857) und AA-Briefcase (+148 Elo, 1581 auf 1729). Muse Wonder (max) gewinnt 4 Intelligence-Index-Punkte und landet bei 52, mit bemerkenswerten Verbesserungen gegenüber Muse Spark 1.3 (max) bei Terminal-Bench 4.0 (33% auf 52%) und AutomationBench-AA (58% auf 68%)
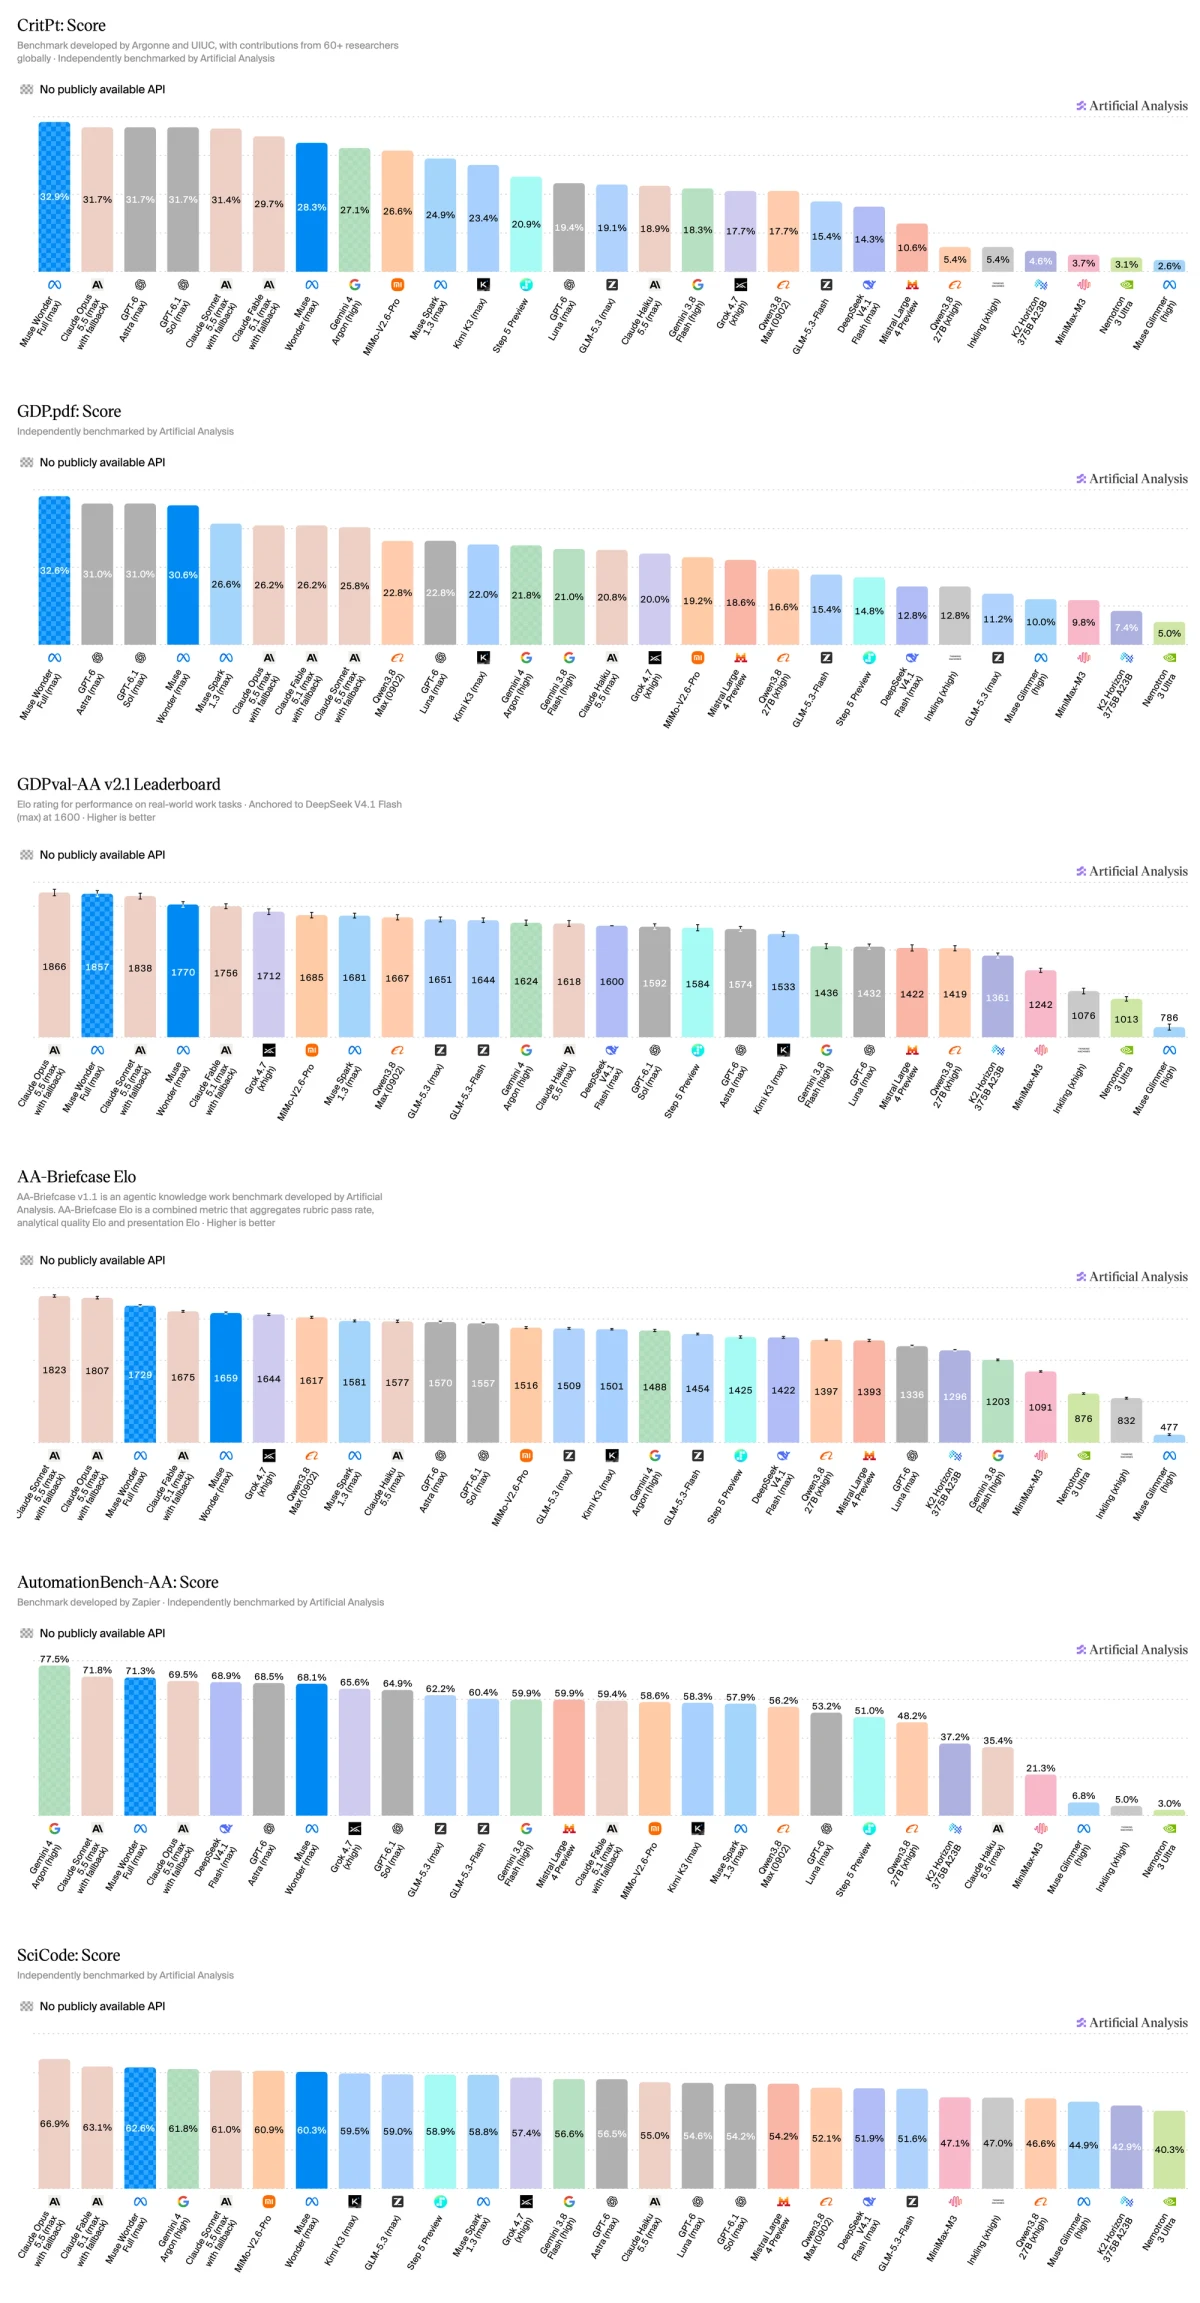
➤ Muse Wonder Full (max) platziert sich bei sechs der zehn Intelligence-Index-Bewertungen in den Top Drei und ist insbesondere bei agentischer Wissensarbeit und wissenschaftlichem Reasoning stark. Bei agentischer Wissensarbeit führt es knapp bei GDP.pdf (33%), belegt Platz #2 bei GDPval-AA v2.1 (1857 Elo) und Platz #3 bei sowohl AA-Briefcase (1729 Elo) als auch AutomationBench-AA (71%). Beim wissenschaftlichen Reasoning führt es die CritPt-Bestenliste mit 33% an und belegt Platz #3 bei SciCode mit 63%. Dies baut auf den relativen Stärken von Muse Spark 1.3 (max) auf, das ebenfalls besondere Fähigkeiten in diesen beiden Bereichen zeigte
➤ Beide Modelle verwenden weniger Output-Token als Muse Spark 1.3 (max). Muse Wonder (max) und Muse Wonder Full (max) verwenden jeweils rund 54k Output-Token pro Intelligence-Index-Aufgabe, etwa 10% weniger als Muse Spark 1.3 (max, 60k). Diese Nutzung ist niedriger als bei ähnlich intelligenten Modellen wie Gemini 4 Argon (high, 62k) und Claude Fable 5.1 (max w/ fallback, 78k), aber höher als bei GPT-6.1 Sol (max, 38k) und GPT-6 Astra (max, 27k). Muse Wonder Full (max) verwendet 16% weniger Input-Token pro Intelligence-Index-Aufgabe als Muse Wonder (max) (6,44M vs. 7,69M), was bedeutet, dass es sowohl intelligenter als auch token-effizienter ist
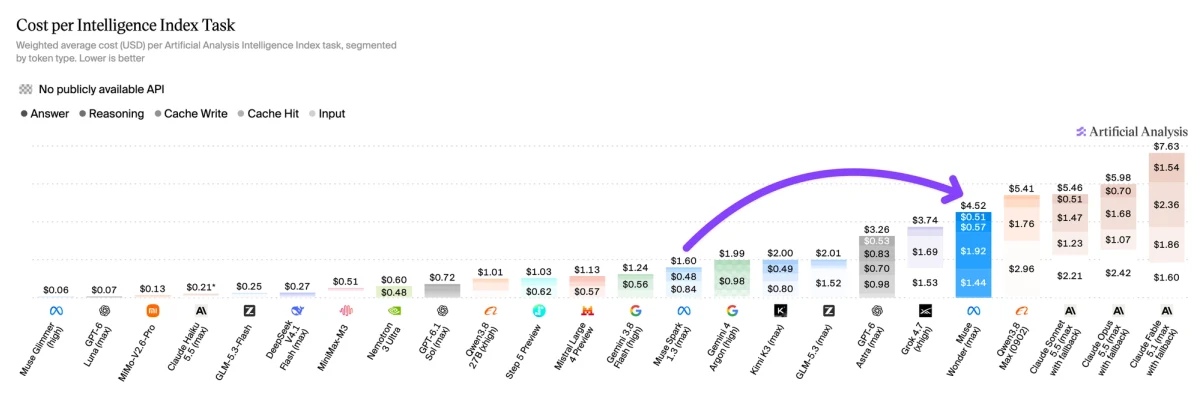
➤ Die Kosten pro Aufgabe für Muse Wonder (max) liegen höher als bei den meisten ähnlich intelligenten Modellen. Trotz effizienter Output-Token-Nutzung treiben Premium-API-Preise ($4 pro Million Input-Token, $20 pro Million Output-Token) und eine hohe Input-Token-Nutzung (7,69M pro Aufgabe) die Kosten von Muse Wonder (max) auf $4,52 pro Intelligence-Index-Aufgabe. Dies ist niedriger als bei Claude Fable 5.1 (max w/ fallback, $7,63), Claude Opus 5.5 (max w/ fallback, $5,98) und Claude Sonnet 5.5 (max w/ fallback, $5,46), aber höher als bei GPT-6 Astra (max, $3,26), Gemini 4 Argon (high, $1,99), GPT-6.1 Sol (max, $0,72) und seinem Vorgänger Muse Spark 1.3 (max, $1,60). Muse Wonder Full wird nicht pro Token bepreist, daher ist keine Kosten-pro-Aufgabe-Zahl verfügbar
➤ Beide Modelle erzielen signifikante Zugewinne bei der Coding-Agent-Leistung. Muse Wonder Full erreicht 68 beim Artificial Analysis Coding Agents Index bei maximaler Anstrengung in Muse Code, neben Claude Code mit Sonnet 5.5 (max, 68) und Opus 5.5 (max, 66). Muse Wonder (max) erzielt 63. Dies sind materielle Zugewinne gegenüber Muse Code mit Muse Spark 1.3 (max), das 54 Punkte erreicht
Weitere Details zu den beiden neuen Modellen:
➤ Kontextfenster: 1M Token jeweils, unverändert gegenüber Muse Spark 1.3
➤ Preise: für Muse Wonder: $4 Input / $0,20 gecachter Input / $20 Output pro 1M Token. Muse Wonder Full wird nicht pro Token bepreist
➤ Input-Modalitäten: Text, Bild, Video und Audio
➤ Output-Modalitäten: Text
➤ Verfügbarkeit: Muse Wonder ist zum Launch über Metas First-Party-API und Muse Code verfügbar, während Muse Wonder Full nur für Muse-Code-Nutzer verfügbar ist
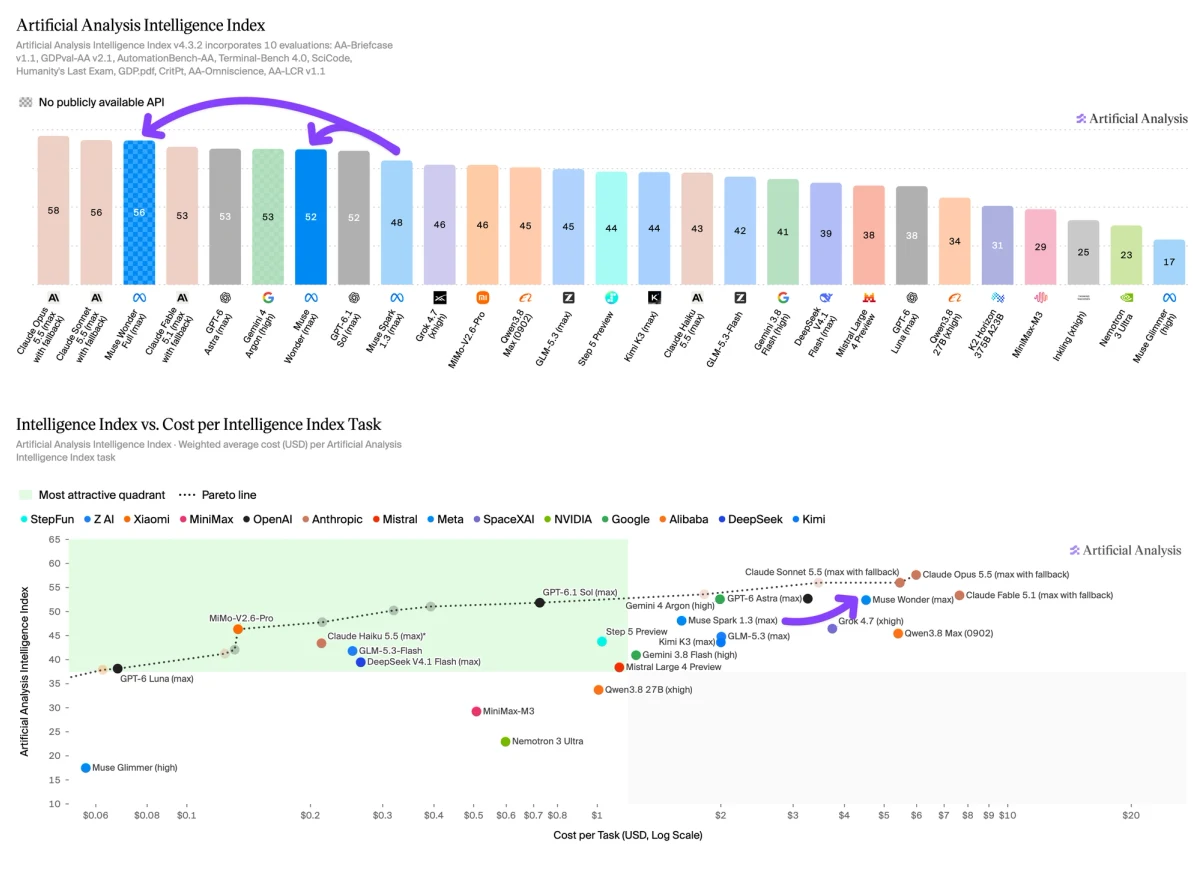
Muse Wonder Full (max) platziert sich bei sechs der zehn Artificial Analysis Intelligence Index v4.3 Bewertungen in den Top Drei:
➤ Platz #1 bei CritPt (33%) und GDP.pdf (33%)
➤ Platz #2 bei GDPval-AA v2.1 (1857 Elo)
➤ Platz #3 bei AA-Briefcase (1729 Elo), AutomationBench-AA (71%) und SciCode (63%)
Die Führung bei CritPt und GDP.pdf ist knapp, die nächstplatzierten Konkurrenten liegen bei 31–32 %. Bei GDPval-AA v2.1 liegt das Ergebnis innerhalb der Konfidenzintervalle von Claude Opus 5.5 (max w/ fallback, 1866) und Claude Sonnet 5.5 (max w/ fallback, 1838)
Sein größter Vorsprung gegenüber Muse Spark 1.3 (max) liegt bei Terminal-Bench 4.0: von 33 % auf 57 %, womit es mit Gemini 4 Argon (high) gleichzieht
Muse Wonder (max) kostet $4.52 pro Artificial Analysis Intelligence Index Aufgabe, das 2.8-fache von Muse Spark 1.3 (max, $1.60), verursacht durch höhere Preise pro Token und höhere Nutzung von Eingabetokens
➤ Token-Preise: $4 pro 1M Eingabetokens, $0.20 im Cache und $20 Ausgabe, gegenüber $1.25 / $0.15 / $4.25 bei Muse Spark 1.3. Dies entspricht Claude Opus 5.5, ist jeweils doppelt so hoch wie bei Claude Sonnet 5.5, Gemini 4 Argon und GPT-6.1 Sol ($2/$10) und liegt 60 % unter GPT-6 Astra und Claude Fable 5.1 ($10/$50)
➤ Eingabe: 7.69M Eingabetokens pro Aufgabe, 28 % mehr als Muse Spark 1.3 (max, 6.03M) und das 2–7-fache von Gemini 4 Argon (high), GPT-6.1 Sol (max) und GPT-6 Astra (max). Die Eingabe macht $3.43 (76 %) seiner Kosten pro Aufgabe aus, zusammengesetzt aus $1.92 Cache-Schreibvorgängen, $1.44 Cache-Treffern und $0.07 nicht zwischengespeicherter Eingabe
➤ Ausgabe: etwa 54k Ausgabetokens pro Aufgabe ($1.08), 10 % weniger als Muse Spark 1.3 (max, 60k)
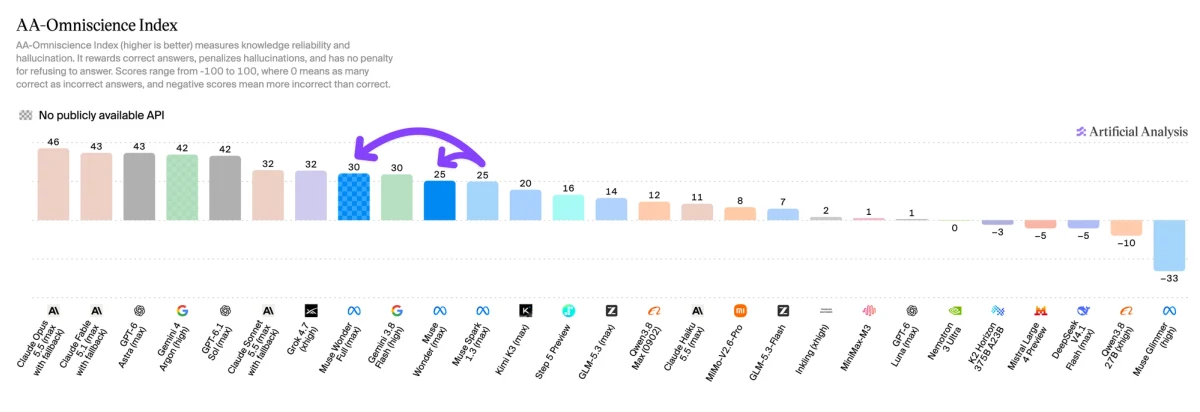
Wissen bleibt bei beiden Modellen eine relative Schwäche, was jedoch durch sehr niedrige Halluzinationsraten abgemildert wird. Bei AA-Omniscience erzielt Muse Wonder Full (max) 30 Punkte und Muse Wonder (max) 25 Punkte, gleichauf mit Muse Spark 1.3 (max), unterhalb von Claude Opus 5.5 (46), GPT-6 Astra (43), Gemini 4 Argon (42) und Claude Sonnet 5.5 (32)
Der 5-Punkte-Gewinn von Muse Wonder Full (max) ergibt sich aus der Senkung seiner Halluzinationsrate (von 33% auf 23%), wodurch es zu den Modellen mit den niedrigsten Halluzinationsraten im Test gehört: Es hat die zweitniedrigste Halluzinationsrate aller Modelle, die 45 oder mehr Punkte im Intelligence Index erreichen, hinter nur Gemini 4 Argon (high, 15%). Muse Wonder (max) liegt mit 27% auf dem dritten Platz
Vollständige Ergebnisse des Artificial Analysis Intelligence Index für Muse Wonder Full (max) und Muse Wonder (max):
Vergleichen Sie Muse Wonder Full (max) und Muse Wonder (max) mit anderen führenden Modellen unter: https://artificialanalysis.ai/models/muse-wonder-full und https://artificialanalysis.ai/models/muse-wonder