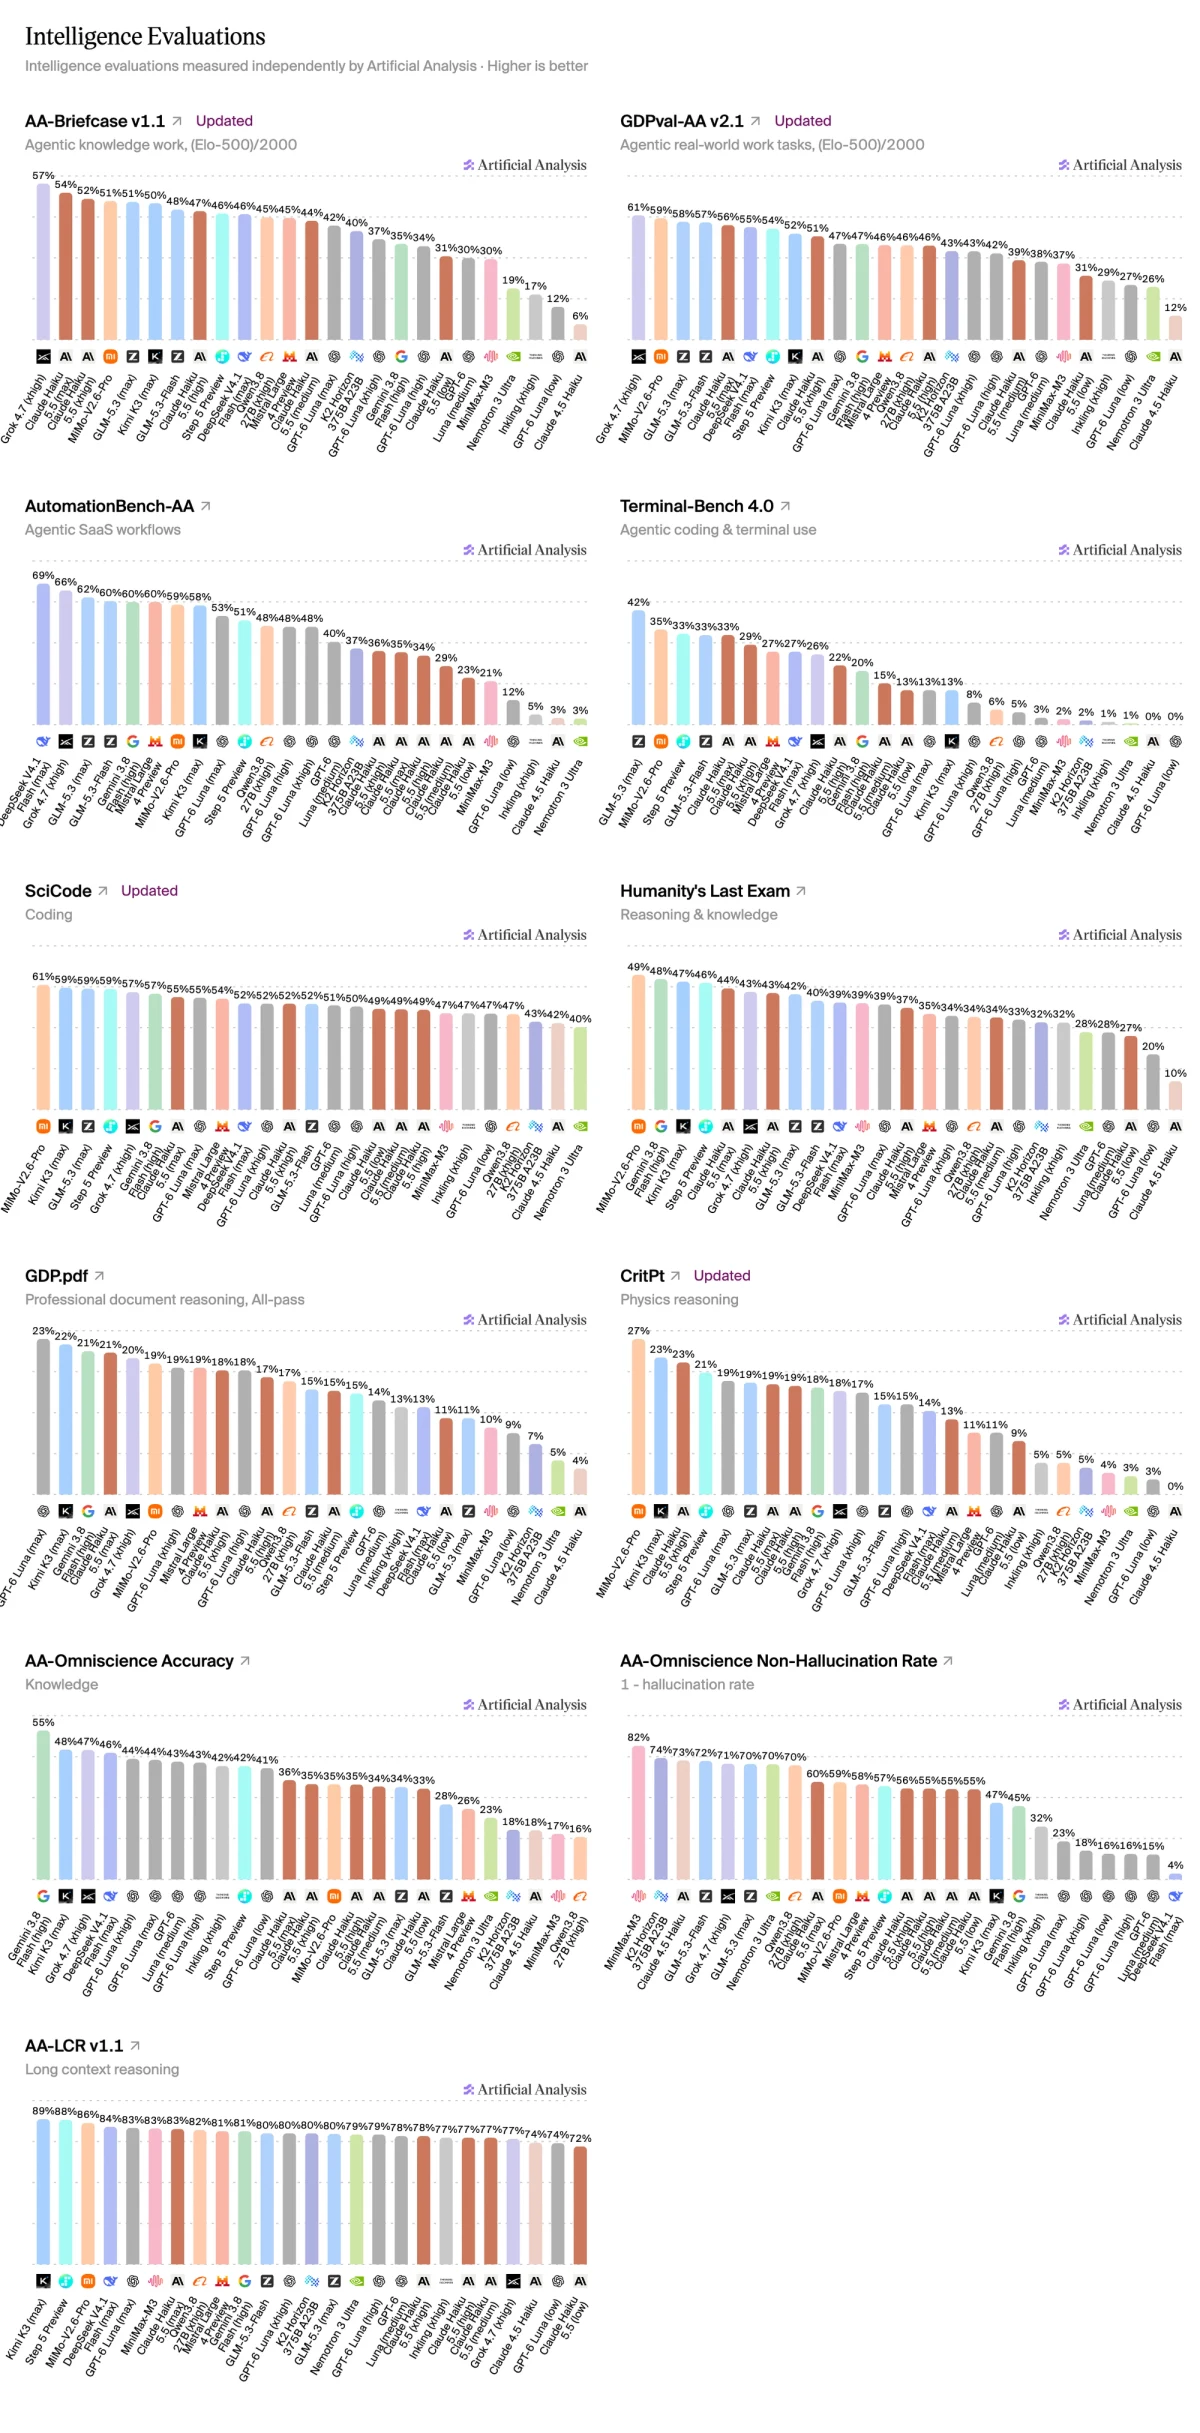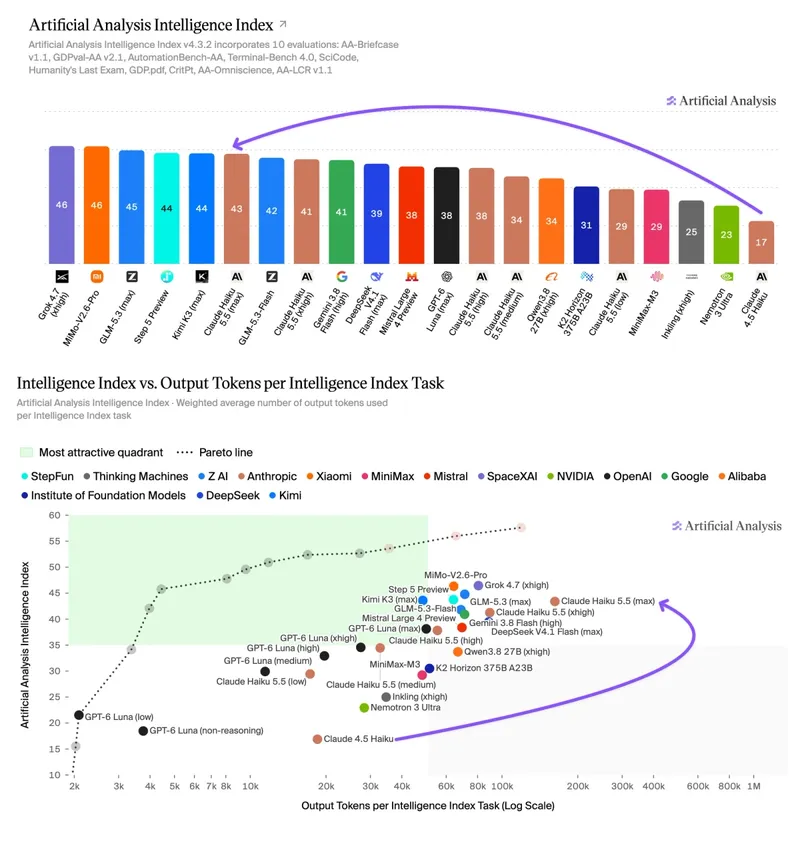
Anthropic ha lanzado Claude Haiku 5.5, obteniendo 43 puntos en el Artificial Analysis Intelligence Index, 26 puntos más un año después del último lanzamiento de Haiku
Ver la página del modeloHaiku 5.5 es el primer modelo Haiku con los ajustes de esfuerzo y el pensamiento adaptativo de Anthropic, y Anthropic ha introducido precios escalonados.
Haiku 5.5 es más barato que su predecesor: cuesta $0.10/$0.50 por 1M de tokens de entrada/salida para prompts de hasta 100k tokens (lo mismo que GPT-6 Luna y el 10% del modelo Haiku anterior). Sin embargo, este precio sube 5 veces a $0.50/$2.50 por encima de 100k. El sitio aún no refleja los precios escalonados, por lo que las cifras provisionales de coste de Haiku 5.5 no incluyen el coste del escalón adicional. Estamos trabajando en el soporte y pronto publicaremos cobertura de Coste por Tarea.
Puntos clave:
➤ Rendimiento líder en la clase de modelos pequeños: Con esfuerzo máximo, Haiku 5.5 se sitúa ligeramente por delante de modelos como GLM-5.3 Flash (42), Gemini 3.8 Flash (41) y GPT-6 Luna (38). Su puntuación es comparable a la de Kimi K3 (44), un modelo de pesos abiertos de 2.8T de parámetros, y queda 13 puntos por detrás de Claude Sonnet 5.5 (max, 56)
➤ Uso intensivo de tokens en comparación con GPT-6 Luna: Haiku 5.5 (max) usa ~162k tokens de salida por tarea del Intelligence Index, ~3 veces más que GPT-6 Luna (max, ~50k). Pasar de xhigh a max añade 2 puntos por ~1.8 veces los tokens. Con inteligencia similar también usa más tokens que GPT-6 Luna: Haiku 5.5 (high) obtiene 38 con ~55k tokens por tarea frente a 38 con ~50k de Luna (max), y la brecha se amplía en ajustes de esfuerzo más bajos
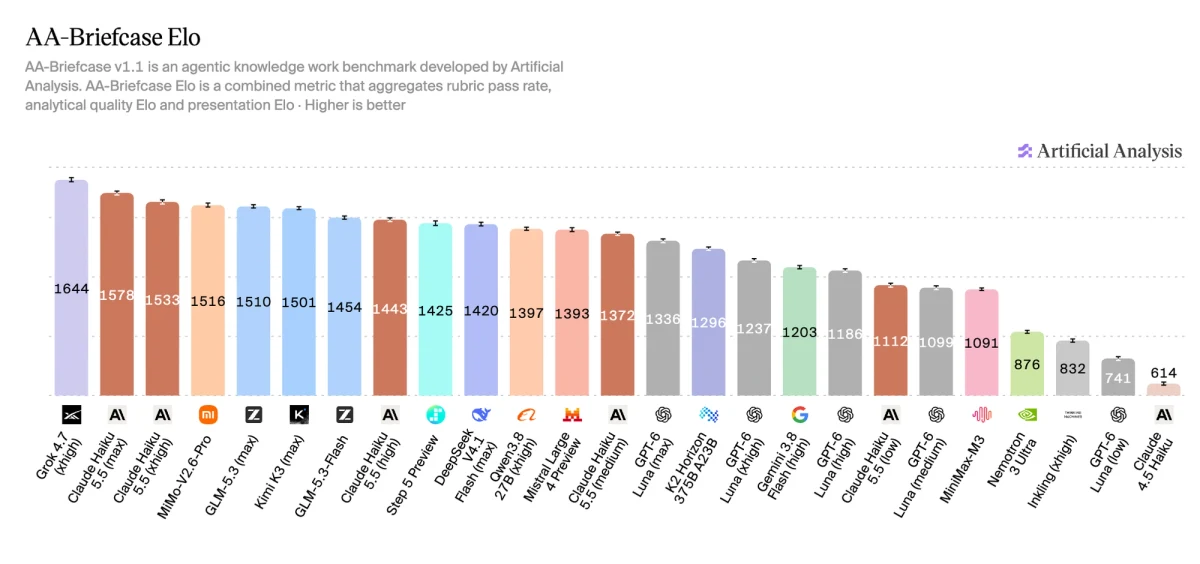
➤ Muy capaz en trabajo de conocimiento agéntico: en AA-Briefcase, nuestra evaluación privada para tareas realistas de trabajo de conocimiento, Haiku 5.5 (max) alcanza 1578 Elo, por delante de modelos como Kimi K3 y GLM-5.3, y comparable a Muse Spark 1.3 (max)
➤ Mejoras en el uso de terminal: en Terminal-Bench 4.0 obtiene 33%, frente al 0% de Haiku 4.5. Esto lo iguala con GLM-5.3 Flash, y lo sitúa por delante de Gemini 3.8 Flash (20%) y GPT-6 Luna (13%)
➤ Menos conocimiento factual, pero alucinaciones relativamente bajas: como es de esperar en un modelo de clase más pequeña, Haiku 5.5 tiene menos conocimiento factual que sus hermanos. La precisión en AA-Omniscience es de 36%, frente al 55% de Gemini 3.8 Flash y el 44% de GPT-6 Luna, pero esto se debe en parte a una mayor disposición a admitir cuando no lo sabe: su tasa de alucinación es menor, de 40% frente a 55% y 77%
➤ Resultado en AutomationBench-AA probablemente subestimado: Haiku 5.5 obtiene 35%, frente al 53–60% de GPT-6 Luna, Gemini 3.8 Flash y GLM-5.3 Flash. Durante las pruebas previas al lanzamiento, un problema de rechazos por seguridad hizo que el modelo rechazara en exceso. Anthropic está trabajando en resolverlo; volveremos a ejecutar esta evaluación con la corrección y esperamos que esta puntuación suba
Otros detalles del modelo:
➤ Ventana de contexto: 1 millón de tokens, frente a 200k de Claude 4.5 Haiku
➤ Precios: $0.10/$0.50 por 1M de tokens de entrada/salida hasta 100k tokens, $0.50/$2.50 por encima. Lecturas de caché $0.01 ($0.05 por encima de 100k), escrituras de caché de 5 minutos $0.125 ($0.625 por encima de 100k)
➤ Multimodalidad: Entrada de texto e imagen, con salida de texto
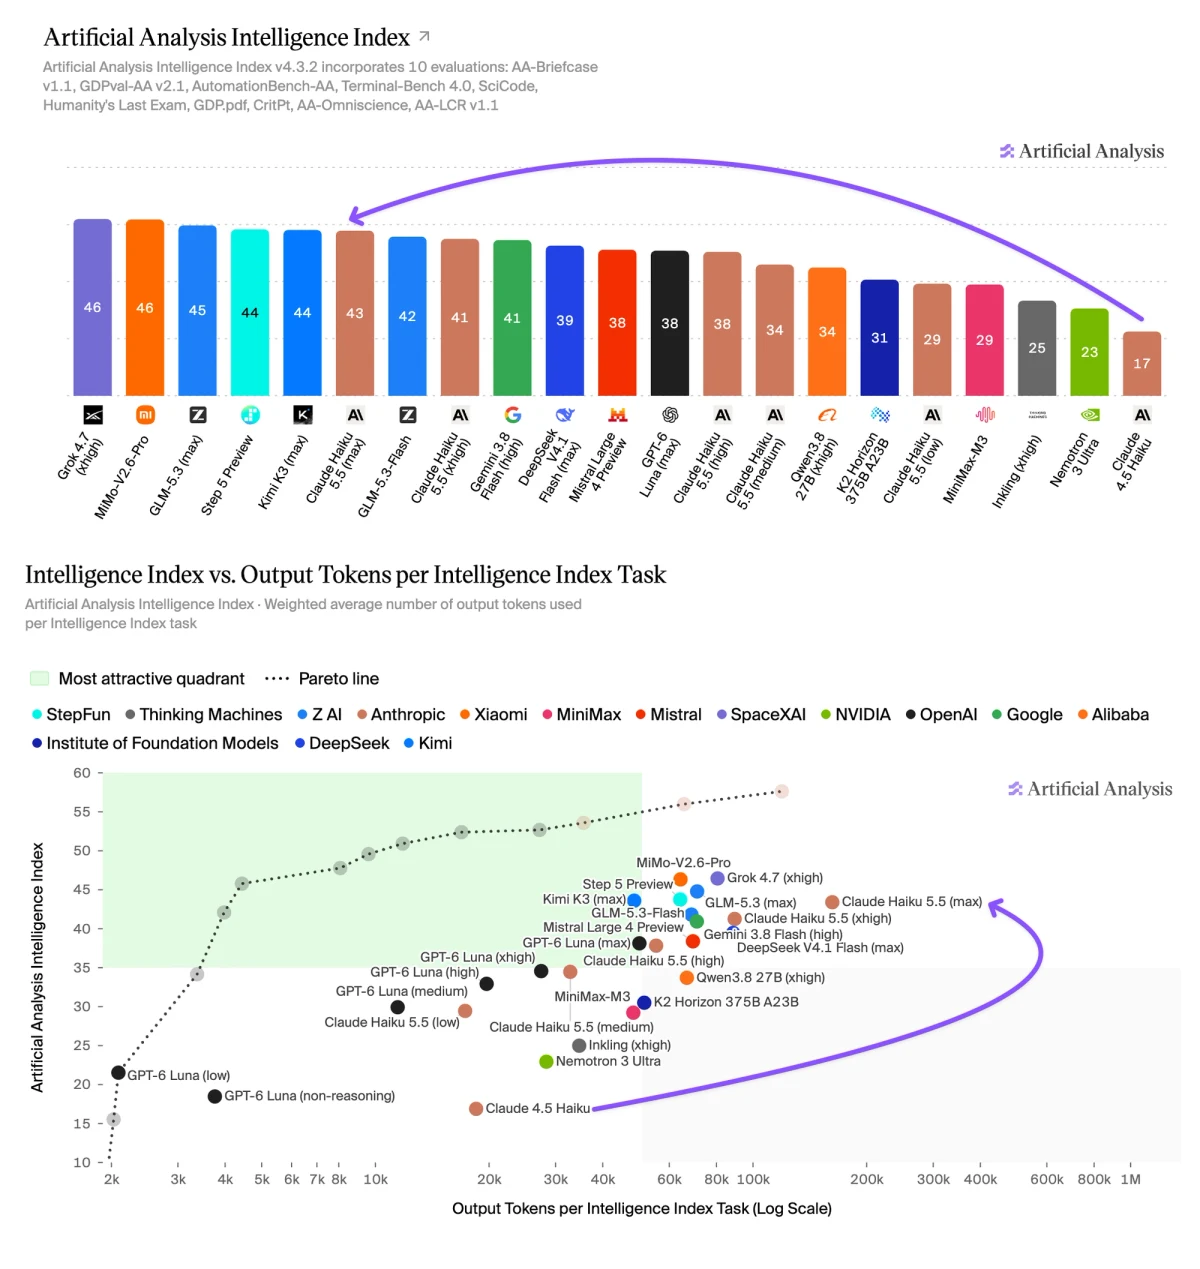
Claude Haiku 5.5 (max) usa ~162k tokens de salida por tarea del Intelligence Index, más que Opus 5.5 (max) y ~3 veces más que GPT-6 Luna (max). En todos los ajustes de esfuerzo, Haiku 5.5 usa más tokens de salida que GPT-6 Luna para alcanzar puntuaciones similares en el Intelligence Index
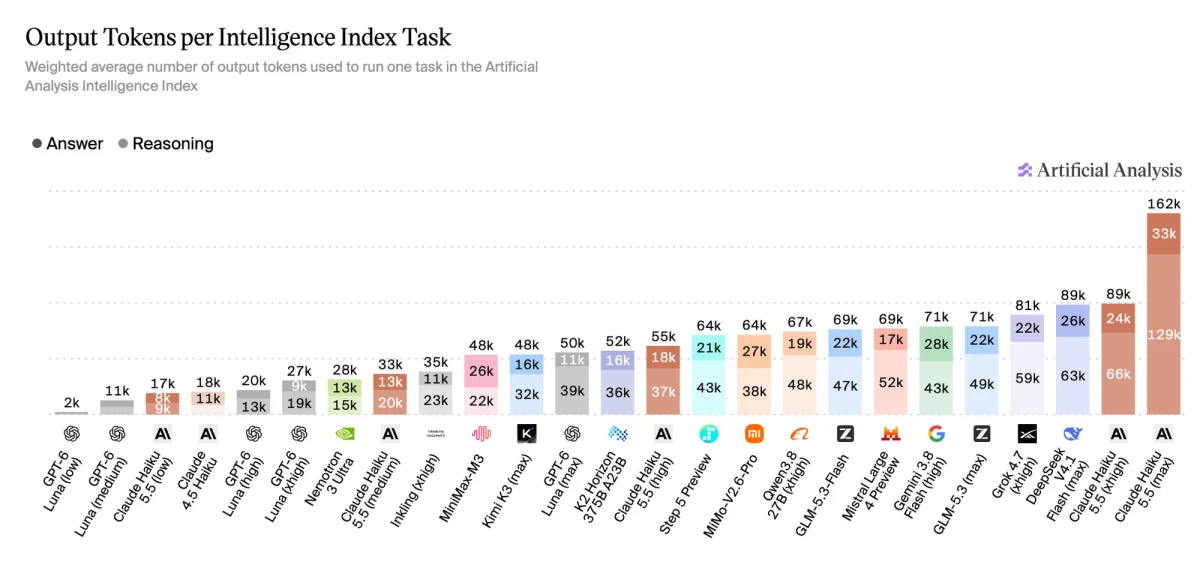
Claude Haiku 5.5 (max) alcanza 1578 Elo en AA-Briefcase, nuestra evaluación privada de trabajo de conocimiento frontera, dentro de los intervalos de confianza de GPT-6 Astra (max) y Claude Fable 5.1 (high)
Desglose completo de las evaluaciones individuales del Artificial Analysis Intelligence Index para Claude Haiku 5.5 en todos los ajustes de esfuerzo