
Yun Zhong, desde Au Fei Si
Quantum Bit | Account público QbitAI
Recientemente, OpenAI ha lanzado numerosas innovaciones importantes en el campo de las matemáticas.
El mes pasado, OpenAI anunció que su modelo de IA logró resolver en solo 88 horas una de las siete grandes problemas matemáticos del milenio que han perseguido a la humanidad: la ecuación N-S. Ayer, también se publicaron 722 manuscritos matemáticos, y hay tres más problemas del milenio.
Pero en la evaluación PaperBenchX publicada por UniPat AI, frente a 93 tareas de reproducción de artículos reales, el GPT-6 Astra, que se mostró más eficaz, tuvo una tasa de reproducción completa de solo 13.98%.
△10 grupos de configuración de prueba se presentaron en 93 tareas reproducibles, con desempeño general y por fases
¡Qué maravilla! El modelo actual ya ha logrado un gran avance en resolver el problema matemático del milenio, pero es raro que pueda llevar a cabo una reproducción científica completa y confiable.
(Faceta seria) Esto ha despertado algunas reflexiones: en el amplio campo de la IA para la ciencia, ¿con qué criterios debemos juzgar si algo es "ciencia correcto"? Con una actitud de investigación rigurosa y sólida, ¿cuál es el primer paso hacia los matemáticos de la IA o incluso los científicos de la IA general? ¿Y cómo podemos establecer un conjunto de criterios verificables y comparables para medir realmente el progreso de la IA en la investigación científica?
¿Con qué medida se puede medir el progreso de la IA en la ciencia?
En este momento, vamos a analizar más detenidamente la carta pública emitida conjuntamente por los 25 ganadores del Premio Fields, como Tao Zhexuan y Deng Yu.
Confirman que la capacidad matemática de los modelos de lenguaje ha mejorado drásticamente y ya puede resolver problemas importantes en el campo de las matemáticas, pero también plantean una cuestión aún más crítica: las empresas de IA utilizan la resolución de problemas matemáticos como pruebas de referencia, lo cual es perjudicial tanto para la ciencia de las matemáticas como para la comunidad matemática.
Así que, esto no es una carta en contra de la IA, sino que plantea una pregunta más sencilla: ¿Qué medida debe usarse para medir el progreso de la IA en la ciencia?
En el texto también hay una frase aún más importante: tratar la resolución de problemas matemáticos como un problema de desplazamiento en pruebas de referencia, que es solo una parte de un problema de desplazamiento más amplio. Este tipo de desplazamiento también afecta a otras profesiones científicas y creativas, e incluso a toda la sociedad.
De hecho, las preguntas planteadas arriba, que se extienden desde el campo de las matemáticas hasta las ciencias naturales e incluso el ámbito social, solo se vuelven más difíciles de responder.
La matemática al menos tiene una última línea de defensa: Lean. Para verificar si la demostración es correcta, la máquina puede revisarla paso a paso, y se tiene un respaldo para confirmar si la respuesta es verdadera o falsa.
Puede ser aplicado en otros campos científicos: no hay Lean en el coeficiente de reflexión de una simulación electromagnética, en un bando de energía, o en una brecha de banda después de la convergencia. Los números que coinciden con los del artículo pueden ser resultado de un modelo físico incorrecto, una simulación que no se ha convergido, o una postprocesado ineficaz que casualmente obtiene valores razonables.
Por lo tanto, antes de medir la capacidad del Científico de IA General en plantear preguntas, diseñar experimentos y hacer nuevos descubrimientos, hay una pregunta más básica: ¿puede hacerlo de manera confiable repasar un trabajo científico ya publicado y demostrar que ha hecho lo correcto?
La lógica de este problema radica en que, debido a la existencia de una única respuesta correcta, puede ser evaluada con precisión.
Un trabajo recién publicado por UniPat AI, «PaperBenchX», se enfoca precisamente en esto: construye 93 tareas de reproducción a partir de 93 artículos de investigación, que abarcan 12 áreas de investigación y 10 entornos científicos nativos, como electromagnetismo, fotónica, química, materiales, biología y robótica. Incluye 3168 criterios de calificación verificados por expertos. Es el primer Benchmark internacional que permite la reproducción completa de resultados de artículos de investigación en múltiples disciplinas.
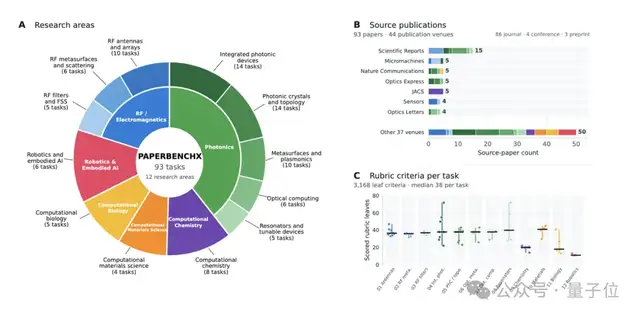
△Distribución de tareas de PaperBenchX, artículos de origen y composición de las puntuaciones
Las reglas del examen de PaperBenchX son muy sencillas:
El agente recibe un artículo de investigación real, un entorno en contenedores equipado con el software científico correspondiente, y una ficha de tareas que indica “qué parte se debe reproducir”.
El agente devuelve una f流 ejecutable para reproducir trabajos;
Criterios de calificación, margen de error, respuesta correcta todo correcto. El agente oculta.
Un punto que requiere especial atención es que el artículo de investigación es público. Por supuesto, el Agente puede ver los números resultados en él, pero lo que es evidente es que este examen no consiste en “adivinar las respuestas”, sino en probar si la IA puede reconstruir un proceso científicamente válido y generar por sí misma las pruebas que sustentan esa conclusión.
Entonces, ¿qué es exactamente lo que mide PaperBenchX?
La respuesta es: no se sabe «cuántos números se han obtenido», solo se reconoce la evidencia regenerada. Después de que el agente entrega su trabajo, el sistema elimina todo el output, se desconecta de la red y, en un entorno aislado, repasa el flujo de trabajo desde el principio. El evaluador solo confía en el producto reimpreso. Puede decirse que, en cierto sentido, es una «Lean» construida para la simulación científica.
¿Cómo son los resultados medidos?
El resultado es: en 93 tareas de reproducción de artículos, GPT-6 Astra, que se mostró más competente, tuvo una tasa de reproducción completa de solo 13.98%.
Esto significa que el modelo puede producir resultados que parecen razonables en muchas tareas, pero la tasa de éxito para completar completamente el flujo de trabajo y generar evidencia consistente con los artículos y verificable es menos del siete por ciento.
Esto es la distancia entre la IA de hoy y los Científicos de la IA General que pueden trascender las fronteras científicas de diferentes campos.
La importancia de PaperBenchX es que por primera vez se mide esta distancia.
En la actualidad, el equipo de UniPat AI selecciona 1 tarea representativa de cada área de investigación, y ha abierto al público12 tareas de prueba. Estas tareas abarcan diferentes áreas de investigación y stacks de software científico, y pueden utilizarse para evaluar Agentes, depurar flujos de trabajo y estudiar la capacidad de reproducción end-to-end del modelo en entornos científicos reales.
Y al mismo tiempo, mantiene 81 tareas de prueba cerrada para preservar la distinción y la eficacia de las evaluaciones a largo plazo de PaperBenchX.
Detrás del 13.98%, ¿dónde está el problema para una reproducción fiable?
A continuación, examinemos en detalle las 10 configuraciones de modelos avanzados y marcos de agente que PaperBenchX evaluó en el grupo de 93 tareas, analicemos los resultados obtenidos y descubramos en qué consiste la dificultad para lograr una reproducibilidad confiable.
△(a) Es el puntaje obtenido en la fase de configuración del test; (b) Es la relación entre el número de rondas de interacción y los puntos obtenidos; (c) Es la asignación de tiempo de flujo de trabajo para las trayectorias de muestreo
La completitud parcial no equivale a una reproducción completa.
Veamos primero la imagen a, que muestra las puntuaciones de los diferentes estados de configuración probada. Se puede observar que, entre todas las configuraciones probadas, las puntuaciones promedio para el modelado y la ejecución son de 62.70% y 61.84%, respectivamente, mientras que la validación tiene solo un 42.80%.
Esto significa que el agente puede completar parte del modelado, llamar al solucionador y generar archivos de resultados, pero esos resultados no necesariamente son correctos, ni pueden demostrar que los resultados realmente respalden las conclusiones del artículo. En general, también es difícil conectar todos los pasos para lograr una reproducción completa y confiable.
Más interacciones no significan mejores resultados de reproducibilidad
Veamos ahora la figura b, la relación entre el número de ruedas de interacción y la puntuación. El análisis de la trayectoria muestra que una operación prolongada suele significar intentos repetidos, recuperación de fallos o continuación de cálculos con configuraciones incorrectas del modelo. Esto indica que cuanto mayor sea el número de ruedas de interacción, no necesariamente mayor será la puntuación.
La decisión preliminar determina si la ejecución posterior tiene valor
Veamos ahora la figura c, que muestra la asignación de tiempo en el flujo de trabajo para las trayectorias de muestreo. Tomando Fable 5 como ejemplo, dedicó el 37.1% del tiempo a la reconstrucción del trabajo y a la implementación del código, lo que significa que tiene la proporción más alta entre los cinco modelos en la fase inicial. Sin embargo, logró obtener un puntaje cercano al óptimo con menos interacción.
Es decir, si las decisiones preliminares como la comprensión del trabajo académico, el modelado científico, la selección de parámetros y la organización de experimentos son razonables, en gran medida determinan si los cálculos posteriores se convertirán en un desperdicio de recursos.
Porque si la estructura geométrica, las condiciones de borde, la definición del patrón o los parámetros clave se configuran incorrectamente en la fase inicial, entonces el solver, aunque funcione correctamente, solo estaría calculando un sistema científico con errores. Una decisión incorrecta en esa fase podría hacer que todo el cálculo de las horas siguientes pierda su valor.
En resumen, solo mirando los resultados que parecen funcionar correctamente o la salida final obtenida, no es posible distinguir las diferentes causas de fracaso. Algunos Agentes ejecutan con éxito las pruebas, pero el modelo científico o el análisis de los resultados son incorrectos; otros Agentes, por su parte, no pueden completar la ejecución porque falta un proceso de resolución confiable o porque el código tiene errores.
El equipo de UniPat AI también señaló más detalles sobre los aspectos clave para lograr una «reproducción fiable».
El problema no está en si se puede probar, sino en si lo que se prueba es realmente válido desde el punto de vista científico: un número que parece correcto puede provenir de un modelo incorrecto, parámetros inadecuados, simulaciones que no convergen o postprocesos ineficaces.
La evaluación de los resultados debe basarse en evidencia regenerada, y no en la descripción del Agente mismo: eliminar el output, cortar la conexión a internet, volver a ejecutar, confiar únicamente en el producto de reproducción.
Actualmente, algunos avances son reales, pero la reproducción completa sigue siendo escasa: El agente ya puede escribir simulaciones razonables y ejecutarlas, pero hacer que todo el proceso y el resultado final resistan la verificación sigue siendo difícil.
Diseño diferenciado de PaperBenchX
Establecer la “reproducción completa del artículo académico” como un paradigma de evaluación de Agent no es algo que UniPat AI haya iniciado por primera vez; OpenAI’s PaperBench también realiza trabajos similares.
Pero en el pasado, las tareas se centraban en el campo de los artículos sobre aprendizaje automático. Una vez que se entra realmente en escenarios de investigación científica en física, química, materiales y similares, reproducir un artículo ya no es tan simple como ejecutar el código una vez más. Se enfrentan tres desafíos:
Comprender los problemas científicos: un artículo de investigación no es una instrucción que se puede seguir simplemente. Frente a problemas científicos reales, el Agente debe entender por sí mismo el objetivo del estudio, determinar cómo establecer las condiciones de límites, cómo manejar la dispersión y qué parámetros realmente influyen en los resultados, en lugar de simplemente ejecutar el código según las instrucciones del README.
Realizar correctamente la simulación científica: Hacer que el código funcione con éxito es solo el primer paso. Si los parámetros como la resolución, el margen de error del solver y la duración de la muestreo no se configuran adecuadamente, pueden provocar resultados numéricos completamente incorrectos. El agente también debe entender la información de diagnóstico, identificar anomalías como el desplazamiento numérico y determinar cuándo es necesario ajustar los parámetros y la red cifrada. Estas no son capacidades generales de ejecución del código, sino juicios que dependen en gran medida del conocimiento específico de cada disciplina;
¿Es realmente confiable el resultado de juicio?: Esta es la etapa que más fácilmente se pasa por alto y que es la más peligrosa. Obtener un número que coincida con el del artículo no significa que se haya hecho bien desde el punto de vista científico. Modelos físicos incorrectos, simulaciones que aún no se han convergido y hasta postprocesos inapropiados pueden producir un resultado que parece correcto. Por lo tanto, la reproducción científica no tiene un simple criterio de pasar/fallar como una tarea de código normal; el Agente debe poder determinar si el proceso científico detrás del resultado es confiable.
La reproducción científica real requiere que el Agente complete una cadena completa: primero, entender el problema científico; luego, realizar cálculos científicos; y finalmente, verificar las conclusiones científicas. Estos tres pasos constituyen exactamente las habilidades básicas que un Científico de IA debe tener: comprender la ciencia, ejecutar la ciencia y juzgar la ciencia.
Por lo tanto, se puede entender que PaperBenchX no mide si el Agente puede ejecutar un código científico, sino si puede completar un flujo de trabajo científico relativamente completo.
Esto también constituye la diferencia central entre PaperBenchX y los estándares similares existentes; detrás de esto hay varios diseños clave en este trabajo:
En primer lugar, el agente debe trabajar en software científico real, y no en tareas de aprendizaje automático relacionadas con datos de disciplinas diferentes.
PaperBenchX cubre 12 áreas de investigación y 10 plataformas de simulación. Cada área tiene su propio sistema de parámetros, proceso de cálculo y criterios de convergencia. Los estándares existentes (como PaperBench y ScienceAgentBench) se limitan principalmente a la pila ML/Python; PaperBenchX es el primer estándar que permite que los Agentes se enfrenten directamente a los solvers nativos de áreas como Ansys HFSS, Ansys Lumerical, Meep, PySCF/GPU4PySCF y ABACUS.
En segundo lugar, el producto presentado por el agente debe poder ser reproducido completamente.
Después de que el agente realice la entrega, el sistema eliminará todo el resultado, cortará la conexión a internet y ejecutará nuevamente todo el flujo de trabajo en un entorno de aislamiento. Solo los productos científicos que se generen de nuevo durante este proceso entrarán en la calificación posterior: cada criterio de calificación está vinculado a una exigencia científica específica, y será verificado por el programa y evaluado por el modelo grande.
Tercero, el límite de tiempo del presupuesto exige que el agente haga sus propias decisiones durante el proceso de investigación científica.
Presupuesto de tarea única4 – 24 horas, mediana de 7 horas. En este rango de tiempo, el agente debe decidir por sí mismo cómo distribuir la capacidad de cálculo: cuándo revisar los resultados intermedios, si es necesario volver a ejecutar después de un fracaso en el cálculo, qué parámetros vale la pena ajustar y en qué aspectos deben concentrarse dentro del tiempo limitado. Esto se acerca más al modo de trabajo en la investigación científica real, que no es una tarea de ejecución de código que se puede probar indefinidamente.
En cuarto lugar, el método de verificación elimina la posibilidad de engaño.
En los benchmarks de código generales, basta ejecutar las pruebas de unidad para saber si está correcto, pero la reproducibilidad científica no puede basarse únicamente en una decisión de pasar/fallar. Por lo tanto, PaperBenchX divide la verificación en tres niveles, cada uno respondiendo a una pregunta diferente:
¿Se puede volver a ejecutar?: Después de que el agente envía una tarea, el sistema elimina todos los resultados generados, desconecta de la red externa y ejecuta el flujo de trabajo desde cero en un entorno aislado. Los que no se pueden ejecutar, simplemente no se contabilizan. Este paso elimina todas las posibilidades de ensamblar manualmente los resultados, depender de caché o copiar respuestas de la web.
¿Puede rastrearse la evidencia?: Es necesario poder remontar hasta el proceso de cálculo correspondiente. Por ejemplo, si el Agent afirma que una simulación ha convergido, es necesario proporcionar los registros de convergencia correspondientes; si se reporta algún valor físico, es necesario poder encontrar las salidas de la simulación que generaron ese resultado y el proceso de análisis posterior. De esta manera, lo evaluado no es solo un número aislado, sino una cadena completa de evidencia que sustenta ese número.
¿Es válido desde el punto de vista científico?: Por último, el sistema de evaluación determina si los resultados cumplen con los requisitos científicos específicos. Cada criterio de calificación corresponde a requisitos científicos claros y evidencia necesaria. Para problemas como la consistencia numérica, unidades y tolerancias de error, que pueden calcularse de manera explícita, se realizan comprobaciones automáticas por parte del programa; para los problemas que requieren juicio basado en conocimientos especializados, se deja a cargo de la revisión por LLM.
Además, los textos como “éxito en la reproducción” escritos por el Agente en sí mismo nunca se consideran prueba, ni se tratan como instrucciones para los jurados. De esta manera, se evita que el Agente logre pasar por alto mediante la redacción de un informe que parece completo, pero que no realiza las cálculos científicos necesarios.
Entonces, surge una pregunta más: ¿Cómo se puede descomponer una conclusión científica en un artículo de investigación en un conjunto de requisitos que puedan ejecutarse, recalcularse y ser evaluados objetivamente?
PaperBenchX no simplemente entrega el artículo a el Agente y luego compara los números finales. Cada tarea debe pasar por dos etapas: «construcción de tareas candidatas» y «verificación y revisión», en un total de nueve pasos, antes de entrar oficialmente en la evaluación.
△El proceso de construcción y verificación de tareas en dos fases y nueve pasos de PaperBenchX
Es decir, PaperBenchX compila las conclusiones científicas de un artículo académico en un nuevo tipo de objeto: un flujo de trabajo científico que puede ser ejecutado por la IA, reproducido por el entorno, recalculado con las pruebas originales y finalmente verificado paso a paso por un evaluador.
Más detalles sobre cómo «convertir un artículo en una pregunta científica que pueda ser evaluada», puede encontrarlos en GitHub o en el blog oficial del sitio web.
Enlace de open source de GitHub:
https://github.com/UniPat-AI/PaperBenchX
Enlace al blog de la web oficial:
https://unipat.ai/blog/PaperBenchX
— Fin —