
Mengyao desde Ao Fei Si
Quantum Bit | Cuenta oficial QbitAI
Vaya, hombre,ByteDance¡¿esta vez ha convertido la generación con IA en un mundo abierto?!
Mirad: basta con introducir una frase, y la IA genera de la nada una habitación desde la perspectiva de una miniatura humana~
A continuación, con una ráfaga de teclado y ratón, podemos subirnos a un avión de papel yvolar librementeen el mundo ciber, yendo donde queramos:
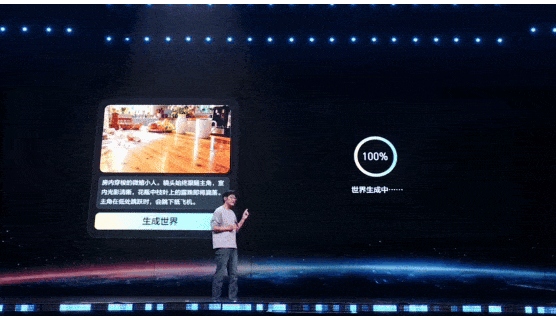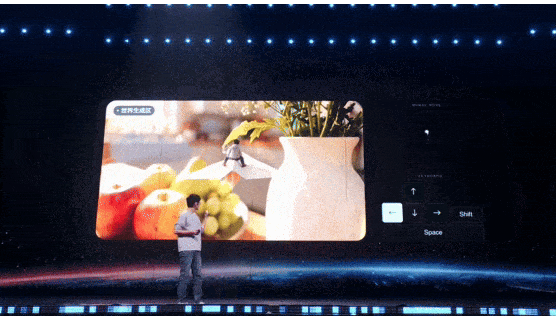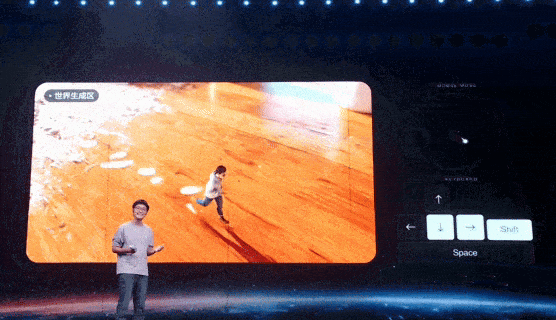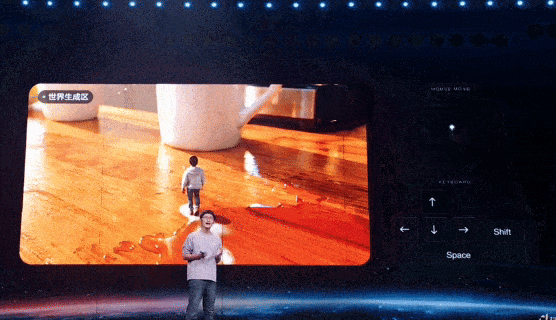
Y esto no es todo: en este mundo generado por IA, ¡incluso podemos crear a mano lo que tenemos delante!
¿Queréis una cuchara? La creamos de la nada; e incluso…
también podemosinteractuarcon la cuchara, convirtiendo los cubiertos cotidianos en una gran escena de escalada——
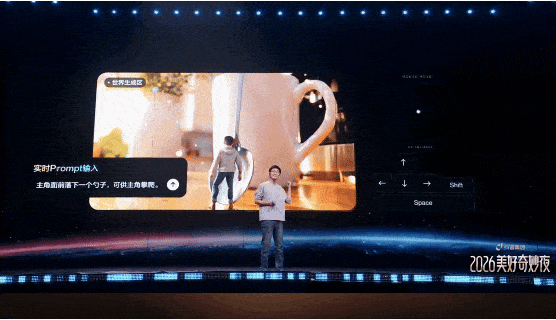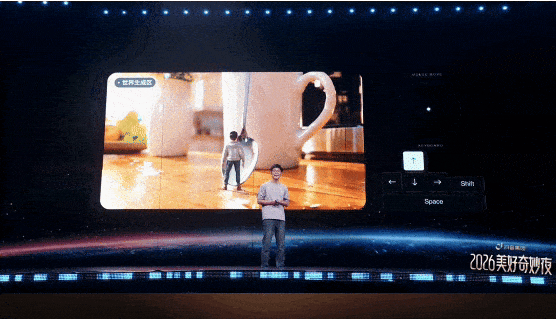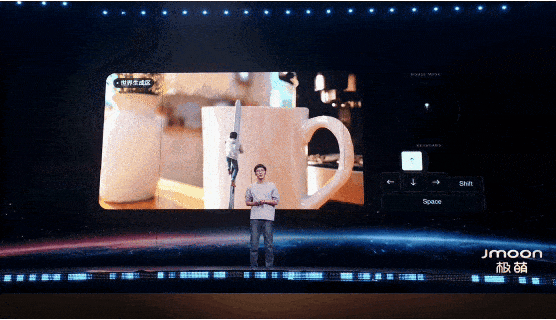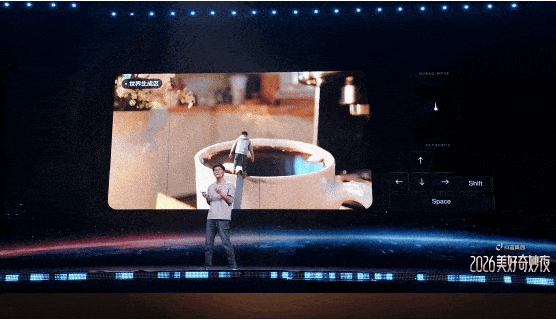
Por supuesto, lo que este mundo puede hacer no se limita a esto.
Gracias a la función depuerta任意门(任意门), dos escenarios sin ninguna relación pueden conectarse directamente.
¿Un segundo estás en casa y, al empujar la puerta, al siguiente entras en el espacio exterior?!
Esta escena tan mágica apareció en el escenario del programa tecnológico«Noche Maravillosa de la Belleza 2026» del Grupo Douyin(抖音集团《2026 美好奇妙夜》), y el presentador fue Tim de YingShi JuFeng (影视飓风).
Merece la pena destacar que, detrás de esta cadena de operaciones dignas de creación ciber, se encuentra elmodelo mundial(世界模型) queByteDanceha estado desarrollando en silencio todo este tiempo. (震惊.jpg)
Aunque el modelo aún no se ha lanzado oficialmente, según lo mostrado en el evento ya ha demostradogeneración de escenas tridimensionales, exploración libre, interacción en tiempo real, edición de objetos,Incluso la habilidad deconexión libreentre diferentes espacios~
Esta vez, ByteDance aprovechó la presentación en directo del programa para que su modelo mundial realizara una«debut»sorpresivo, adelantándose así a lucir músculo.
La verdad es que uno se emociona al recordarlo: en estos años, desde World Labs fundada por Li Fei-Fei, hasta Genie de Google DeepMind, pasando por Cosmos de NVIDIA.
Un sinfín de gigantes tecnológicos han entrado en escena, intentando que la IA comprenda mejor la estructura espacial, simule las leyes de la realidad e incluso prediga cómo cambia el entorno según las acciones de las personas.
Hoy en día, la IA está convirtiendo en realidad los mundos de las películas de ciencia ficción.
De dibujar un mundo a hacer que todo el mundo «cobré vida»
Supongo que quienes primero jugaron con AIGC hace años tampoco imaginaron que—
un día, los videos generados por la IA podrían convertirse en un mundo ciber tridimensional al que se puede entrar, con interacción y edición flexible.
He hecho un pequeño recuento: desde principios de año hasta ahora, he probado unos seis o siete productos de modelos mundiales。。。
El nivel de asombro no es menor que ver «Interstellar» un día y descubrir al siguiente que puedes entrar en la pantalla y, de paso, llevarte el agujero negro a tu sala de estar.
Entonces, ¿cómo pudo la IA pasar de la generación de imágenes y videos a «cambiar de servidor» tan suavemente hacia la creación de mundos?!
Este asunto hay que contarlo desde una deficiencia técnica de la generación multimodal tradicional。(doge)
Hoy en día, los modelos mundiales han derivado en varias rutas técnicas: desde la predicción de estados abstractos, el modelado causal físico, hasta la generación de mundos tridimensionales, cada una con su enfoque.
De lo que queremos hablar aquí es principalmente de una ruta relacionada con la generación multimodal y la inteligencia espacial:
hacer que la IA aprenda la estructura espacial y las leyes de cambio del mundo real, para luego generar, reconstruir y simular un mundo tridimensional que permita exploración continua e interacción en tiempo real.
Vale la pena subrayar que aquí hay dos palabras clave:estructura espacialyleyes de cambio。
Y estas dos capacidades apuntan precisamente a un problema fundamental que la tecnología de generación visual no ha resuelto por completo en los últimos años.
△Generado por IA
En 2024, OpenAI lanzó Sora, y sus impresionantes videos generados hicieron que toda la red se quedara aturdida y anonadada junto a Sam Altman.
Pero, en comparación con aquellos videos que entonces inundaron las pantallas, el informe técnico que OpenAI publicó en su momento resulta hoy, en cambio, aún más digno de saborearse con calma—
«Video generation models as world simulators», traducido literalmente sería«Modelos de generación de video como simuladores del mundo»。
En aquel momento, OpenAI descubrió que, a medida que aumentaba la escala de los modelos de generación de video, los modelos comenzaban a exhibir cierta consistencia tridimensional y persistencia de los objetos, e incluso podían simular interacciones ambientales simples.
Pero lo incómodo es que un modelo capaz de generar imágenes de mundos realistas todavía puede fallar incluso en las «relaciones físicas» más básicas.
Por ejemplo, Sora puede generar una escena de una persona corriendo en una cinta de correr, con personajes, luces y sombras, y encuadres que parecen muy reales.
Pero al observarlo detenidamente, la relación entre los movimientos de los personajes y el funcionamiento de la cinta de correr no necesariamente se ajusta a la lógica física de la realidad; la imagen es muy realista, pero las leyes de la física parecen depender un poco de la suerte??
△Fuente de la imagen: sitio web oficial de OpenAI
Detrás de esto, en realidad, se expone un problema bastante fundamental de las tecnologías tradicionales de generación visual.
En los últimos años, tanto los modelos de difusión como las arquitecturas generativas basadas en Transformer, los principales modelos de imagen y video han dependido principalmente de aprender de enormes cantidades de datos visuales elley estadística, para generar imágenes que cumplan las condiciones de entrada.
Este conjunto de métodos ha tenido bastante éxito, e incluso ha llegado a aprender de manera implícita parte de la geometría tridimensional, las relaciones entre objetos y las leyes de la física.
PeroLa continuidad espacio-temporal visual no corresponde necesariamente a un conjunto de estados del mundo estables y susceptibles de intervención mediante acciones externas.——
Por ejemplo, hacer que una taza mantenga una apariencia consistente a lo largo de un video ya es relativamente fácil para los modelos generativos actuales.
Pero cuando se recoge, se suelta o incluso se empuja hacia el borde de la mesa, el modelo también necesita rastrear continuamente la posición espacial, las relaciones entre objetos y los cambios de estado, además de predecir resultados físicos como colisiones y caídas.
En otras palabras, entre generar un vídeo coherente con la intuición física y predecir de manera fiable los cambios que una acción provoca en el entorno, media todavía un problema: la modelización del estado del mundo.
Y esto es precisamente aquello en lo que destacan los modelos del mundo.
En junio de este año, el equipo de Fei-Fei Li publicó un artículo titulado «A Functional Taxonomy of World Models».
El artículo divide los modelos del mundo en tres tipos desde una perspectiva funcional, y también ofrece una explicación más clara de qué «habilidades reales» tienen realmente los modelos del mundo:
- Renderizador: responsable del mundoParece que...cómo es y produce imágenes visuales orientadas a los seres humanos, cuyo objetivo principal es el realismo de la imagen y la expresividad visual.
- Simulador: a cargo del mundoreal…una apariencia en la plataforma, manteniendo el estado de la escena conforme a la geometría y la causalidad física.
- Planificador: responsable de decidir cuál debe ser el siguiente paso del agente inteligenteAcción, y con base en el estado actual del mundo y los objetivos establecidos, produce acciones razonables.
Lo interesante de esta división es que explica exactamente por qué, aunque la IA ya puede generar vídeos indistinguibles de los reales, todavía nos esforzamos tanto en investigar los modelos del mundo.
Desde generar imágenes visuales realistas, hasta mantener estados del entorno conformes a las leyes de la física, y además permitir que los agentes tomen decisiones y actúen de manera autónoma——
Las capacidades de representación espacial, predicción dinámica y planificación de acciones que implica esto son precisamente los desafíos técnicos que los modelos generativos multimodales tradicionales aún no han resuelto de manera adecuada.
Y hoy en día, esas concepciones de modelos del mundo que en el artículo parecen bastante inalcanzables ya han comenzado a ser «construidas» poco a poco por la IA.
△Fuente de la imagen: artículo «A Functional Taxonomy of World Models»
TomemosDouyin Group: «Noche Maravillosa de la Belleza 2026»Tomemos como ejemplo aquella operación de creación ciber presentada en un programa de tecnología, realizada sobre la base de un modelo de IA de ByteDance.
Generar imágenes a partir de una sola frase ya no es nada extraordinario hoy en día.
Pero cuando una persona realmente entra en esta escena generada por IA y puede moverse libremente por ella, lo que el modelo necesita procesar ya no es solo generar la imagen que tiene delante, sino mantener la estructura espacial de toda la escena.
Sea cual sea la dirección en que la persona se mueva o el ángulo desde el que observe, el terreno, los objetos de la escena y sus posiciones relativas deben mantener una consistencia geométrica suficiente.
Lo que se esconde detrás de esto es precisamente lacapacidad de representación espacialdel modelo del mundo, y también la base que permite que un escenario generado por IA resista realmente una exploración repetida.
Si se quiere una cuchara, la IA puede generarla de la nada, e incluso permitir arrastrarse a lo largo de la cuchara, logrando interacción de acciones en tiempo real.
Estas operaciones, que parecen simples, implican en realidad del modelo del mundo lacapacidad de generación inmediata, modelado del estado del entorno y predicción dinámica——
El modelo necesita actualizar en tiempo real los objetos y las relaciones espaciales de la escena según las operaciones del usuario, y predecir continuamente los cambios del entorno provocados por las acciones, manteniendo la coherencia entre los estados anterior y posterior.
Incluso, el propio espacio puede transformarse a voluntad: al dibujar una «puerta mágica», se puede conectar directamente una habitación real con el espacio exterior.
Llegados a este punto, la capacidad del modelo del mundo se extiende un nivel más——reconstrucción de escenas tridimensionales, edición espacial controlable y modelado de continuidad entre escenas.
El modelo puede, conservando al mismo tiempo la estructura espacial de la escena original, reorganizar dinámicamente las relaciones geométricas de distintas escenas, y soportar la exploración continua entre escenas y la interacción en tiempo real:
Desde mantener la estructura espacial, hasta responder a la interacción en tiempo real, y luego soportar la edición de escenas y la reorganización entre espacios, las capacidades del modelo de IA de ByteDance apuntan conjuntamente también a la característica central del modelo del mundo——
Lo que la IA genera ya no es solo contenido, sino lo que genera es un mundo digital capaz de existir de forma continua, de cambiar continuamente y de interactuar continuamente.
En los últimos años, los grandes modelos de lenguaje han ampliado sin cesar la capacidad de la IA para procesar lenguaje y conocimiento, mientras que los modelos multimodales han extendido la capacidad de generación a imágenes, sonido y video.
Y hoy, con el desarrollo de los modelos del mundo, la IA ha comenzado a explorar más a fondo la estructura espacial, el estado del entorno y sus leyes de evolución.
El desarrollo tecnológico de la IA generativa también está pasando de cuán realista es la imagen a si el entorno generado puede existir de forma sostenida, responder a la interacción e incluso simular el funcionamiento del mundo real.
El modelo del mundo permite a la IA forjar «verdaderas habilidades» en el mundo virtual
Por supuesto, si los modelos del mundo solo sirvieran para que los humanos exploren por todas partes el mundo cibernético, sería algo así como desaprovechar un gran talento.
Situándolo en unas coordenadas industriales más amplias, tiene un valor con mayor capacidad de imaginación——
permitir que las máquinas se entrenen a gran escala en el mundo virtual, cometan errores repetidamente y luego transfieran las habilidades aprendidas a la realidad.
Después de todo, el desarrollo de la IA física, como los robots y la conducción autónoma, ha estado limitado durante mucho tiempo por restricciones de la realidad como el alto costo de la recopilación de datos reales, los largos ciclos de prueba y error, y la dificultad de reproducir escenarios peligrosos o extremos.
Y el modelo del mundo ofrece un nuevo camino: convertir el entorno real en un campo de entrenamiento virtual generable, controlable y verificable repetidamente.
Desde generar datos de entrenamiento escasos, hasta simular entornos complejos y verificar estrategias de acción, algunas etapas de entrenamiento que antes dependían del entorno real podrían trasladarse al mundo virtual para completarse.
Esto también hace que el modelo del mundo comience a extenderse desde la generación de contenido hacia las etapas de entrenamiento y verificación de la IA física, convirtiéndose en una importante dirección de exploración tecnológica en campos como los robots y la conducción autónoma.
△Generado por IA
Empecemos por hablar del asunto de los «datos de entrenamiento».
Para los sistemas de IA física como la conducción autónoma, cuanto más crítico es el escenario extremo, más escasos suelen ser los datos de entrenamiento.
Por ejemplo, en escenarios de baja frecuencia y alto riesgo como accidentes repentinos o clima extremo, puede que ni siquiera con muchos kilómetros recorridos se encuentren unas pocas veces, y precisamente el modelo del mundo puede generar y simular repetidamente estos escenarios a demanda.
En el evento tecnológico del programa del ByteDance Group «2026 美好奇妙夜», mostraron precisamente una demo de conducción autónoma——
una ambulancia que se acerca de repente, peatones que cruzan la calzada, un policía dirigiendo el tráfico en el lugar.
Diversas condiciones de tráfico complejas fueron llevadas a una carretera virtual generada por IA, donde los vehículos pueden simular la conducción, responder a situaciones imprevistas, e incluso analizar el desempeño de la conducción mediante reproducciones desde múltiples cámaras.
Los escenarios de cola larga que antes requerían numerosas pruebas de conducción reales para acumularse, hoy podrían generarse en lotes mediante el modelo del mundo y utilizarse para el entrenamiento y la verificación repetidos de los sistemas de conducción autónoma.
Además de los datos de entrenamiento, el valor industrial de los modelos de mundo también se manifiesta en otro aspecto clave:mejorar la eficiencia del entrenamiento y la validación de la IA física.
Todos saben que un robot real debe ejecutar acciones y esperar retroalimentación en cada entrenamiento, y tras un fallo puede requerir un reinicio manual y correr el riesgo de dañar el hardware.
Pero en el mundo tridimensional, ese proceso de prueba y error que consume tanto tiempo tiene la oportunidad de convertirse en experimentos de simulación repetibles y paralelizables.
La demostración de un robot doméstico en el escenario tecnológico de la gala 《2026 Noche Maravillosa de lo Maravilloso》 de Douyin Group refleja precisamente una idea similar.
En un entorno virtual generado por IA, el robot puede practicar operaciones domésticas como agarrar, transportar y colocar objetos, y además puede ajustar sus estrategias de movimiento frente a posiciones de objetos y disposiciones espaciales que cambian constantemente, intentando completar las tareas.
Incluso si la operación falla, puede reproducir rápidamente el problema en el entorno virtual, ajustar la estrategia y entrenar y validar repetidamente.
En comparación con operar una y otra vez en el mundo real con reposicionamiento manual, los modelos del mundo dan a los robots la oportunidad de ensayar en paralelo en distintos escenarios,perfeccionando su capacidad para afrontar el entorno real a un costo menor y a mayor velocidad.~
Mirando la industria en su conjunto, los gigantes tecnológicos en realidad ya han comenzado a explorar la aplicación industrial de los modelos del mundo siguiendo distintas direcciones.
En marzo de este año,NVIDIAcombinó el modelo del mundo Cosmos con la plataforma de simulación Isaac, permitiendo que los robots generen datos y se entrenen repetidamente en entornos virtuales.
Esta solución de simulación industrial promete reducir considerablemente el costo de llevar un robot del entrenamiento al despliegue real.
△ Fuente de la imagen: sitio oficial de NVIDIA
Merece destacar además que este auge incluso ha arrastrado a los gigantes de los chips de la cadena upstream.
Justo en el mes de 9, septiembre, que acaba de pasar,AMD anunció la adquisición por 8200 millones de dólares de World Labs de Fei-Fei Licon la intención de adelantarse a la demanda de potencia de cálculo de los modelos del mundo y allanar el camino para el desarrollo de la próxima generación de chips.
Desde el entrenamiento virtual de robots, hasta la simulación industrial, y luego los gigantes de los chips entrando en escena personalmente.
La competencia industrial de los modelos del mundo se extiende a lo largo de toda la cadena de suministro, desde la capacidad de los modelos y las aplicaciones prácticas hasta profundizar gradualmente en la arquitectura de potencia de cálculo subyacente.
Carrera global de los modelos del mundo: la acumulación tecnológica de los jugadores chinos comienza a rendir frutos
Los modelos del mundo están realmente de moda, pero tras este auge va surgiendo un fenómeno industrial bastante interesante.
Los fabricantes dentro y fuera del país exploran cómo construir mundos tridimensionales con estabilidad espacial y capacidad de interacción en tiempo real, pero la acumulación tecnológica, el enfoque de I+D y las rutas de aplicación de cada uno difieren considerablemente—
los objetivos técnicos convergen gradualmente, pero cada quien tiene sus propias maneras de lograrlo.
Tomando el extranjero como ejemplo, Genie de Google DeepMind y World Labs de Fei-Fei Li exploran la capacidad de simulación universal del mundo, centrándose en la estructura espacial, el modelado dinámico de entornos y la generación de escenas interactivas.
Cosmos de NVIDIA está más cerca de las necesidades reales de la IA física, combinando modelos del mundo con la simulación de robots y la generación de datos sintéticos, intentando conectar el entrenamiento virtual con la aplicación real.
Las distintas rutas tienen enfoques diferentes, pero todas apuntan finalmente a un mismo objetivo:que los entornos virtuales generados por IA adquieran gradualmente la capacidad de simular el mundo real.
Dirijamos ahora la mirada a China.
Una ventaja digna de mención es que, en comparación con la ruta exploratoria del extranjero orientada a la simulación universal del mundo, la capacidad técnica acumulada por los fabricantes chinos durante los últimos añosen el ámbito de la generación de imágenes y videos ofrece a los modelos del mundo otra vía de evolución bastante competitiva.
En julio de este añoSeedance 2.5extendió la duración de una sola generación de video a 30 segundos, y además reforzó el control de referencias multimodales, el movimiento de cámara y la capacidad de narración continua.
El modelo de generación de imágenes lanzado en el mismo período,Seedream 5.0 Pro, refuerza aún más la comprensión de la posición espacial, la consistencia estructural y la edición interactiva de precisión.
El usuario marca una posición en la imagen, o incluso hace unos cuantos trazos a mano alzada, y el modelo puede modificar el área indicada: de verdad, lo que dibujas es lo que se cambia.
Desde la coherencia de la estructura espacial, pasando por la continuidad dinámica en series temporales largas, hasta la respuesta precisa a operaciones externas: todos estos son precisamente problemas técnicos inevitables para construir un mundo tridimensional interactivo.
En los últimos años, la tecnología acumulada por los fabricantes nacionales en generación visual y edición controlable empieza ahora a mostrar su potencial de extenderse hacia modelos universales del mundo.
En 1895, los hermanos Lumière llevaron a la pantalla un tren que entraba en la estación.
En aquella época, la gente difícilmente habría imaginado que este nuevo invento cambiaría por completo, durante los más de cien años siguientes, la forma en que la humanidad registra y presenta el mundo.
Un siglo después, con la aparición sucesiva de los gráficos por computadora y la tecnología de realidad virtual, la humanidad comenzó a intentar pasar de observar el mundo dentro de una pantalla a experimentar y explorar de forma inmersiva el mundo digital.
Hoy en día, la aparición de modelos del mundo ha dado un nuevo giro a esta evolución tecnológica que lleva más de un siglo—
Las máquinas comienzan a aprender la estructura espacial y las leyes de funcionamiento del mundo real, intentando generar entornos virtuales capaces de explorar de manera continua, interactuar en tiempo real e incluso simular la realidad.
Hace más de cien años, la humanidad aprendió a registrar el mundo con imágenes.
Más de cien años después, empezamos a intentar que la imagen se convierta en un mundo que se puede entrar en persona e incluso cambiar la realidad.
Más de cien años después, esta vez por fin comenzamos a intentar adentrarnos en las imágenes que nosotros mismos creamos.