
Las aplicaciones que enrutan solicitudes, seleccionan acciones de agentes o asignan resultados de políticas a menudo necesitan puntuaciones sobre un conjunto fijo de opciones en lugar de texto de forma libre. Desplegar estos modelos de decisión con llama.cpp en Amazon SageMaker AI le ofrece una ruta administrada para servir modelos cuantizados en infraestructura de CPU o GPU.
Este artículo continúa una serie sobre AWS Deep Learning Containers (DLC) especializados para inferencia de IA generativa. Artículos anteriores cubren WhisperX, vLLM-Omni – Parte 1, y vLLM-Omni – Parte 2.
En esta publicación, primero usará el AWS DLC para llama.cpp para servir finalizaciones de chat compatibles con OpenAI a través de SageMaker AI InvokeEndpoint`. A continuación se extiende el mismo runtime con` SemIf, anteriormente OpenJev, que devuelve probabilidades sobre las opciones declaradas sin decodificar un token de respuesta. El ejemplo de código incluye opciones de despliegue de CPU y GPU.
Descripción general de la solución
La Figura 1 muestra dos rutas de despliegue a partir del mismo modelo empaquetado. La ruta de generación de texto usa el AWS DLC para llama.cpp y devuelve respuestas generadas a través de la API compatible con OpenAI. La ruta de decisión estructurada construye una imagen hija que reemplaza el servidor predeterminado con un adaptador SemIf y devuelve probabilidades para las opciones declaradas.
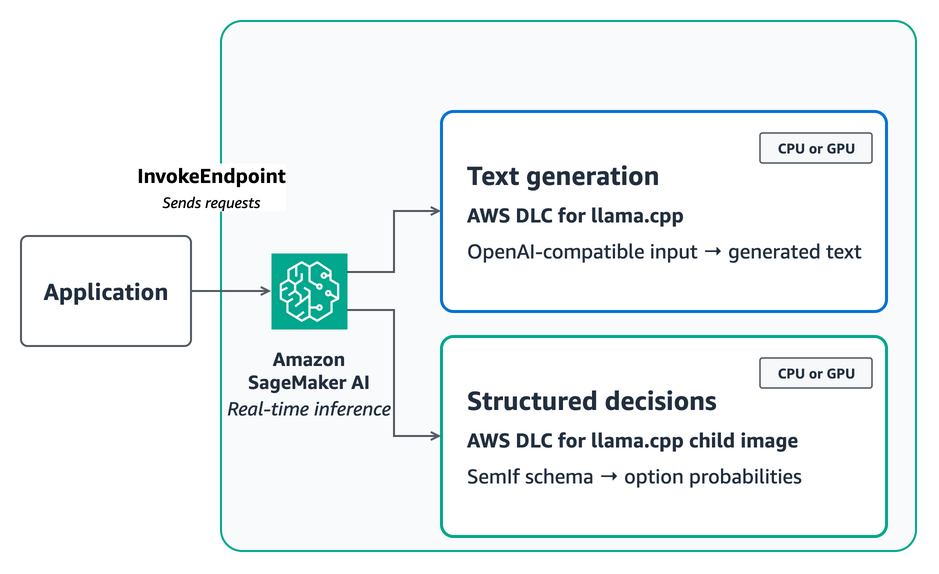
Figura 1: Ejecute el AWS DLC para llama.cpp o la imagen hija de SemIf en CPU o GPU, dependiendo de los requisitos de API y latencia de su carga de trabajo
Para la ruta estándar, empaquete el modelo como model.tar.gz en Amazon Simple Storage Service (Amazon S3) y referencie directamente la imagen DLC publicada. El contenedor encuentra el primer .gguf archivo bajo /opt/ml/model, mapea POST /invocations a llama-server en /v1/chat/completionsy pasa SM_LLAMA_CPP_* variables de entorno a los argumentos de llama.cpp.
La llama-server API HTTP no expone los logits de posición final ni las operaciones de estado que SemIf utiliza. Por lo tanto, la ruta de decisiones estructuradas usa AWS CodeBuild para compilar una imagen secundaria y almacenarla en Amazon Elastic Container Registry (Amazon ECR). La imagen secundaria conserva las bibliotecas CPU o CUDA compiladas del DLC mientras reemplaza su punto de entrada por un adaptador compatible con SageMaker.
Comprenda los esquemas de entrada y salida
El AWS DLC para llama.cpp acepta el esquema de Chat Completions de OpenAI. Envíe un messages array con role y content, además de controles de generación como max_tokens y stream:
{
  "messages": [
    {
      "role": "user",
      "content": "A customer cannot receive a password reset email. Reply with the best support queue."
    }
  ],
  "max_tokens": 64,
  "stream": false
}
La respuesta utiliza el choices array compatible con OpenAI. Lea el texto generado desde choices[0].message.content.
SemIf utiliza un esquema de decisión restringido en lugar de mensajes de chat. La solicitud contiene un ID definido por el llamador, estado no estructurado, una pregunta y una lista ordenada de opciones permitidas:
{
  "decision": {
    "id": "support-route",
    "state": "The customer cannot receive a password reset email.",
    "question": "Which queue should handle this request?",
    "options": [
      {"id": "account_access", "description": "Account access support."},
      {"id": "billing", "description": "Billing support."}
    ]
  }
}
La respuesta devuelve option_ids, probabilities, y el option_logits sin procesar en el mismo orden, junto con el prompt, los tiempos y los metadatos del modelo fijado. Con IDs de opciones estables, su aplicación puede aplicar umbrales, alternativas de reserva y comprobaciones de políticas sin analizar prosa generada.
SemIf pertenece a una clase más amplia de modelos de decisión que puntúan resultados definidos por la aplicación a partir de estado no estructurado. Otras implementaciones incluyen Jev, el modelo de decisión de TypeSafe y su /v1/systemone API; Kev, un servidor de modelos diseñado para la compatibilidad con la API de TypeSafe; y Strands Decider 2B, un modelo construido específicamente para flujos de trabajo de agentes con salidas calibradas.
Elija los flujos de trabajo de decisión adecuados
Utilice este patrón cuando su aplicación define las opciones permitidas en el momento de la solicitud y necesita que un modelo interprete contexto no estructurado. Algunos ejemplos son enrutar un caso a una cola, extraer un valor de un conjunto conocido, asignar una prioridad a un incidente, comprobar el resultado de una política o seleccionar una acción de un agente. Mantenga la autorización y las reglas de negocio deterministas fuera del modelo, y valide las probabilidades del modelo antes de tratarlas como confianza operativa.
Use la ruta estándar de generación de texto de SageMaker AI cuando necesite completaciones de chat compatibles con OpenAI a través de InvokeEndpoint. La imagen de SageMaker AI mapea POST /invocations al endpoint llama-server /v1/chat/completions . Cree una imagen secundaria solo cuando su aplicación necesite un comportamiento que esta interfaz no proporciona, como el acceso directo a los logits y al estado de SemIf.
Eliminar la generación de tokens de respuesta no elimina la inferencia del modelo. El modelo sigue procesando el estado completo, la pregunta y las descripciones de las opciones antes de que SemIf lea los logits finales. Mantenga los prompts enfocados y evalúe el modelo seleccionado con decisiones etiquetadas de su aplicación antes de usarlo en producción.
Ajuste según sus objetivos de latencia y calidad
El siguiente benchmark se aplica a la extensión SemIf, no al endpoint de generación de texto. El tamaño del modelo, la cuantización, la longitud del prompt, el runtime y el número de hilos de CPU afectan cada decisión. Para cuantificar estas compensaciones, enviamos las mismas 231 tareas públicas de JevBench en serie a un endpoint de CPU y a un endpoint de GPU.
| Configuración | AWS DLC para llama.cpp | Respuestas válidas | Precisión | p50 del cliente | p95 del cliente |
Qwen3.5-4B Q4_K_M, ml.c6i.8xlarge, 32 hilos |
llama-cpp:server-sagemaker-cpu-v1 | 231/231 | 179/231 (77.5%) | 1.715 segundos | 19.291 segundos |
Qwen3.5-4B Q4_K_M, ml.g6e.xlarge, descarga completa a GPU |
llama-cpp:server-sagemaker-cuda-v1 | 231/231 | 180/231 (77.9%) | 0.352 segundos | 0.599 segundos |
En comparación con la configuración de CPU, el endpoint de GPU fue 4.9 veces más rápido en p50 y 32.2 veces más rápido en p95. El ejemplo utiliza la función de pools de instancias de SageMaker AI para listar los tipos de instancia de GPU compatibles en orden de prioridad, de modo que SageMaker pueda seleccionar una alternativa cuando la primera preferencia no esté disponible. El pool ordenó g6e, g6, g5, luego g4dn. SageMaker seleccionó ml.g6e.xlarge, y los registros de inicio confirmaron que llama.cpp descargó las 34 capas del modelo a una NVIDIA L40S. Las imágenes de CPU y GPU usaron compilaciones diferentes de llama.cpp y produjeron predicciones diferentes en seis tareas difíciles. Considere la diferencia de precisión de una sola respuesta como variación del runtime, no como evidencia de que la descarga a GPU mejore la calidad del modelo.
Los modelos más pequeños redujeron la latencia mediana, pero los candidatos de 2B y 0.8B lograron una precisión de 66.7 por ciento y 58.4 por ciento. Por lo tanto, el ejemplo conserva el modelo de 4B Q4_K_M como su valor predeterminado centrado en la calidad. Estas mediciones incluyen la latencia de red y no son garantías del servicio.
Evalúe con benchmark la configuración completa de modelo e infraestructura frente a sus propias decisiones. Use CPU para cargas de trabajo en segundo plano, sin conexión o de bajo rendimiento que no sean sensibles a la latencia y que puedan tolerar segundos de tiempo de respuesta. Use GPU para decisiones interactivas, prompts largos o cargas de trabajo con objetivos estrictos de latencia de cola. Mantenga el estado y las descripciones de las opciones concisas, agrupe las decisiones que comparten el mismo estado en una sola solicitud y escale las instancias del endpoint para la concurrencia. La puntuación de estado compartido reutiliza el prefijo común del prompt, mientras que el adaptador devuelve HTTP reintentables 503 respuestas en lugar de permitir una cola sin límites alrededor de su contexto con estado de llama.cpp.
Requisitos previos
Necesita:
- Una cuenta de AWS y un bucket de S3 en su región de AWS de despliegue.
- Python 3.10 o posterior, Git y la Interfaz de línea de comandos de AWS (AWS CLI).
- Un rol de servicio de CodeBuild específico para la extensión opcional SemIf.
- Un rol de AWS Identity and Access Management (IAM) que SageMaker AI pueda asumir.
- Permisos para SageMaker AI, Amazon ECR, Amazon S3, CodeBuild, acciones de IAM pass-role y Amazon CloudWatch Logs.
- Cuota para un endpoint en tiempo real de SageMaker compatible con CPU x86 o GPU NVIDIA.
El ejemplo de generación de texto usa el DLC de CPU y una instancia de CPU fija. La extensión SemIf mantiene CPU como predeterminada para cargas de trabajo que no son sensibles a la latencia y ofrece una imagen CUDA opcional con pools de instancias ordenados. Revise los precios de SageMaker AI antes de crear un endpoint.
Desplegar un modelo de decisión y extenderlo con SemIf
Use el siguiente procedimiento para desplegar el endpoint estándar de generación de texto y luego compilar la extensión opcional SemIf para decisiones estructuradas en CPU o GPU.
- Clone el código de ejemplo e instale sus dependencias.
git clone https://github.com/aws-samples/sagemaker-genai-hosting-examples.git cd sagemaker-genai-hosting-examples/03-features/semif-decision-model python3 -m venv .venv . .venv/bin/activate python3 -m pip install -r deploy/requirements.txt - Establezca los valores de despliegue para su cuenta.
export AWS_REGION="<your-region>" export ARTIFACT_BUCKET=amzn-s3-demo-semif-artifacts export CODEBUILD_ROLE_ARN=arn:aws:iam::111122223333:role/semif-codebuild-role export SAGEMAKER_ROLE_ARN=arn:aws:iam::111122223333:role/semif-sagemaker-role export STANDARD_ENDPOINT_NAME=llamacpp-gguf export SEMIF_ENDPOINT_NAME=semif-decision-workflows - Empaquete el modelo GGUF fijado y el tokenizer con CodeBuild.
python deploy/prepare_model_build.py \
  --region "$AWS_REGION" \
  --bucket "$ARTIFACT_BUCKET" \
  --codebuild-role-arn "$CODEBUILD_ROLE_ARN" \
  --model-s3-uri "s3://$ARTIFACT_BUCKET/semif-llamacpp/model.tar.gz"
Espere a que el ID de compilación devuelto alcance
SUCCEEDED. La compilación registra las revisiones de origen y los checksums enmodel-manifest.jsony se detiene si el checksum del GGUF difiere del valor validado. - Despliegue el modelo GGUF con el AWS DLC para llama.cpp.
Resuelva una imagen
server-sagemaker-cpu-v1fijada por digest desde la documentación del AWS DLC para llama.cpp, luego cree el modelo de SageMaker AI, la configuración del endpoint y el endpoint:export STANDARD_IMAGE_URI="<published-llama-cpp-cpu-image>@sha256:<digest>" python deploy/deploy_standard_endpoint.py \ --region "$AWS_REGION" \ --image-uri "$STANDARD_IMAGE_URI" \ --model-data-url "s3://$ARTIFACT_BUCKET/semif-llamacpp/model.tar.gz" \ --role-arn "$SAGEMAKER_ROLE_ARN" \ --instance-type ml.c6i.2xlarge \ --name "$STANDARD_ENDPOINT_NAME"Seleccione una imagen
server-sagemaker-cpu-v1oserver-sagemaker-cuda-v1en lugar de la imagen EC2 correspondiente. Las imágenes de SageMaker AI implementan el contrato de contenedor/pingy/invocationsy mapean las cargas de invocación a completaciones de chat.Este recorrido suministra el modelo GGUF mediante el artefacto del modelo de SageMaker AI en Amazon S3. Como alternativa, puede configurar
SM_LLAMA_CPP_HF_REPOySM_LLAMA_CPP_HF_FILEpara descargar un archivo GGUF desde Hugging Face cuando el endpoint tenga salida de red.No necesita un Dockerfile ni un repositorio de ECR para esta vía. Espere a que el endpoint entre en
InService, luego envíe una solicitud de chat compatible con OpenAI:python deploy/invoke_standard_endpoint.py \ --region "$AWS_REGION" \ --endpoint-name "$STANDARD_ENDPOINT_NAME" - Compile la imagen secundaria opcional de SemIf y resuelva su digest inmutable.
Para CPU:
python deploy/prepare_build.py \
  --region "$AWS_REGION" \
  --bucket "$ARTIFACT_BUCKET" \
  --codebuild-role-arn "$CODEBUILD_ROLE_ARN"
Para GPU, compile en su lugar la imagen secundaria de CUDA:
python deploy/prepare_build.py \
  --region "$AWS_REGION" \
  --bucket "$ARTIFACT_BUCKET" \
  --codebuild-role-arn "$CODEBUILD_ROLE_ARN" \
  --dockerfile Dockerfile.gpu \
  --image-tag "gpu-$(date +%Y%m%d%H%M%S)"
Después de que la compilación se complete con éxito, construya el URI de imagen inmutable:
ECR_REPOSITORY_URI=$(aws ecr describe-repositories \
  --region "$AWS_REGION" \
  --repository-names semif-llamacpp-dlc \
  --query 'repositories[0].repositoryUri' \
  --output text)
IMAGE_DIGEST=$(aws ecr describe-images \
  --region "$AWS_REGION" \
  --repository-name semif-llamacpp-dlc \
  --query 'sort_by(imageDetails,&imagePushedAt)[-1].imageDigest' \
  --output text)
export IMAGE_URI="${ECR_REPOSITORY_URI}@${IMAGE_DIGEST}"
El script de despliegue rechaza etiquetas de imagen mutables.
- Despliegue el endpoint de SemIf.
La configuración de CPU usa un tipo de instancia fijo:
python deploy/deploy_endpoint.py \
  --region "$AWS_REGION" \
  --image-uri "$IMAGE_URI" \
  --model-data-url "s3://$ARTIFACT_BUCKET/semif-llamacpp/model.tar.gz" \
  --role-arn "$SAGEMAKER_ROLE_ARN" \
  --instance-type ml.c6i.8xlarge \
  --threads 32 \
  --name "$SEMIF_ENDPOINT_NAME"
Espere a que el nombre de endpoint devuelto entre en
InService. Esta vía establecen_gpu_layers=0. El adaptador serializa la puntuación alrededor de un único contexto con estado de llama.cpp, así que escale horizontalmente con instancias de endpoint después de medir su carga de trabajo en lugar de asumir puntuación paralela dentro de un contenedor.Para la imagen de GPU, proporcione grupos de instancias ordenados y solicite la descarga completa del modelo:
python deploy/deploy_endpoint.py \
  --region "$AWS_REGION" \
  --image-uri "$IMAGE_URI" \
  --model-data-url "s3://$ARTIFACT_BUCKET/semif-llamacpp/model.tar.gz" \
  --role-arn "$SAGEMAKER_ROLE_ARN" \
  --instance-pool ml.g6e.xlarge \
  --instance-pool ml.g6.2xlarge \
  --instance-pool ml.g5.2xlarge \
  --instance-pool ml.g4dn.2xlarge \
  --gpu-layers=-1 \
  --provision-timeout 1200 \
  --name "$SEMIF_ENDPOINT_NAME"
Los instance pools son alternativas ordenadas de ubicación, no un balanceo de carga de inferencia. SageMaker selecciona un tipo disponible para la variante. La creación del endpoint puede tardar más mientras SageMaker AI recorre el pool. Revise los registros de inicio para ver la GPU seleccionada y un mensaje que confirme que todas las capas del modelo fueron descargadas.
- Invoque el endpoint de SemIf con la decisión de ejemplo.
La solicitud declara identificadores estables para cada opción permitida:
{
  "decision": {
    "id": "support-route",
    "state": "Customer asks to reset a forgotten password and says the reset email never arrived.",
    "question": "Which queue should handle this request?",
    "options": [
      {"id": "account_access", "description": "Account access and authentication support."},
      {"id": "billing", "description": "Billing and payment support."},
      {"id": "sales", "description": "Sales and product evaluation."}
    ]
  }
}
python deploy/invoke_endpoint.py \ --region "$AWS_REGION" \ --endpoint-name "$SEMIF_ENDPOINT_NAME"La respuesta conserva el orden de las opciones e incluye probabilidades condicionales, logits brutos, metadatos de token y de prompt, y la identidad del modelo fijado:
{
  "result": {
    "id": "support-route",
    "option_ids": ["account_access", "billing", "sales"],
    "probabilities": [0.99996, 0.00003, 0.00001],
    "option_logits": [28.47, 17.92, 17.04],
    "prompt_sha256": "016267542103ab91422c425d2234ec7e1b9aef77f9d3e481b96db2de7cca470a",
    "readout": "quantized last-position logits restricted to declared answer slots; no generated tokens"
  }
}
Aplique umbrales y alternativas a nivel de aplicación. No utilice una decisión del modelo como sustituto de la autorización.
Limpieza
Elimine el endpoint, la configuración del endpoint y el modelo de SageMaker AI:
python deploy/cleanup_endpoint.py \
  --region "$AWS_REGION" \
  --name "$STANDARD_ENDPOINT_NAME"

python deploy/cleanup_endpoint.py \
  --region "$AWS_REGION" \
  --name "$SEMIF_ENDPOINT_NAME"
El script elimina únicamente los recursos de SageMaker AI explícitamente nombrados. Elimine los proyectos de CodeBuild, el repositorio de ECR, los objetos de modelo y de origen en Amazon S3, los registros y los roles de IAM de propósito específico cuando ya no los necesite.
Conclusión
El AWS DLC para llama.cpp le ofrece una base administrada para servir modelos de decisión en SageMaker AI en instancias de CPU y GPU. Puede cargar modelos GGUF desde artefactos de modelo de SageMaker AI o desde un repositorio de Hugging Face configurado, y luego servir chat completions compatibles con OpenAI a través de InvokeEndpoint sin necesidad de un contenedor personalizado. Cuando su aplicación necesite acceso directo a los logits y a las operaciones del estado del modelo, puede extender el DLC con un adaptador de SemIf. Elija CPU para cargas de trabajo que no sean sensibles a la latencia, y elija GPU cuando el prefill del prompt y la latencia final afecten la experiencia de la aplicación.
Revise el ejemplo de código, documentación del AWS DLC para llama.cppy el contrato de contenedores de inferencia personalizados de SageMaker AI para adaptar la implementación a su carga de trabajo.