
Esta publicación muestra cómo desplegar un modelo de lenguaje grande (LLM) en dos nodos GPU en Amazon Elastic Kubernetes Service (Amazon EKS) con los Ray LLM Deep Learning Containersmulti-nodo. Utiliza nodos de prefill y decode separados detrás de un único endpoint compatible con OpenAI. Este tipo de configuración multi-nodo es común para el paralelismo de tensores, pipeline y datos, así como para cargas de trabajo de inferencia con disagregación de prefill/decode. En una publicación anterior, presentamos los Ray Serve DLC y los usamos para levantar un modelo pequeño detrás de un endpoint HTTP en un único nodo GPU. Usted tenía un endpoint de inferencia funcional, y el contenedor mantiene la pila de GPU compatible, incluidas las librerías CUDA, por lo que no necesitaba escribir código repetitivo.
Ray es un framework de computación distribuida, por lo que los despliegues de Ray Serve pueden abarcar múltiples nodos. Los clientes usan Ray Serve multi-nodo por varias razones. Algunos quieren ejecutar modelos fundacionales o de pesos abiertos que son demasiado grandes para una única GPU. Otros necesitan más rendimiento del que una sola réplica puede entregar. Otros más quieren separar las dos fases de inferencia para mejorar el rendimiento. En cada caso, los clientes deben construir ellos mismos la cadena de dependencias: elegir librerías compatibles para la pila de GPU y depurar problemas cuando un componente se desalinea. Este es un trabajo no diferenciado que quita tiempo y esfuerzo a la entrega de modelos.
AWS Deep Learning Containers (DLC) ha resuelto durante mucho tiempo este tipo de problemas para cargas de trabajo de entrenamiento e inferencia. Los DLC son imágenes Docker preconstruidas y optimizadas para el rendimiento que agrupan un framework, sus dependencias y la pila de GPU en una combinación probada y corregida que puede descargar y usar de inmediato. Con el lanzamiento del Ray LLM DLC para despliegues multi-nodo, ese mismo enfoque ahora se extiende a la inferencia multi-nodo. Usted obtiene un contenedor diseñado específicamente para servir modelos detrás de un endpoint HTTP, mantenido y probado por AWS, con toda la pila de inferencia ya ensamblada.
Esta publicación recorre la implementación de inferencia disagregada multi-nodo usando el Ray LLM DLC multi-nodo: desplegar un único modelo de lenguaje grande a través de dos nodos con GPU en Amazon EKS que cooperan detrás de un único endpoint. Mientras uno de los nodos GPU maneja la fase de prefill, el otro nodo GPU maneja la fase de decode. Separar las fases evita que los prompts largos con uso intensivo de cómputo bloqueen la generación de tokens para las solicitudes ya en curso. Este enfoque es adecuado para cargas de trabajo como Generación Aumentada por Recuperación (RAG), resumen de documentos y aplicaciones agénticas. Usamos el Ray LLM DLC multi-nodo, que incluye Ray Serve LLM, NVIDIA Inference Transfer Library (NIXL), y la pila de Elastic Fabric Adapter (EFA) , y expone una API compatible con OpenAI sin código de aplicación. El código completo está disponible en el repositorio adjunto.
Por qué la disagregación de prefill/decode (PD)
La inferencia de LLM tiene dos fases distintas. Prefill procesa todo el prompt de entrada en paralelo y construye la caché de clave-valor (KV). Decode luego genera la respuesta un token a la vez, leyendo y extendiendo esa caché. Prefill está limitado por cómputo, y Decode está limitado por el ancho de banda de memoria. Cuando ambas fases comparten una GPU, compiten por los mismos recursos, y el trabajo de prefill, irregular e intensivo en cómputo, interfiere con el trabajo de decode, constante y sensible a la latencia. Separar la fase de prefill de la fase de decode significa que puede seleccionar el hardware y las propiedades de servicio para cada fase, mejorando el rendimiento general a escala.
La disagregación de PD coloca las dos fases en nodos separados, por lo que cada fase se ejecuta sin interferir con la otra y puede escalarse de forma independiente. La contrapartida es que la caché KV construida durante el prefill debe entregarse al nodo de decode, y esa transferencia debe ser lo suficientemente rápida como para no borrar el beneficio. Eso es exactamente por lo que importa la interconexión entre los nodos.
Lo que proporciona el DLC de Ray LLM
Las AWS DLC son imágenes de Docker preconstruidas y optimizadas para el rendimiento que empaquetan un framework, sus dependencias y la pila de GPU en una combinación probada y parcheada que puedes descargar y usar de inmediato. Todos los componentes se validan juntos antes de cada versión, por lo que no hay desviación de versiones entre el runtime de CUDA, el framework y la capa de servicio. Los parches de seguridad se aplican en el momento de la compilación.
El Ray LLM DLC extiende esto al servicio distribuido de LLM. Incluye vLLM como motor de inferencia, el HTTP de Ray Serve como capa de servicio, NIXL para la transferencia de la caché KV entre nodos, y la pila EFA (libfabric y aws-ofi-nccl) para la comunicación entre nodos de alto ancho de banda. Debido a que la Ray Serve LLM library incluye un constructor de aplicaciones integrado, toda la aplicación de servicio es un bloque de YAML. No hay clase de manejador, ni archivador de modelos, ni imagen personalizada que compilar. Un único helper, build_pd_openai_app, toma una configuración de prefill y una configuración de decode y conecta la transferencia de la caché KV entre ellas detrás de un único endpoint compatible con OpenAI.
Arquitectura
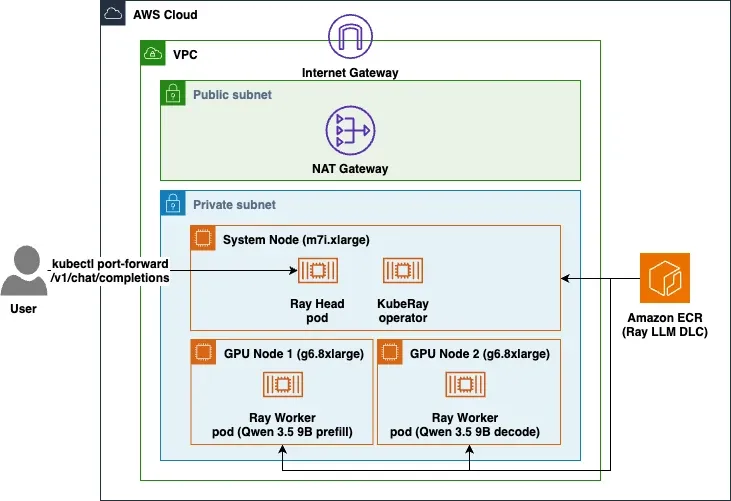
El siguiente diagrama muestra cómo se estructura el despliegue en Amazon EKS. Una solicitud de usuario llega al head de Ray en el nodo de sistema CPU, y los dos nodos GPU worker ejecutan las fases de prefill y decode del modelo.
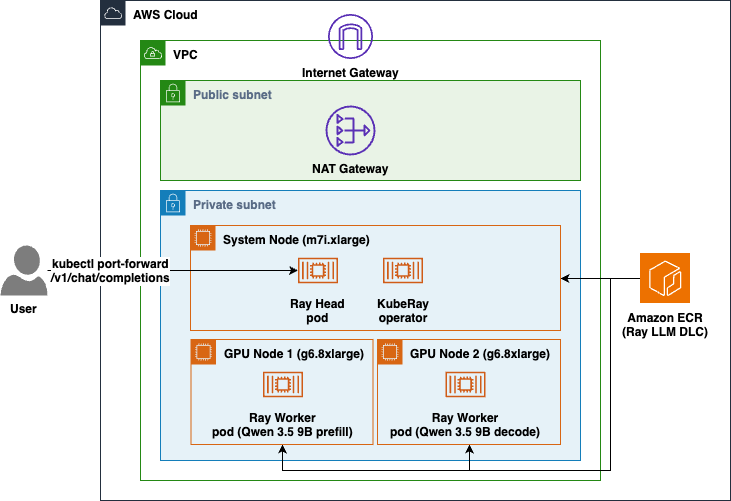
Figura 1: Arquitectura de inferencia multi-nodo en Amazon EKS, con el head de Ray en un nodo de sistema CPU y las fases de prefill y decode en dos nodos GPU worker
El despliegue es un clúster de EKS dentro de una nube privada virtual (VPC). Los nodos se ejecutan en subredes privadas con acceso de salida a través de una NAT Gateway. Un nodo de sistema CPU system node (m7i.xlarge) aloja las cargas de trabajo del sistema, el operador KubeRay y el pod del head de Ray, que es solo CPU. Dos nodos GPU worker nodes (g6.8xlarge) ejecutan los workers de Ray: uno sirve la fase de prefill y el otro sirve la fase de decode. Ambos nodos descargan el Ray LLM DLC desde Amazon Elastic Container Registry (Amazon ECR).
KubeRay observa el RayService que aplicas y conecta automáticamente la unión head-to-worker. Ray Serve coloca los despliegues de prefill y decode en los dos workers GPU. La caché KV fluye del worker de prefill al worker de decode a través de NIXL, usando EFA mediante el backend libfabric de NIXL. El grupo de nodos GPU está fijado a una única Availability Zone (AZ) porque EFA no puede cruzar AZ.
Requisitos previos
Para seguir esta publicación, necesitas:
- Una cuenta de AWS con facturación habilitada.
- Cuota de servicio suficiente para ejecutar dos instancias g6.8xlarge (al menos 64 vCPU) en tu Región de destino.
- AWS Command Line Interface (AWS CLI) con credenciales configuradas.
- CLI de kubectl para comunicarse con el plano de control de un clúster de Kubernetes.
- CLI de eksctl para crear y gestionar clústeres en EKS.
- helm (gestor de paquetes de Kubernetes) para instalar el operador KubeRay.
- utilidad envsubst (parte de GNU gettext) para renderizar el manifiesto.
Verifique que sus credenciales de AWS estén activas con el siguiente comando:
aws sts get-caller-identityUse la aplicación preconstruida para servir inferencia
La aplicación es el bloque serveConfigV2 en manifest/rayservice.yaml. Utiliza build_pd_openai_app, que toma un prefill_config y un decode_config y conecta la transferencia de KV-cache entre ellos:
applications:
- name: qwen
  import_path: ray.serve.llm:build_pd_openai_app # OpenAI-compatible PD app, built in
  route_prefix: /
  args:
    prefill_config:
      model_loading_config: { model_id: qwen3.5-9b, model_source: Qwen/Qwen3.5-9B }
      engine_kwargs:
        max_model_len: 4096
        dtype: bfloat16
        gpu_memory_utilization: 0.90
        enforce_eager: true # Skip CUDA graph capture to reduce peak GPU memory
      kv_transfer_config:
        kv_connector: NixlConnector
        kv_role: kv_both
        engine_id: prefill
        kv_connector_extra_config: { backends: ["LIBFABRIC"] }
      deployment_config: { num_replicas: 1 }
    decode_config:
      model_loading_config: { model_id: qwen3.5-9b, model_source: Qwen/Qwen3.5-9B }
      engine_kwargs:
        max_model_len: 4096
        dtype: bfloat16
        gpu_memory_utilization: 0.90
        enforce_eager: true
      kv_transfer_config:
        kv_connector: NixlConnector
        kv_role: kv_both
        engine_id: decode
        kv_connector_extra_config: { backends: ["LIBFABRIC"] }
      deployment_config: { num_replicas: 1 }
Pocas configuraciones llevan la mayor parte del peso. max_model_len: 4096 ajusta el tamaño del contexto para que quepa el KV cache medido en la GPU. dtype: bfloat16 y gpu_memory_utilization: 0.90 establecen la precisión y cuánta VRAM puede reclamar vLLM. enforce_eager: true omite la captura de grafos CUDA para reducir el pico de memoria de GPU (depende del modelo y de la entrada). La configuración kv_transfer_config es lo que hace funcionar la desagregación: ambas fases usan NixlConnector con kv_role: kv_both y un engine_id distinto (prefill en uno, decode en el otro). La configuración crítica es kv_connector_extra_config: { backends: ["LIBFABRIC"] }. Sin esa línea, NIXL usa por defecto UCX, que funciona a velocidad TCP incluso en EFA.
El resto del manifiesto, en rayClusterConfig, describe los pods. El pod head es solo de CPU (num-gpus: "0") y está fijado al grupo de nodos del sistema. Cada pod worker solicita una GPU y una interfaz EFA (nvidia.com/gpu: "1", vpc.amazonaws.com/efa: "1") y apunta a los nodos de GPU mediante nodeSelector: { role: gpu-worker }. Se ejecuta con privileged: true porque NIXL registra la VRAM de CUDA en la NIC de EFA. La capacidad IPC_LOCK por sí sola no es suficiente. Los workers establecen FI_PROVIDER=efa, leen VLLM_HOST_IP de la IP del pod y montan un volumen de memoria compartida. Los límites de memoria se sitúan muy por encima de los aproximadamente 18 GiB del checkpoint para que la caché de páginas del SO pueda retenerlo. Para la carga del modelo Qwen3.5-9B en g6.8xlarge con la configuración de caché anterior, la carga de los pesos del modelo pasa de alrededor de 145 segundos a unos 2 segundos en el reinicio.
Despliegue en Amazon EKS
Todos los scripts comparten un único archivo de configuración, scripts/env.sh. El script contiene valores predeterminados para CLUSTER_NAME, REGION, K8S_VERSION, y NAMESPACE. Otros valores predeterminados cubren los grupos de nodos del sistema y de GPU, la versión de KubeRay y el modelo. Anule cualquier variable exportándola antes de ejecutar un script.
Desde la raíz del proyecto, establezca un directorio base y luego cargue las variables:
CURRENT_DIR=$(pwd)
cd $CURRENT_DIR/ray-serve-multi-node/scripts
source ./env.sh
Paso 1: Crear el clúster de EKS
./deploy_cluster.shEsto aprovisiona el clúster de EKS (VPC, proveedor OIDC, complementos principales) y un grupo de nodos de sistema con CPU que ejecuta las cargas de trabajo del sistema, el operador de KubeRay y el head de Ray. Los nodos se ejecutan en subredes privadas con salida a través de una NAT Gateway, y las subredes del clúster se colocan en las AZ que ofrecen el tipo de instancia de GPU. El script es idempotente y tarda entre 15 y 20 minutos en una ejecución inicial.
Paso 2: Añadir nodos trabajadores de GPU
./deploy_node_group.shEsto crea el grupo de nodos de GPU: dos instancias g6.8xlarge con EFA habilitado, fijadas a una única AZ y etiquetadas role=gpu-worker para que los trabajadores de Ray las apunten. Habilitar EFA también instala el plugin de dispositivos EFA, que anuncia vpc.amazonaws.com/efa en cada nodo. Este paso tarda entre 5 y 20 minutos, normalmente más en la primera ejecución.
Paso 3: Instalar el operador de KubeRay
./install_kuberay.shEsto instala el operador de KubeRay usando Helm, fijado al grupo de nodos del sistema para mantener los nodos de GPU disponibles para la inferencia. KubeRay observa el RayService que aplique a continuación y configura automáticamente la unión entre head y trabajadores. Este paso tarda entre 1 y 2 minutos.
Paso 4: Desplegar el RayService
./deploy_ray_service.shEsto genera manifest/rayservice.yaml con sus variables de imagen, modelo y nombres usando envsubst y lo aplica. KubeRay crea el head y dos pods de trabajadores, y Ray Serve LLM pone en marcha los despliegues de prefill y decode. El script espera a que el head esté Ready, que ambos trabajadores estén Running y, finalmente, a que la aplicación de Serve informe RUNNING. Como cada nodo carga el modelo, espere que este paso tarde varios minutos.
Compruebe el estado en cualquier momento, incluyendo en qué nodo aterrizó cada pod y la capacidad de GPU disponible:
./deploy_ray_service.sh statusInvocar el modelo
Después de que la aplicación de Serve esté saludable, KubeRay crea un Service <rayservice-name>-serve-svc estable. Haga port-forward hacia él:
kubectl port-forward -n inference svc/ray-llm-serve-svc 8000:8000Dado que el DLC expone una API compatible con OpenAI, puede listar los modelos y enviar una solicitud estándar de chat-completion sin esquema personalizado:
curl --silent http://127.0.0.1:8000/v1/models
curl --fail --silent --show-error \
  --request POST "http://127.0.0.1:8000/v1/chat/completions" \
  --header "Content-Type: application/json" \
  --data '{
    "model": "qwen3.5-9b",
    "messages": [
      {"role": "user", "content": "Explain the benefits of prefill/decode disaggregation."}
    ],
    "max_tokens": 200,
    "temperature": 0.7
  }'
Verificar que se esté usando EFA
NIXL recurre a un transporte de velocidad TCP si no puede usar libfabric, y lo hace sin generar un error, por lo que vale la pena confirmar el backend que eligió. Busque en los registros del trabajador:
for POD in $(kubectl get pods -n inference -l ray.io/node-type=worker \
  -o jsonpath='{.items[*].metadata.name}'); do
  kubectl exec -n inference "$POD" -c ray-worker -- \
    grep -rhoE "Backend (LIBFABRIC|UCX) was instantiated" /tmp/ray/session_latest/logs/ 2>/dev/null
done | sort | uniq -c
deploy_node_group.sh ya imprime el conteo de vpc.amazonaws.com/efa por nodo cuando crea el grupo. Para obtener una cifra de ancho de banda entre nodos, el DLC incluye un benchmark precompilado de NVIDIA Collective Communications Library (NCCL) en /usr/local/bin/all_reduce_perf.
Limpieza
Para evitar cargos continuos, elimine los recursos en orden inverso:
./delete_ray_service.sh # Remove the RayService
./install_kuberay.sh cleanup # Uninstall the KubeRay operator
./delete_node_group.sh # Remove the GPU node group
./delete_cluster.sh # Delete the EKS cluster
Conclusión y próximos pasos
Sirvió un único modelo en dos nodos de GPU con disagregación de prefill/decode, y toda la aplicación fue un bloque de YAML, sin código de manejadores, sin model archiver y sin una pila de GPU y EFA ensamblada a mano. El DLC de Ray LLM multi-nodo suministró la pila de inferencia probada, KubeRay orquestó el clúster de Ray, y NIXL sobre EFA transportó la caché KV entre los nodos. Su trabajo fue configurarlo, no construirlo.
Los patrones comunes para ejecutar inferencia multi-nodo incluyen el paralelismo de tensores y de canalización (fragmentar un modelo demasiado grande para una instancia), el paralelismo de datos (replicar un modelo para aumentar el rendimiento) y la disagregación de prefill/decode (separar las dos fases de la inferencia en nodos distintos).
Desde aquí puede escalar las réplicas de decode para obtener más rendimiento, pasar a modelos más grandes con paralelismo de tensores o de canalización en instancias de GPU mayores, o añadir bibliotecas adicionales sobre la misma base probada para los modelos que las necesiten. Para el código completo, la lista actual de etiquetas de imagen y los mecanismos subyacentes, consulte el repositorio que acompaña al artículo, la página de imágenes disponibles del DLC de Ray LLM, la documentación de prefill/decode de Ray Serve LLM, y la documentación de EFA.