
La inferencia de una sola Región puede experimentar limitación cuando la demanda supera la capacidad local. Los equipos en Tailandia, Malasia, Singapur, Indonesia y Taiwán necesitan acceso a los modelos de OpenAI más recientes más allá de esa capacidad. Amazon Bedrock ofrece OpenAI GPT-6 Sol y GPT-6 Luna mediante inferencia global entre Regiones desde las cinco Regiones de AWS, y GPT-6 Astra desde Asia Pacífico (Singapur). Esta publicación le muestra cómo configurar la llamada, establecer permisos y monitorizar la inferencia desde su Región de origen.
GPT-6 Sol, GPT-6 Luna y GPT-6 Astra están disponibles mediante inferencia global entre Regiones desde las Regiones anteriores, en el bedrock-runtime endpoint. Consulte Cross-Region inference en la Amazon Bedrock User Guide. Para ver la lista completa de Regiones de origen y destino en cada perfil, consulte Supported Regions and models for inference profiles.
En esta publicación, presentamos los perfiles de inferencia global entre Regiones y los invocamos desde Asia Pacífico (Singapur) mediante la API Converse, las API compatibles con OpenAI y clientes de programación. Luego cubrimos la configuración de AWS Identity and Access Management (IAM) y de la política de control de servicios (SCP), la gestión de cuotas y la monitorización.
Perfiles de inferencia global entre Regiones para OpenAI GPT-6
La familia GPT-6 ofrece tres modelos, cada uno disponible mediante inferencia global entre Regiones.
- GPT-6 Sol aporta potentes capacidades de razonamiento y programación a tareas complejas realizadas durante toda la semana.
- GPT-6 Luna hace que las tareas enfocadas y repetibles sean prácticas a gran volumen.
- GPT-6 Astra gestiona razonamiento complejo, programación y trabajo con documentos largos.
Los tres aceptan entrada de texto e imágenes, uso de herramientas del lado del cliente y almacenamiento en caché de prompts. Se diferencian en el esfuerzo de razonamiento. GPT-6 Sol y GPT-6 Luna aceptan none, low, medium, high, xhigh y max. GPT-6 Astra acepta los mismos niveles excepto none. Para GPT-6 Sol y GPT-6 Luna, consulte Aporta más inteligencia al trabajo cotidiano con GPT-6 Sol y GPT-6 Luna en Amazon Bedrock. Para GPT-6 Astra, consulte Take on your most ambitious work with GPT-6 Astra on Amazon Bedrock.
La inferencia global entre Regiones enruta las solicitudes a través de las Regiones comerciales de AWS admitidas donde el modelo está implementado, brindándole un amplio acceso a la capacidad de Amazon Bedrock. La invoca pasando un ID de perfil de inferencia global entre Regiones en lugar de un ID de modelo. Su Región de origen es donde realiza la llamada a la API. Amazon Bedrock selecciona la Región de destino para el procesamiento. La facturación, el seguimiento de cuotas, AWS CloudTrail y Amazon CloudWatch permanecen en su Región de origen.
La siguiente tabla enumera los ID de los perfiles de inferencia global entre Regiones y las Regiones de origen cubiertas en esta publicación.
| Perfiles de inferencia global entre Regiones | Regiones de origen | Regiones de destino |
|
global.openai.gpt-6-sol global.openai.gpt-6-luna |
Asia Pacífico (Singapur) ap-southeast-1 Asia Pacífico (Yakarta) ap-southeast-3 Asia Pacific (Malasia) ap-southeast-5 Asia Pacific (Tailandia) ap-southeast-7 Asia Pacific (Taipéi) ap-east-2 |
Regiones comerciales de AWS admitidas donde el modelo está implementado |
| global.openai.gpt-6-astra | Asia Pacific (Singapur) ap-southeast-1 | Regiones comerciales de AWS admitidas donde el modelo está implementado |
La disponibilidad de los perfiles de inferencia y la compatibilidad de Regiones cambian a medida que AWS agrega Regiones y perfiles, por lo que debe confirmar ambos en la tarjeta del modelo antes de desarrollar: GPT-6 Sol, GPT-6 Lunay GPT-6 Astra. Para ver las tarifas por token, consulte Amazon Bedrock pricing.
Getting started with OpenAI models on Amazon Bedrock
Comience con los requisitos previos y luego invoque cualquiera de los tres perfiles mediante la API de Converse, las API compatibles con OpenAI o su cliente de codificación existente.
Requisitos previos
- Una identidad de IAM con permiso para invocar el perfil. La política de IAM de la sección Security and permissions concede únicamente lo que estos ejemplos necesitan.
- Su Región de origen activada. Solo es necesario activar la Región desde la que realiza las llamadas. No se activan las Regiones de destino, que se ejecutan en capacidad gestionada de Amazon Bedrock. Singapur (
ap-southeast-1) es una Región habilitada de forma predeterminada. Yakarta (ap-southeast-3), Malasia (ap-southeast-5), Tailandia (ap-southeast-7) y Taipéi (ap-east-2) son Regiones de admisión (opt-in) que debe activar primero. Para más información, consulte Enable or disable AWS Regions in your account. - Un SDK o CLI de AWS actualizado. Los ejemplos compatibles con OpenAI también requieren el SDK de OpenAI y el generador de tokens de Amazon Bedrock. Instálelos con
pip install boto3 openai aws-bedrock-token-generator.
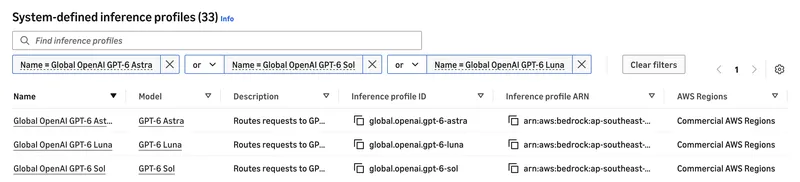
La consola de Amazon Bedrock enumera los tres perfiles globales de inferencia entre Regiones bajo los perfiles de inferencia definidos por el sistema. Véase la Figura 1.
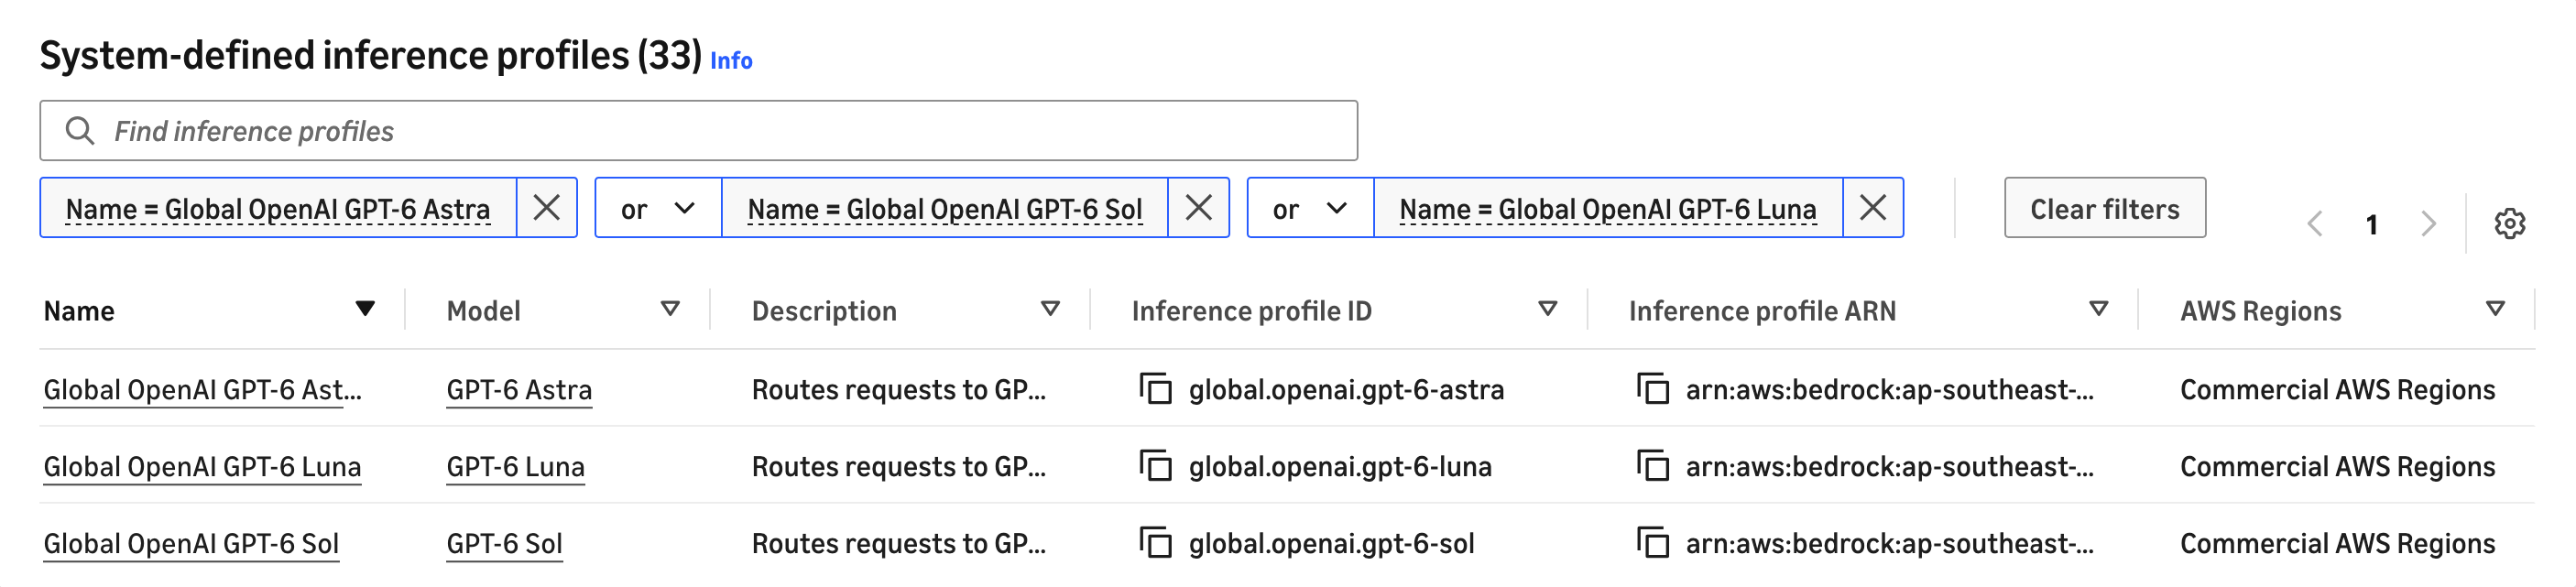
Figura 1: Los tres perfiles globales de inferencia de OpenAI GPT-6 entre los perfiles definidos por el sistema en la consola de Amazon Bedrock
Invocar modelos GPT-6 a través de Amazon Bedrock Runtime
Cada modelo admite tres rutas de acceso en este endpoint: la API Converse de Amazon Bedrock, la API Responses de OpenAI y la API Chat Completions de OpenAI. Las API compatibles con OpenAI se llaman en las rutas de /openai/v1 en lugar de a través de los SDK de AWS, y el endpoint acepta tanto Signature Version 4 (SigV4) como una clave de API de Amazon Bedrock. Pase el ID del perfil global de inferencia entre Regiones como model en todos los casos.
API Converse. Este ejemplo llama a GPT-6 Sol desde Asia Pacífico (Singapur) y registra la respuesta. Establezca BEDROCK_PROFILE_ID en global.openai.gpt-6-luna o global.openai.gpt-6-astra para cambiar de modelo, o llame a converse_stream para transmisión (streaming).
import logging
import os
import boto3

# AWS_REGION overrides this default, so set it to your source Region or unset it.
REGION = os.environ.get("AWS_REGION", "ap-southeast-1")
PROFILE_ID = os.environ.get("BEDROCK_PROFILE_ID", "global.openai.gpt-6-sol")
PROMPT = (
    "In three bullet points, explain when a workload should use "
    "cross-Region inference instead of calling a model in a single Region."
)

logging.basicConfig(format="%(levelname)s %(message)s")
log = logging.getLogger("bedrock-cris")
log.setLevel(logging.INFO)

client = boto3.client("bedrock-runtime", region_name=REGION)

# AccessDeniedException points at the IAM policy. ValidationException usually
# means the model ID is not a global cross-Region inference profile.
response = client.converse(
    modelId=PROFILE_ID,
    messages=[{"role": "user", "content": [{"text": PROMPT}]}],
    inferenceConfig={"maxTokens": 1024},
    # GPT-6 Sol and Luna accept none through max. GPT-6 Astra rejects none.
    additionalModelRequestFields={"reasoning": {"effort": "low"}},
)

# Any effort above none can prepend a reasoningContent block, so pick the text
# block by key rather than by position.
text = "".join(b["text"] for b in response["output"]["message"]["content"] if "text" in b)

log.info("Called %s from %s", PROFILE_ID, REGION)
log.info("Stop reason: %s", response["stopReason"])
log.info("Response:\n%s", text)
API Chat Completions de OpenAI. Apunte el SDK de OpenAI al endpoint Regional y pase el mismo ID de perfil.
import logging
import os
from aws_bedrock_token_generator import provide_token
from openai import OpenAI

REGION = os.environ.get("AWS_REGION", "ap-southeast-1")
PROFILE_ID = os.environ.get("BEDROCK_PROFILE_ID", "global.openai.gpt-6-sol")
PROMPT = "List three uses for a message queue."

logging.basicConfig(format="%(levelname)s %(message)s")
log = logging.getLogger("bedrock-cris")
log.setLevel(logging.INFO)

# provide_token mints a short-term key from your AWS credentials, valid up to 12 hours.
client = OpenAI(
    base_url=f"https://bedrock-runtime.{REGION}.amazonaws.com/openai/v1",
    api_key=provide_token(region=REGION),
)

response = client.chat.completions.create(
    model=PROFILE_ID,
    messages=[{"role": "user", "content": PROMPT}],
    max_completion_tokens=256,
)

log.info("Called %s from %s", PROFILE_ID, REGION)
log.info("Response:\n%s", response.choices[0].message.content)
Al migrar un cliente de OpenAI existente:
- Establezca el parámetro del modelo en cada solicitud, incluidas las que hacen referencia a una respuesta anterior.
- Use tipos de herramientas compatibles:
function,mcp,custom,namespaceytool_search. - Configure el ID del perfil de inferencia directamente en su cliente en lugar de consultar el endpoint de modelos.
Configurar la aplicación de escritorio de ChatGPT y la Codex CLI
La aplicación de escritorio de ChatGPT y la Codex CLI comparten ~/.codex/config.toml, por lo que un solo cambio cubre ambas. De los dos proveedores integrados de Amazon Bedrock, solo amazon-bedrock-runtime acepta un perfil de inferencia.
model = "global.openai.gpt-6-astra"
model_provider = "amazon-bedrock-runtime"
[model_providers.amazon-bedrock-runtime.aws]
region = "ap-southeast-1"
La firma SigV4 significa que no hay clave que rotar. Añada profile = "<your-profile>" para un perfil no predeterminado, y establezca region explícitamente, porque de lo contrario el cliente recurre a AWS_REGION. Sustituya otro ID de perfil por model para cambiar de modelos.
Codex informa de una ventana de 272,000 tokens para estos perfiles, que es una cifra propia incluida en el paquete y no un límite del servicio. Auméntela con model_context_window. Esta configuración requiere Codex CLI 0.148 o posterior.
La Figura 2 muestra el resultado en la aplicación.
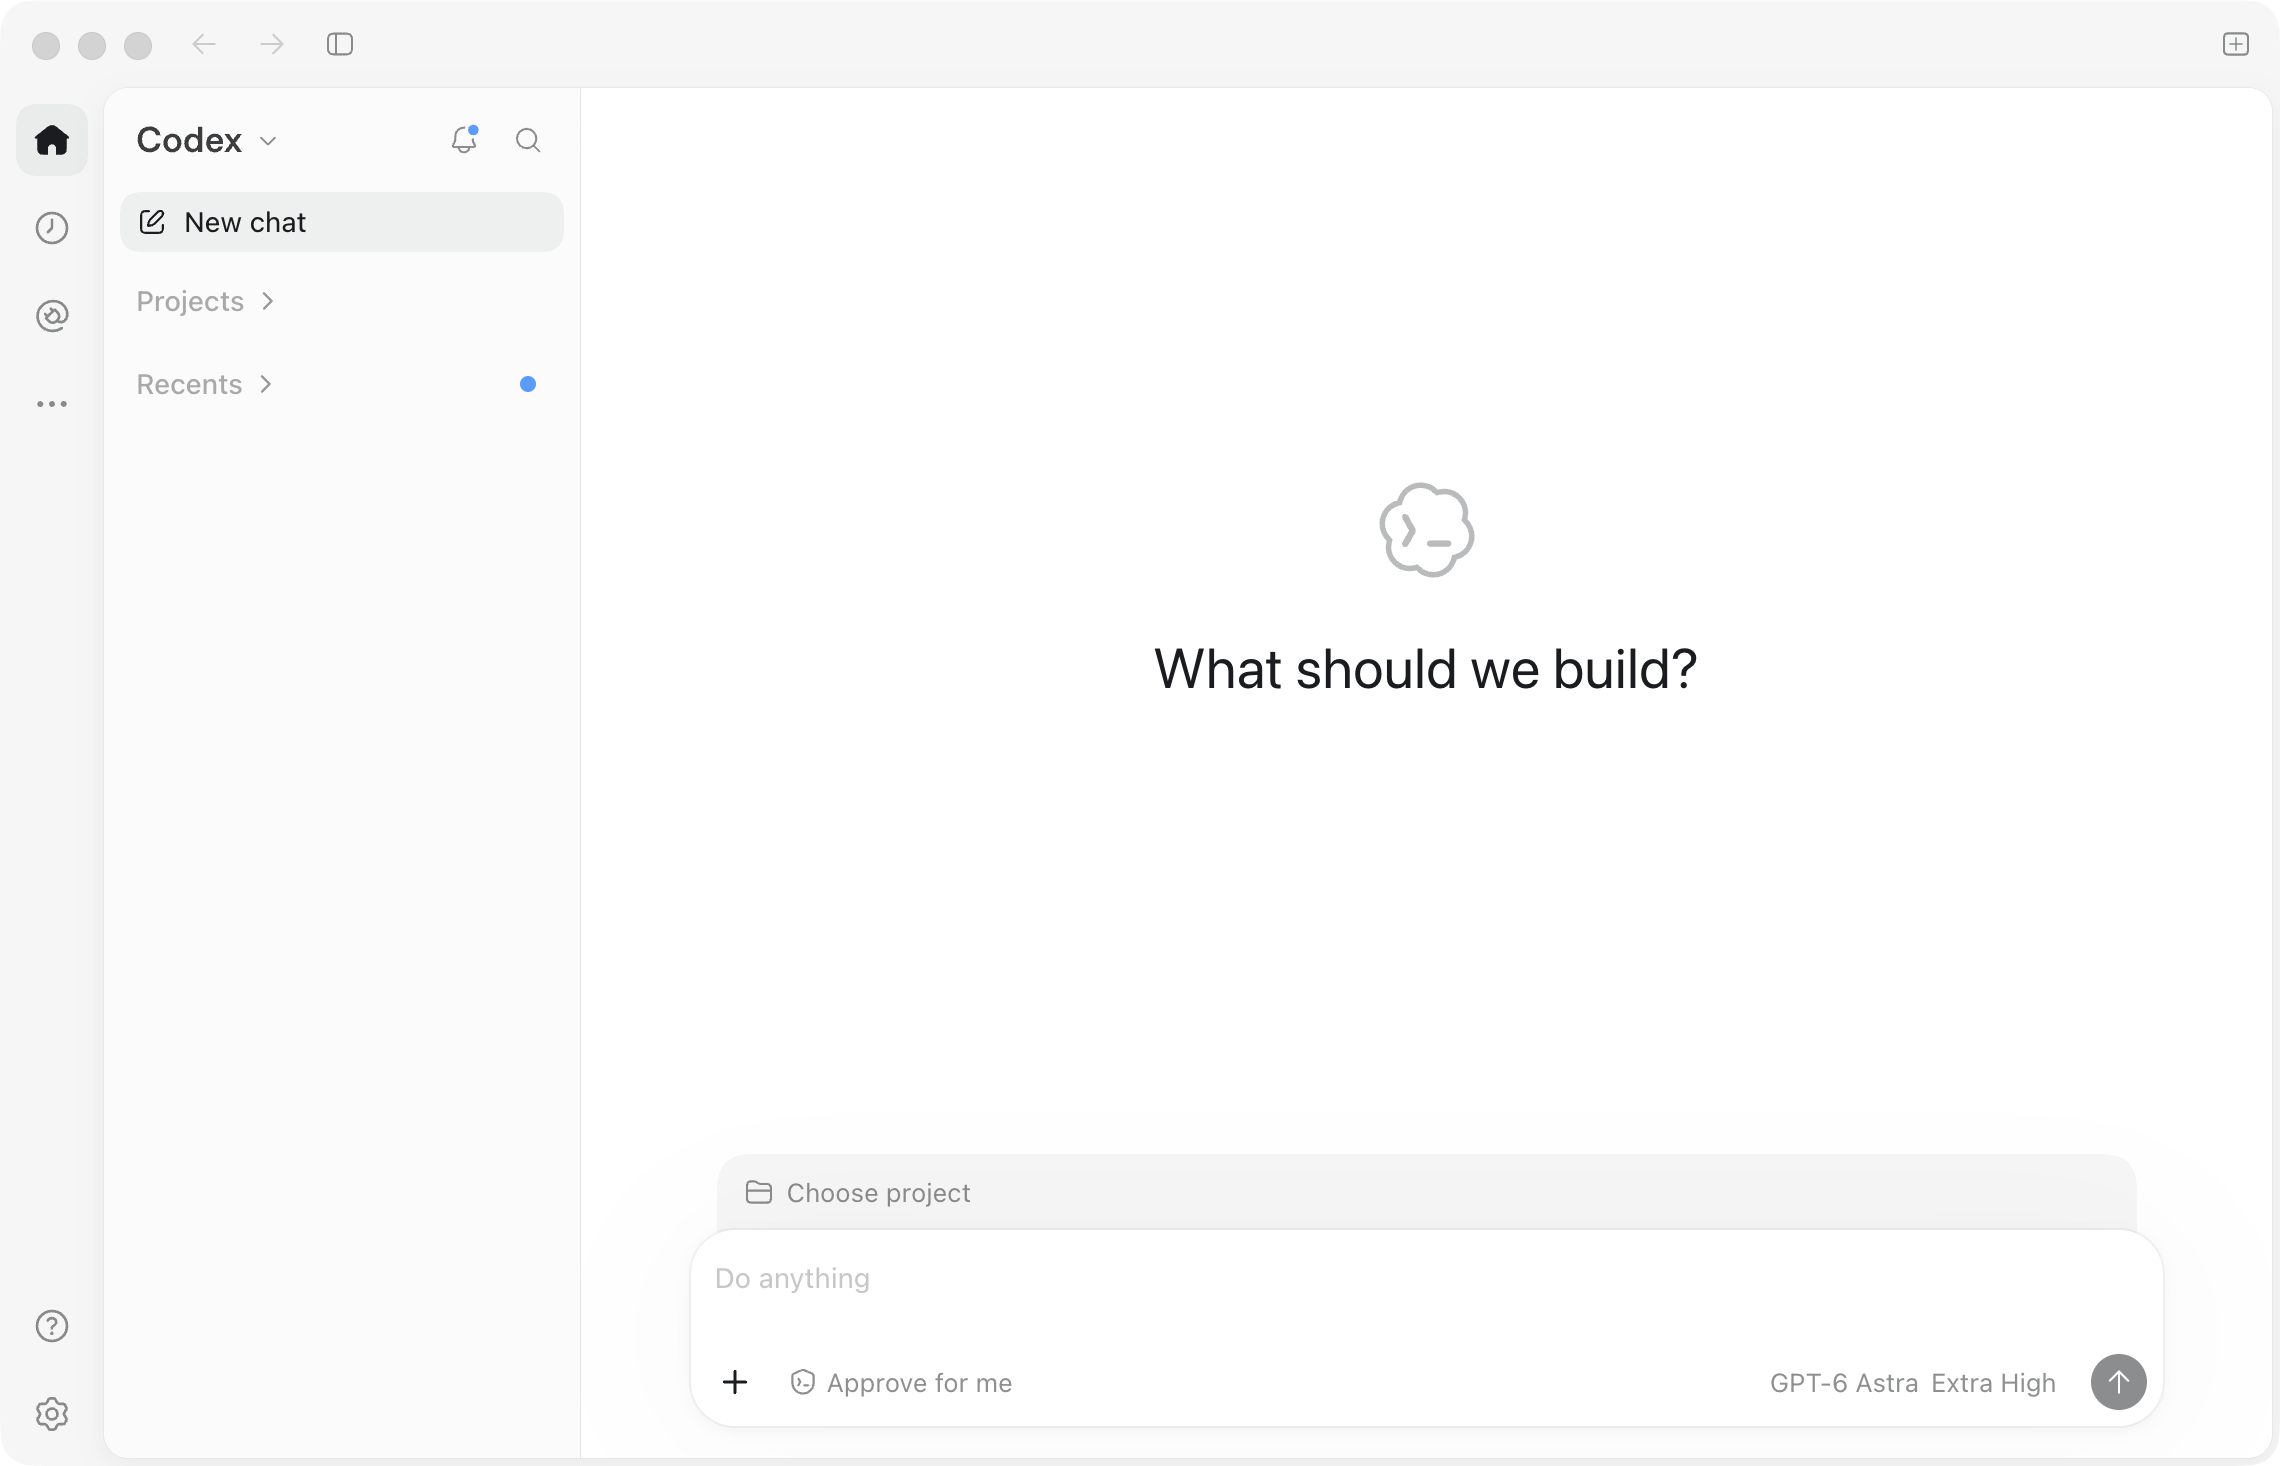
Figura 2: La aplicación de escritorio de ChatGPT ejecutando GPT-6 Astra en Amazon Bedrock
Seguridad y permisos
Amazon Bedrock ofrece una gama de controles sobre la inferencia. Dos de ellos importan aquí. Las políticas de AWS Identity and Access Management (IAM) controlan qué roles pueden invocar qué perfiles, y las políticas de control de servicios (SCPs) aplican controles en toda la organización, incluido el alcance por Región. Esta sección cubre ambos, y dónde aterrizan los datos de las solicitudes.
Permisos de IAM para la inferencia global entre Regiones
Para llamar a cualquiera de estos modelos a través de un perfil de inferencia global entre Regiones, su política de IAM necesita cuatro instrucciones:
- Acceso al perfil de inferencia y al recurso predeterminado o de proyecto en su Región de origen.
- Acceso al modelo base en su Región de origen, con alcance al perfil de inferencia.
- El Nombre de Recurso de Amazon (ARN) agnóstico de Región para el modelo base,
arn:aws:bedrock:::foundation-model/openai.gpt-6-sol, conaws:RequestedRegionestablecido enunspecifiedpara permitir el enrutamiento entre Regiones. bedrock:CallWithBearerTokenpara la autenticación con clave de API.
Esta política de IAM concede permiso para invocar GPT-6 Sol mediante inferencia global entre Regiones desde ap-southeast-1. Reemplácelo por su ID de cuenta de AWS y ap-southeast-1 por su Región de origen.
{
  "Version": "2012-10-17",
  "Statement": [
    {
      "Sid": "GrantGlobalCrisProfileAndProjectAccess",
      "Effect": "Allow",
      "Action": ["bedrock:InvokeModel"],
      "Resource": [
        "arn:aws:bedrock:ap-southeast-1:<ACCOUNT>:inference-profile/global.openai.gpt-6-sol",
        "arn:aws:bedrock:ap-southeast-1:<ACCOUNT>:project/default"
      ],
      "Condition": {
        "StringEquals": { "aws:RequestedRegion": "ap-southeast-1" }
      }
    },
    {
      "Sid": "GrantGlobalCrisInRegionModelAccess",
      "Effect": "Allow",
      "Action": ["bedrock:InvokeModel"],
      "Resource": ["arn:aws:bedrock:ap-southeast-1::foundation-model/openai.gpt-6-sol"],
      "Condition": {
        "StringEquals": {
          "aws:RequestedRegion": "ap-southeast-1",
          "bedrock:InferenceProfileArn": "arn:aws:bedrock:ap-southeast-1:<ACCOUNT>:inference-profile/global.openai.gpt-6-sol"
        }
      }
    },
    {
      "Sid": "GrantGlobalCrisGlobalModelAccess",
      "Effect": "Allow",
      "Action": ["bedrock:InvokeModel"],
      "Resource": ["arn:aws:bedrock:::foundation-model/openai.gpt-6-sol"],
      "Condition": {
        "StringEquals": {
          "aws:RequestedRegion": "unspecified",
          "bedrock:InferenceProfileArn": "arn:aws:bedrock:ap-southeast-1:<ACCOUNT>:inference-profile/global.openai.gpt-6-sol"
        }
      }
    },
    {
      "Sid": "AllowBearerTokenAuth",
      "Effect": "Allow",
      "Action": ["bedrock:CallWithBearerToken"],
      "Resource": "*"
    }
  ]
}
Si utiliza transmisión por secuencias (converse_stream o stream=True), añada bedrock:InvokeModelWithResponseStream a la Action en las tres primeras instrucciones. Converse autoriza como bedrock:InvokeModel. Si solo llama a Converse con credenciales SigV4, elimine la cuarta instrucción.
Para cambiar de modelo, reemplace openai.gpt-6-sol por openai.gpt-6-luna o openai.gpt-6-astra en todo el documento. Para la referencia completa, consulte Requisitos de política de IAM para la inferencia global entre Regiones.
Consideraciones sobre las políticas de control de servicios para la inferencia global entre Regiones
Una solicitud de inferencia global entre Regiones no incluye ningún nombre de Región. Amazon Bedrock establece aws:RequestedRegion como unspecified, por lo que una lista de permitidas de Regiones en una SCP deniega la llamada, y el error solo menciona el tipo de política, no cuál política. Esa es una razón común por la que falla una primera llamada en una cuenta empresarial.
En lugar de ampliar la allowlist, delimite el alcance de la excepción. Amazon Bedrock rellena la bedrock:InferenceProfileArn clave de condición durante la autorización, de modo que un SCP pueda permitir estos perfiles mientras mantiene los controles de Región para todo lo demás. El siguiente SCP hace eso.
{
  "Version": "2012-10-17",
  "Statement": [
    {
      "Sid": "DenyOutsideApprovedRegionsExceptBedrockInvoke",
      "Effect": "Deny",
      "NotAction": [
        "iam:*", "sts:*", "organizations:*", "account:*",
        "route53:*", "cloudfront:*", "waf:*", "wafv2:*", "shield:*",
        "support:*", "trustedadvisor:*", "health:*",
        "budgets:*", "ce:*", "cur:*", "tax:*", "billing:*",
        "bedrock:Invoke*"
      ],
      "Resource": "*",
      "Condition": {
        "StringNotEquals": { "aws:RequestedRegion": ["ap-southeast-1"] }
      }
    },
    {
      "Sid": "DenyBedrockInferenceOutsideApprovedRegionsUnlessCris",
      "Effect": "Deny",
      "Action": ["bedrock:Invoke*"],
      "Resource": "*",
      "Condition": {
        "StringNotEquals": { "aws:RequestedRegion": ["ap-southeast-1"] },
        "ArnNotLike": {
          "bedrock:InferenceProfileArn": [
            "arn:aws:bedrock:*:*:inference-profile/global.*"
          ]
        }
      }
    }
  ]
}
La primera declaración aplica su lista de Regiones permitidas a todos los servicios excepto la inferencia de Amazon Bedrock. La segunda deniega esa inferencia fuera de esas Regiones a menos que se enrute a través de un perfil de inferencia global entre Regiones. Para los perfiles geográficos, añada su prefijo (por ejemplo inference-profile/us.*) a la ArnNotLike lista, porque las solicitudes geográficas llevan un nombre de Region real. Mantén tu Region de origen en la allowlist y añade los servicios globales que usa tu organización. NotAction.
Una alternativa más contundente es añadir unspecified a tu lista de permitidos existente, lo cual funciona pero abre la misma excepción a todos los demás servicios. Para un archivo de políticas listo para usar, consulte el repositorio aws-samples service-control-policy-examples.
Retención de datos y detección de abusos
Para la detección automatizada de abusos sin conexión, el tráfico marcado por el clasificador es conservado por AWS durante un máximo de 30 días y procesado programáticamente. Bajo la inferencia entre Regiones, esa retención ocurre en la Región de destino, que para un perfil global es cualquier Región comercial de AWS admitida donde el modelo esté implementado. Los clientes elegibles pueden solicitar la retención total de cero datos a través de su equipo de cuenta de AWS. Para más información, consulte Detección de abusos en Amazon Bedrock y Retención de datos.
Si su organización tiene requisitos de residencia de datos, consulte esto con su equipo de riesgos y cumplimiento lo antes posible. Vea el AWS Financial Services Compliance Center páginas de país de estos cinco países. Le recomendamos que obtenga su propio asesoramiento sobre el cumplimiento de los requisitos pertinentes para su negocio.
Gestión de cuotas
Cuotas de GPT-6 en bedrock-runtime se miden en tokens por minuto (TPM), con seguimiento según la Región de origen desde la que llamas. Los tokens de entrada y de escritura en caché cuentan 1:1, y cada token de salida consume 10 tokens de cuota. Por ejemplo, una solicitud con 2,000 tokens de entrada y 1,000 tokens de salida agota 12,000 tokens de tu cuota.
Amazon Bedrock reserva la totalidad max_tokens al principio, así que configúrelo cerca de las finalizaciones que espere. Una cuota cubre InvokeModel, Converse, Responses y Chat Completions. Revísalo y plantéalo en el Consola de Service Quotas de su Región de origen. Antes de producción, solicite aumentos con anticipación y configure alarmas EstimatedTPMQuotaUsage en el AWS/Bedrock namespace al 70–80 por ciento de su asignación. Consulte How tokens are counted in Amazon Bedrock y Amazon Bedrock endpoints and quotas para conocer los valores actuales.
Supervisión y registro
Su superficie operativa permanece en su Región de origen. Las métricas de Amazon CloudWatch, los eventos de AWS CloudTrail, los registros de invocación de modelos, la contabilidad de cuotas y la facturación permanecen en la Región desde la que llamó. Usted paga las tarifas de esa Región, no las de la Región de procesamiento.
CloudTrail registra dónde se procesó cada solicitud. AWS documenta los destinos de un perfil de inferencia global entre Regiones como sus Regiones comerciales en lugar de enumerarlos. GetInferenceProfile devuelve los ARN del modelo agnóstico de Región y de la Región de origen en lugar de una lista de destinos. Su registro por solicitud está additionalEventData.inferenceRegion en CloudTrail en su Región de origen. La inferencia en este endpoint es un evento de administración, registrado por defecto sin costo adicional. CloudTrail Event History conserva 90 días, por lo que los horizontes más largos requieren un trail o un registro de invocación de modelos. Recupere los eventos de CloudTrail con este comando.
aws cloudtrail lookup-events \
  --region ap-southeast-1 \
  --lookup-attributes AttributeKey=EventSource,AttributeValue=bedrock.amazonaws.com \
  --start-time <START> \
  --end-time <END> \
  --max-results 1 \
  --query 'Events[0].CloudTrailEvent' --output text | python3 -m json.tool
Establezca la ventana alrededor de una llamada que acaba de realizar, porque la entrega de CloudTrail se retrasa unos minutos. Si el evento más reciente fue una llamada fallida, lleva un errorCode y no inferenceRegion. Aumente --max-results y elija un evento sin errorCode.
{
  "eventName": "Converse",
  "eventSource": "bedrock.amazonaws.com",
  "awsRegion": "ap-southeast-1",
  "managementEvent": true,
  "requestParameters": {
    "modelId": "global.openai.gpt-6-sol",
    "inferenceConfig": { "maxTokens": 1024 }
  },
  "additionalEventData": {
    "inferenceRegion": "us-east-1"
  }
}
Las métricas y el uso de agentes de código permanecen en CloudWatch. Donde los desarrolladores acceden a GPT-6 a través de un agente de código, CloudWatch Coding Agent Insights añade paneles listos para usar bajo GenAI Observability que desglosan el uso de tokens por usuario, equipo y centro de costos. Los agentes emiten métricas de OpenTelemetry de forma nativa. Para Codex, consulte Set up OpenTelemetry for OpenAI Codex.
Limpieza
Esta publicación añade una política de IAM y, opcionalmente, una declaración de SCP y un destino de registro. Desasocie o elimine la política de IAM que adjuntó y revierta la entrada de SCP si añadió una. Elimine el destino de registro de invocación de modelos en Amazon Simple Storage Service (Amazon S3) o Amazon CloudWatch Logs si creó uno, para evitar cargos de almacenamiento. Los perfiles de inferencia globales entre Regiones están definidos por el sistema, por lo que no hay nada que eliminar.
Conclusión
Esta publicación mostró cómo invocar GPT-6 Sol y GPT-6 Luna desde cinco Regiones de origen de Asia Pacífico, y GPT-6 Astra desde Asia Pacífico (Singapur), mediante la inferencia global entre Regiones en bedrock-runtime. Pase un ID de perfil de inferencia global entre Regiones como el model parámetro, y configure la política de IAM y la excepción de SCP de esta publicación. El mismo punto de enlace sirve las API compatibles con OpenAI, por lo que una integración existente de OpenAI se traslada cambiando una URL base y una clave.
Para comenzar, adjunte la política de IAM de esta publicación y envíe una primera solicitud a través de global.openai.gpt-6-sol. Dimensione su cuota de tokens por minuto a la tasa de reducción de 10x y confirme en CloudTrail que additionalEventData.inferenceRegion aparece en sus llamadas.
Para obtener más información, consulte la Amazon Bedrock User Guide, Enrute las solicitudes de inferencia del modelo en las Regiones de AWS con la inferencia entre Regionesy Amazon Bedrock pricing.