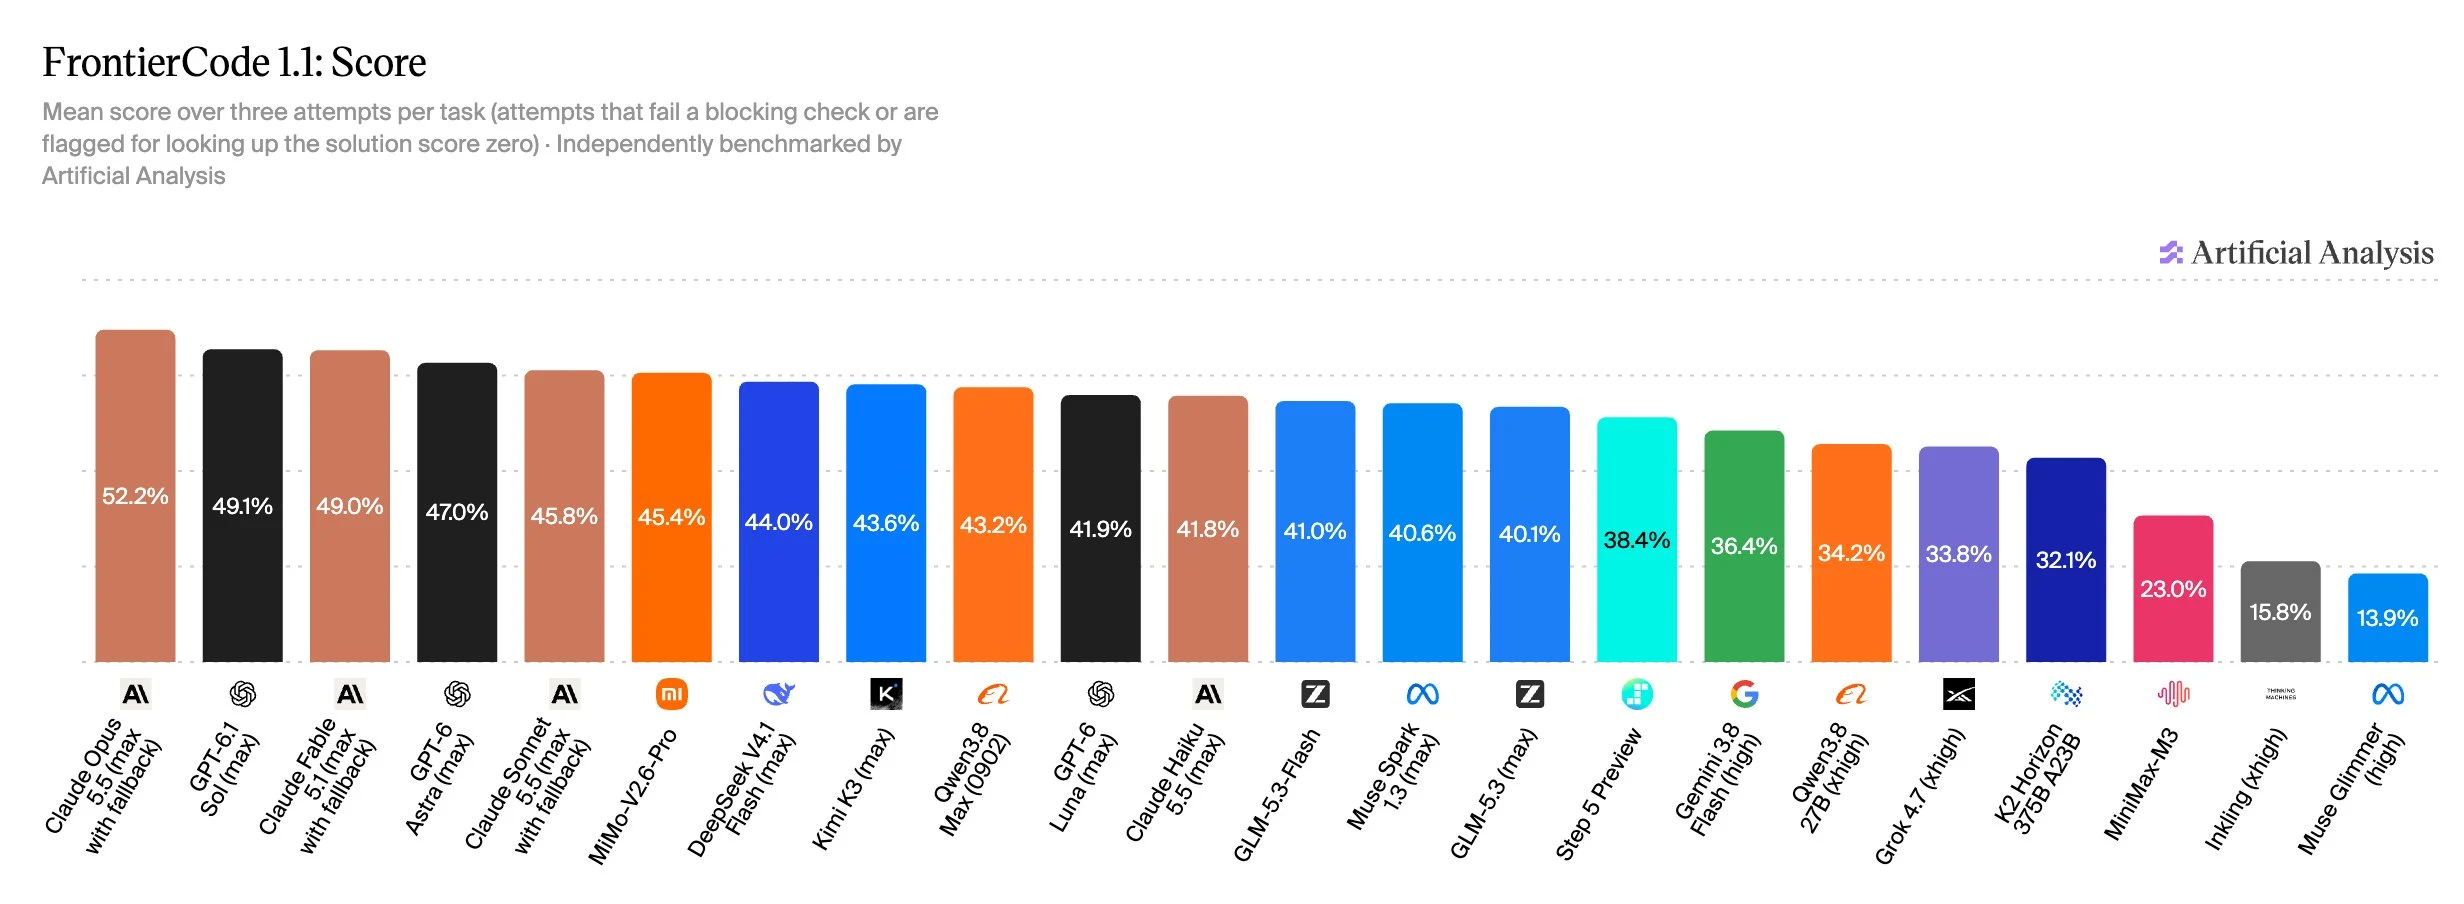
Estamos lanzando nuestro tablero de clasificación para FrontierCode 1.1, una evaluación privada de Cognition que prueba los modelos en tareas de programación de manera tal que pueda ser utilizada por los mantenedores de repositorios del mundo real.
@cognition anunció FrontierCode en junio de 2026 y lo actualizó a la versión 1.1 en julio. Cognition creó el conjunto de datos con mantenedores de código abierto que dedicaron más de 40 horas por tarea. Cada tarea requiere que el agente realice un cambio en un repositorio de código abierto real, y luego verifica tanto los tests unitarios como los tests cualitativos para determinar qué requerirían los mantenedores para fusionar el cambio.
Ejecutamos FrontierCode 1.1 Main, el conjunto principal de 100 tareas del conjunto de 150 tareas del benchmark, utilizando nuestro arnés de referencia de código abierto Stirrup para comparaciones equivalentes entre modelos. Todas las tareas son privadas para evitar la contaminación. Cada intento se evalúa con criterios tanto bloqueantes como no bloqueantes. Un intento que falla en cualquier verificación bloqueante obtiene un puntaje de cero, y aquel que pasa todos los criterios obtiene un puntaje entre el 70% y el 100%.
A diferencia de otras evaluaciones de codificación, FrontierCode tiene una visión más holística del éxito basada en el uso real. Los modelos deben pasar los pruebas unitarias, pero también se evalúan por comportamientos como hacer cambios excesivos y grandes diferencias, modificar archivos fuera del alcance correspondiente o agregar pruebas inútiles. Creemos que este enfoque es valioso en el contexto actual: los modelos son ahora muy capaces en tareas de codificación, pero sus cambios todavía pueden requerir una limpieza sustancial antes de que un mantenedor los fusione.
Puntos clave:
➤ Los modelos líderes todavía fallan más del 40% de las veces: Claude Opus 5.5 (máximo con fallback) lidera con un porcentaje de 52% después de superar los obstáculos en el 58% de sus intentos. Nueve de las 100 tareas no se superaron en ningún intento por ninguno de los modelos que evaluamos para el lanzamiento.
➤ La parte superior del tablero de clasificación está muy densa: nueve modelos de seis laboratorios obtienen puntajes entre el 43% y el 52%. MiMo-V2.6-Pro es el modelo de pesos abiertos líder con un 45%, seguido por DeepSeek V4.1 Flash (máx.) y Kimi K3 (máx.) con un 44%.
➤ GPT-6.1 Sol (máx) ofrece el rendimiento más fuerte para su precio: a un costo de $0.81 por tarea, obtiene una puntuación del 49%, equivalente a Claude Fable 5.1 (máx) con fallback. Esto significa que logra un rendimiento similar a los modelos líderes de Anthropic, por menos de una décima parte del costo por tarea.
Gracias a @silasalberti, @ybenpan, @cl571128 y al resto del equipo de Cognition por desarrollar FrontierCode y colaborar con nosotros para llevarlo a Artificial Analysis. Estamos trabajando para añadir FrontierCode a nuestra tabla de clasificación de agentes de codificación muy pronto.