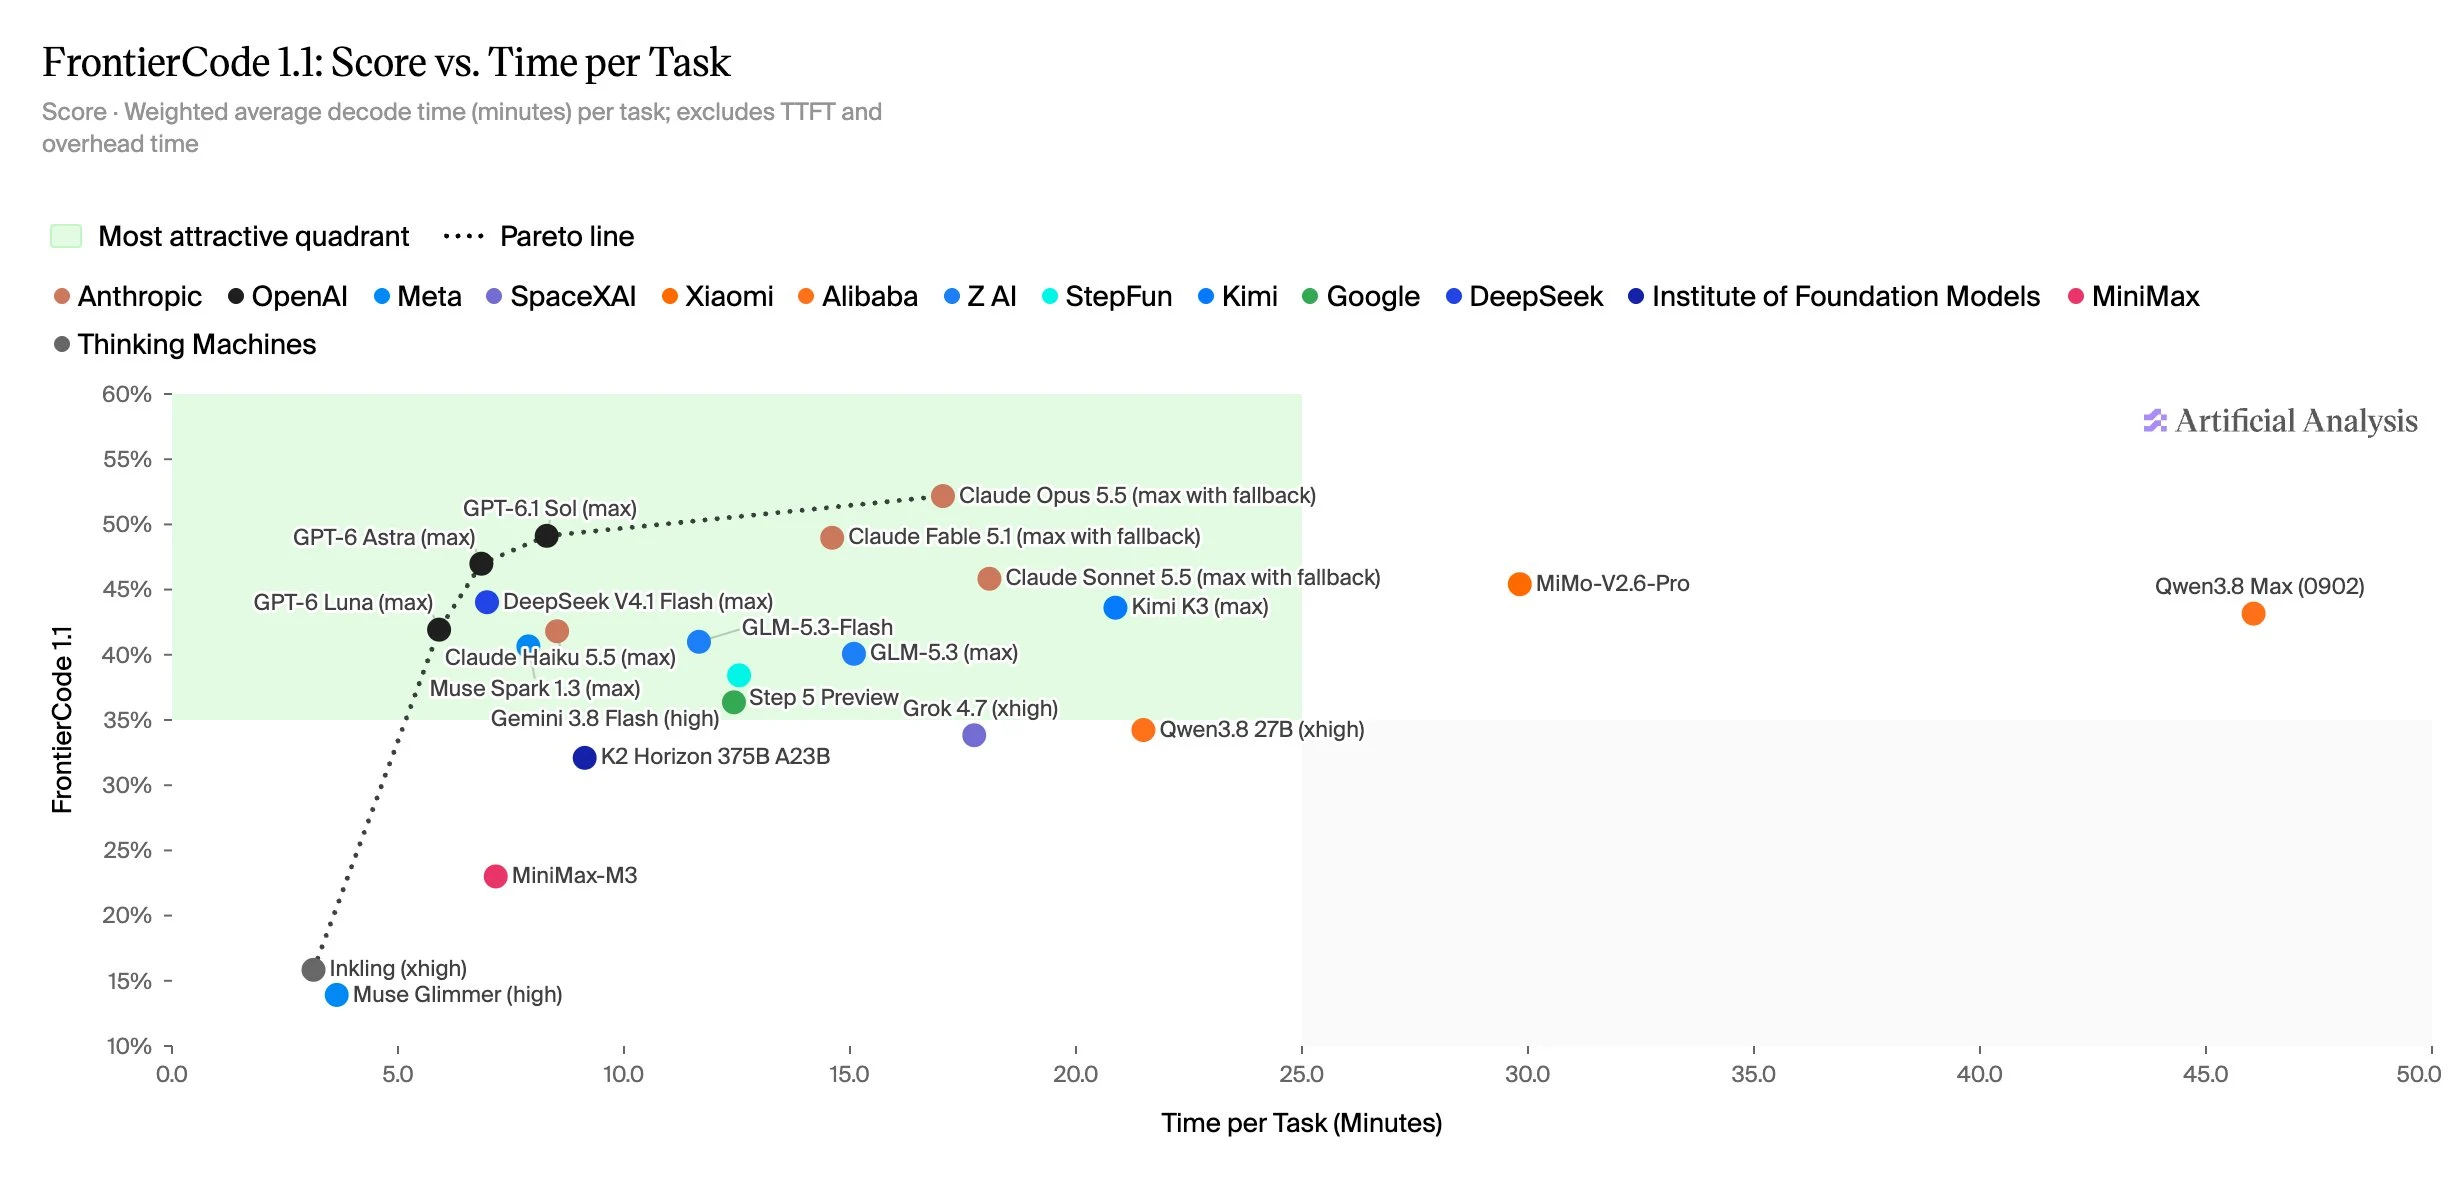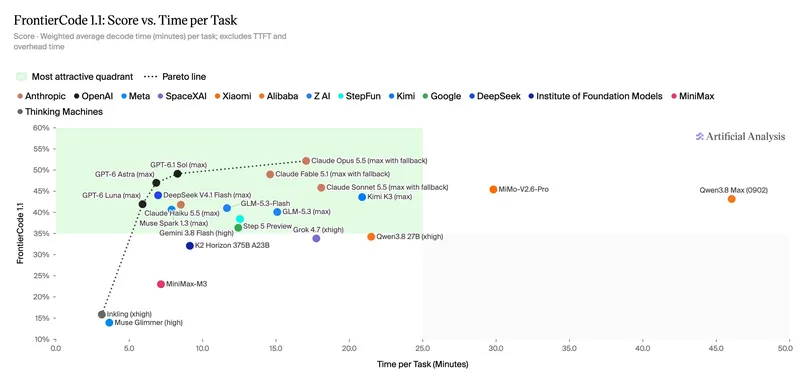
GPT-6 Luna (máx.), GPT-6 Astra (máx.), GPT-6.1 Sol (máx.) y Claude Opus 5.5 (máx. con fallback) se encuentran en la frontera de Pareto en cuanto al puntaje frente al tiempo por tarea. Estimamos el tiempo por tarea a partir del uso de tokens de cada modelo y nuestras mediciones de velocidad de salida en tiempo real. Los modelos GPT-6 son rápidos porque utilizan pocos tokens, entre 27k y 48k tokens de salida por tarea. DeepSeek V4.1 Flash (máximo) utiliza ~119k, pero se ejecuta rápidamente, con una media de ~7 minutos por tarea, aproximadamente el 40% del tiempo de Claude Opus 5.5 (máximo con fallback), en ~17 minutos.