
Las cargas de trabajo agénticas multivuelo se construyen sobre un contexto acumulado a medida que el agente razona, invoca herramientas e incorpora resultados anteriores. Con cada nuevo turno, el cliente reenvía el historial de la conversación, incluidas las instrucciones del sistema, los prompts previos, los resultados de las herramientas y las respuestas del modelo, lo que hace que el contexto creciente se procese repetidamente. En Desagregación prefill-decode (P-D), cada solicitud se divide entre nodos especializados: el nodo de prefill procesa el prompt y construye su caché KV, luego el nodo de decode recupera esos bloques KV y genera la respuesta.
Sin embargo, la atención desagregada convencional solo transfiere la caché KV en una dirección: del nodo de prefill al nodo de decode. Este flujo unidireccional crea dos ineficiencias para las cargas de trabajo multi-turno. Primero, después de generar una respuesta, el nodo de decode conserva las entradas de caché KV tanto del prompt como de los tokens recién generados. Al procesar el siguiente turno, el nodo de prefill no puede recuperar esas entradas, por lo que debe recalcular las proyecciones KV de los tokens de respuesta anteriores. Segundo, el nodo de decode mantiene el estado de la sesión mientras que los nodos de prefill no lo hacen, lo que aumenta la probabilidad de expulsión de caché para las sesiones activas en los nodos de prefill. Ante un fallo total de caché, el nodo de prefill debe recalcular las proyecciones KV de todo el historial de la conversación, incluidas las instrucciones del sistema, las solicitudes previas del usuario, los resultados de las herramientas y las respuestas generadas por el modelo. A medida que la conversación crece, este trabajo redundante consume más capacidad del acelerador y aumenta el time to first token (TTFT).
Para los clientes que desarrollan asistentes conversacionales y aplicaciones agénticas, historiales de interacción más largos pueden aumentar la latencia y consumir capacidad de aceleradores mediante cálculos de prefill repetidos. En esta publicación, mostramos cómo transferencia bidireccional de caché KV permite que los nodos de prefill y decode reutilicen el contexto previamente calculado entre turnos, mejorando la utilización de los aceleradores y ayudando a las aplicaciones a mantener un TTFT receptivo a medida que las conversaciones crecen.
En nuestros benchmarks multitudinales (multi-turn) sobre un despliegue 1P1D utilizando instancias Amazon EC2 P5en conectadas mediante AWS Elastic Fabric Adapter (AWS EFA, la red RDMA de baja latencia utilizada entre los servidores de AWS), la transferencia bidireccional de KV redujo el TTFT hasta en 1.6x para Qwen3-32B y hasta en 3.3x para zai-org/GLM-5-FP8 (véase el Datos de rendimiento section); los resultados dependen de la carga de trabajo y la configuración.
Originalmente construimos y validamos esta función en clústeres de instancias AWS Trainium conectados con EFA y la contribuimos a vLLM como una capacidad independiente del acelerador. Los resultados presentados aquí provienen de un clúster de GPU Amazon EC2 P5en con EFA, lo que demuestra que los beneficios también se trasladan a las GPU. Esta publicación explica la arquitectura de transferencia bidireccional, el flujo de metadatos del router, la retención de bloques KV y los controles de recálculo, los resultados de rendimiento y cómo reproducir el benchmark.
Transferencia bidireccional de KV
La transferencia bidireccional de KV es un mecanismo que permite que un nodo de decodificación devuelva un KV calculado previamente a un nodo de prefill en turnos posteriores de una conversación, evitando el recálculo del contexto compartido en el nodo de prefill, controlado por un umbral de recálculo de KV configurable. Esto mitiga ambos escenarios de redundancia computacional descritos anteriormente, y materializarlo requiere que el KV sobreviva al turno que lo produjo y que viaje en dirección inversa, coordinado por un router consciente de la caché de KV.
Mejoras del conector KV de NIXL para transferencia bidireccional
Ampliamos la NVIDIA Inference Xfer Library (NIXL) Conector KV para permitir que los nodos de prefill consuman bloques KV remotos, de manera similar a cómo los nodos de decode ya consumen bloques KV que el nodo de prefill proporciona. Este no es un cambio trivial, porque los dos tipos de nodos son arquitectónicamente diferentes: los nodos de prefill calculan representaciones KV para los nuevos tokens del prompt y pueden proporcionar bloques KV de prompt completos. Los nodos de decode carecen de la capacidad (o eficiencia) para generar representaciones KV completas y solo pueden servir bloques KV previamente almacenados en caché. Como resultado, los nodos de prefill y decode aún conservan sus propios roles y lógica para calcular los metadatos de los bloques KV remotos y locales. Sin embargo, el mecanismo real de transferencia de KV (un NIXL READ) es común a ambos P->D y D->P direcciones.
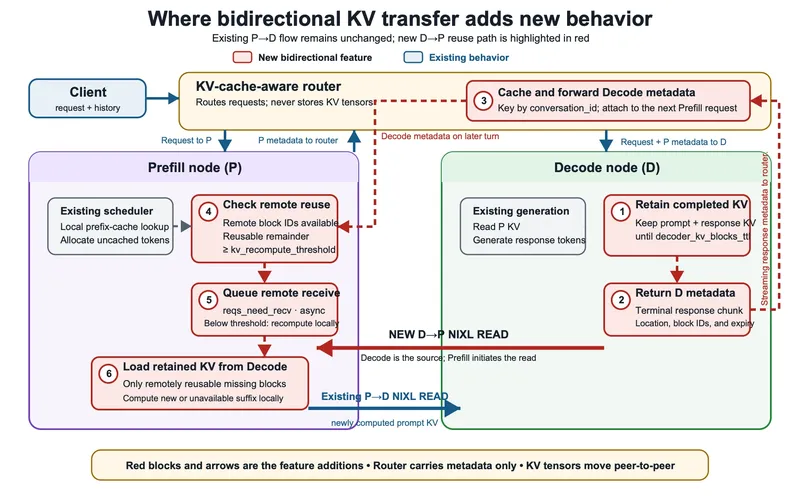
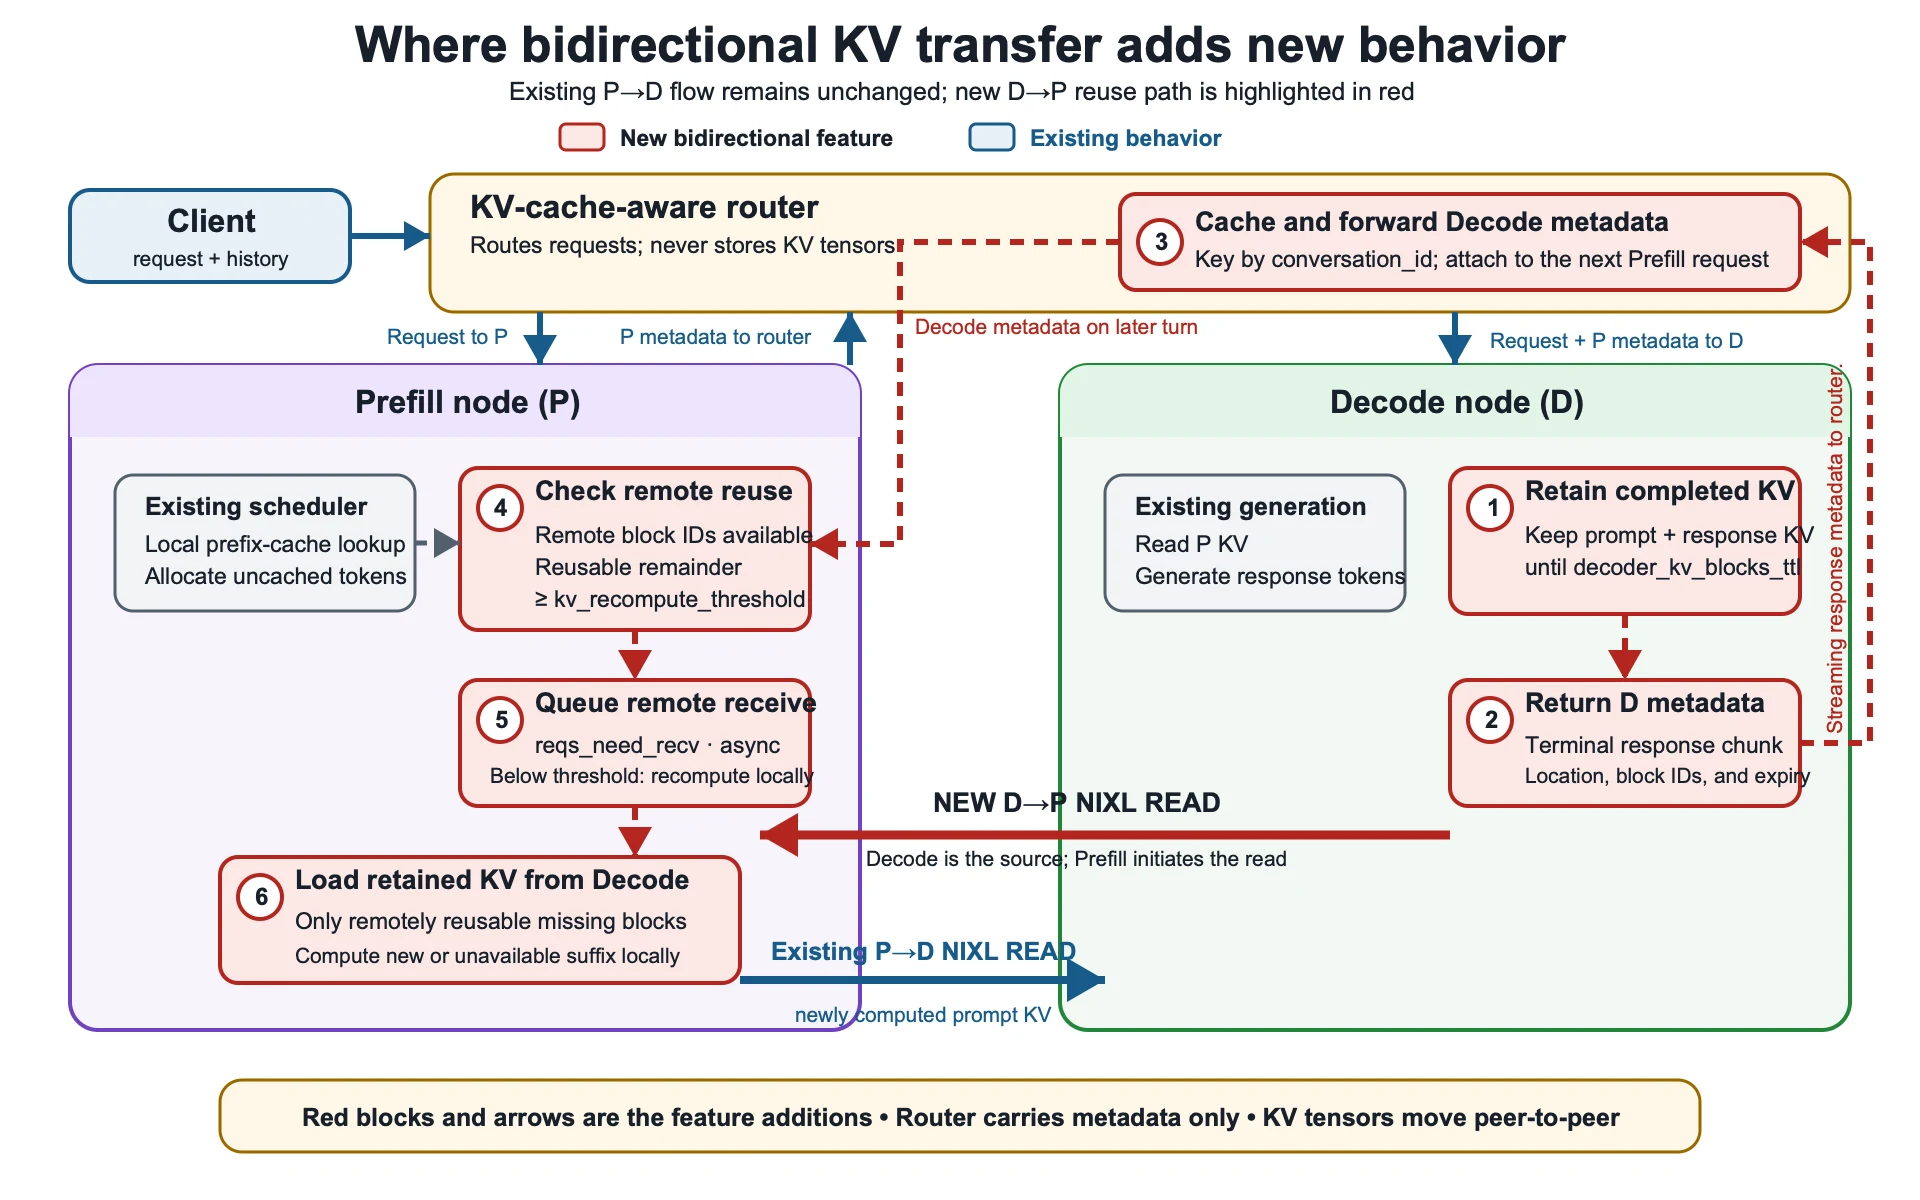
El siguiente diagrama muestra primero en azul el flujo existente: el router envía la solicitud al nodo de prefill, el nodo de prefill calcula el KV del prompt y devuelve sus metadatos de bloque, y el router reenvía la solicitud y los metadatos al nodo de decode para el P→D NIXL READ estándar. La ruta roja numerada ilustra las adiciones de transferencia de KV bidireccional: (1) el nodo de decode retiene los bloques KV elegibles después de la generación, (2) devuelve sus metadatos en la respuesta de streaming, y (3) el router almacena en caché esos metadatos para la próxima solicitud de prefill. Luego, el nodo de prefill (4) verifica el KV reutilizable remotamente después de aplicar las coincidencias de caché locales, (5) encola una recepción asíncrona cuando el número de tokens reutilizables alcanza el umbral, y (6) realiza un D→P NIXL READ antes de calcular el sufijo restante.
router consciente de la caché KV
vLLM incluye soporte del lado del conector para la transferencia bidireccional de KV, mientras que coordinar la reutilización de KV entre turnos de conversación requiere un router consciente de la caché KV. vLLM GitHub proporciona un proxy de ejemplo que implementa el flujo usado en esta publicación y que puede adaptarse a su entorno.
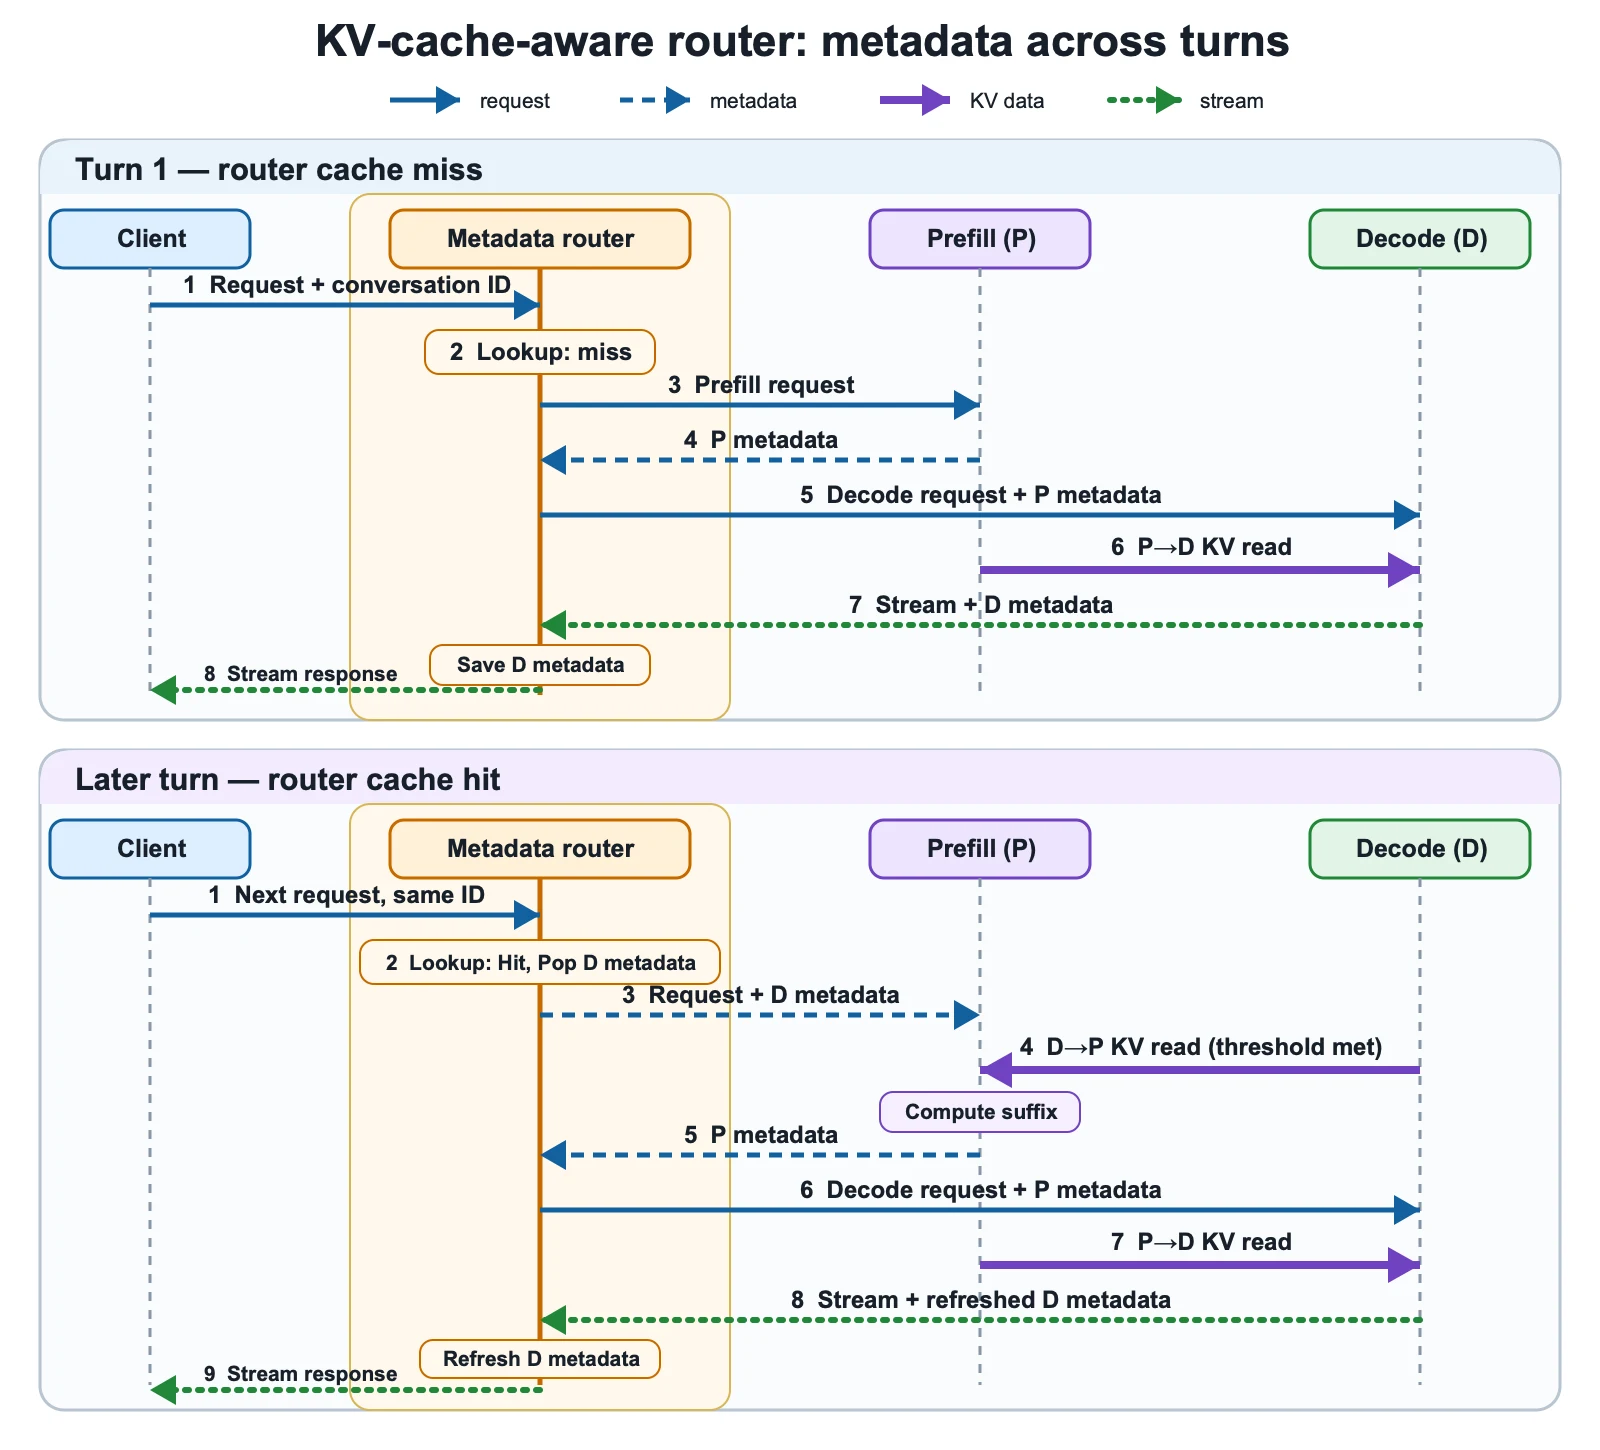
El router consciente de la caché KV es un componente del plano de control ligero y con estado entre el cliente y los nodos de prefill y decode. Mantiene un mapeo en memoria desde el conversation_id proporcionado por el cliente al kv_transfer_paramsde decode. El router almacena solo metadatos de ubicación de bloques, no tensores KV, y obtiene esos metadatos del flujo de respuesta en lugar de consultar por separado al nodo de decode.
El siguiente diagrama muestra cómo el router gestiona los metadatos KV a lo largo de los turnos de conversación. En el primer turno, la búsqueda en la caché falla y la solicitud sigue el flujo estándar P→D; el router luego guarda los metadatos de decode del flujo de respuesta. En turnos posteriores, el router recupera esos metadatos usando el conversation_id, lo que permite a prefill reutilizar el KV de decode, y actualiza los metadatos después de la generación para el siguiente turno.
TTL de retención de bloques
Normalmente, una instancia de decode libera los bloques de una solicitud tan pronto como termina la generación. En modo bidireccional, los retiene durante un tiempo de vida configurable (decoder_kv_blocks_ttl, por defecto 480 segundos) y publica su ubicación y caducidad, de modo que el KV de la conversación, tanto el prefijo del prompt como la respuesta generada, permanezca disponible para el siguiente turno. Para un turno que llega antes de que expire el TTL, el nodo de prefill reutiliza el KV; uno que llega más tarde recurre al prefill normal. Debido a que este TTL es fijo y no se renueva, ajústelo al tiempo esperado entre turnos para equilibrar la reutilización de KV con el uso de la memoria del acelerador. Una mejora natural siguiente es extender el lease renovado por latido al lado de decode, de modo que una instancia de decode recupere los bloques tan pronto como una conversación quede inactiva en lugar de al final de un temporizador fijo.
Umbral de recálculo de KV
La reutilización de KV no siempre es más rápida que el recálculo local. Para un prefijo reutilizable corto, la sobrecarga de interconexión y coordinación puede superar el tiempo necesario para recalcular los tokens. La opción kv_recompute_threshold , que por defecto es 64 tokens, controla esta decisión. El nodo de prefill recalcula cuando el número de tokens a calcular está por debajo del umbral y obtiene el KV del nodo de decode cuando está en el umbral o por encima. Las implementaciones pueden ajustar este valor según el tiempo de cómputo del modelo, el tamaño del KV y el rendimiento de la interconexión.
Datos de rendimiento
Para la evaluación, usamos los modelos Qwen3-32B y GLM-5-FP8 en un despliegue 1P1D utilizando instancias Amazon EC2 P5en conectadas con EFA. Para emular escenarios en los que el nodo de prefill ha desalojado su caché local o el router selecciona un nodo de prefill diferente que no tiene los bloques KV de la conversación, desactivamos el almacenamiento en caché de prefijos en el nodo de prefill con --no-enable-prefix-caching.
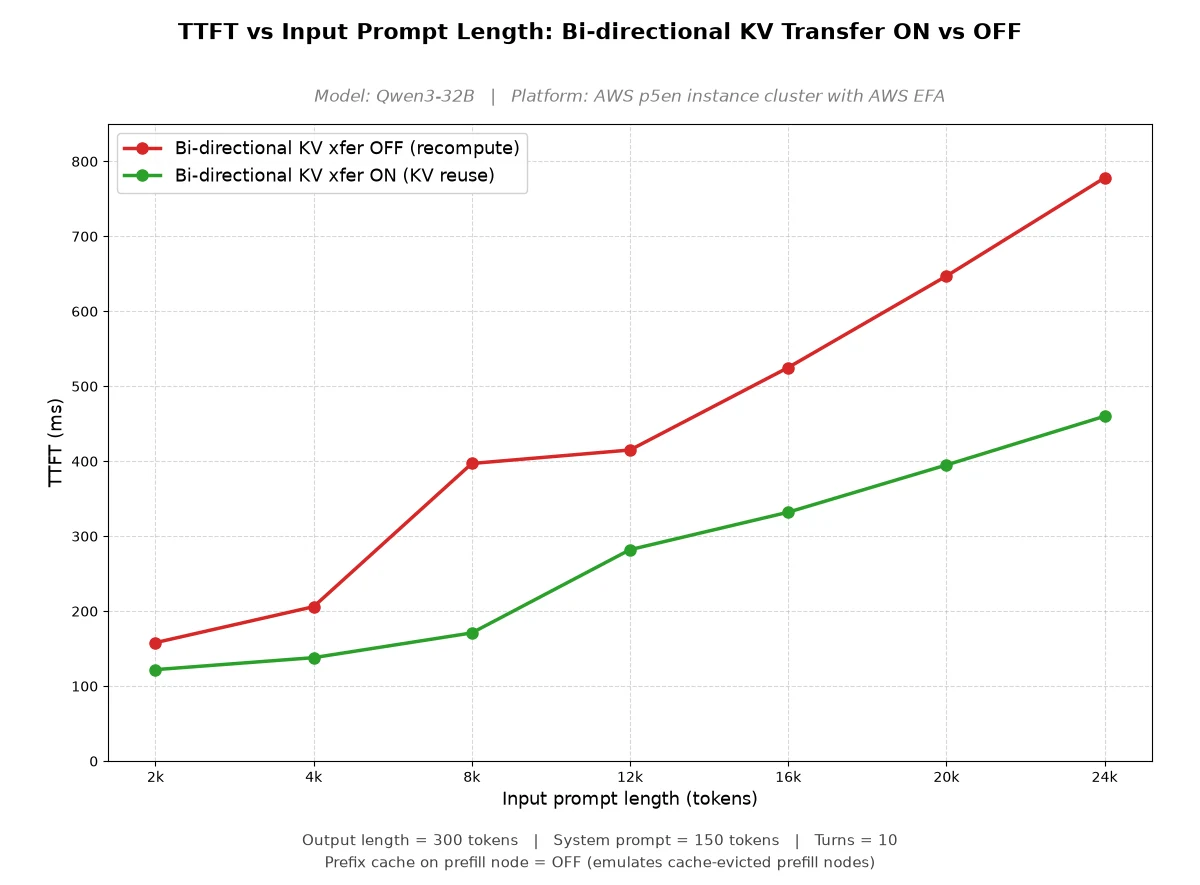
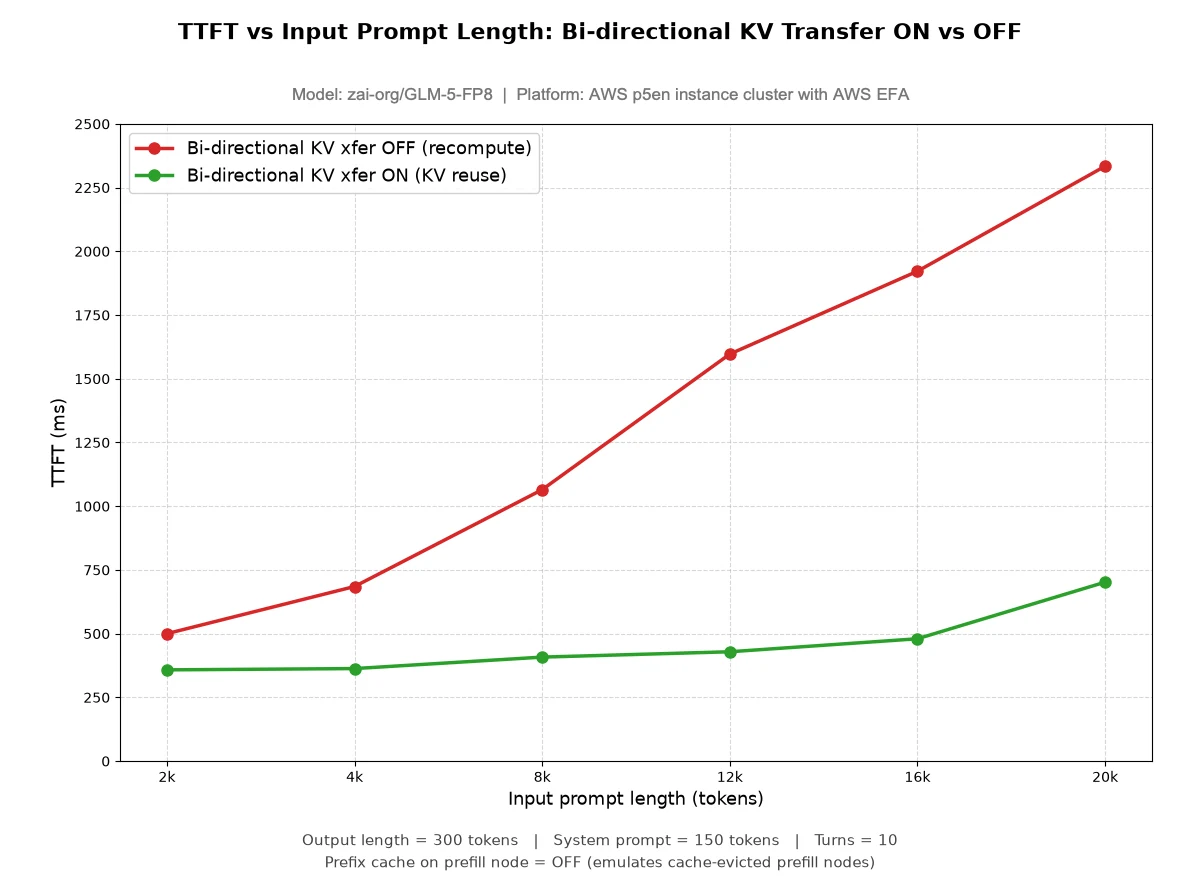
En ambos modelos, activar la transferencia bidireccional de KV reduce el cómputo de prefill en conversaciones de múltiples turnos, y el beneficio suele crecer con la longitud del prompt. Con la función APAGADA, la instancia de prefill recalcula todo el contexto crecido en cada turno, por lo que el TTFT sube bruscamente: Qwen3-32B sube de 158 ms a 2k hasta 778 ms a 24k, y GLM-5-FP8 de 500 ms a 2k hasta 2,334 ms a 20k. Con la función ENCENDIDA, el KV retenido de la instancia de decode se reutiliza en lugar de recalcularse, manteniendo el TTFT mucho más plano: Qwen3-32B sube solo de 122 ms a 460 ms en el mismo rango (aproximadamente una reducción de 1.6x en el prompt más largo), mientras que GLM-5-FP8 sube de 358 ms a 702 ms y se ejecuta hasta 3.3x por debajo de la ruta de recálculo en prompts largos. El desglose de la duración del prefill explica por qué.
La transferencia bidireccional añade un pequeño tiempo de transferencia de KV (aproximadamente 30 ms a 130 ms para Qwen3-32B; aproximadamente 29 ms a 110 ms para GLM-5-FP8), pero el cómputo de prefill que elimina supera con creces ese tiempo de transferencia de KV. Como resultado, la duración total del prefill con la transferencia activada (Qwen3-32B: 128 ms a 414 ms; GLM-5-FP8: 316 ms a 541 ms) se mantiene muy por debajo de la vía de solo recálculo (Qwen3-32B: 153 ms a 744 ms; GLM-5-FP8: 500 ms a 2,331 ms). El modelo más grande GLM-5-FP8 muestra una brecha mayor en términos absolutos y relativos, ya que su mayor tiempo de recálculo por token hace que la reutilización de KV sea aún más rentable a medida que los modelos y los contextos escalan.
Qwen3-32B
El gráfico siguiente representa el TTFT frente a la longitud del prompt para Qwen3-32B, comparando la transferencia bidireccional de KV activada frente a desactivada.
El siguiente gráfico desglosa la duración del prefill de las mismas ejecuciones en sus componentes de recálculo y transferencia de KV.
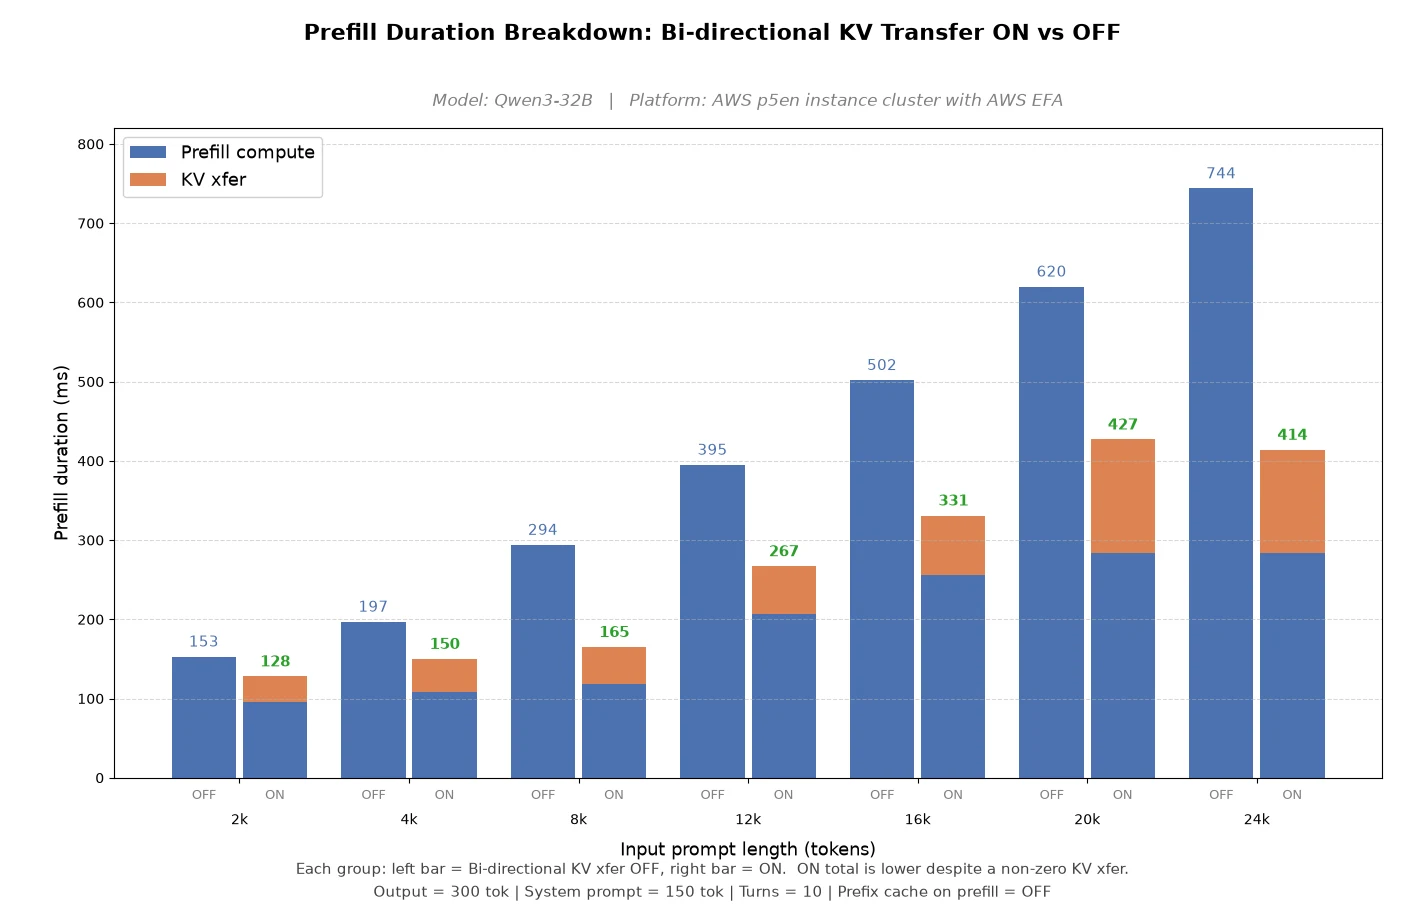
En conjunto, los gráficos muestran que el TTFT se mantiene casi plano con la función activada, mientras que la vía desactivada se incrementa abruptamente a medida que crece el contexto, porque el pequeño tiempo de transferencia de KV es superado con creces por el recálculo que elimina.
zai-org/GLM-5-FP8
Las mismas dos vistas siguen para GLM-5-FP8. La primera representa el TTFT frente a la longitud del prompt con la función activada frente a desactivada.
La segunda desglosa la duración del prefill en sus componentes de recálculo y transferencia de KV.
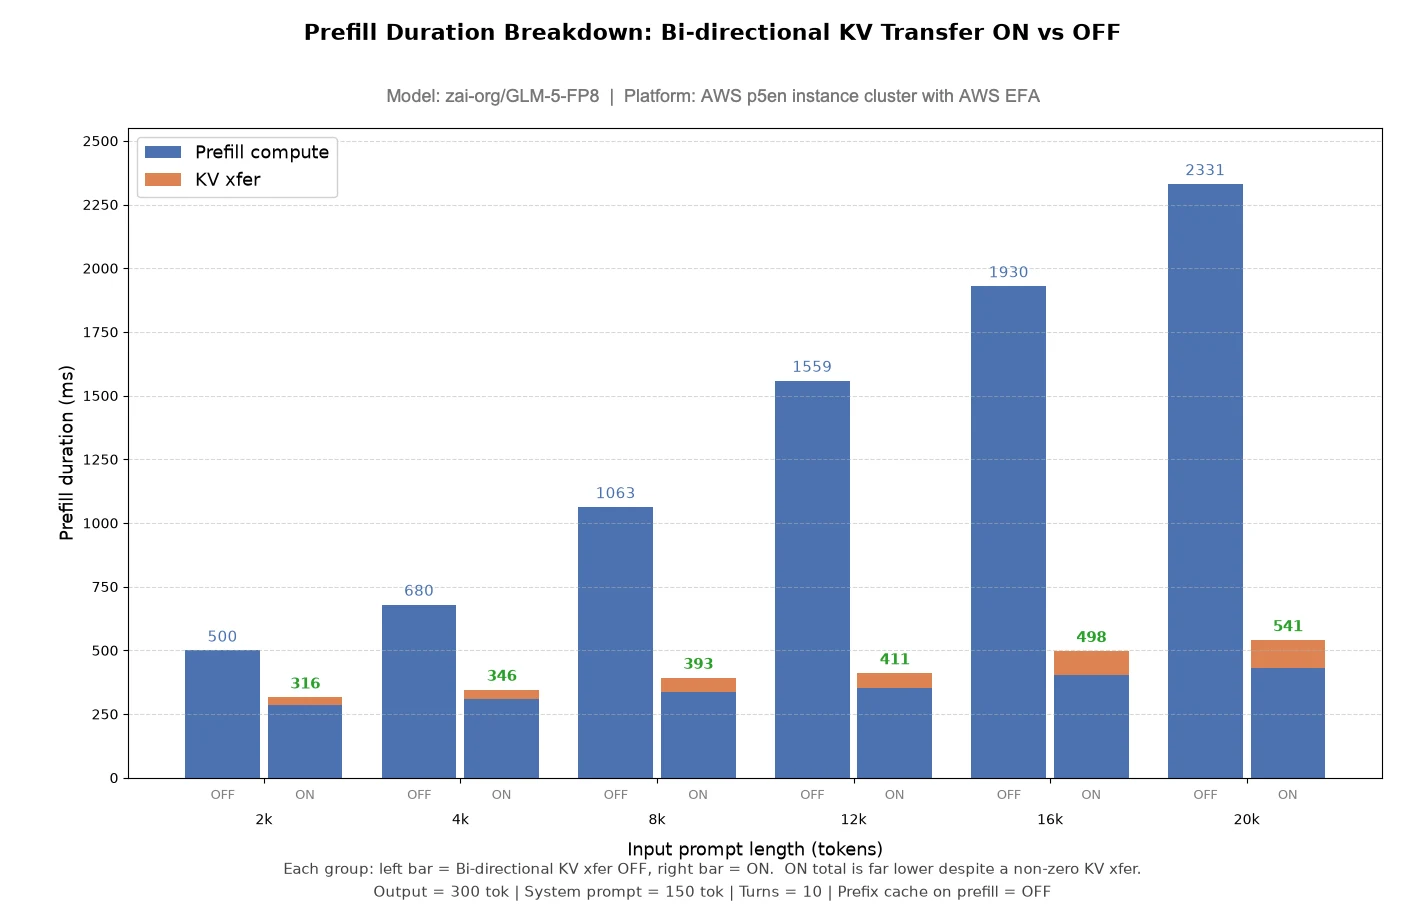
GLM-5-FP8 muestra una brecha mucho mayor que Qwen3-32B, de hasta aproximadamente 3.3 veces menos TTFT en prompts largos, porque su mayor tiempo de recálculo por token hace que la reutilización de KV sea aún más rentable a medida que crece la longitud del contexto.
Cómo ejecutar el benchmark
Para reproducir nuestra configuración de benchmark 1P1D, un nodo de prefill y un nodo de decode, utilizando instancias Amazon EC2 P5en con EFA, siga las instrucciones paso a paso de la Reproduciendo nuestros resultados guía que aparece a continuación. La guía cubre la configuración del entorno, el lanzamiento de los servidores vLLM de prefill y decode, la ejecución del benchmark y la recopilación de resultados. La función puede ejecutarse en otras configuraciones compatibles, pero los resultados de rendimiento variarán según el hardware, el modelo, la carga de trabajo y la configuración de red.
Conclusión
En esta publicación, mostramos cómo la transferencia bidireccional de caché KV puede reducir el TTFT a medida que crece el historial de conversación de un agente. En despliegues disagregados P-D, la función permite que el nodo de prefill reutilice los bloques KV retenidos por el nodo de decode entre turnos, reduciendo el cálculo repetido. Los umbrales configurables de retención de bloques y recálculo determinan cuándo se produce la reutilización. En un despliegue 1P1D utilizando instancias Amazon EC2 P5en conectadas con EFA, en las longitudes de prompt más largas probadas, observamos reducciones de TTFT de 1.6x para Qwen3-32B y 3.3x para zai-org/GLM-5-FP8; los resultados dependen de la carga de trabajo y de la configuración de despliegue. Para implementar esto en su entorno, use vLLM v0.21.0 o posterior con NixlConnector, habilite bidirectional_kv_xfer en ambos servidores de prefill y decode, use un router consciente de la caché KV y siga la guía de reproducción.
Recursos relacionados
- AWS EFA
- Servicio disagregado Prefill-Decode (P-D)
- Benchmark de descarga de caché KV con conversaciones de múltiples turnos
Agradecimientos
Agradecemos a Nicolò Lucchesi (Mistral), Mark McLoughlin (Red Hat) y a la comunidad de vLLM su apoyo en el mantenimiento de esta función.
Apéndice: Reproduciendo nuestros resultados
La topología es de dos instancias AWS p5en (prefill en :8100, decode en :8200) con EFA habilitada, más un tercer nodo pequeño que ejecuta el proxy y el cliente del benchmark en :8000.
Tres scripts se incluyen con esta entrada: serve_pd_multiturn.sh inicia cualquiera de las dos etapas con la funcionalidad activada o desactivada, run_multiturn_sweep.sh ejecuta el barrido de longitud de prompt, y cleanup.sh desmantela el despliegue.
Entorno de prueba
Ambos nodos GPU se configuraron de forma idéntica:
| Tipo de instancia | p5en.48xlarge (8x NVIDIA H200), uno para prefill y otro para decode |
| Región / AZ | ap-south-1 ( Bombay ), ap-south-1b (ID de AZ aps1-az3), ambos nodos en la misma AZ |
| Ubicación | Sin grupo de ubicación en clúster; ambas instancias se lanzaron en una On-Demand Capacity Reservation específica, tenencia predeterminada |
| AMI | Imagen pública de AWS ParallelCluster 3.14.2 para Ubuntu 24.04 x86_64, aws-parallelcluster-3.14.2-ubuntu-2404-lts-hvm-x86_64-202602121713 (ami-0133f195033a4baae en ap-south-1; los ID de AMI difieren por región). Incluye el kernel 6.14.0-1018-aws, el controlador NVIDIA 570 y CUDA 12.8, por lo que hay que actualizar el controlador, el CUDA toolkit y el instalador de EFA a las versiones indicadas abajo. |
| SO / kernel | Ubuntu 24.04.4 LTS, 6.14.0-1018-aws |
| Controlador NVIDIA / CUDA | Controlador 580.126.16 (API de controlador CUDA 13.0); CUDA toolkit 13.0 |
| Interfaces EFA | 16 por instancia, una por tarjeta de red (tarjetas 0-15, todas de tipo de interfaz efa), 200 Gb/s cada una para un total de 3.2 Tb/s. 8 interfaces se encuentran en cada nodo NUMA, y cada GPU comparte un conmutador PCIe con 2 de ellas. |
| Software EFA | Instalador de EFA 1.50.0, módulo de kernel EFA 3.3.0g, libfabric 2.6.0amzn1.0, rdma-core 64.0amzn0 |
Selección de dispositivo EFA por parte de NIXL. El backend LIBFABRIC abre los 16 dispositivos EFA como rails con el proveedor efa Luego registra la caché KV de cada GPU solo en los 2 rails que comparten el conmutador PCIe de esa GPU, de modo que cada transferencia se mantenga local a PCIe. No se establecieron anulaciones de dispositivo de NIXL ni de libfabric; esta es la selección predeterminada. Para confirmarlo en sus propios nodos, lance los servidores con NIXL_LOG_LEVEL=DEBUG y verifique las líneas de registro:
grep -E "Created rail [0-9]+ \(device=|mapped to rail" server.log1. Aprovisionar los nodos
Instale la pila de espacio de usuario de EFA en ambos nodos de GPU y confirme que el proveedor está presente. Usamos el instalador 1.50.0:
curl -O https://efa-installer.amazonaws.com/aws-efa-installer-1.50.0.tar.gz
tar -xf aws-efa-installer-1.50.0.tar.gz && cd aws-efa-installer
sudo ./efa_installer.sh -y
fi_info --version         # libfabric 2.6.0amzn1.0
fi_info -p efa -t FI_EP_RDM            # verify the EFA provider is present on both GPU nodes
2. Instalar vLLM y NIXL en ambos nodos de GPU
python3 -m venv ~/venv-pd && source ~/venv-pd/bin/activate
pip install --upgrade pip && pip install vllm==0.29.0 nixl==1.4.1
Aplique el PR de vLLM #40186 una vez en ambos nodos. Añade kv_transfer_params a el streaming de respuestas, que es lo que el proxy multivuelto necesita para vincular los vuelos: el proxy siempre consulta al nodo de decodificación con stream=True, por lo que sin este parche el nodo de decodificación nunca devuelve los metadatos del bloque y cada turno aterriza como un fallo de caché.
SITE=$(python -c 'import site; print(site.getsitepackages()[0])')
curl -sL https://github.com/vllm-project/vllm/pull/40186.diff -o /tmp/40186.diff
patch -p1 -d "$SITE" --fuzz=3 < /tmp/40186.diff
3. Descargar el modelo
export HF_HOME=/fsx/huggingface        # a large shared volume
hf download Qwen/Qwen3-32B
4. Lanzar el par P/D
Ejecutar serve_pd_multiturn.sh una vez por cada nodo de GPU. BIDIR es lo único que cambia entre las dos etapas del A/B, y debe coincidir en ambos nodos:
# on the prefill node
P_IP=<P_IP> D_IP=<D_IP> ROLE=prefill BIDIR=false ./serve_pd_multiturn.sh
# on the decode node
P_IP=<P_IP> D_IP=<D_IP> ROLE=decode  BIDIR=false ./serve_pd_multiturn.sh
Lo que se expande a, en el lado de prefill:
export FI_PROVIDER=efa
export VLLM_NIXL_SIDE_CHANNEL_HOST=<P_IP> VLLM_NIXL_SIDE_CHANNEL_PORT=5600
vllm serve Qwen/Qwen3-32B --served-model-name Qwen --dtype bfloat16 \
  --tensor-parallel-size 8 --max-model-len 32768 --max-num-seqs 8 \
  --no-enable-prefix-caching --port 8100 \
  --kv-transfer-config '{"kv_connector":"NixlConnector","kv_buffer_device":"cuda",
    "kv_role":"kv_producer","engine_id":"prefill-engine-001","kv_rank":0,
    "kv_parallel_size":2,"kv_connector_extra_config":{"backends":["LIBFABRIC"],
    "kv_recompute_threshold":64,"decoder_kv_blocks_ttl":480,
    "bidirectional_kv_xfer":false}}'
--no-enable-prefix-caching se establece solo en el nodo de prefill — ese es el escenario de caché desalojada que el benchmark emula. Deje el caché de prefijos habilitado en el nodo de decodificación. Espere a que ambos /health endpoints devuelvan 200.
5. Iniciar el proxy multi-turno
python3 -m venv ~/venv-proxy && source ~/venv-proxy/bin/activate
pip install fastapi uvicorn httpx pandas numpy aiohttp transformers tqdm
sudo dnf install -y jq || sudo apt-get install -y jq
git clone --depth 1 --branch v0.29.0 https://github.com/vllm-project/vllm.git ~/vllm_src
export VLLM_SRC=~/vllm_src

python3 $VLLM_SRC/examples/disaggregated/disaggregated_serving/disagg_proxy_multiturn.py \
  --port 8000 --prefiller-host <P_IP> --prefiller-ports 8100 \
  --decoder-hosts <D_IP> --decoder-ports 8200 \
  2>&1 | tee ~/proxy_$(date +%Y%m%d_%H%M%S).log
El proxy recibe hosts y puertos, no URLs. La reutilización se activa mediante el cliente enviando conversation_id, así que aquí no hay ninguna bandera que habilitar.
6. Ejecutar la etapa OFF, luego la etapa ON
VLLM_SRC=~/vllm_src LEG=off ./run_multiturn_sweep.shPara la etapa ON, detenga ambos servidores y el proxy, relance el paso 4 con BIDIR=true en cada nodo, reinicie el proxy (su caché de conversaciones está en el proceso), y luego:
VLLM_SRC=~/vllm_src LEG=on ./run_multiturn_sweep.shRepita ambas etapas para GLM-5-FP8 con MODEL=zai-org/GLM-5-FP8 SERVED_NAME=GLM.
7. Recopilar los números
Tres cantidades, una por fuente:
- TTFT, a partir del JSON de estadísticas por solicitud del benchmark escrito por
--stats-json-output. Cada registro incluyettft_msjunto coninput_num_tokensyconversation_id. Este es el eje y de los gráficos de TTFT. - Duración del prefill, a partir del registro del proxy, que informa la etapa de prefill de cada solicitud como
Prefill done in <N>ms. Esta es la altura total de cada barra en el desglose de duración de prefill. - Tiempo y volumen de transferencia KV, a partir del registro del nodo de prefill, que informa líneas
KV Transfer metrics:con tiempo de transferencia promedio y P90, bytes por transferencia y rendimiento. Este es el componente KV-xfer de cada barra ON.
La telemetría de NIXL se registra en el lado que inicia la transferencia, por lo que la lectura de retorno D->P aparece en el registro del nodo de prefill, mientras que la extracción ordinaria P->D aparece en el registro del nodo de decode.
Promedie cada cantidad por longitud de prompt y luego grafique: TTFT frente a la longitud del prompt como dos líneas (ON y OFF), y la duración del prefill como barras apiladas emparejadas por longitud de prompt, con la barra ON dividida entre cómputo de prefill y transferencia de KV. La diferencia entre las dos vistas es el punto: el costo de transferencia que exponen las barras es lo que las líneas de TTFT convierten en un ahorro.
Solución de problemas
- El proxy siempre registra
cache MISSen una ejecución ON — falta--send-conversation-id, PR #40186 no aplicado en ambos nodos, oBIDIR=falsedejado en el nodo de decode, en cuyo caso no devuelve ningúnkv_transfer_paramsen absoluto. Declining expired remote readen el nodo de prefill — los bloques del nodo de decode expiraron antes de que llegara el siguiente turno. Aumentedecoder_kv_blocks_ttl(valor predeterminado 480 s) y mantenga el TTL de caché del proxy por debajo de este.fi_info -p efaestá vacío o recurre a sockets — falta el proveedor EFA. Reinstaleaws-efa-installery confirme que las instancias se lanzaron con interfaces habilitadas para EFA; sin ello, NIXL o bien no logra inicializarse o silenciosamente se ejecuta sobre TCP, lo que hace que los números de transferencia no tengan sentido.
Limpieza
./cleanup.sh proxy      # on the proxy / benchmark driver node
./cleanup.sh server     # on each GPU node
Luego termine las instancias y verifique que no quede ninguna en ejecución.