
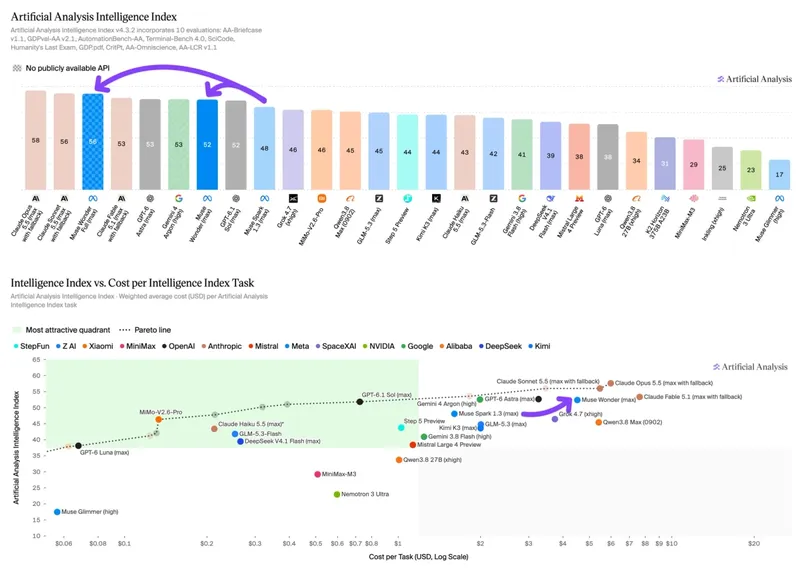
Muse Wonder y Muse Wonder Full: un salto material en inteligencia sobre los modelos anteriores de Meta
Ver la página del modeloMeta ha lanzado Muse Wonder y Muse Wonder Full, logrando puntuaciones de 52 y 56 en el Artificial Analysis Intelligence Index v4.3 con máximo esfuerzo de razonamiento, cada uno una ganancia material sobre Muse Spark 1.3 (max) con 48, con un intervalo de lanzamiento de solo 6 semanas
Muse Wonder está disponible para los usuarios de la API de primera parte de Meta, mientras que Muse Wonder Full actualmente solo está disponible para los usuarios de Muse Code. Meta señala que cada modelo está diseñado para uso personal y profesional de agentes
Conclusiones clave:
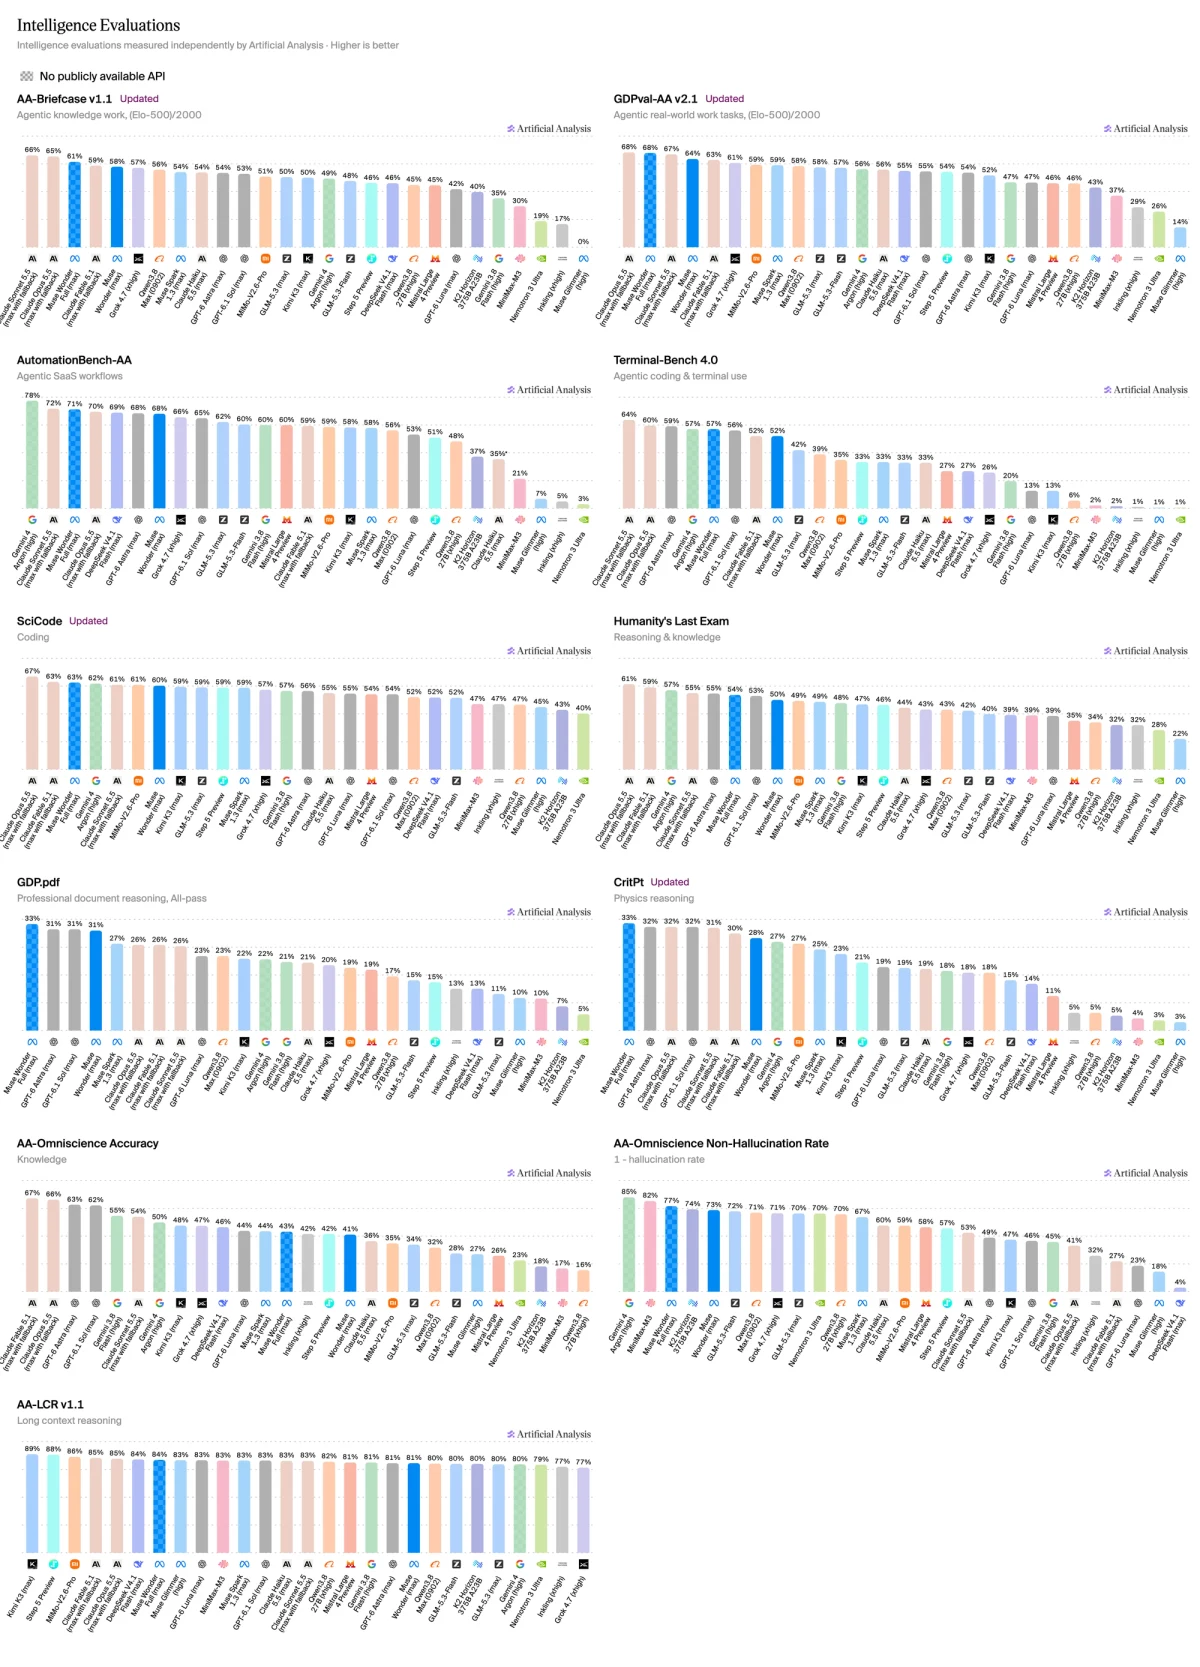
➤ Ambos modelos muestran un salto material en la puntuación general del Intelligence Index. Muse Wonder Full (max) mejora a Muse Spark 1.3 (max) en las diez evaluaciones del Intelligence Index, ganando 8 puntos hasta 56. Las mayores ganancias se observaron en evaluaciones agénticas: Terminal-Bench 4.0 (+24 puntos, 33% a 57%), GDPval-AA v2.1 (+176 Elo, 1681 a 1857) y AA-Briefcase (+148 Elo, 1581 a 1729). Muse Wonder (max) gana 4 puntos del Intelligence Index y se sitúa en 52, con mejoras notables frente a Muse Spark 1.3 (max) en Terminal-Bench 4.0 (33% a 52%) y AutomationBench-AA (58% a 68%)
➤ Muse Wonder Full (max) se sitúa entre los tres primeros en seis de las diez evaluaciones del Intelligence Index, y es particularmente fuerte en trabajo del conocimiento agéntico y razonamiento científico. En trabajo del conocimiento agéntico, lidera por poco en GDP.pdf (33%), ocupa el #2 en GDPval-AA v2.1 (1857 Elo) y el #3 tanto en AA-Briefcase (1729 Elo) como en AutomationBench-AA (71%). En razonamiento científico, encabeza la tabla de CritPt con 33% y ocupa el #3 en SciCode con 63%. Esto se basa en las fortalezas relativas de Muse Spark 1.3 (max), que también mostró una capacidad particular en estos dos dominios
➤ Ambos modelos usan menos tokens de salida que Muse Spark 1.3 (max). Muse Wonder (max) y Muse Wonder Full (max) usan cada uno alrededor de 54k tokens de salida por tarea del Intelligence Index, una reducción de ~10% respecto a Muse Spark 1.3 (max, 60k). Este uso es menor que el de modelos de inteligencia similar como Gemini 4 Argon (high, 62k) y Claude Fable 5.1 (max w/ fallback, 78k), pero mayor que el de GPT-6.1 Sol (max, 38k) y GPT-6 Astra (max, 27k). Muse Wonder Full (max) usa 16% menos tokens de entrada por tarea del Intelligence Index que Muse Wonder (max) (6.44M vs 7.69M), lo que significa que es tanto más inteligente como más eficiente en tokens
➤ El Cost per Task de Muse Wonder (max) se sitúa por encima de la mayoría de los modelos de inteligencia similar. A pesar del uso eficiente de tokens de salida, los precios premium de la API ($4 por millón de tokens de entrada, $20 por millón de tokens de salida) y el alto uso de tokens de entrada (7.69M por tarea) llevan el costo de Muse Wonder (max) a $4.52 por tarea del Intelligence Index. Esto es menor que Claude Fable 5.1 (max w/ fallback, $7.63), Claude Opus 5.5 (max w/ fallback, $5.98) y Claude Sonnet 5.5 (max w/ fallback, $5.46), pero mayor que GPT-6 Astra (max, $3.26), Gemini 4 Argon (high, $1.99), GPT-6.1 Sol (max, $0.72) y su predecesor Muse Spark 1.3 (max, $1.60). Muse Wonder Full no tiene precio por token, por lo que no hay una cifra de Cost per Task disponible
➤ Ambos modelos ganan significativamente en rendimiento de agentes de programación. Muse Wonder Full alcanza 68 en el Artificial Analysis Coding Agents Index con máximo esfuerzo en Muse Code, junto a Claude Code con Sonnet 5.5 (max, 68) y Opus 5.5 (max, 66). Muse Wonder (max) obtiene 63. Esto representa ganancias materiales sobre Muse Code con Muse Spark 1.3 (max), que obtiene 54
Otros detalles de los dos nuevos modelos:
➤ Ventanas de contexto: 1M de tokens cada uno, sin cambios respecto a Muse Spark 1.3
➤ Precios: para Muse Wonder, $4 de entrada / $0.20 de entrada en caché / $20 de salida por 1M de tokens. Muse Wonder Full no tiene precio por token
➤ Modalidades de entrada: texto, imagen, video y audio
➤ Modalidades de salida: texto
➤ Disponibilidad: Muse Wonder está disponible en la API de primera parte de Meta y en Muse Code desde el lanzamiento, mientras que Muse Wonder Full solo está disponible para los usuarios de Muse Code
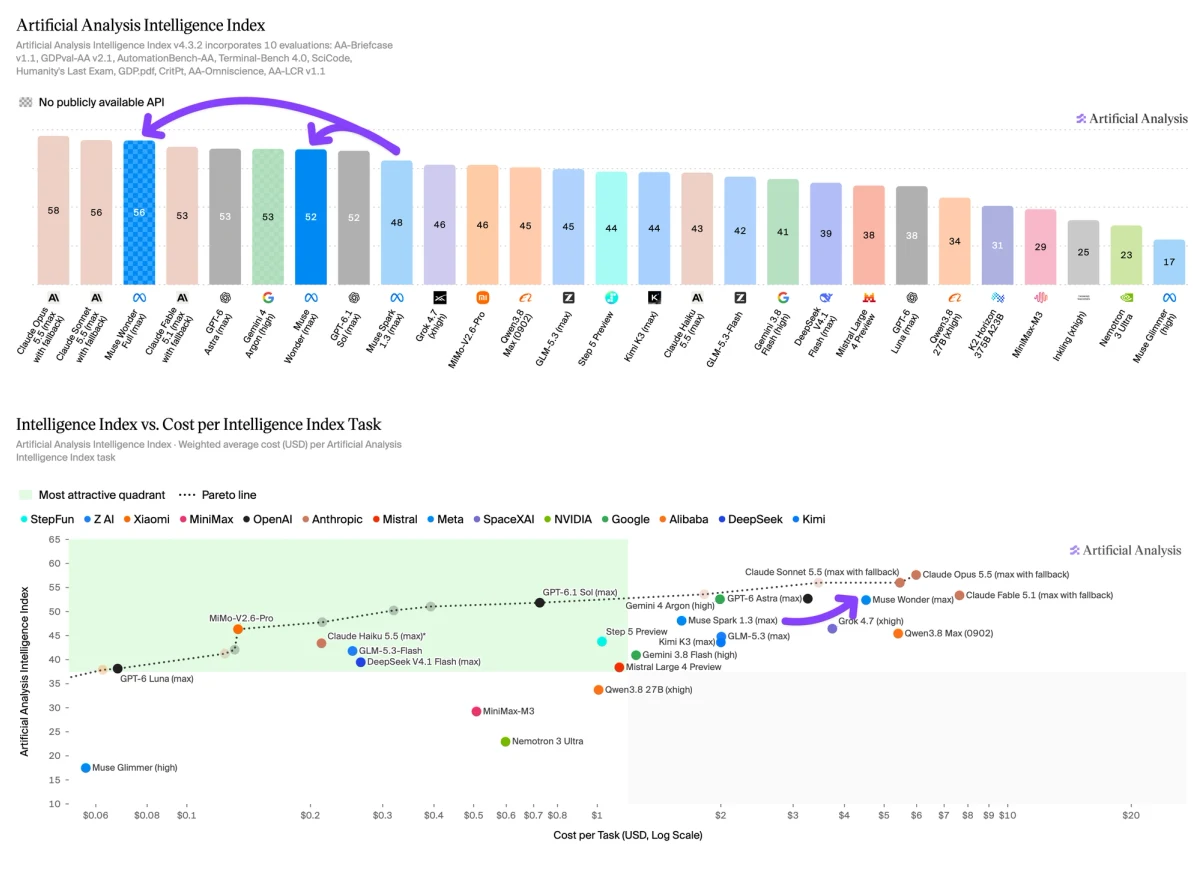
Muse Wonder Full (max) se sitúa entre los tres primeros en seis de las diez evaluaciones del Artificial Analysis Intelligence Index v4.3:
➤ #1 en CritPt (33%) y GDP.pdf (33%)
➤ #2 en GDPval-AA v2.1 (1857 Elo)
➤ #3 en AA-Briefcase (1729 Elo), AutomationBench-AA (71%) y SciCode (63%)
Las ventajas en CritPt y GDP.pdf son estrechas, con los competidores más cercanos obteniendo 31-32%. En GDPval-AA v2.1, su resultado está dentro de los intervalos de confianza de Claude Opus 5.5 (max w/ fallback, 1866) y Claude Sonnet 5.5 (max w/ fallback, 1838)
Su mayor mejora sobre Muse Spark 1.3 (max) es en Terminal-Bench 4.0: del 33% al 57%, quedando al nivel de Gemini 4 Argon (high)
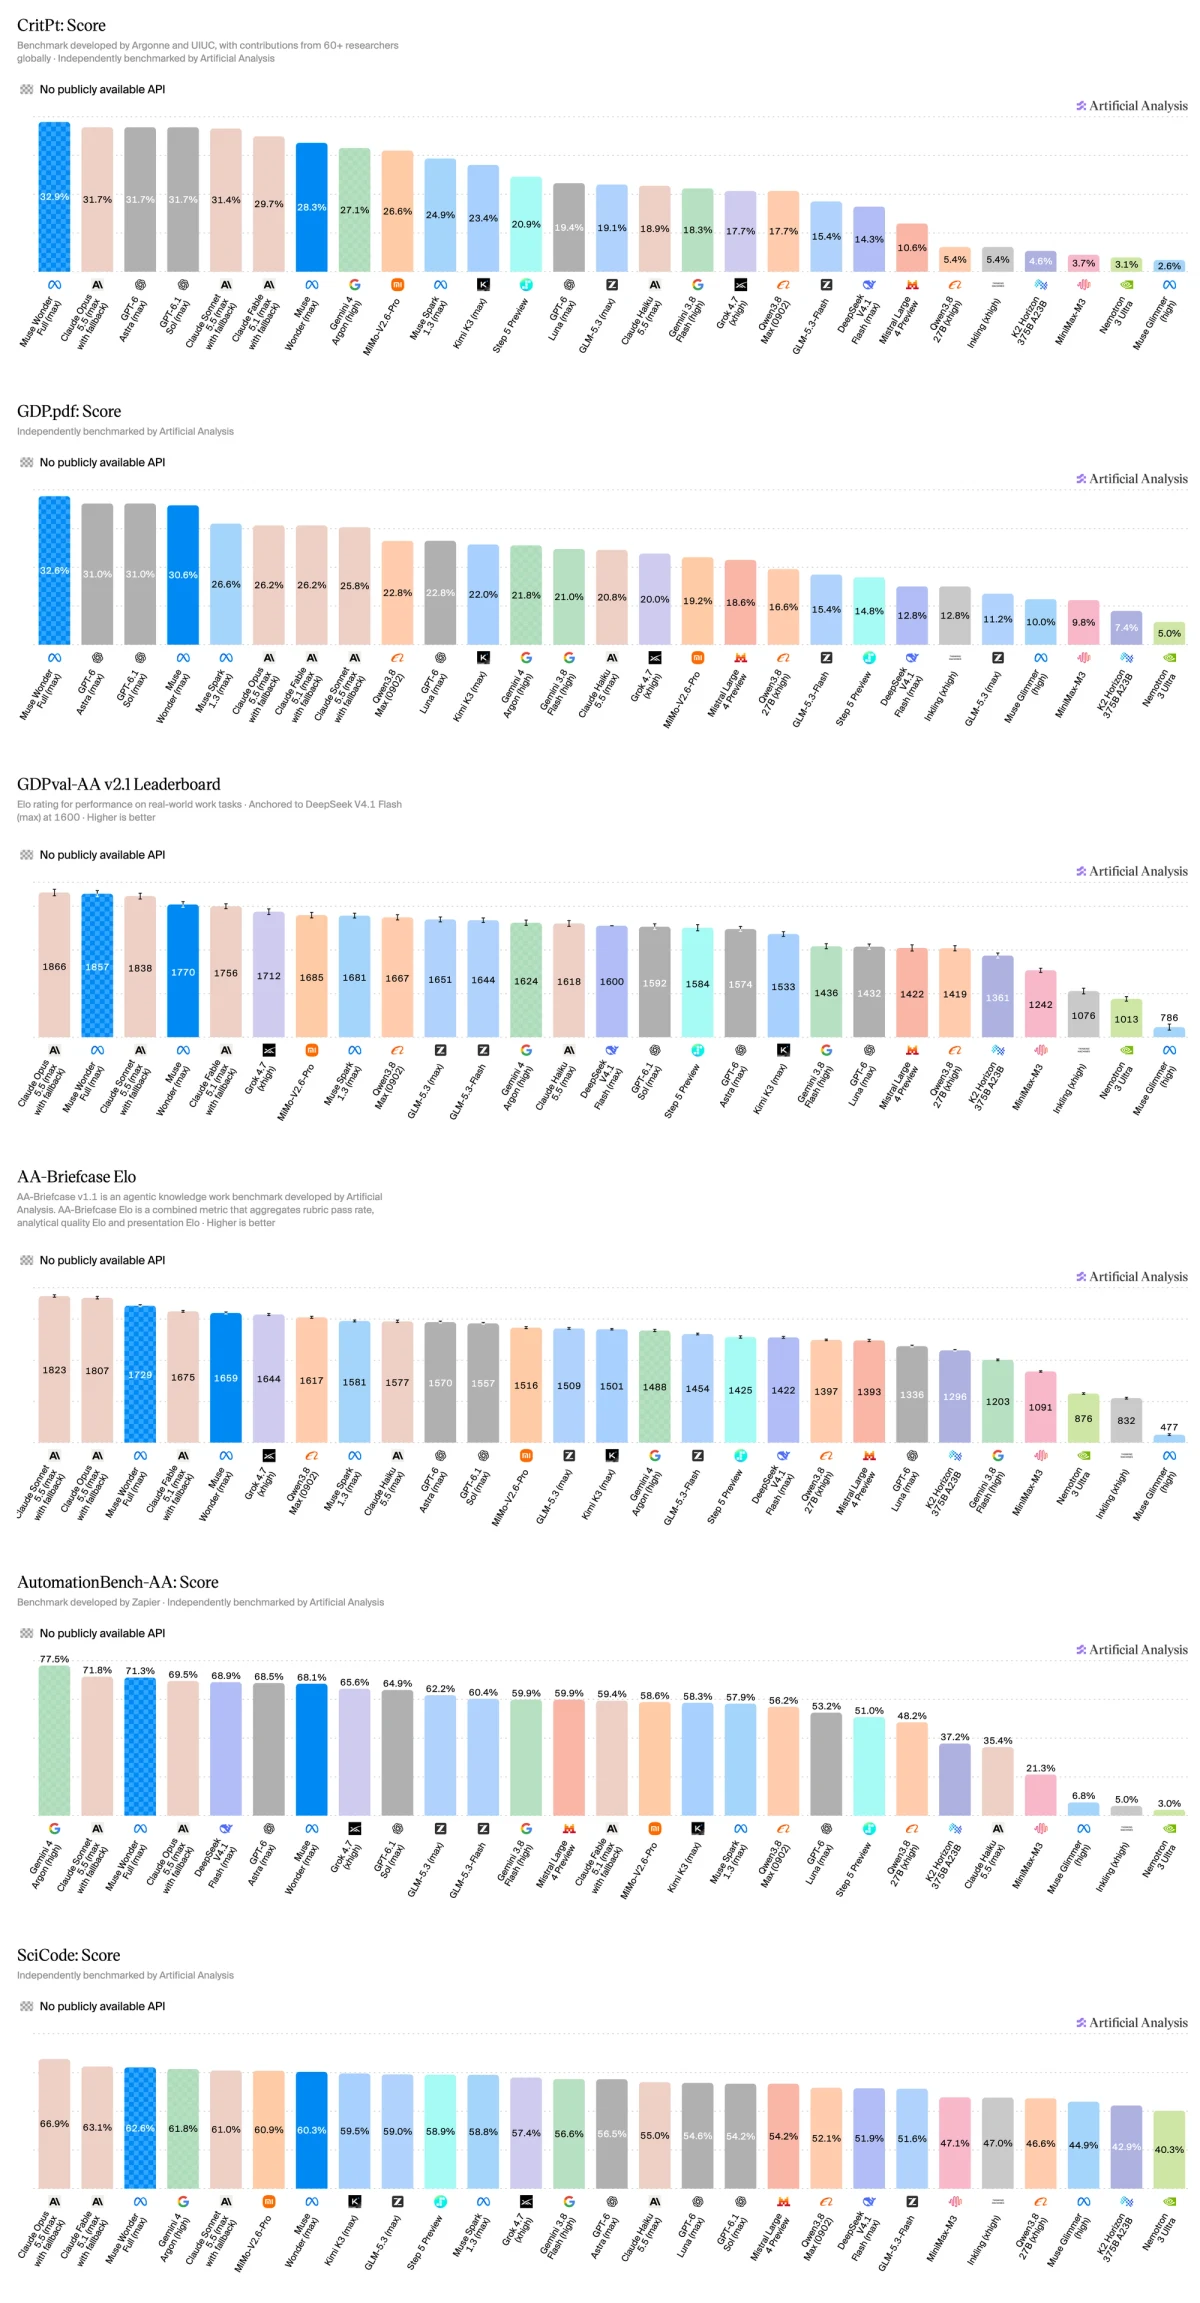
Muse Wonder (max) cuesta $4.52 por tarea del Artificial Analysis Intelligence Index, 2.8 veces Muse Spark 1.3 (max, $1.60), impulsado por precios por token más altos y un mayor uso de tokens de entrada
➤ Precios por token: $4 por 1M de tokens de entrada, $0.20 en caché y $20 de salida, frente a $1.25 / $0.15 / $4.25 de Muse Spark 1.3. Esto coincide con Claude Opus 5.5, es el doble de cada uno de Claude Sonnet 5.5, Gemini 4 Argon y GPT-6.1 Sol ($2/$10), y está un 60% por debajo de GPT-6 Astra y Claude Fable 5.1 ($10/$50)
➤ Entrada: 7.69M de tokens de entrada por tarea, un 28% más que Muse Spark 1.3 (max, 6.03M) y 2-7 veces Gemini 4 Argon (high), GPT-6.1 Sol (max) y GPT-6 Astra (max). La entrada representa $3.43 (76%) de su costo por tarea, compuesto por $1.92 en escrituras de caché, $1.44 en aciertos de caché y $0.07 de entrada sin caché
➤ Salida: alrededor de 54k tokens de salida por tarea ($1.08), un 10% menos que Muse Spark 1.3 (max, 60k)
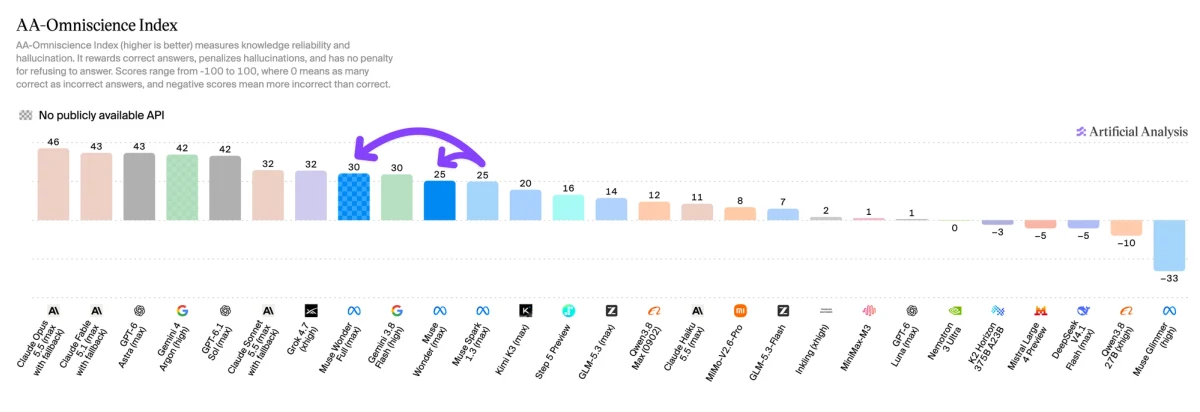
El conocimiento sigue siendo una debilidad relativa para ambos modelos, pero esto se mitiga por tasas de alucinación muy bajas. En AA-Omniscience, Muse Wonder Full (max) obtiene 30 y Muse Wonder (max) obtiene 25, a la par de Muse Spark 1.3 (max), por debajo de Claude Opus 5.5 (46), GPT-6 Astra (43), Gemini 4 Argon (42) y Claude Sonnet 5.5 (32)
La ganancia de 5 puntos de Muse Wonder Full (max) proviene de reducir su tasa de alucinación (33% a 23%), lo que lo sitúa entre los modelos con menos alucinaciones probados: tiene la segunda tasa de alucinación más baja de cualquier modelo con 45 o más puntos en el Intelligence Index, superado solo por Gemini 4 Argon (high, 15%). Muse Wonder (max) es tercero con 27%
Resultados completos del Artificial Analysis Intelligence Index para Muse Wonder Full (max) y Muse Wonder (max):
Compare Muse Wonder Full (max) y Muse Wonder (max) con otros modelos líderes en: https://artificialanalysis.ai/models/muse-wonder-full y https://artificialanalysis.ai/models/muse-wonder