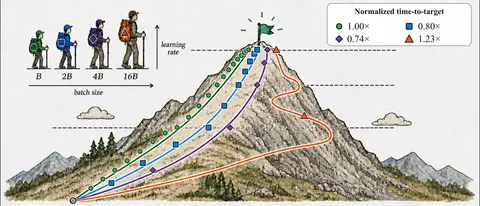
Un batch más grande permite procesar más secuencias en cada actualización, aprovechando así más recursos de cómputo en paralelo; pero, con un presupuesto de muestras fijo, también se reduce el número de veces que el modelo puede actualizarse. En el aprendizaje por refuerzo, ¿cuándo aumentar el batch acorta realmente el tiempo necesario para alcanzar el rendimiento objetivo? En el caso de los grandes modelos de lenguaje, además hay que considerar que las trayectorias de entrenamiento deben generarse en línea, y que la generación y el entrenamiento tienen necesidades de recursos computacionales distintas. Establecimos un marco analítico que relaciona el número de muestras necesarias para alcanzar el objetivo con el rendimiento extremo a extremo: solo cuando la ganancia de throughput supera el coste adicional de muestras, un batch más grande puede acelerar el entrenamiento. Esto también arroja un orden práctico de ajuste: primero encontrar el rango en el que el efecto del aprendizaje permanece aproximadamente invariable ante cambios del tamaño de batch, y luego optimizar el throughput dentro de ese rango. Los experimentos con GRPO y PPO muestran que, tras reajustar la tasa de aprendizaje, las curvas de aprendizaje de diferentes batches se alinean aproximadamente, dentro de cierto rango, al compararlas por número acumulado de muestras. En hardware fijo, aumentar el batch elevó el throughput de generación hasta 2.29 veces; nuestra mejor configuración de GRPO medida redujo en un 29% el tiempo necesario para alcanzar el mismo objetivo de validación, sin añadir GPU.