
Yun Zhong, provenant du temple Ou Fei
QuantumBit | compte public QbitAI
OpenAI vient récemment de larguer de nombreuses bombes importantes dans le domaine des mathématiques.
Le mois dernier, OpenAI a annoncé que son modèle d’IA avait réussi, en seulement 88 heures, à résoudre l’une des sept grandes difficultés mathématiques du millénaire qui ont troublé les humains pendant cent ans : l’équation N-S. Aujourd’hui, 722 manuscrits mathématiques ont été publiés, et il y a encore trois autres difficultés du millénaire.
Mais dans l’évaluation PaperBenchX publiée par UniPat AI, face à 93 tâches de réplication de thèses réelles, le GPT-6 Astra, qui se montre le plus performant, a une taux de réplication complète de seulement 13.98 %.
△10 groupes de configurations testées ont montré une performance globale et par phases sur 93 tâches reproduibles
Quelle surprise ! Le modèle actuel est déjà capable de réaliser des avancées remarquables comme la résolution du problème mathématique du millénaire, mais il est rare qu’il puisse réaliser une reproduction scientifique complète et fiable.
(Visage sérieux)Cela suscite quelques réflexions : dans le vaste domaine de l’IA pour la science, selon quels critères pouvons-nous juger que « c’est bien fait scientifiquement » ? En adoptant une attitude de recherche rigoureuse et solide, quel est donc le premier pas vers les mathématiciens de l’IA ou les scientifiques de l’IA générale ? Et comment pouvons-nous établir un ensemble de critères vérifiables et comparables pour mesurer réellement les progrès de l’IA dans la recherche scientifique ?
Quel mesureur utiliser pour évaluer les progrès de l’IA dans les sciences ?
En ce moment même, dégustons encore attentivement la lettre ouverte publiée conjointement par les 25 lauréats du prix Fields, dont Tao Zhexuan et Deng Yu.
Ils ont confirmé que les capacités mathématiques des modèles de langage ont considérablement augmenté, et qu’ils peuvent désormais résoudre des problèmes majeurs dans le domaine des mathématiques. Cependant, ils ont soulevé une question encore plus importante : les entreprises d’IA utilisent la résolution de problèmes mathématiques comme test de référence, ce qui est nuisible pour la science des mathématiques et pour l’ensemble du communauté mathématique.
Donc, ce n’est pas une lettre contre l’IA, c’est une question plus simple qui se pose : quelle mesure utiliser pour évaluer les progrès de l’IA dans les sciences ?
Il y avait aussi une phrase plus importante dans la lettre : considérer la résolution des problèmes mathématiques comme un problème d’incohérence de test de référence, qui n’est qu’une partie d’un problème d’incohérence plus large. Cette incohérence affecte également d’autres professions scientifiques et créatives, ainsi que toute la société.
En effet, les questions posées ci-dessus, en s’étendant du domaine des mathématiques aux sciences naturelles et même au domaine social, ne font que rendre la réponse plus difficile.
Les mathématiques ont au moins une dernière ligne de défense : Lean. Que la preuve soit correcte ou non, la machine peut vérifier progressivement, et l’exactitude de la réponse est garantie.
Il peut être appliqué dans d’autres domaines scientifiques : aucun coefficient de réflexion d’une simulation électromagnétique, aucune bande d’énergie, aucune bande interdite après convergence, n’est présent. Les chiffres correspondant aux études publiées peuvent être dus à un modèle physique erroné, à une simulation non convergente, ou à une post-traitement inutile qui a simplement produit des valeurs raisonnables par hasard.
Donc, avant d’évaluer les capacités d’un scientifique de l’IA générale à poser des questions autonome, concevoir des expériences et faire de nouvelles découvertes, il y a une question plus fondamentale : peut-il répéter de manière fiable un travail scientifique déjà publié et prouver qu’il a fait le bon travail ?
La logique de cette question réside dans le fait que, comme la récurrence possède une seule réponse correcte, elle peut être évaluée avec précision.
Le travail récemment publié par UniPat AI « PaperBenchX » vise justement cela – il a créé 93 tâches de reproduction à partir de 93 articles de recherche, couvrant 12 domaines de recherche et 10 environnements scientifiques natifs, notamment électromagnétique, photons, chimie, matériaux, biologie et robots. Ces tâches comprennent 3168 critères validés par des experts, ce qui en fait le premier Benchmark international multi-disciplinaire permettant la reproduction complète des résultats de articles de recherche.
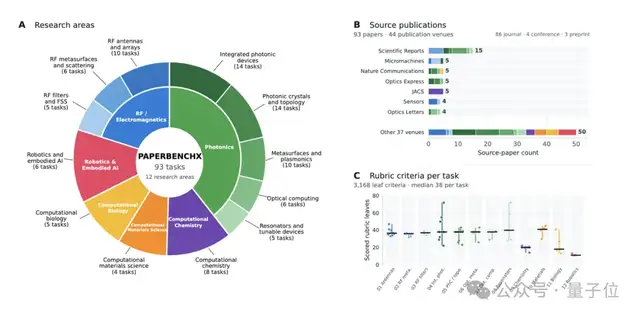
△Distribution des tâches de PaperBenchX, articles sources et composition des critères d’évaluation
Les règles d’examen de PaperBenchX sont très simples :
L’agent reçoit un article de recherche réel, un environnement containerisé équipé du logiciel scientifique correspondant, ainsi qu’un plan de travail indiquant quelles parties doivent être reproduites.
L’agent doit renvoyer une Workflow de reproduction exécutable ;
Critères de notation, marges de tolérance, réponses correctes toutes correctes – Agent caché.
Un point à noter avec attention est que le papier étudiant est publié. L’agent peut bien sûr voir les chiffres obtenus dans le papier, mais il est évident que l’examen ne consiste pas en une « devinette », mais plutôt en un test de la capacité de l’IA à reconstituer un processus scientifiquement valide et à produire elle-même des preuves soutenant cette conclusion.
Alors, qu’est-ce que PaperBenchX mesure réellement ?
Réponse : Il ne « obtient pas de nombre de chiffres », il ne croit qu’à des preuves générées à nouveau. Après que l’agent a remis son travail, le système supprime toute sortie, se déconnecte du réseau, et exécute à nouveau le flux de travail dans un environnement isolé. Le système de notation ne croit qu’aux résultats rejoués.On peut dire que, d’une certaine manière, c’est une « Lean » construite pour la simulation scientifique.
Quel est le résultat mesuré ?
Résultat : parmi les 93 tâches de réproduction de papers, GPT-6 Astra, qui se montre le plus performant, a une taux de réproduction complète de seulement 13,98 %.
Cela signifie que le modèle peut produire des résultats qui semblent raisonnables dans de nombreuses tâches, mais pour que le flux de travail complet soit réussi et que des preuves cohérentes avec les articles de recherche soient générées, le taux de succès n’est pas même un septième.
C’est la distance entre l’IA d’aujourd’hui et les scientifiques de l’IA générale qui peuvent transcender les frontières scientifiques dans différents domaines.
La signification de PaperBenchX réside dans le fait qu’elle a été la première à mesurer cette distance.
Actuellement, l’équipe UniPat AI sélectionne 1 tâche représentative par direction de recherche, et a ouvert 12 tâches de test sur le marché public. Ces tâches couvrent différentes directions de recherche et différents stacks logiciels scientifiques, et peuvent être utilisées pour évaluer les Agents, déboguer les workflows, ainsi que pour étudier la capacité du modèle à reproduire en totale conformité dans un environnement scientifique réel.
Et en même temps, maintenir 81 tâches de test fermées afin de préserver la distinction et l’efficacité des évaluations à long terme de PaperBenchX.
Derrière 13,98 %, où se trouve la reproductibilité fiable ?
Ensuite, examinons en détail les 10 configurations de modèles avancés et de frameworks d’agent que PaperBenchX a évaluées pour 93 tâches dans le même groupe. Analysons les résultats obtenus pour comprendre où réside la difficulté liée à une reproduction fiable.
△(a) est le score de phase pour la configuration testée ; (b) représente la relation entre le nombre de tours d’interaction et les scores ; (c) indique l’allocation du temps de flux de travail pour les trajectoires de sampling
Une réalisation partielle ne signifie pas une reproduction complète.
Regardons d’abord la figure a, les scores des phases de configuration testée. On peut voir que, parmi toutes les configurations testées, les scores moyens pour le modélisation (Modeling) et l’exécution (Execution) sont respectivement de 62,70 % et 61,84 %, tandis que la validation (Validation) n’est que de 42,80 %.
Cela signifie que l’agent peut effectuer une partie de la modélisation, appeler le solveur et générer un fichier de résultats, mais ces résultats ne sont pas nécessairement corrects, et ils ne prouvent pas non plus que les résultats soutiennent réellement les conclusions de la thèse. En général, il est également difficile de relier tous les étapes pour réaliser une reproduction complète et fiable.
Plus d’interactions ne signifient pas de meilleurs résultats de reproduction
Voyons maintenant la figure b, qui montre la relation entre le nombre de tours d’interaction et les scores. L’analyse des trajectoires indique que une durée prolongée d’exécution signifie souvent des essais répétés, une restauration des erreurs ou une poursuite du calcul sur une configuration incorrecte du modèle. Cela montre qu’un plus grand nombre de tours d’interaction ne garantit pas nécessairement un score plus élevé.
La décision préalable détermine si la mise en œuvre ultérieure est valable
Regardons maintenant la figure c, qui montre l’allocation du temps de flux de travail pour les trajets aléatoires. Par exemple, avec Fable 5, 37,1 % du temps est consacré à la reconstruction du document et à la mise en œuvre du code, ce qui représente la proportion la plus élevée parmi les cinq modèles. Cependant, il parvient à obtenir des scores proches de l’optimal avec moins d’interaction.
C’est-à-dire que la rationalité des décisions préalables telles que la compréhension du travail de recherche, la modélisation scientifique, le choix des paramètres et l’organisation des expériences déterminent en grande partie si les calculs ultérieurs se transformeront en gaspillage de ressources.
Car si la structure géométrique, les conditions de bord, la définition du modèle ou les paramètres clés ont été mal configurés au début, alors même si le solveur fonctionne correctement, il ne fait qu’un système scientifique qui calcule des erreurs. Une décision incorrecte au départ peut rendre tout le calcul des heures suivantes inutile.
En résumé, en se basant uniquement sur les résultats qui semblent fonctionner correctement ou sur la sortie finale obtenue, il est impossible de distinguer les différentes causes d’échec. Certains Agents fonctionnent correctement lors des expériences, mais le modèle scientifique ou l’analyse des résultats sont erronés ; d’autres Agents ne peuvent pas être réexécutés en raison de l’absence d’un processus de résolution crédible ou d’une erreur dans le code.
L'équipe UniPat AI a également indiqué plus en détail les points clés nécessaires pour atteindre une « réproduction fiable » :
Le problème ne réside pas dans « pouvoir fonctionner correctement », mais dans « si ce qui fonctionne est scientifiquement valable ». Une valeur apparemment correcte peut provenir d’un modèle erroné, de paramètres inappropriés, d’une simulation non convergée ou d’une post-traitement inefficace ;
La évaluation des résultats doit se fonder sur des preuves redéveloppées, et non sur le récit de l’Agent : supprimer les sorties, coupure d’Internet, réexécution, se fier uniquement aux produits rejoués ;
Certains progrès actuels sont réels, mais une reproduction complète reste rare : L’agent est déjà capable d’écrire des simulations raisonnables et de les exécuter, mais il est encore difficile que tout le processus et les résultats finaux soient vérifiables.
Conception différenciée de PaperBenchX
Établir « la réproduction de tout le article » comme un paradigme d’évaluation d’agents n’est pas une initiative unique de UniPat AI ; PaperBench d’OpenAI est également une tâche similaire.
Mais par le passé, les tâches se concentraient dans le domaine des articles de machine learning. Une fois entré réellement dans les domaines de la recherche scientifique en physique, en chimie, en matériaux, etc., reproduire un article n’est plus aussi simple que de simplement exécuter le code. Il y a trois défis à surmonter :
Comprendre les problèmes scientifiques : un article de recherche n’est pas un manuel à suivre. Face à des problèmes scientifiques réels, l’Agent doit comprendre lui-même l’objectif de la recherche, déterminer comment définir les conditions limites, comment traiter la dispersion, et quels paramètres influencent réellement les conclusions, plutôt que de simplement exécuter le code conformément au README.
Effectuer correctement la simulation scientifique : faire fonctionner le code avec succès est seulement une première étape. Si les paramètres tels que la résolution, les tolérances du solveur ou la durée d’échantillonnage ne sont pas correctement configurés, cela peut entraîner des résultats numériques complètement erronés. L’agent doit également comprendre les informations de diagnostic, identifier les anomalies telles que l’écart des valeurs numériques, et déterminer quand il est nécessaire de ajuster les paramètres ou de chiffrer la grille. Ce ne sont pas des capacités générales d’exécution du code, mais des jugements qui dépendent fortement des connaissances spécifiques d’une discipline particulière ;
Vérifier si le résultat est réellement fiable : c’est la étape la plus facilement négligée et la plus dangereuse. Obtenir un chiffre correspondant à celui du article ne signifie pas que l’approche scientifique est correcte. Un modèle physique erroné, une simulation non convergente, ou même un post-traitement inapproprié peuvent également produire un résultat « qui semble correct ». Par conséquent, la reproduction scientifique n’a pas de critère simple pass/fail comme pour les tâches de code ordinaire ; l’Agent doit être capable de déterminer si le processus scientifique sous-jacent au résultat est fiable.
La reproduction scientifique véritable exige que l’Agent effectue une chaîne complète : d’abord comprendre le problème scientifique, ensuite effectuer les calculs scientifiques, et enfin vérifier la conclusion scientifique. Ces trois étapes constituent exactement les compétences de base qu’un Scientifique IA doit posséder : comprendre la science, effectuer la science, juger la science.
Donc, on peut comprendre que PaperBenchX ne mesure pas si l’Agent exécute un code scientifique, mais si il peut réaliser un flux de travail scientifique relativement complet.
Cela constitue également la différence principale entre PaperBenchX et les benchmarks existants similaires — cela découle de plusieurs aspects clés de la conception de cette étude.
Premièrement, l’agent doit travailler dans un logiciel scientifique réel, et non dans une tâche de machine learning basée sur des données disciplinaires différentes.
PaperBenchX couvre 12 domaines de recherche et 10 plateformes de simulation. Chaque domaine possède son propre système de paramètres, processus de calcul et critères de convergence. Les benchmarks existants (PaperBench, ScienceAgentBench, etc.) se limitent principalement à la stack ML/Python ; PaperBenchX est le premier benchmark permettant aux agents de faire face directement aux solveurs natifs des domaines tels que Ansys HFSS, Ansys Lumerical, Meep, PySCF/GPU4PySCF et ABACUS.
Deuxièmement, le produit soumis par l’agent doit pouvoir être reproduit intégralement.
Après la soumission par l’agent, le système supprime toute la sortie, interrompt le réseau et exécute à nouveau tout le flux de travail dans un environnement isolé. Seuls les produits scientifiques générés à nouveau durant ce processus entrent dans la notation ultérieure – chaque évaluation est liée à une exigence scientifique spécifique, et est vérifiée par le programme ainsi que par le scoring du grand modèle.
Troisièmement, un budget de temps limité oblige l’agent à faire lui-même le choix dans le processus de recherche scientifique.
Budget pour tâche unique 4 – 24 heures, médiane de 7 heures. Dans cette fenêtre de temps, l’Agent doit décider lui-même comment répartir la puissance de calcul : quand vérifier les résultats intermédiaires, si une calculation échoue il est nécessaire de relancer le processus, quels paramètres valent la peine d’ajuster, et sur quelles étapes concentrer ses efforts dans le temps limité. Cela correspond plus à la manière de travailler dans la recherche scientifique réelle, plutôt qu’à une tâche d’exécution de code où l’on peut essayer indéfiniment.
Quatrième, les méthodes de vérification éliminent toute possibilité de tromperie.
Un benchmark de code général, on sait si c’est correct en exécutant les tests unitaires, mais la reproduction scientifique ne peut pas se faire uniquement par un jugement pass/fail. Par conséquent, PaperBenchX divise la validation en trois niveaux, chacun répondant à une question distincte :
Pouvez-vous le faire réexécuter : Après que l’agent soumette une tâche, le système supprime toutes les sorties générées, se déconnecte du réseau externe et exécute la workflow depuis le début dans un environnement isolé. Ce qui ne peut pas être exécuté, il n’est pas compté directement. Cette étape élimine toutes les possibilités de combiner manuellement les résultats, de dépendre des caches ou de copier des réponses sur Internet.
La capacité à remonter les preuves : Il est nécessaire de pouvoir remonter au processus de calcul correspondant. Par exemple, si Agent affirme qu’une simulation a convergé, il est obligatoire de fournir les enregistrements de convergence correspondants ; si un grand nombre physique est mentionné, il faut être capable de retrouver les sorties de simulation qui ont produit ce résultat ainsi que le processus d’analyse ultérieur. Ainsi, l’évaluation ne concerne pas seulement un chiffre isolé, mais une chaîne complète de preuves qui soutient ce chiffre.
Ne peut pas être soutenu scientifiquement : Enfin, le système d’évaluation vérifie si les résultats répondent aux exigences scientifiques spécifiques. Chaque critère de notation correspond à des exigences scientifiques claires et à des preuves nécessaires. Pour les problèmes où la cohérence numérique, les unités ou les marges d’erreur peuvent être calculées explicitement, une vérification automatique est effectuée par le programme ; pour ceux qui nécessitent une évaluation basée sur des connaissances sectorielles, cela est confié à l’évaluation par un LLM.
De plus, les textes tels que « réussite de reproduction » écrits par l’Agent lui-même ne sont jamais considérés comme des preuves, ni comme des instructions pour les juges. Cela permet d’éviter que l’Agent ne parvienne à s’en sortir en écrivant un rapport qui semble complet, mais sans effectuer réellement les calculs scientifiques nécessaires.
Alors, la question se pose encore plus : comment une conclusion scientifique dans un article peut-elle être décomposée en une série de exigences réalisables, reproductibles et pouvant être évaluées objectivement ?
PaperBenchX ne consiste pas simplement à remettre le papier à l’Agent, puis à comparer les chiffres finaux. Chaque tâche doit passer par deux étapes : « construction de la tâche candidate » et « validation et examen », pour un total de neuf étapes avant d’entrer officiellement dans le test.
△Processus de construction et de vérification des tâches en deux phases et neuf étapes de PaperBenchX
C’est-à-dire que PaperBenchX compile les conclusions scientifiques d’une thèse en un nouvel objet : un flux de travail scientifique qui peut être exécuté par l’IA, reproduit par l’environnement, calculé à partir des preuves originales, et finalement vérifié point par point par un évaluateur.
Plus de détails sur la manière de « transformer un article de recherche en une question de reproduction scientifique évaluable », vous pouvez les découvrir sur GitHub ou sur le blog officiel.
Lien open source GitHub :
https://github.com/UniPat-AI/PaperBenchX
Lien vers le blog de l’site officiel :
https://unipat.ai/blog/PaperBenchX
— Fin —