
L'inférence mono-Région peut être limitée lorsque la demande dépasse la capacité locale. Les équipes en Thaïlande, Malaisie, Singapour, Indonésie et Taïwan ont besoin d'accéder aux derniers modèles OpenAI au-delà de cette capacité. Amazon Bedrock propose OpenAI GPT-6 Sol et GPT-6 Luna via l'inférence multi-Régions mondiale depuis les cinq Régions AWS, et GPT-6 Astra depuis l'Asie-Pacifique (Singapour). Cet article vous montre comment configurer l'appel, définir les autorisations et surveiller l'inférence depuis votre Région source.
GPT-6 Sol, GPT-6 Luna et GPT-6 Astra sont tous disponibles via l'inférence multi-Régions mondiale depuis les Régions précédentes, sur le point de terminaison bedrock-runtime . Voir Cross-Region inference dans le Amazon Bedrock User Guide. Pour la liste complète des Régions sources et de destination dans chaque profil, voir Supported Regions and models for inference profiles.
Dans cet article, nous présentons les profils d'inférence multi-Régions mondiaux et les invoquons depuis l'Asie-Pacifique (Singapour) à l'aide de l'API Converse, des API compatibles OpenAI et de clients de codage. Nous couvrons ensuite la configuration AWS Identity and Access Management (IAM) et de la stratégie de contrôle de service (SCP), la gestion des quotas et la surveillance.
Profils d'inférence multi-Régions mondiaux pour OpenAI GPT-6
La famille GPT-6 propose trois modèles, chacun disponible via l'inférence multi-Régions mondiale.
- GPT-6 Sol apporte de fortes capacités de raisonnement et de codage aux tâches complexes effectuées tout au long de la semaine.
- GPT-6 Luna rend pratiques, à volume élevé, les tâches ciblées et répétables.
- GPT-6 Astra gère le raisonnement complexe, le codage et le travail sur des documents longs.
Les trois acceptent les entrées texte et image, l'utilisation d'outils côté client et la mise en cache des prompts. Ils diffèrent par l'effort de raisonnement. GPT-6 Sol et GPT-6 Luna acceptent none, low, medium, high, xhigh et max. GPT-6 Astra accepte les mêmes niveaux sauf none. Pour GPT-6 Sol et GPT-6 Luna, voir Apportez plus d'intelligence au travail quotidien avec GPT-6 Sol et GPT-6 Luna sur Amazon Bedrock. Pour GPT-6 Astra, voir Take on your most ambitious work with GPT-6 Astra on Amazon Bedrock.
L'inférence multi-Régions mondiale achemine les requêtes à travers les Régions AWS commerciales prises en charge où le modèle est déployé, vous donnant un large accès à la capacité Amazon Bedrock. Vous l'invoquez en passant un ID de profil d'inférence multi-Régions mondial à la place d'un ID de modèle. Votre Région source est celle où vous effectuez l'appel API. Amazon Bedrock sélectionne la Région de destination pour le traitement. La facturation, le suivi des quotas, AWS CloudTrail et Amazon CloudWatch restent tous dans votre Région source.
Le tableau suivant répertorie les ID des profils d'inférence multi-Régions mondiaux et les Régions sources couvertes dans cet article.
| Profils d'inférence multi-Régions mondiaux | Régions sources | Régions de destination |
|
global.openai.gpt-6-sol global.openai.gpt-6-luna |
Asie-Pacifique (Singapour) ap-southeast-1 Asie-Pacifique (Jakarta) ap-southeast-3 Asie-Pacifique (Malaisie) ap-southeast-5 Asie-Pacifique (Thaïlande) ap-southeast-7 Asie-Pacifique (Taipei) ap-east-2 |
Régions AWS commerciales prises en charge où le modèle est déployé |
| global.openai.gpt-6-astra | Asie-Pacifique (Singapour) ap-southeast-1 | Régions AWS commerciales prises en charge où le modèle est déployé |
La disponibilité des profils d'inférence et la prise en charge des Régions évoluent à mesure qu'AWS ajoute des Régions et des profils ; confirmez donc les deux sur la fiche du modèle avant de commencer : GPT-6 Sol, GPT-6 Lunaet GPT-6 Astra. Pour les tarifs par jeton, consultez Tarification d'Amazon Bedrock.
Prise en main des modèles OpenAI sur Amazon Bedrock
Commencez par les prérequis, puis appelez l'un des trois profils via l'API Converse, les API compatibles OpenAI ou votre client de codage existant.
Prérequis
- Une identité IAM disposant de l'autorisation d'invoquer le profil. La politique IAM de la section Security and permissions n'accorde que ce dont ces exemples ont besoin.
- Votre Région source activée. Seule la Région depuis laquelle vous effectuez des appels doit être activée. Vous n'activez pas les Régions de destination, qui s'exécutent sur une capacité gérée d'Amazon Bedrock. Singapour (
ap-southeast-1) est une Région activée par défaut. Jakarta (ap-southeast-3), la Malaisie (ap-southeast-5), la Thaïlande (ap-southeast-7) et Taipei (ap-east-2) sont des Régions à activation requise (opt-in) que vous devez activer au préalable. Pour plus d'informations, consultez Enable or disable AWS Regions in your account. - Un AWS SDK ou une CLI à jour. Les exemples compatibles avec OpenAI nécessitent également le SDK OpenAI et le générateur de jetons Amazon Bedrock. Installez-les avec
pip install boto3 openai aws-bedrock-token-generator.
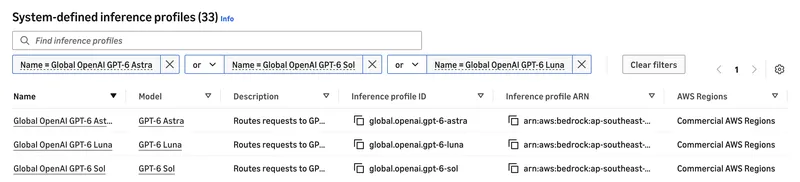
La console Amazon Bedrock répertorie les trois profils d'inférence inter-Régions globaux sous les profils d'inférence définis par le système. Voir la Figure 1.
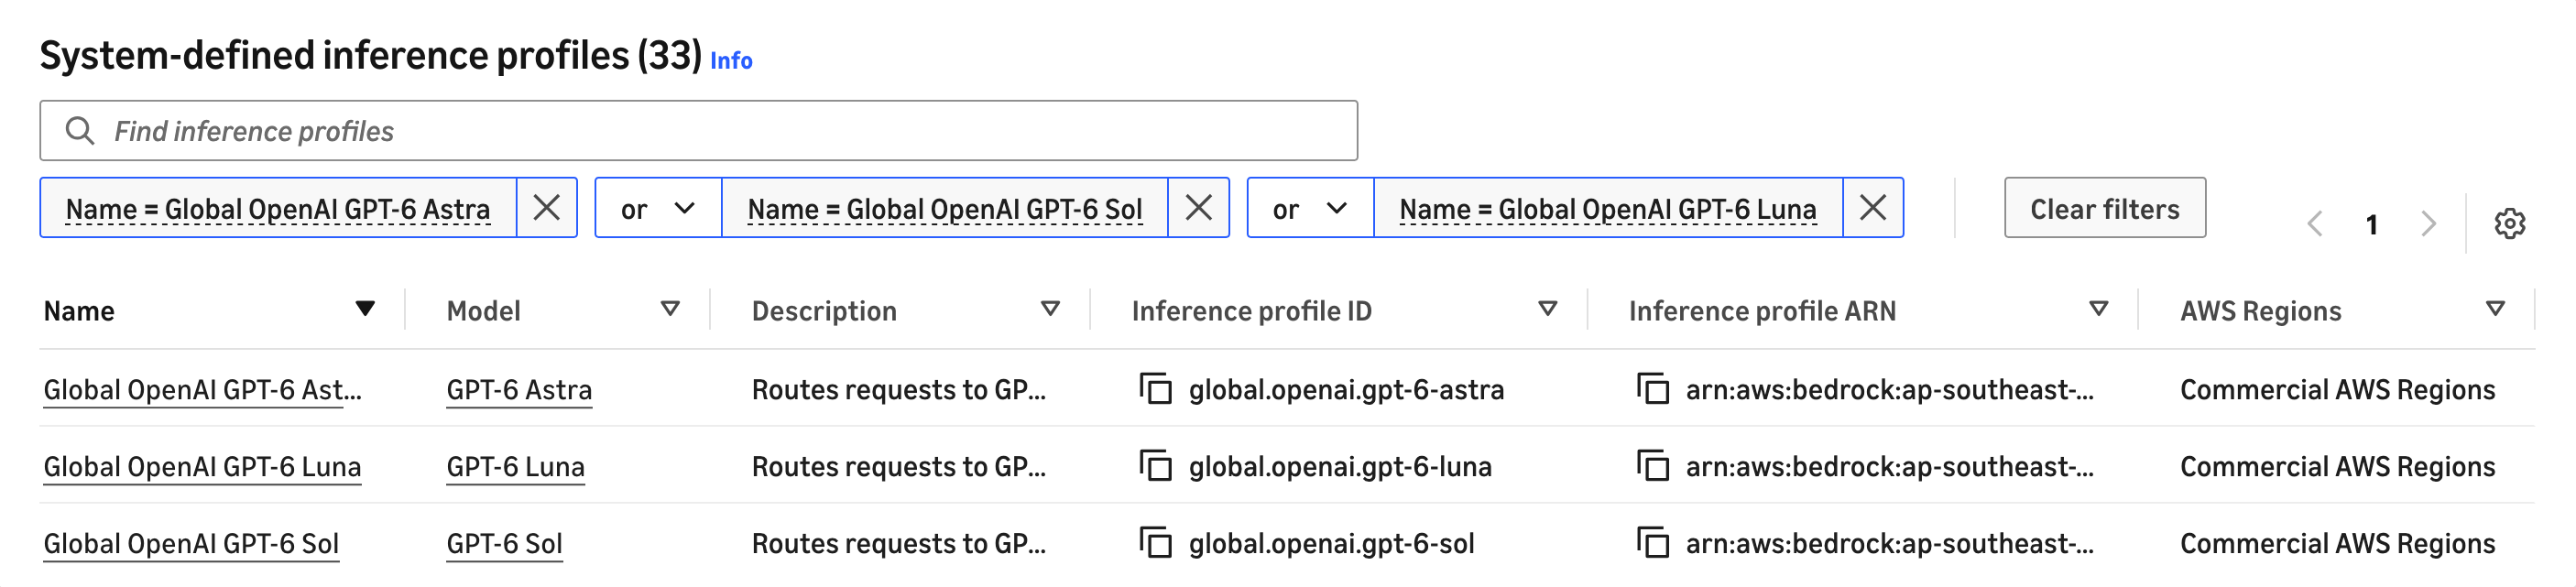
Figure 1 : Les trois profils d'inférence globaux OpenAI GPT-6 parmi les profils définis par le système dans la console Amazon Bedrock
Invoquer les modèles GPT-6 via Amazon Bedrock Runtime
Chaque modèle prend en charge trois chemins d'accès sur ce point de terminaison : l'API Amazon Bedrock Converse, l'API OpenAI Responses et l'API OpenAI Chat Completions. Les API compatibles avec OpenAI sont appelées sur les chemins /openai/v1 plutôt que via les AWS SDK, et le point de terminaison accepte soit Signature Version 4 (SigV4), soit une clé d'API Amazon Bedrock. Dans tous les cas, transmettez l'ID du profil d'inférence inter-Régions global en tant que model .
API Converse. Cet exemple appelle GPT-6 Sol depuis Asie Pacifique (Singapour) et journalise la réponse. Définissez BEDROCK_PROFILE_ID sur global.openai.gpt-6-luna ou global.openai.gpt-6-astra pour changer de modèle, ou appelez converse_stream pour le streaming.
import logging
import os
import boto3

# AWS_REGION overrides this default, so set it to your source Region or unset it.
REGION = os.environ.get("AWS_REGION", "ap-southeast-1")
PROFILE_ID = os.environ.get("BEDROCK_PROFILE_ID", "global.openai.gpt-6-sol")
PROMPT = (
    "In three bullet points, explain when a workload should use "
    "cross-Region inference instead of calling a model in a single Region."
)

logging.basicConfig(format="%(levelname)s %(message)s")
log = logging.getLogger("bedrock-cris")
log.setLevel(logging.INFO)

client = boto3.client("bedrock-runtime", region_name=REGION)

# AccessDeniedException points at the IAM policy. ValidationException usually
# means the model ID is not a global cross-Region inference profile.
response = client.converse(
    modelId=PROFILE_ID,
    messages=[{"role": "user", "content": [{"text": PROMPT}]}],
    inferenceConfig={"maxTokens": 1024},
    # GPT-6 Sol and Luna accept none through max. GPT-6 Astra rejects none.
    additionalModelRequestFields={"reasoning": {"effort": "low"}},
)

# Any effort above none can prepend a reasoningContent block, so pick the text
# block by key rather than by position.
text = "".join(b["text"] for b in response["output"]["message"]["content"] if "text" in b)

log.info("Called %s from %s", PROFILE_ID, REGION)
log.info("Stop reason: %s", response["stopReason"])
log.info("Response:\n%s", text)
API OpenAI Chat Completions. Pointez le SDK OpenAI vers le point de terminaison Régional et transmettez le même ID de profil.
import logging
import os
from aws_bedrock_token_generator import provide_token
from openai import OpenAI

REGION = os.environ.get("AWS_REGION", "ap-southeast-1")
PROFILE_ID = os.environ.get("BEDROCK_PROFILE_ID", "global.openai.gpt-6-sol")
PROMPT = "List three uses for a message queue."

logging.basicConfig(format="%(levelname)s %(message)s")
log = logging.getLogger("bedrock-cris")
log.setLevel(logging.INFO)

# provide_token mints a short-term key from your AWS credentials, valid up to 12 hours.
client = OpenAI(
    base_url=f"https://bedrock-runtime.{REGION}.amazonaws.com/openai/v1",
    api_key=provide_token(region=REGION),
)

response = client.chat.completions.create(
    model=PROFILE_ID,
    messages=[{"role": "user", "content": PROMPT}],
    max_completion_tokens=256,
)

log.info("Called %s from %s", PROFILE_ID, REGION)
log.info("Response:\n%s", response.choices[0].message.content)
Lors de la migration d'un client OpenAI existant :
- Définissez le paramètre model sur chaque requête, y compris celles faisant référence à une réponse précédente.
- Utilisez les types d'outils pris en charge :
function,mcp,custom,namespace, ettool_search. - Configurez l'ID du profil d'inférence directement dans votre client plutôt que d'interroger le point de terminaison des modèles.
Configurer l'application de bureau ChatGPT et le Codex CLI
L'application de bureau ChatGPT et le Codex CLI partagent ~/.codex/config.toml, de sorte qu'une seule modification couvre les deux. Parmi les deux fournisseurs Amazon Bedrock intégrés, seul amazon-bedrock-runtime accepte un profil d'inférence.
model = "global.openai.gpt-6-astra"
model_provider = "amazon-bedrock-runtime"
[model_providers.amazon-bedrock-runtime.aws]
region = "ap-southeast-1"
La signature SigV4 signifie qu'il n'y a aucune clé à faire tourner. Ajoutez profile = "<your-profile>" pour un profil non par défaut, et définissez region explicitement, car sinon le client retombe sur AWS_REGION. Remplacez par un autre identifiant de profil model pour changer de modèle.
Codex signale une fenêtre de 272,000 jetons pour ces profils, ce qui est sa propre valeur intégrée plutôt qu'une limite du service. Augmentez-la avec model_context_window. Cette configuration nécessite Codex CLI 0.148 ou une version ultérieure.
La figure 2 montre le résultat dans l'application.
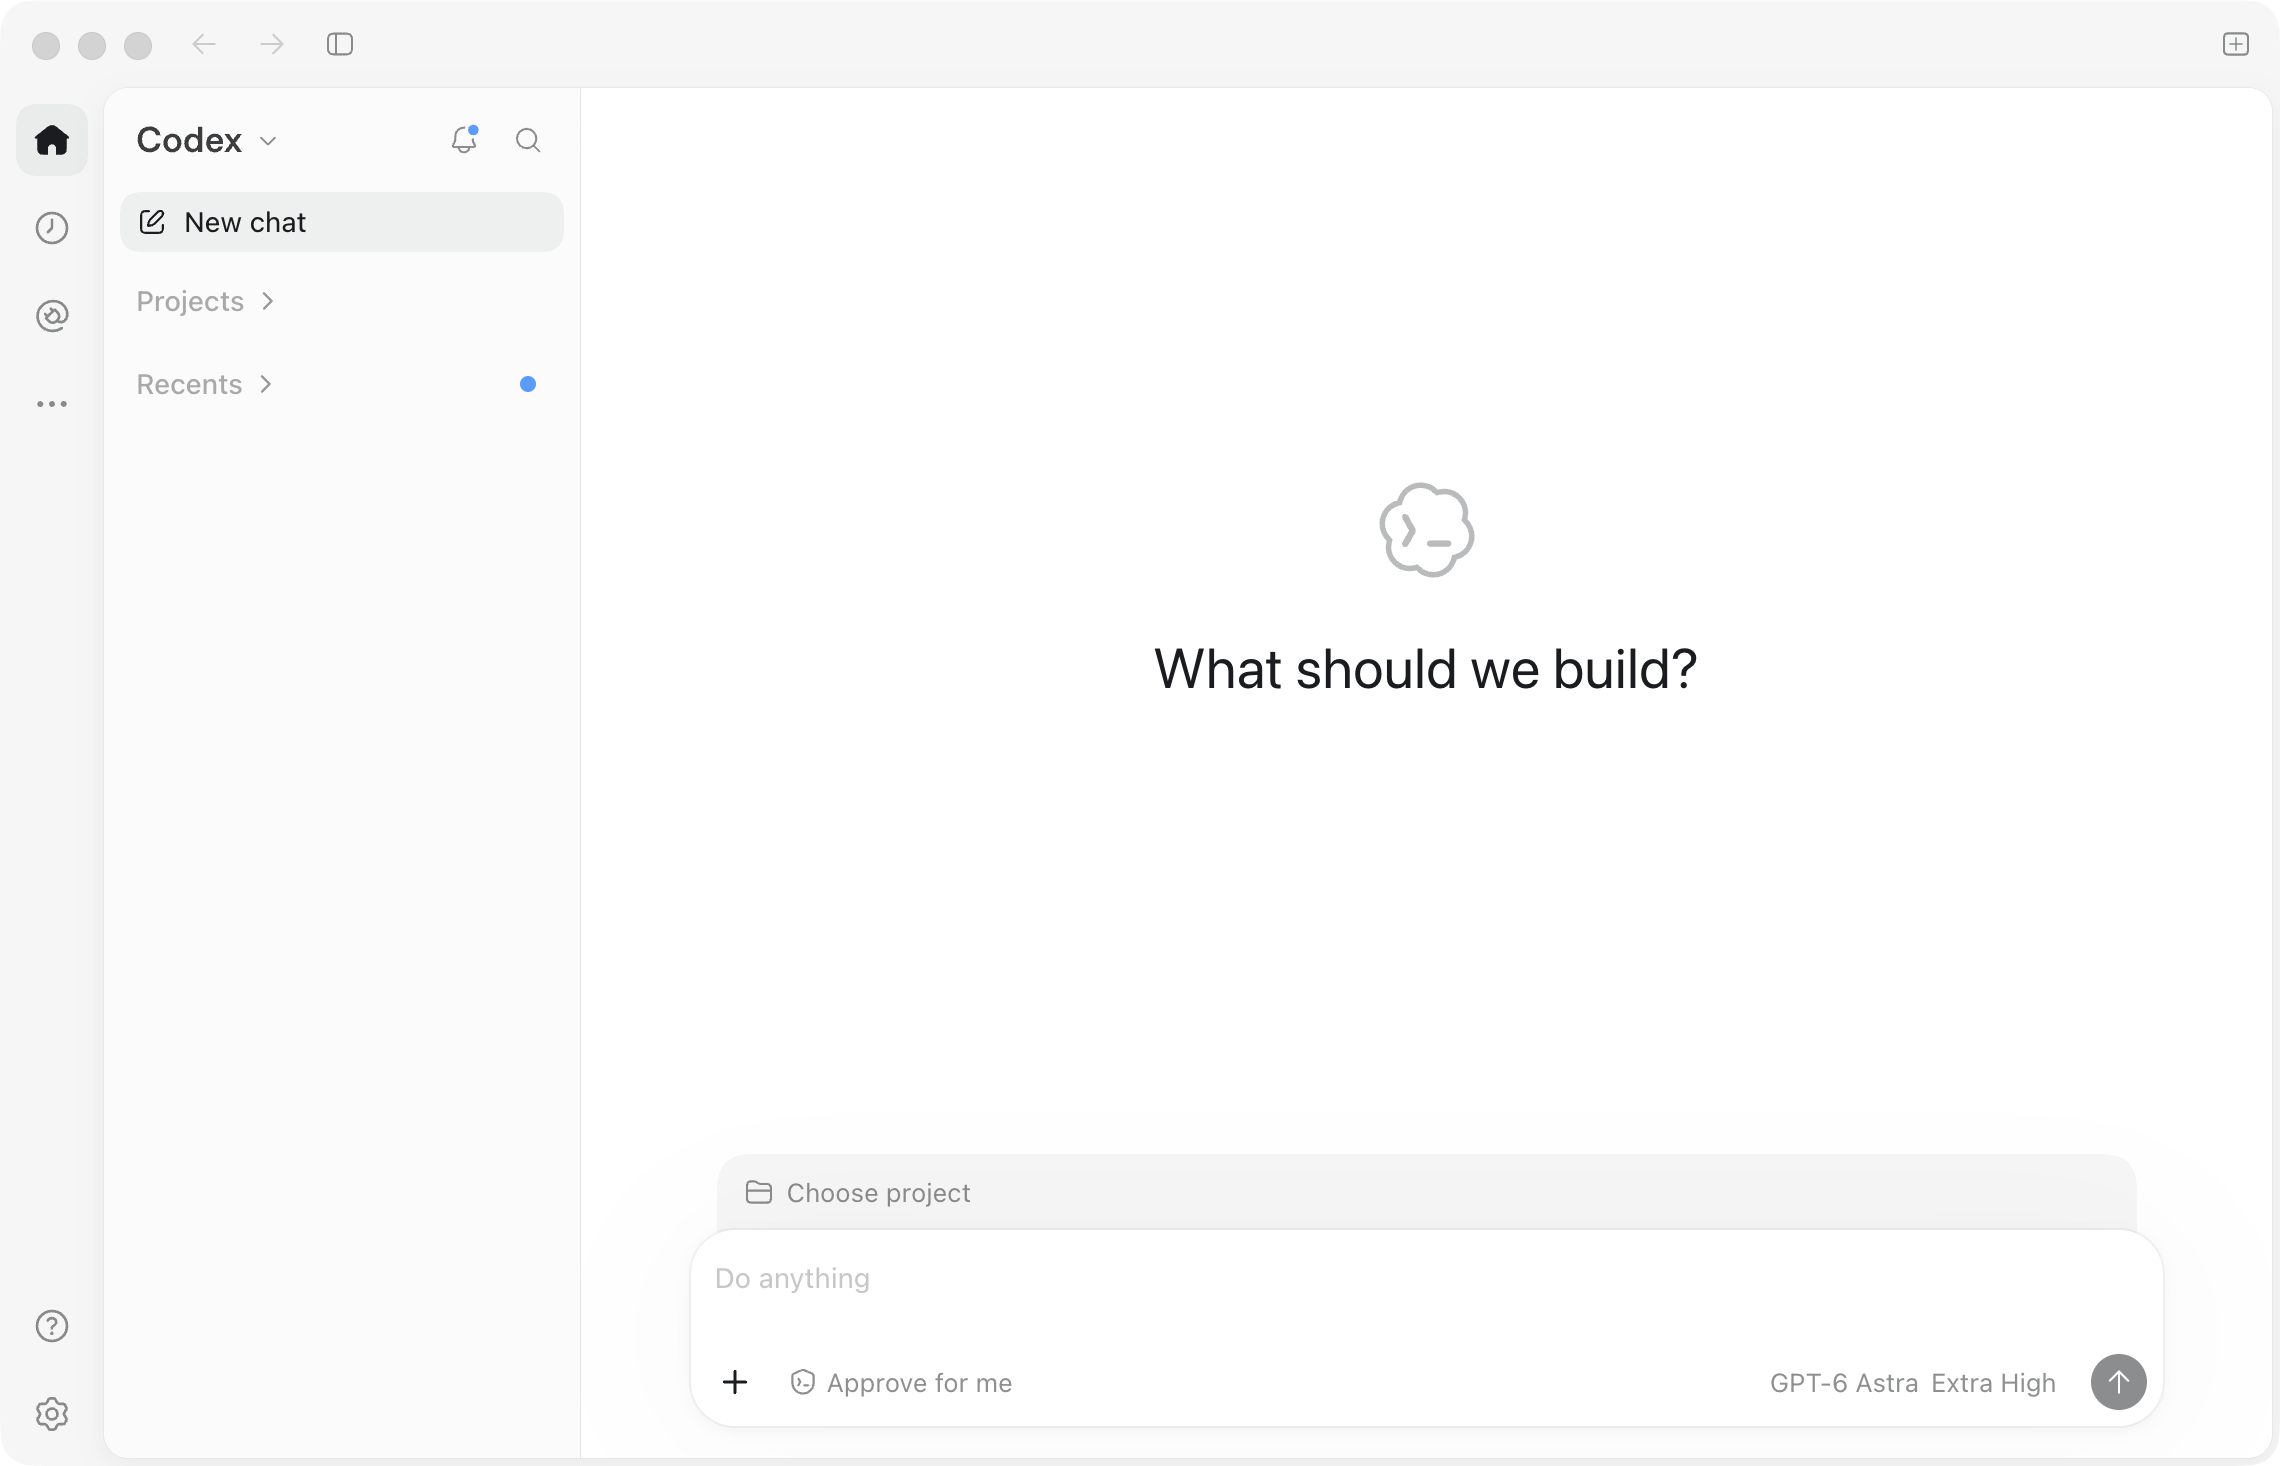
Figure 2 : L'application de bureau ChatGPT exécutant GPT-6 Astra sur Amazon Bedrock
Sécurité et autorisations
Amazon Bedrock offre une gamme de contrôles sur l'inférence. Deux d'entre eux importent ici. Les politiques AWS Identity and Access Management (IAM) contrôlent quels rôles peuvent invoquer quels profils, et les politiques de contrôle de service (SCP) appliquent des contrôles à l'échelle de l'organisation, y compris la portée régionale. Cette section couvre les deux, ainsi que l'endroit où les données des requêtes atterrissent.
Autorisations IAM pour l'inférence inter-Régions globale
Pour appeler l'un de ces modèles via un profil d'inférence inter-Régions global, votre politique IAM a besoin de quatre déclarations :
- L'accès au profil d'inférence et à la ressource projet/défaut dans votre Région source.
- L'accès au modèle de fondation dans votre Région source, délimité au profil d'inférence.
- L'Amazon Resource Name (ARN) indépendant de la Région pour le modèle de fondation,
arn:aws:bedrock:::foundation-model/openai.gpt-6-sol, avecaws:RequestedRegiondéfini surunspecifiedpour autoriser le routage inter-Régions. bedrock:CallWithBearerTokenpour l'authentification par clé d'API.
Cette politique IAM accorde la permission d'invoquer GPT-6 Sol via l'inférence inter-Régions globale à partir de ap-southeast-1. Remplacez par votre identifiant de compte AWS et ap-southeast-1 par votre Région source.
{
  "Version": "2012-10-17",
  "Statement": [
    {
      "Sid": "GrantGlobalCrisProfileAndProjectAccess",
      "Effect": "Allow",
      "Action": ["bedrock:InvokeModel"],
      "Resource": [
        "arn:aws:bedrock:ap-southeast-1:<ACCOUNT>:inference-profile/global.openai.gpt-6-sol",
        "arn:aws:bedrock:ap-southeast-1:<ACCOUNT>:project/default"
      ],
      "Condition": {
        "StringEquals": { "aws:RequestedRegion": "ap-southeast-1" }
      }
    },
    {
      "Sid": "GrantGlobalCrisInRegionModelAccess",
      "Effect": "Allow",
      "Action": ["bedrock:InvokeModel"],
      "Resource": ["arn:aws:bedrock:ap-southeast-1::foundation-model/openai.gpt-6-sol"],
      "Condition": {
        "StringEquals": {
          "aws:RequestedRegion": "ap-southeast-1",
          "bedrock:InferenceProfileArn": "arn:aws:bedrock:ap-southeast-1:<ACCOUNT>:inference-profile/global.openai.gpt-6-sol"
        }
      }
    },
    {
      "Sid": "GrantGlobalCrisGlobalModelAccess",
      "Effect": "Allow",
      "Action": ["bedrock:InvokeModel"],
      "Resource": ["arn:aws:bedrock:::foundation-model/openai.gpt-6-sol"],
      "Condition": {
        "StringEquals": {
          "aws:RequestedRegion": "unspecified",
          "bedrock:InferenceProfileArn": "arn:aws:bedrock:ap-southeast-1:<ACCOUNT>:inference-profile/global.openai.gpt-6-sol"
        }
      }
    },
    {
      "Sid": "AllowBearerTokenAuth",
      "Effect": "Allow",
      "Action": ["bedrock:CallWithBearerToken"],
      "Resource": "*"
    }
  ]
}
Si vous utilisez le streaming (converse_stream ou stream=True), ajoutez bedrock:InvokeModelWithResponseStream à l'Action dans les trois premières déclarations. Converse autorise en tant que bedrock:InvokeModel. Si vous n'appelez Converse qu'avec des identifiants SigV4, supprimez la quatrième déclaration.
Pour changer de modèle, remplacez openai.gpt-6-sol par openai.gpt-6-luna ou openai.gpt-6-astra partout. Pour la référence complète, consultez Exigences de politique IAM pour l'inférence globale inter-Régions.
Considérations relatives aux politiques de contrôle de service pour l'inférence globale inter-Régions
Une requête d'inférence globale inter-Régions ne contient aucun nom de Région. Amazon Bedrock définit aws:RequestedRegion sur unspecified, de sorte qu'une liste blanche de Régions dans une SCP refuse l'appel, et l'erreur ne mentionne que le type de politique, pas laquelle. C'est une raison fréquente d'échec du premier appel dans un compte d'entreprise.
Plutôt que d'élargir la liste d'autorisation, délimitez l'exception. Amazon Bedrock renseigne la bedrock:InferenceProfileArn clé de condition lors de l'autorisation, de sorte qu'une SCP peut autoriser ces profils tout en conservant les contrôles de Région pour tout le reste. La SCP suivante fait cela.
{
  "Version": "2012-10-17",
  "Statement": [
    {
      "Sid": "DenyOutsideApprovedRegionsExceptBedrockInvoke",
      "Effect": "Deny",
      "NotAction": [
        "iam:*", "sts:*", "organizations:*", "account:*",
        "route53:*", "cloudfront:*", "waf:*", "wafv2:*", "shield:*",
        "support:*", "trustedadvisor:*", "health:*",
        "budgets:*", "ce:*", "cur:*", "tax:*", "billing:*",
        "bedrock:Invoke*"
      ],
      "Resource": "*",
      "Condition": {
        "StringNotEquals": { "aws:RequestedRegion": ["ap-southeast-1"] }
      }
    },
    {
      "Sid": "DenyBedrockInferenceOutsideApprovedRegionsUnlessCris",
      "Effect": "Deny",
      "Action": ["bedrock:Invoke*"],
      "Resource": "*",
      "Condition": {
        "StringNotEquals": { "aws:RequestedRegion": ["ap-southeast-1"] },
        "ArnNotLike": {
          "bedrock:InferenceProfileArn": [
            "arn:aws:bedrock:*:*:inference-profile/global.*"
          ]
        }
      }
    }
  ]
}
La première déclaration applique votre liste de Régions autorisées à tous les services, à l'exception de l'inférence Amazon Bedrock. La deuxième refuse cette inférence en dehors de ces Régions, sauf si elle passe par un profil d'inférence multi-Région global. Pour les profils géographiques, ajoutez leur préfixe (par exemple inference-profile/us.*) à la ArnNotLike liste, car les requêtes géographiques comportent un véritable nom de Région. Conservez votre Région source dans la liste d'autorisation et ajoutez à NotAction.
Une alternative plus brutale consiste à ajouter unspecified à votre liste d'autorisation existante, ce qui fonctionne mais ouvre la même exception à tous les autres services. Pour un fichier de politique prêt à l'emploi, consultez le dépôt aws-samples service-control-policy-examples.
Conservation des données et détection des abus
Pour la détection automatisée des abus hors ligne, le trafic signalé par le classificateur est conservé par AWS pendant 30 jours au maximum et traité de manière programmatique. Avec l'inférence multi-Région, cette conservation s'effectue dans la Région de destination, qui, pour un profil global, correspond à toute Région AWS commerciale prise en charge où le modèle est déployé. Les clients éligibles peuvent demander une conservation complète des données nulle (zero data retention) via leur équipe de compte AWS. Pour plus d'informations, consultez Détection des abus dans Amazon Bedrock et Conservation des données.
Si votre organisation a des exigences de résidence des données, abordez ce sujet tôt avec votre équipe risque et conformité. Consultez les pages pays du AWS Financial Services Compliance Center pour ces cinq pays. Nous vous recommandons d'obtenir votre propre conseil concernant la conformité aux exigences applicables à votre activité.
Gestion des quotas
Les quotas GPT-6 sur bedrock-runtime sont mesurés en tokens par minute (TPM), suivis par rapport à la Région source depuis laquelle vous appelez. Les tokens d'entrée et d'écriture en cache comptent 1:1, et chaque token de sortie consomme 10 tokens de quota. Par exemple, une requête avec 2,000 tokens d'entrée et 1,000 tokens de sortie épuise 12,000 tokens de votre quota.
Amazon Bedrock réserve l'intégralité du max_tokens à l'avance, définissez-le donc proche des complétions que vous attendez. Un seul quota couvre InvokeModel, Converse, Responses et Chat Completions. Consultez-le et augmentez-le depuis la console Service Quotas depuis votre Région source. Avant la production, demandez des augmentations tôt et déclenchez des alarmes sur EstimatedTPMQuotaUsage dans le AWS/Bedrock namespace à 70–80 pour cent de votre allocation. Consultez Comment les tokens sont comptés dans Amazon Bedrock et Amazon Bedrock endpoints and quotas pour les valeurs actuelles.
Surveillance et journalisation
Votre surface opérationnelle reste dans votre Région source. Les métriques Amazon CloudWatch, les événements AWS CloudTrail, les journaux d’invocation de modèle, la comptabilisation des quotas et la facturation restent tous dans la Région depuis laquelle vous avez appelé. Vous payez les tarifs de cette Région, et non ceux de la Région de traitement.
CloudTrail enregistre où chaque requête a été traitée. AWS documente les destinations d’un profil d’inférence multi-Régions global comme étant ses Régions commerciales plutôt que de les énumérer. GetInferenceProfile renvoie les ARN de modèle agnostiques de Région et de la Région source plutôt qu’une liste de destinations. Votre enregistrement par requête est additionalEventData.inferenceRegion dans CloudTrail dans votre Région source. L’inférence sur ce point de terminaison est un événement de gestion, consigné par défaut sans coût supplémentaire. L’historique des événements CloudTrail conserve 90 jours, donc des horizons plus longs nécessitent une piste (trail) ou la journalisation des invocations de modèle. Récupérez les événements CloudTrail avec cette commande.
aws cloudtrail lookup-events \
  --region ap-southeast-1 \
  --lookup-attributes AttributeKey=EventSource,AttributeValue=bedrock.amazonaws.com \
  --start-time <START> \
  --end-time <END> \
  --max-results 1 \
  --query 'Events[0].CloudTrailEvent' --output text | python3 -m json.tool
Définissez la fenêtre autour d’un appel que vous venez de faire, car la livraison CloudTrail a un retard de quelques minutes. Si l’événement le plus récent était un appel échoué, il comporte un errorCode et pas de inferenceRegion. Augmentez --max-results et choisissez un événement sans errorCode.
{
  "eventName": "Converse",
  "eventSource": "bedrock.amazonaws.com",
  "awsRegion": "ap-southeast-1",
  "managementEvent": true,
  "requestParameters": {
    "modelId": "global.openai.gpt-6-sol",
    "inferenceConfig": { "maxTokens": 1024 }
  },
  "additionalEventData": {
    "inferenceRegion": "us-east-1"
  }
}
Les métriques et l’utilisation des agents de codage restent dans CloudWatch. Là où les développeurs accèdent à GPT-6 via un agent de codage, CloudWatch Coding Agent Insights ajoute des tableaux de bord prêts à l’emploi sous GenAI Observability qui décomposent l’utilisation de jetons par utilisateur, équipe et centre de coûts. Les agents émettent nativement des métriques OpenTelemetry. Pour Codex, consultez Set up OpenTelemetry for OpenAI Codex.
Nettoyage
Cet article ajoute une politique IAM et, éventuellement, une entrée SCP ainsi qu'une destination de journalisation. Détachez ou supprimez la politique IAM que vous avez attachée, et annulez l'entrée SCP si vous en avez ajouté une. Supprimez la destination de journalisation des invocations de modèle dans Amazon Simple Storage Service (Amazon S3) ou Amazon CloudWatch Logs si vous en avez créé une, afin d'éviter des frais de stockage. Les profils d'inférence inter-Régions globaux sont définis par le système, il n'y a donc rien à supprimer.
Conclusion
Cet article a montré comment invoquer GPT-6 Sol et GPT-6 Luna depuis cinq Régions sources d'Asie-Pacifique, et GPT-6 Astra depuis Asie-Pacifique (Singapour), via l'inférence inter-Régions globale sur bedrock-runtime. Passez un ID de profil d'inférence inter-Régions globale comme paramètre model , et configurez la politique IAM et l'exception SCP décrites dans cet article. Le même point de terminaison sert les API compatibles OpenAI, de sorte qu'une intégration OpenAI existante peut être migrée en changeant une URL de base et une clé.
Pour commencer, attachez la politique IAM de cet article et envoyez une première requête via global.openai.gpt-6-sol. Dimensionnez votre quota de jetons par minute selon le taux d'épuisement 10x, et vérifiez dans CloudTrail que additionalEventData.inferenceRegion apparaît sur vos appels.
Pour plus d'informations, consultez le Guide de l'utilisateur Amazon Bedrock, Router les requêtes d'inférence de modèle entre les Régions AWS avec l'inférence inter-Régions, et Tarification d'Amazon Bedrock.