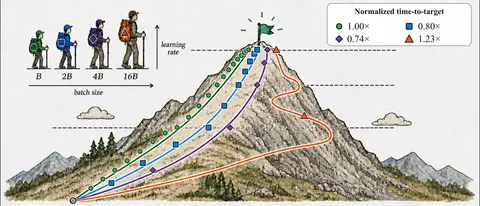
Un batch plus grand permet à chaque mise à jour de traiter davantage de séquences, exploitant ainsi davantage de ressources de calcul parallèle ; mais à budget d'échantillons fixe, le nombre de mises à jour disponibles pour le modèle diminue également. Dans l'apprentissage par renforcement, quand l'augmentation du batch permet-elle réellement de réduire le temps effectif nécessaire pour atteindre la performance cible ? Pour les grands modèles de langage, il faut aussi prendre en compte le fait que les trajectoires d'entraînement doivent être générées en ligne, et que la génération et l'entraînement n'ont pas les mêmes besoins en ressources de calcul. Nous établissons un cadre d'analyse reliant le nombre d'échantillons nécessaires pour atteindre la cible au débit de bout en bout : seul un gain de débit supérieur au coût supplémentaire en échantillons permet à un batch plus grand d'accélérer l'entraînement. Cela fournit également un ordre de réglage pratique : trouver d'abord la plage dans laquelle l'effet d'apprentissage reste approximativement inchangé malgré les variations de batch size, puis optimiser le débit dans cette plage. Les expériences avec GRPO et PPO montrent qu'après un réajustement du taux d'apprentissage, les courbes d'apprentissage de différents batchs s'alignent globalement, dans une certaine plage, lorsqu'on les compare en nombre cumulé d'échantillons. Sur un matériel fixe, l'augmentation du batch augmente le débit de génération jusqu'à 2,29 fois ; la meilleure configuration GRPO que nous ayons mesurée réduit de 29 % le temps nécessaire pour atteindre le même objectif de validation, sans GPU supplémentaire.