
一見
- ハーネスド・エージェントリアル:Microsoft Research Asiaは、展開時に使用される同じエージェントハーネスが直接強化学習に参加するトレーニングパラダイムを導入し、トレーニングフレームワーク内でエージェントを再実装する必要がなくなりました。
- 設計上の軽量性:Agent Lightning v1.0は、約3,500行のコードで完全なエージェントRL制御プランを提供します。
- ネイティブKubernetesサポート:エージェントは、自己管理クラスター、クラウドKubernetes、またはローカルインフラ上で標準的なKubernetesジョブとして実行され、有料の商業サンドボックスサービスへの依存はありません。
- データ効率性の高いトレーニング手法:エンドツーエンドのコーディングエージェントパイプラインにより、SWE-bench Verified上でQwen3.5-9BのPass@1スコアが41.8%から56.4%に向上し、オープンソースデータセットを基に約6,000のトレーニングサンプルのみを使用して、14.6ポイントの改善が達成された。
AIエージェントは、単一のモデルから、モデル、ツール、実行環境で構成される複雑なフルスタックシステムへと進化してきました。その機能は、モデルの外側からそれらを調整するエージェントハーネスにますます依存しています。強化学習(RL)とは、AIシステムが試行錯誤を通じて学習し、その行動に対する報酬や罰によって導かれる手法です。 RLはそれらのエージェントをより良くすることができるが、ほとんどのエージェントRLシステムでは開発者がトレーニングフレームワーク内でエージェントを再実装する必要がある。これは費用がかかり、またトレーニングされたエージェントが実際に展開されるエージェントとは完全に同じではないことを意味する。
これに対処するため、Microsoft Research Asiaの研究者たちは「Harnessed Agentic RLトレーニングパラダイム」を導入し、完全に再構築されたAgent Lightning v1.0(新タブで開く)をオープンソースとして公開しました。元のAgent Lightning v1.0と比べて、Agent Lightning v1.0は軽量性の維持、実際のハーネスとの統合、そして完全で再現可能なエージェントRLトレーニングパイプラインに重点を置いています。
Agent Lightning v1.0はHarnessed Agentic RLを基盤として再構築され、以下の重要な改善が行われました:
- 軽量さ:全体のフレームワークは約3,500行のコードです。Agent Lightning v1.0は、理解しやすく、修正し、拡張可能な十分に小さく明確なコードベースで、完全なHarnessed Agentic RLシステムを実装しています。
- 実際のエージェントハーネスでのトレーニング:Agent Lightning v1.0における大規模言語モデル(LLM)プロキシを通じてエージェントがモデルに到達し、既存のハーネスコードは変更されません。
- ネイティブKubernetesサポート: エージェントは外部の商業用サンドボックスサービスを使用せず、直接Kubernetesジョブとして実行されます。自己管理クラスターやローカルインフラも、大規模な展開をサポートできます。
- 完全なコーディングエージェントトレーニング例:Qwen3.5-9Bを基に構築されたエンドツーエンドのパイプラインにより、SWE-bench VerifiedでのPass@1スコアは41.8%から56.4%へ向上し、絶対値で14.6ポイントの改善が見られました。これは約6,000個のトレーニングサンプルを使用しただけです。
伝統的なエージェント型RLの制限
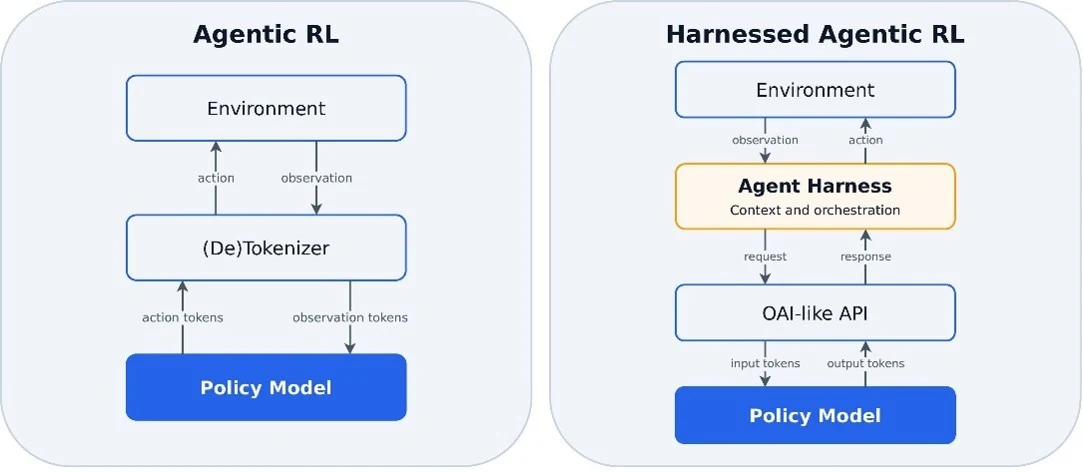
伝統的なエージェント型RLでは、トレーニングフレームワークが環境との相互作用ループを管理するものとされる。ReActスタイルのループでは、モデルがアクションを生成し、環境が観測値を返す。この観測値はコンテキストに追加され、モデルが次のアクションを生成するため、全体のプロセスが一つの連続したトークン軌道にマップされる。verl、AReaL、slimeといった初期のRLシステムもこの方法で構築されており、つまりエージェントのトレーニングを行うには、RLフレームワーク内でそのループを再構築する必要があった。
実際のハーネスはその仮定を超えてしまった。mini-SWE-agent、OpenHands、OpenCode、Claude Code、Codexといったコーディングエージェントはそれぞれ独自のコンテキスト管理、ツールプロトコル、実行ロジック、依存関係を持っている。汎用エージェントシステムも同様である。訓練のために再構築するのは費用がかかり、再構築されたエージェントは既存のエージェントと同じように動作しなくなる可能性がある。
エージェント・ライトニングは別の方法を採用する。エージェントとモデルの中間にLLMプロキシを配置する。エージェントは以前と同じように動作し続ける:以前にモデルAPIを呼び出したエンドポイントをエージェント・ライトニングに向けるだけで、トレーニングフレームワークはそのモデルの呼び出しを観察し記録することができる。 v1.0では、研究者たちはさらに一歩進んで、このパラダイムを「ハーネスド・エージェントルール」と正式に定義する。展開時に使用されるどのエージェントも、トレーニング中の強化学習に直接参加するハーネスとなる(図1)。
実際のハーネスを使ったトレーニングにおける4つの課題
ハーネスド・エージェンティックRLと伝統的なエージェンティックRLの核心的な違いは、環境との相互作用ループがトレーニングフレームワークではなく、エージェントハーネスによって処理される点です。トレーニングシステムは、一連のLLMのリクエストと応答ペアのみを観察することができるため、単一のロールアウトが多様な数のトレーニングサンプルに分割されることがあります。これにより、4つの重要な課題が生じます:
- 再トークン化とサンプル統合: ハーネスではコンテキストをテキストとして保持しますが、RLトレーニングにはロールアウト中にサンプリングされたトークンIDが必要です。チャットテンプレートとトークナイザーを再び通すことでトークンの境界が変わるため、隣接する呼び出しを一つのサンプルに統合することはできません。
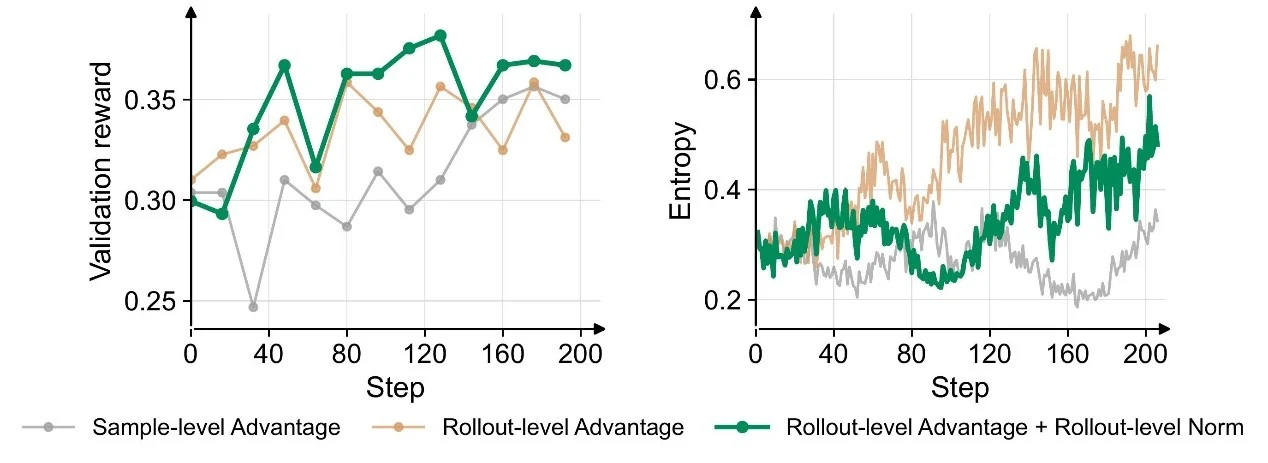
- 利点計算:再トークン化、サブエージェント、コンテキストの要約により、1回のロールアウトを複数のサンプルに分割することができます。サンプルレベルで直接ベースラインと利点を計算すると、より多くのサンプルを生成するロールアウトが繰り返し数えられ、ロールアウトレベルの元の統計的関係が変化します。
- 損失正規化:サンプル数による損失の平均値を計算することで、より多くのサンプルを生成するローリングアウトに重みが与えられます。サンプル数は通常、ハーネス動作の産物に過ぎないため、損失正規化ではその影響を避ける必要があります。
- バックエンドスケジューリングのトレーニング:サンプル数と長さはハーネスが終了した後にのみわかるが、GPUの数やデータ/テンソルの並列構成は通常固定されている。バックエンドは変動するワークロードを固定されたリソースにマッピングしなければならない。
スポットライト:Microsoft研究ニュースレター
マイクロソフト・リサーチニュースレター
今日から購読する3,500行のコードで完全なエージェントRL制御プランを構築する
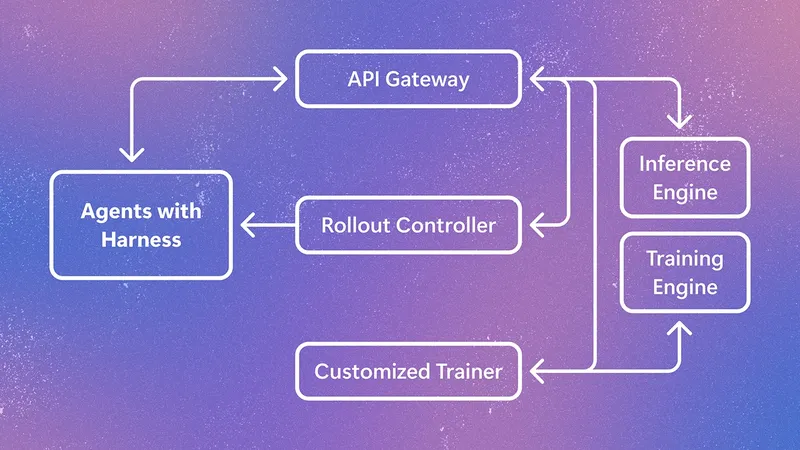
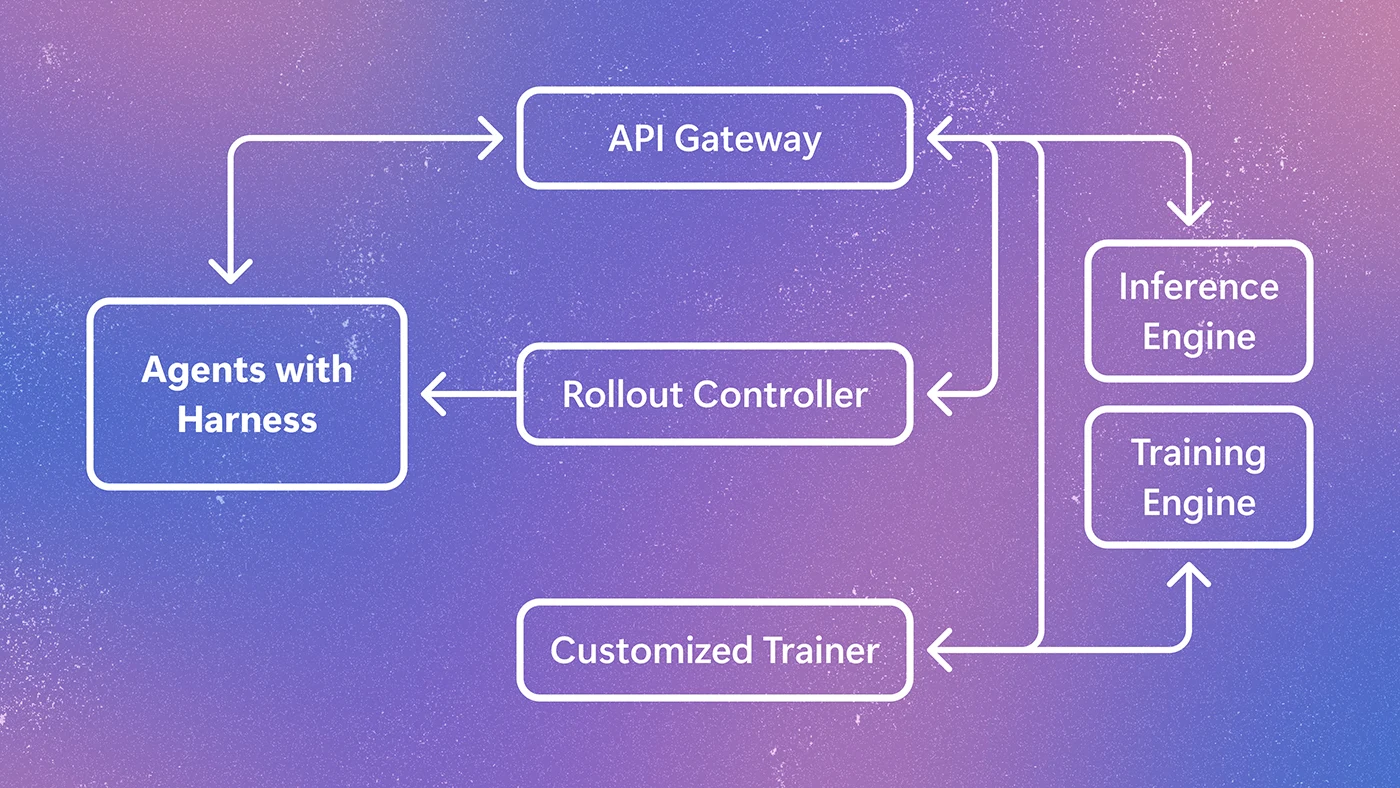
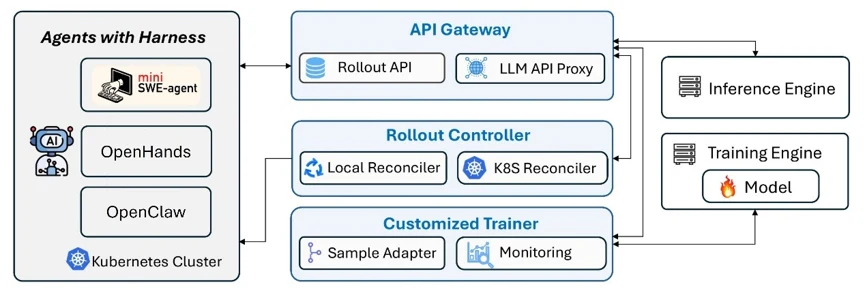
システム設計において、Agent Lightning v1.0はシンプルさを第一の原則とします。全体のフレームワークは約3,500行のコードで構成され、API Gateway、Rollout Controller、Customized Trainerの3つの核心コンポーネントから成ります(図2)。
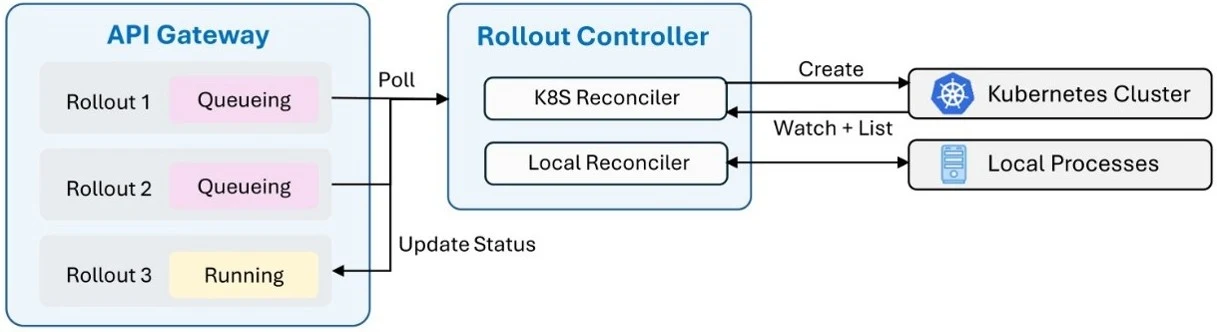
APIゲートウェイはローリング、モデル、イベントを保存し、OpenAI互換のLLMプロキシとして機能します。ハーネスからの各モデル呼び出しをローリングに結びつけ、トレーニングに必要なプロンプト、応答、およびログ確率を記録します。ローリングコントローラーは、エージェント実行をローカルプロセスまたは標準Kubernetesジョブとして開始・管理し、エージェント実行をトレーナーとは別に保ちます。 Verlを基に構築されたカスタマイズされたトレーナーは、ローリングの実行を開始し、それが完了するのを待ち、サンプルを収集し、サンプルアダプターを通じて最終的なトレーニングサンプルを組み立てる。その結果、既存のエージェントハーネスに対しては、モデルのエンドポイントをエージェントライトニングプロキシに向けるだけで、RLトレーニングに迅速に接続できることが一般的である。
コロケート同期RL
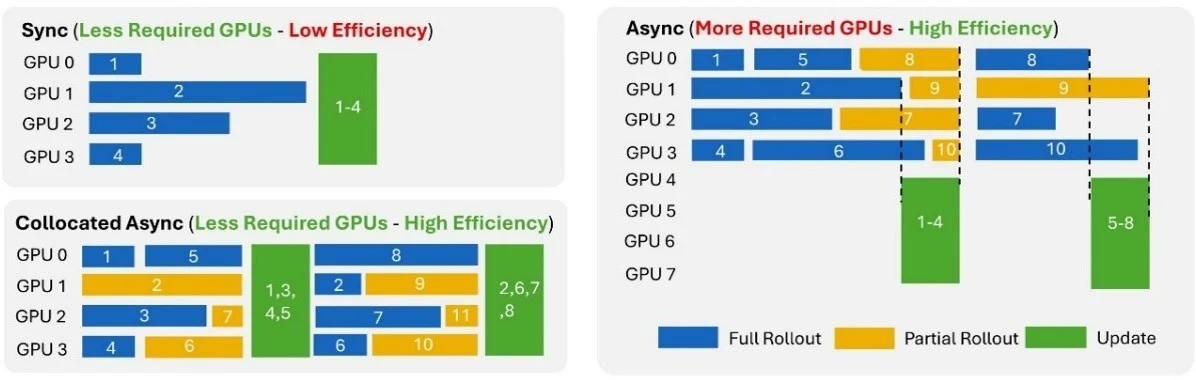
エージェントごとに実行時間は大きく異なります。同時性RLでは、バッチ内で最も遅いエージェントを待ってGPUを使用しない状態にしますが、完全非同期RLでは利用率は向上しますが、実行とトレーニングのために別々のGPUプールが必要です。これに対応して、Agent Lightning v1.0ではCollocated Async RLが導入され、実行とモデル更新が同じGPUセットを共有できるようになりました。
システムが十分な数のローディングを収集した後、アップデートが開始されます。API Gatewayは新しいリクエストの受け付けを停止し、既に進行中のリクエストが完了するのを待ちます。アップデートが完了した後にローディングが再開されます。全体の状態遷移は外部エージェントハーネスには透明です。実験において、この方法は同期RLよりも約2倍のエンドツーエンドの速度向上を達成し、従来の非同期RLよりも少ないGPUを使用できました(図3)。
Kubernetes上でのエージェントの実行
十分な数のエージェントを実行するには、一度に多くのエージェントを動かす必要があり、これは大量のCPU、メモリ、計算リソースを消費します。他のHarnessed Agentic RLフレームワークでは、Modal SandboxやE2Bなどの商業的なサンドボックスサービス上でそれらのエージェントをホストしていますが、規模が大きくなるとコストが急激に上昇します。一方、Agent Lightning v1.0では、既存の自己管理クラスター、クラウドKubernetes、またはローカルインフラを再利用することで、標準的なKubernetesジョブとしてそれらを実行します(図4)。 既存のコンピュータリソースをより効率的に利用でき、大規模な展開コストが低くなり、全体のパイプラインがオープンソースであり再現可能である。
6,000の訓練サンプル、14.6ポイントの性能向上
このアプローチをテストするために、研究者たちはSWE-smith、mini-SWE-agent、Qwen3.5-9Bを用いて完全なパイプラインを構築した。データクリーニング、環境の構築、報酬ハッキングの保護措置、そしてRLトレーニングを含む。トレーニングセットは約6,000個のサンプルを含み、大規模な計算は不要である。RLトレーニングだけで、SWE-bench VerifiedでのQwen3.5-9Bの成功率は41.8%から56.4%に上昇し、14.6ポイントの向上があった。
コーディングエージェントの実験により、2つの課題、すなわち優位性計算と損失の正規化についての以前の分析がさらに確認された。サンプルレベルの処理と比較して、展開レベルの優位性と展開レベルの正規化により、より高い検証報酬が得られ、訓練中にポリシーエントロピーがより安定した状態を保つ(図5)。
Agent Lightning v1.0:実際のハーネスを持つエージェントを訓練するための3,500行の軽量エージェンタルRLフレームワークという記事が、Microsoft Researchに初めて掲載されました。