
主なポイント
- スキルにツールをバインドできるようになりました。 ツールのスキーマは、エージェントがそのバインド先のスキルを読み込むまでコンテキストから除外され、会話の途中で新しいツールを受け入れられるモデルでは、追加してもプロンプトキャッシュが維持されます。
- アプリは実行時にスキルをピン留めできます。これにより、最初のモデル呼び出しの前に指示がコンテキストに入り、
read_fileラウンドトリップが不要になります。 - スレッドの途中でスキルを再読み込みできます。これにより、長時間実行されるエージェントが、新しいスレッドを開始することなく、追加・編集・削除されたスキルを取り込めます。
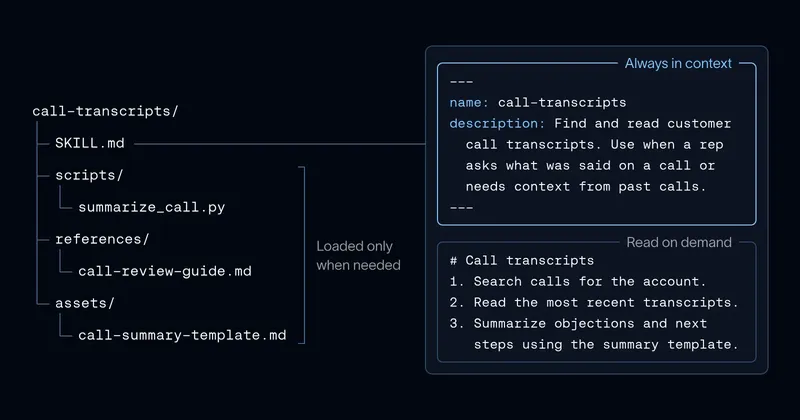
スキルは、エージェントにドメイン知識を与える最良の方法のひとつです。 スキル とは、指示、スクリプト、参照ファイルをまとめたフォルダーで、顧客との打ち合わせの準備や、営業チームと同じ方法での通話トランスクリプトのレビューなど、エージェントにタスクのやり方を教えます。Agent Skills は任意のモデルで動作する オープンスタンダード で、 数十のエージェント製品でサポートされています。また、スキルの作成に技術力は必要ありません。その核心はマークダウンファイルだからです。
スキルが機能するのは、 プログレッシブディスクロージャー(段階的開示)のおかげです。エージェントは最初は各スキルの名前と説明だけを見て、タスクで必要になったときにのみ完全な指示を読み込みます。これによりコンテキストが小さく保たれ、 コンテキストエンジニアリング は効果的なエージェントを構築する鍵となります。
利用が拡大するにつれ、チームがスキルに求めるものは変化しています。企業のスキルレジストリは数千のスキルに成長し、チームやエージェント間で共有されるようになっています。私たちは、よくある要望に応えるために、 Deep Agents のスキルサポート を刷新しました:
- スキルへのツールのバインド: スキルにバインドされたツールは、エージェントがそのスキルを読み込んだときにのみロードされます。
- ピン留めされたスキル: ユーザーがスキルを明示的に要求した場合、たとえば
/meeting-prepの場合、アプリは次のモデル呼び出しの前にそのスキルをロードできます。 - スキルの再読み込み: 長時間実行されるスレッドでも、最初からやり直すことなく、新規または変更されたスキルを取り込めます。
スキルの仕組み
スキルは、次の内容を含むディレクトリです: SKILL.md file: YAMLフロントマター with a name および descriptionに続いて、エージェントが従う指示が記述されます。スキルはまた、補助ファイルを以下のパスにまとめてバンドルすることもできます scripts/, references/、また assets/ (仕様).
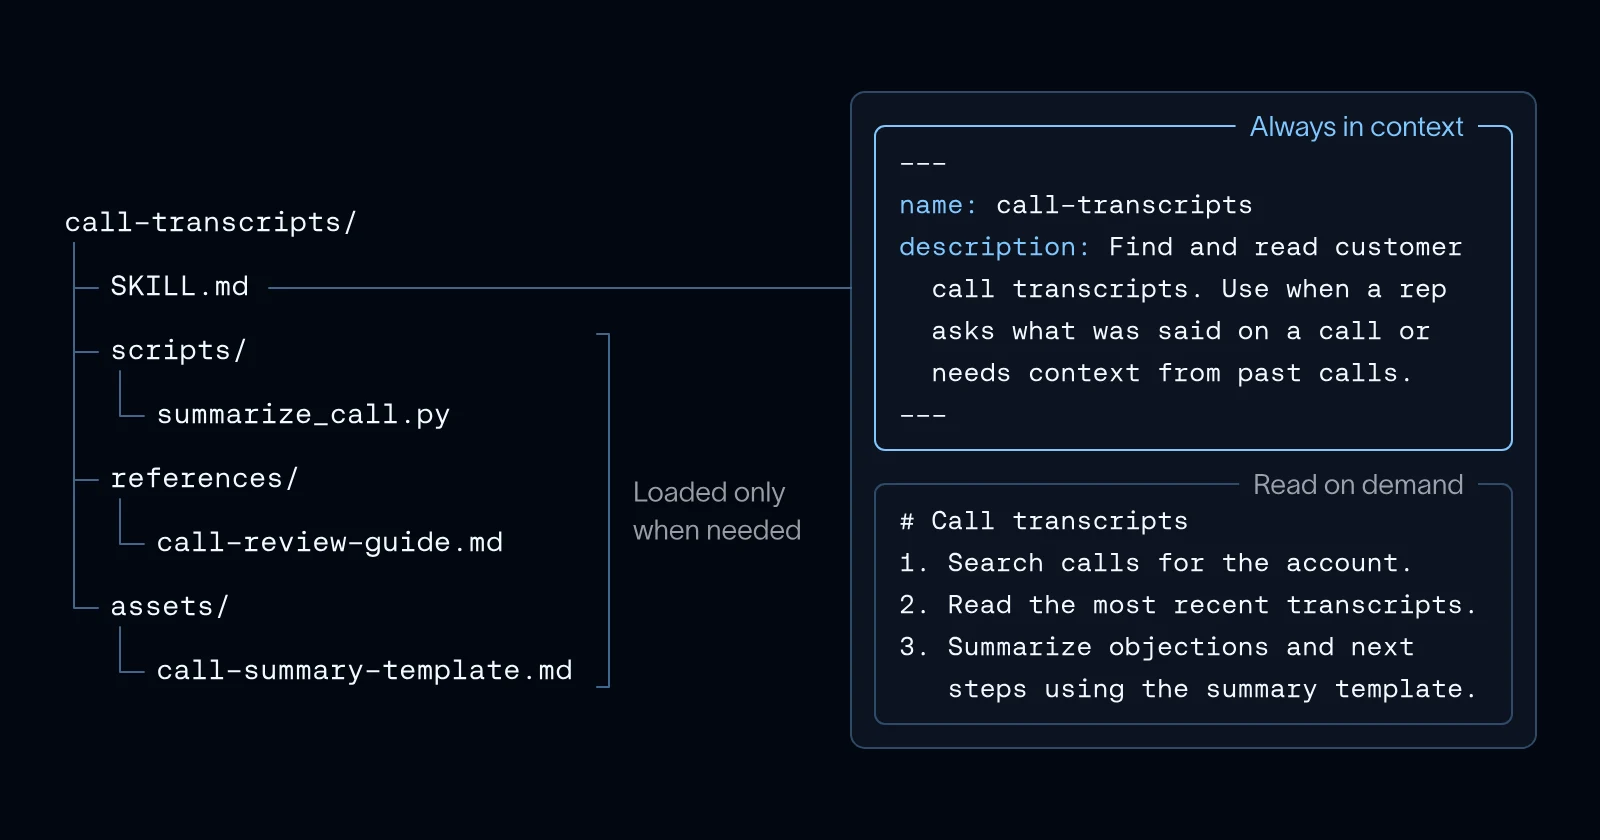
この記事全体を通して、次のものを使用します 当社のGTMエージェント 実行例として使用します。これは〜の上に構築されています Deep Agents, さらに50以上のスキルを備えたライブラリは、営業担当者の繰り返し行う業務をカバーしています。例えば meeting-prep, call-transcripts、また competitive-intel-card.
- ディスカバリー。 起動時に、エージェントは各スキルの以下を確認します。
nameおよびdescription「システムプロンプト内に。」 - アクティベーション。 タスクがスキルに一致すると、エージェントは完全な
SKILL.mdとともにread_file. - 実行。 エージェントは指示に従い、スクリプトや参照ファイルを必要とされる場合にのみ読み込みます。
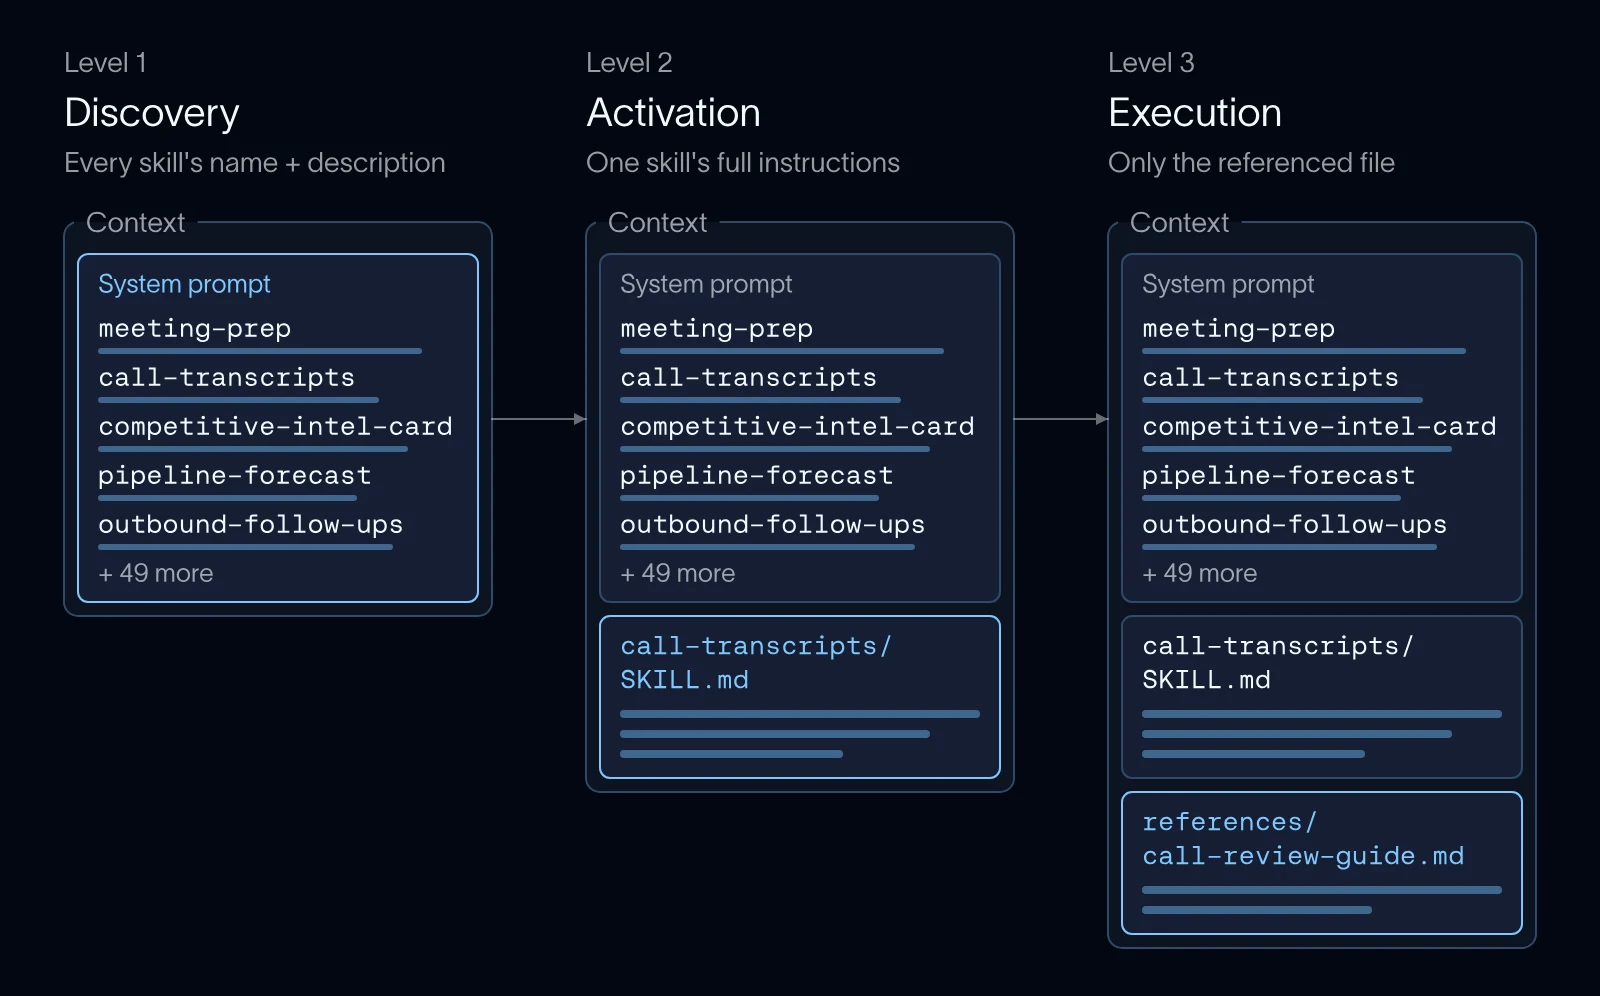
スキルは使用されるまでシステムプロンプト内で1行しか占めないため、ライブラリはコンテキストを圧迫することなく、膨大な数のスキルへの参照を保持できます。それでは、Deep Agents で行った拡張機能を見ていきましょう。
スキルへのツールのバインド
スキルはエージェントに特定のツールの使い方を指示することが多く、一部のツールはエージェントがその説明を読んで初めて正しく機能します。これまで、スキルとツールは別々に開示されていました。ツールのスキーマをコンテキストから外しておくには ツール検索しかし、ツールと、そのツールを説明するスキルを結び付ける仕組みは何もありませんでした。エージェントはスキルを読まずにツールを見つけて呼び出すことができ、逆にスキルを読んでも、対応するツールを探さなければならないという状態でした。
今すぐできるようになりました スキルにツールをバインドするそのため、スキルとそのツールは一緒に公開されます。バインドされたツールは、エージェントがそのスキルを読むまでコンテキストに追加されず、それより前に呼び出そうとすると不明なツールとして失敗します。これによりコンテキストが薄く保たれ、エージェントはツールを呼び出せるようになる前にその使い方を読んでいることになります。弊社の GTMエージェント, call-transcripts 通話の検索方法と文字起こしの読み方を説明しているので、それらのツールをバインドするには自然な場所です。
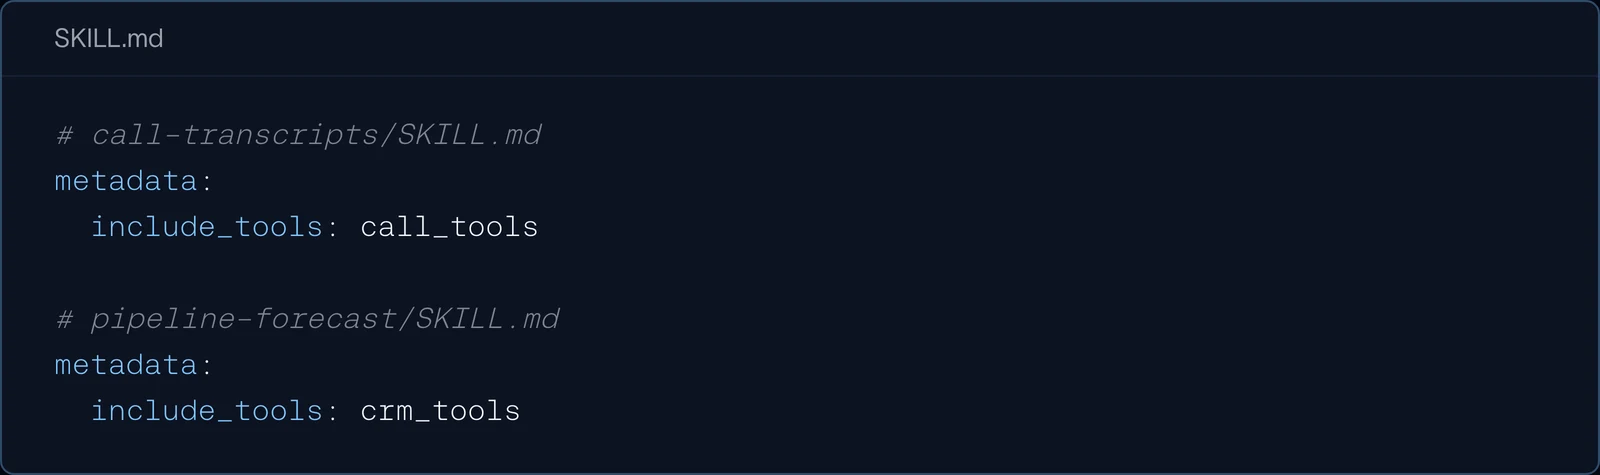
スキルのfrontmatter内のツールを次の下に列挙してください metadata.include_tools:
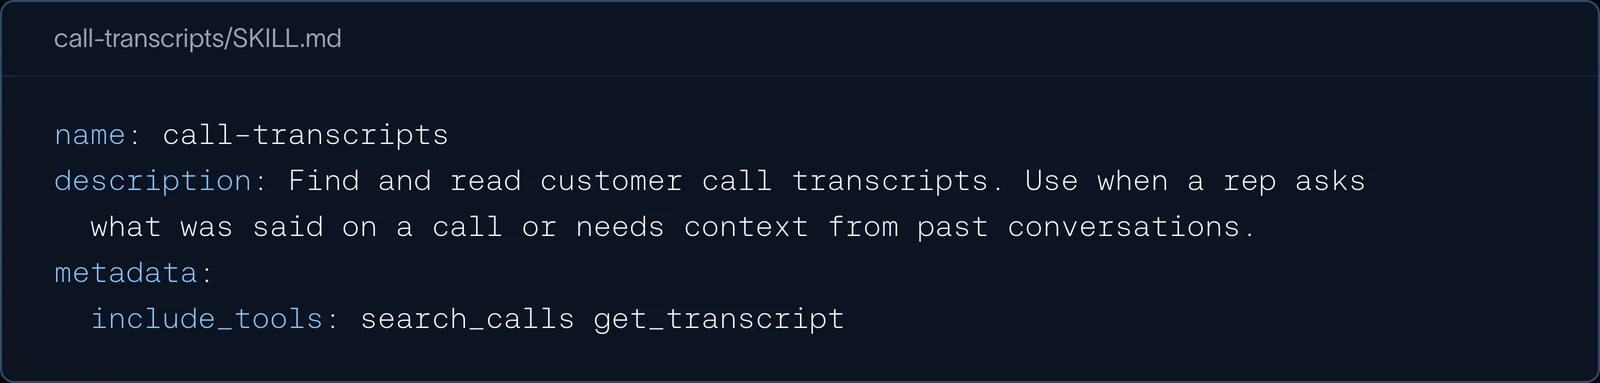
それらのツールを SkillsMiddleware の代わりにエージェントへ渡します:
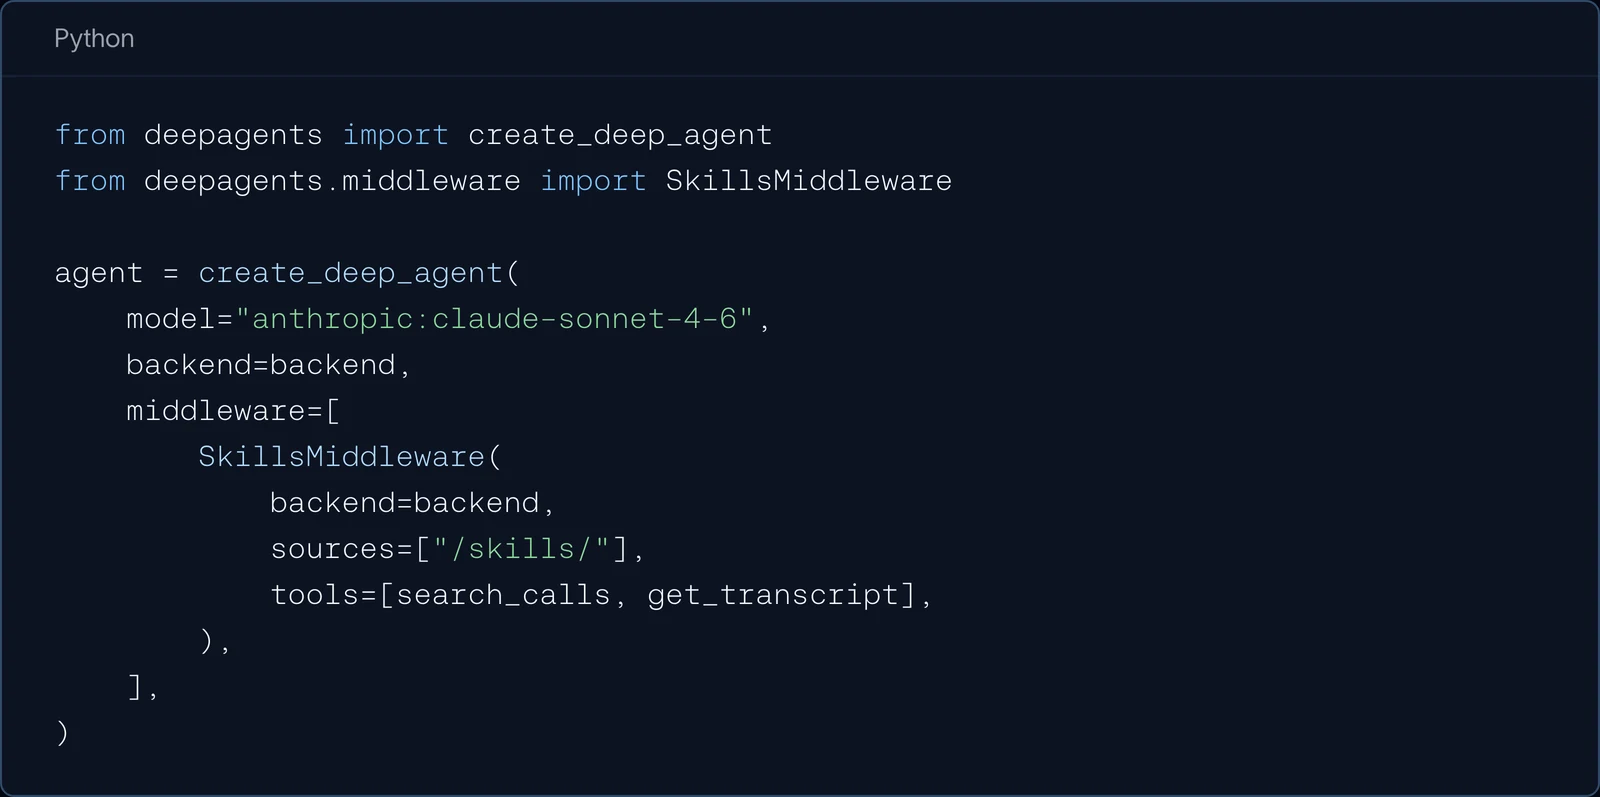
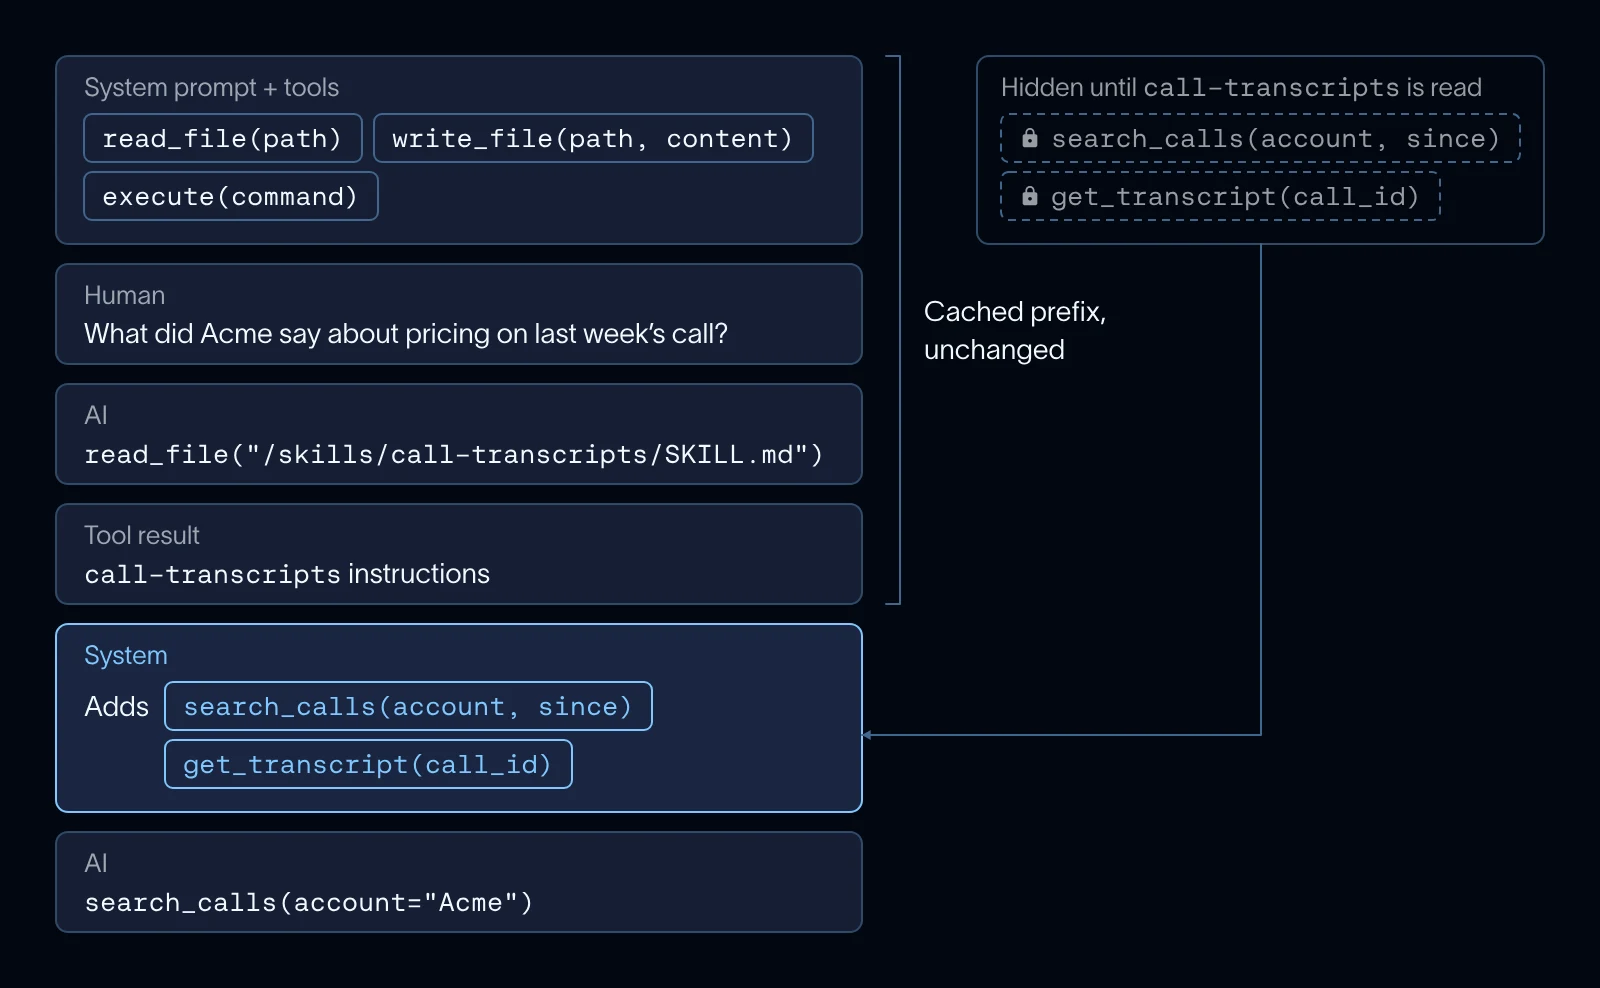
会話の途中でツールを追加するということは、従来はリクエストのツールリストを編集することを意味し、これはプロンプトキャッシュを無効化していました。 Anthropic と OpenAI は現在、新しいモデルで会話の途中のツール受け入れを可能にしているため、これらのモデルでは、Deep Agents はスキルが読み込まれた直後にそのスキルにバインドされたツールを追加し、キャッシュ済みプレフィックスはそのまま維持されます(Anthropic および OpenAI の統合ドキュメント参照)。他のモデルでは、ツールは従来どおりリクエストに追加されます。
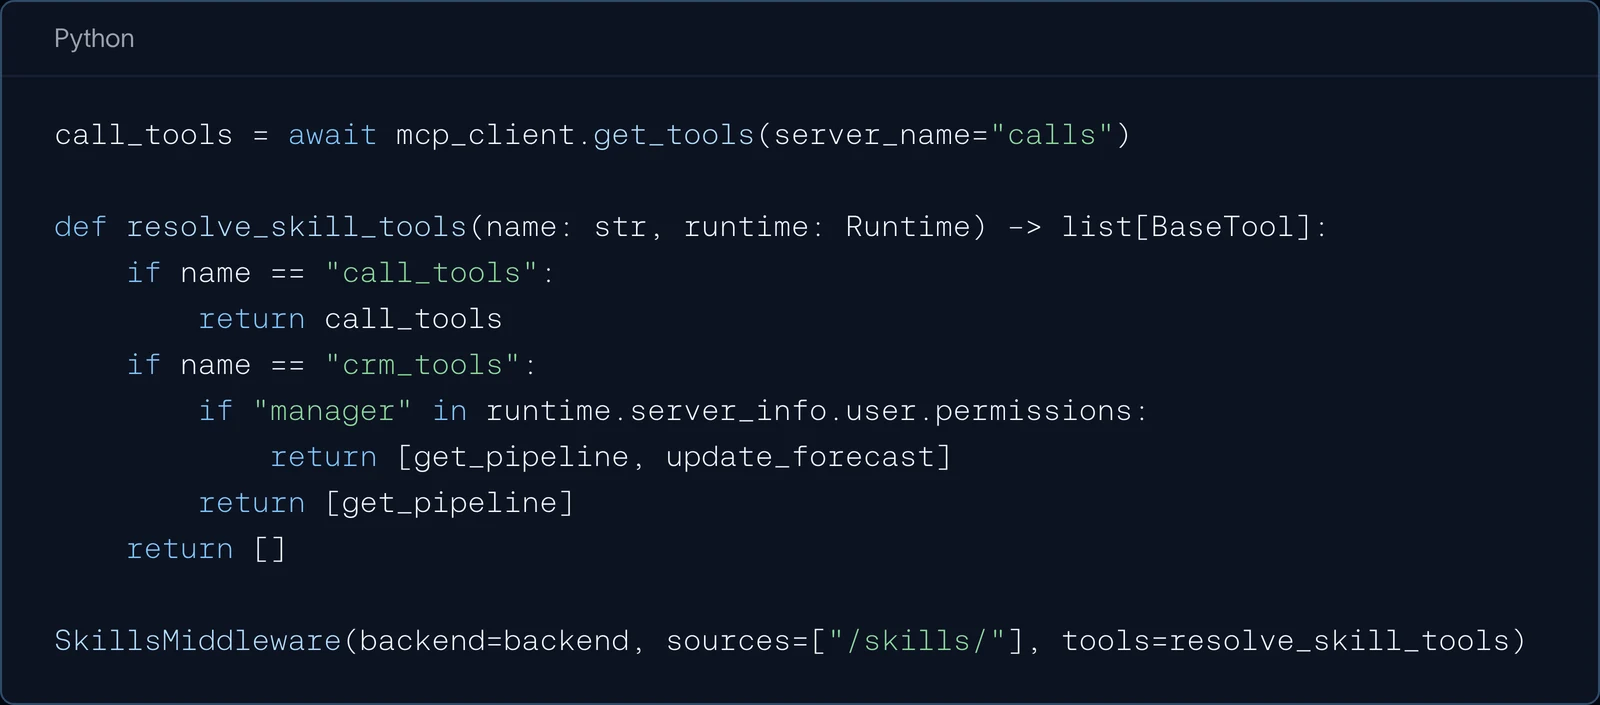
リストでほとんどのスキルをカバーできます。より細かい制御のために、スキルはツール名の代わりにラベルを列挙でき、 SkillsMiddleware に渡す関数が各ラベルをツールに変換します。これにより次のことが可能になります:
- ツールグループ全体を、MCP サーバー上のすべてのツールのように、1 つの名前で開示でき、スキルに各ツールを列挙する必要がありませんMCPサーバー上の他のツールと同様に、スキル内で各ツールを列挙することなく、1つの名前の下で。
- 実行時の権限に基づいてツールをゲートする。 この関数はグラフの runtime を受け取るため、ユーザーが誰であるかを確認し、そのユーザーが使用を許可されているツールのみを返すことができます。
ここでは、 call-transcripts は calls MCP サーバー上のすべてのツールを取得し、 pipeline-forecast は CRM ツールを取得しますが、マネージャーのみが forecast を更新できます:
詳細については、 スキルへのツール追加 を参照してください。
ピン留めされたスキル
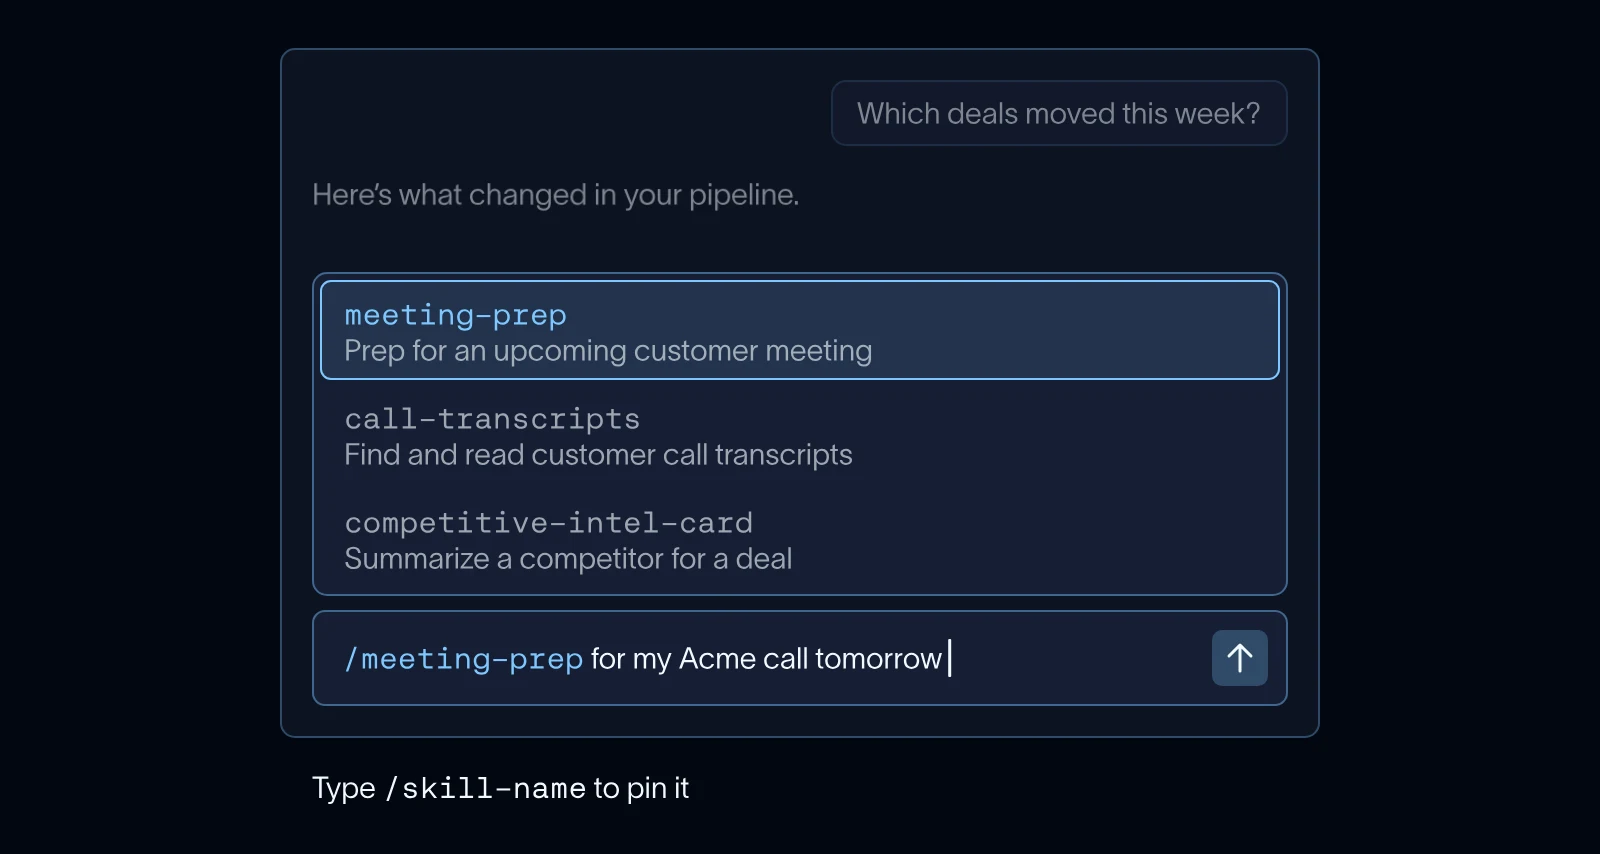
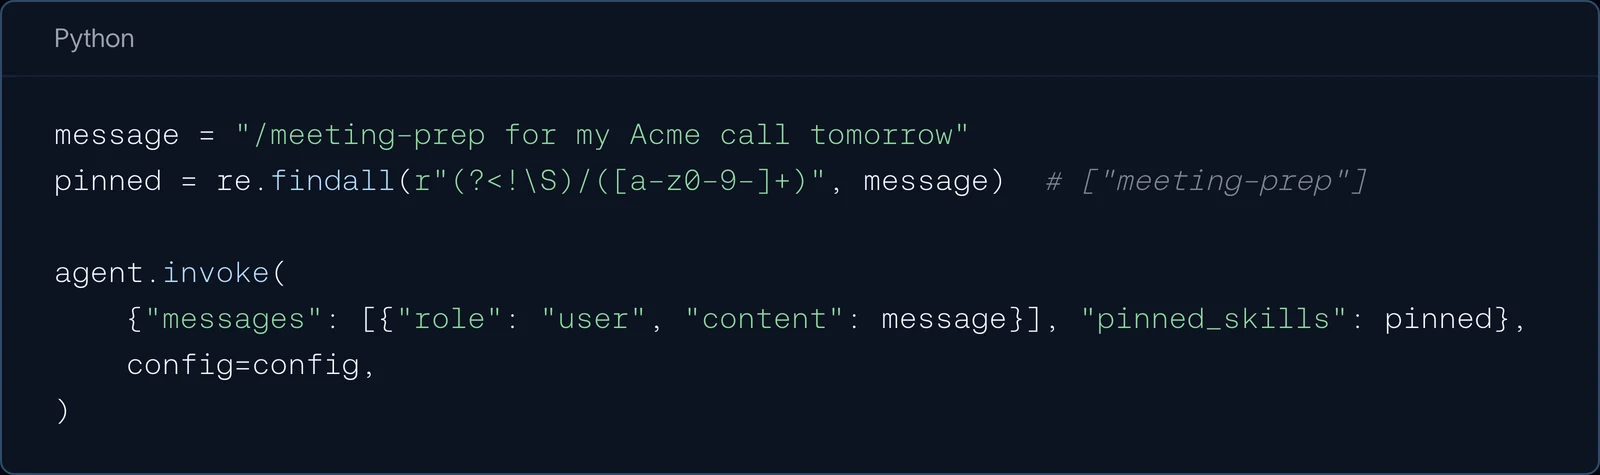
ユーザーがどのスキルを望んでいるかを既に知っている場合があります。当社の GTM エージェントでは、担当者は /meeting-prep for my Acme call tomorrowと入力できます。ピン留めがない場合、モデルにはスキルの説明しか見えず、スキルを読み込む必要があります。これにより作業開始前に往復が 1 回追加され、しかもモデルが正しいスキルを読み込む保証はありません。 ピン留めされたスキルでは、アプリがメッセージ内のスキル名を見つけ(または UI から解析し)、それを pinned_skillsに渡すと、ミドルウェアが次のモデル呼び出しの前に各スキルの指示を会話に追加します。Deep Agents 自身はメッセージを解析しないため、構文はあなたが選択します:
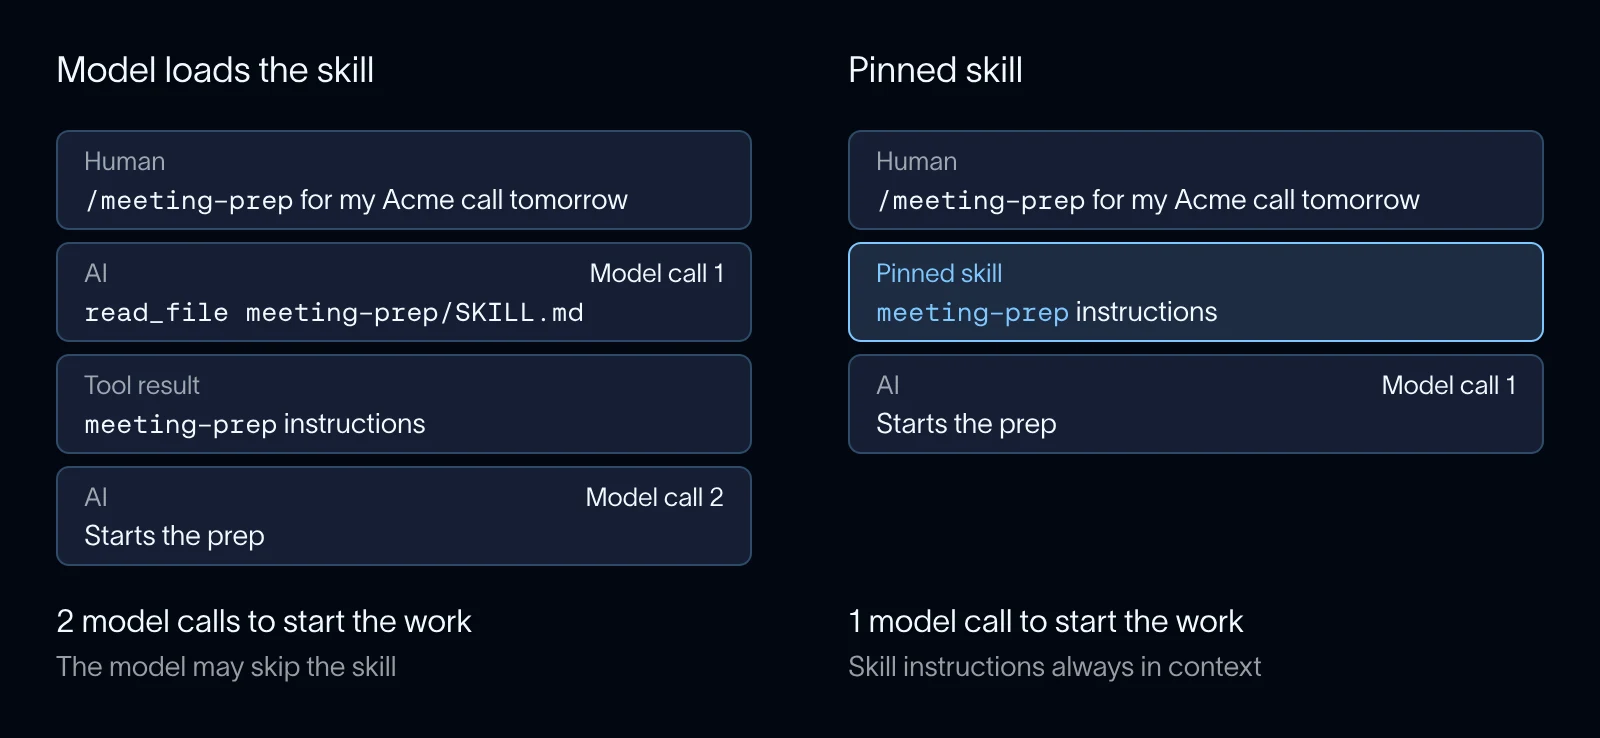
これによりレイテンシが削減され、動作がより予測しやすくなります。命令は確実にコンテキスト内に存在することが保証され、ピン留めされたスキルに紐付いたツールも一緒に提供されます。ピン留めされた各スキルはタグ付きメッセージとして1回だけ追加されるため、以前のメッセージが変更されることはなく、プロンプトキャッシュが有効なまま維持され、チャットUIではスキルの全文の代わりにラベルとして表示できます。
スレッド途中でのスキルの再読み込み
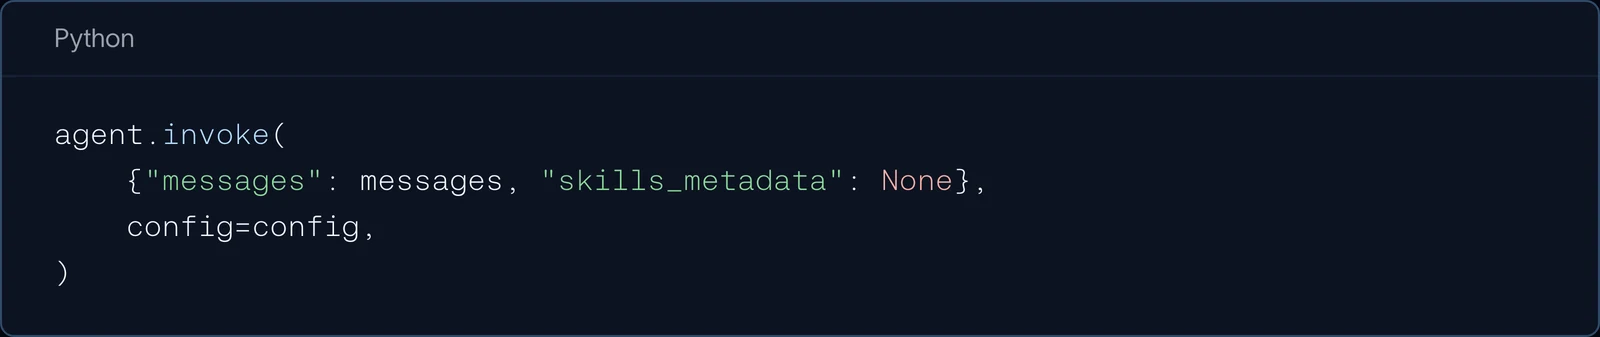
スキルはすべてのスレッドの開始時に読み込まれ、エージェントの状態に保持されるため、それ以降の毎回のターンで同じスキルセットが再利用されます。これにより、次のことが可能になりました。 このリストを無効にする 設定することにより skills_metadata に None エージェントを呼び出す際に。チームメイトが competitive-intel-card スキルをライブラリに追加すると、アプリケーションはスキルのリストを無効化でき、次回の実行ですべてのソースを再スキャンします:
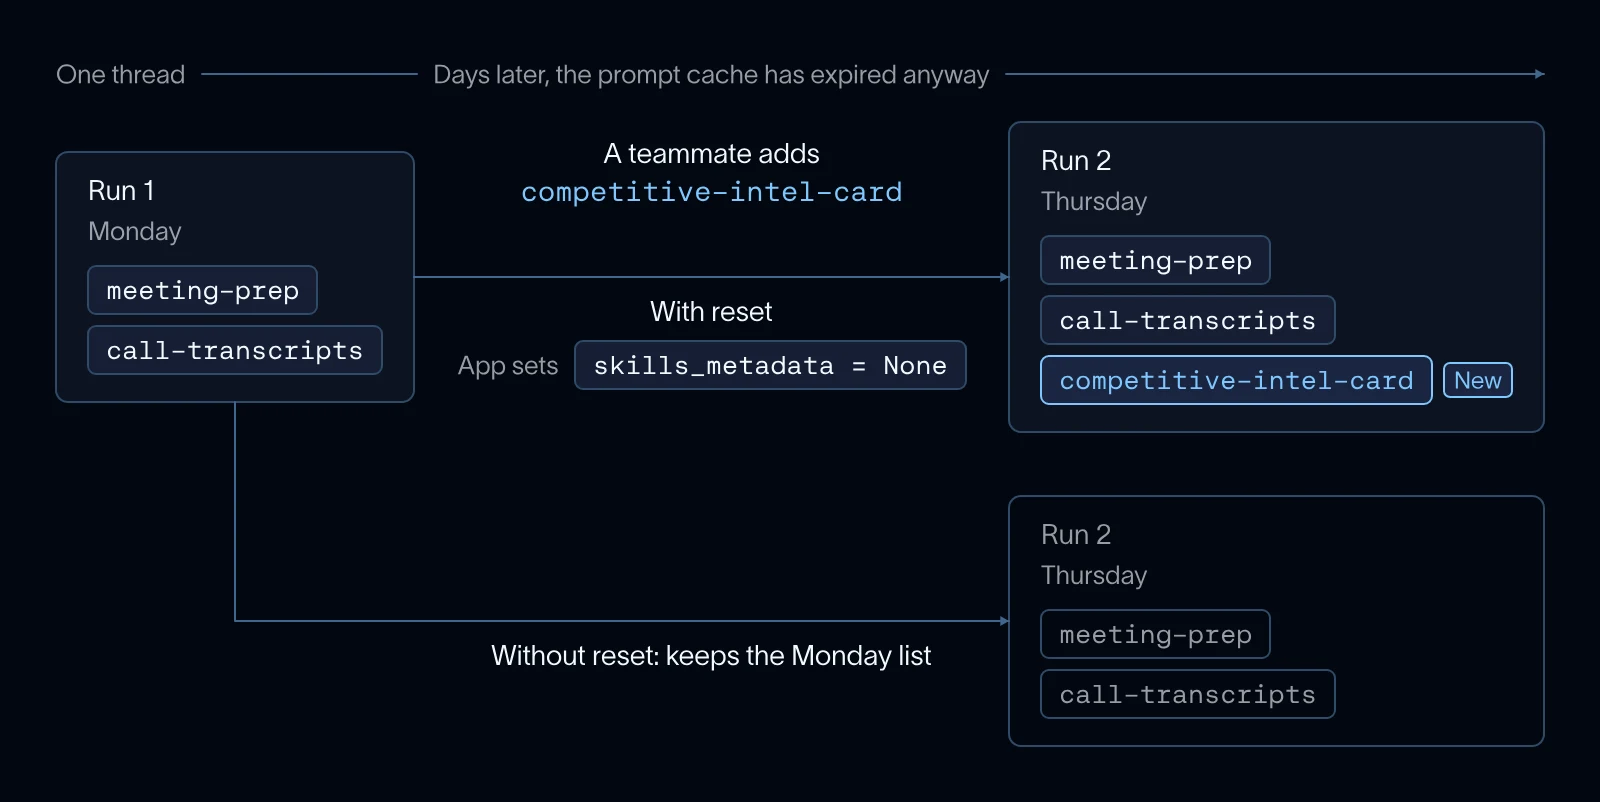
新しいスキルを見つけてリロードするとシステムプロンプトが変更され、プロンプトキャッシュが無効化されます。アイドル状態で放置されていたスレッドであれば、そのコストは通常すでに支払い済みです。プロバイダーのキャッシュは、通常、数分から1時間の非アクティブ状態で失効するからです(Anthropic, OpenAI)、そのため担当者が戻ってくる頃にはキャッシュはコールドになっています。
リセットは単なる実行入力にすぎないため、制御をユーザーに委ねることもできます。たとえば、 /reload クライアント側で次のコマンドを実行します:
ここからもリセットできます: update_state またはミドルウェアからの呼び出しも可能で、スキルの再読み込みがいつ発生するかをアプリ側で制御できます。詳しくは スキルの再読み込み.
開始する
スキルは、エージェントに体系的なドメイン知識を与えるための業界標準のメカニズムです。今回のアップデートにより、大規模な運用がさらに容易になります。ツールはスキルが必要とするときにのみロードされ、ワークフローに必要なスキルは事前にロードされ、長時間実行されるスレッドはライブラリが変わっても最新の状態を保ちます。さらに、スキルはオープン標準であるため、チームが作成したスキルはモデルやエージェントを越えて機能します。
これらはすべて最新版で利用可能です。 deepagents. 以下をお読みください スキルドキュメント 始めるには、またご感想はこちらからお聞かせください: GitHub issues、その フォーラム、または X.
謝辞
〜のおかげで リッチ・スカロット これらの新機能の開発を主導したことを称え、 ハンター・ラヴェル 機能やブログのレビューに!