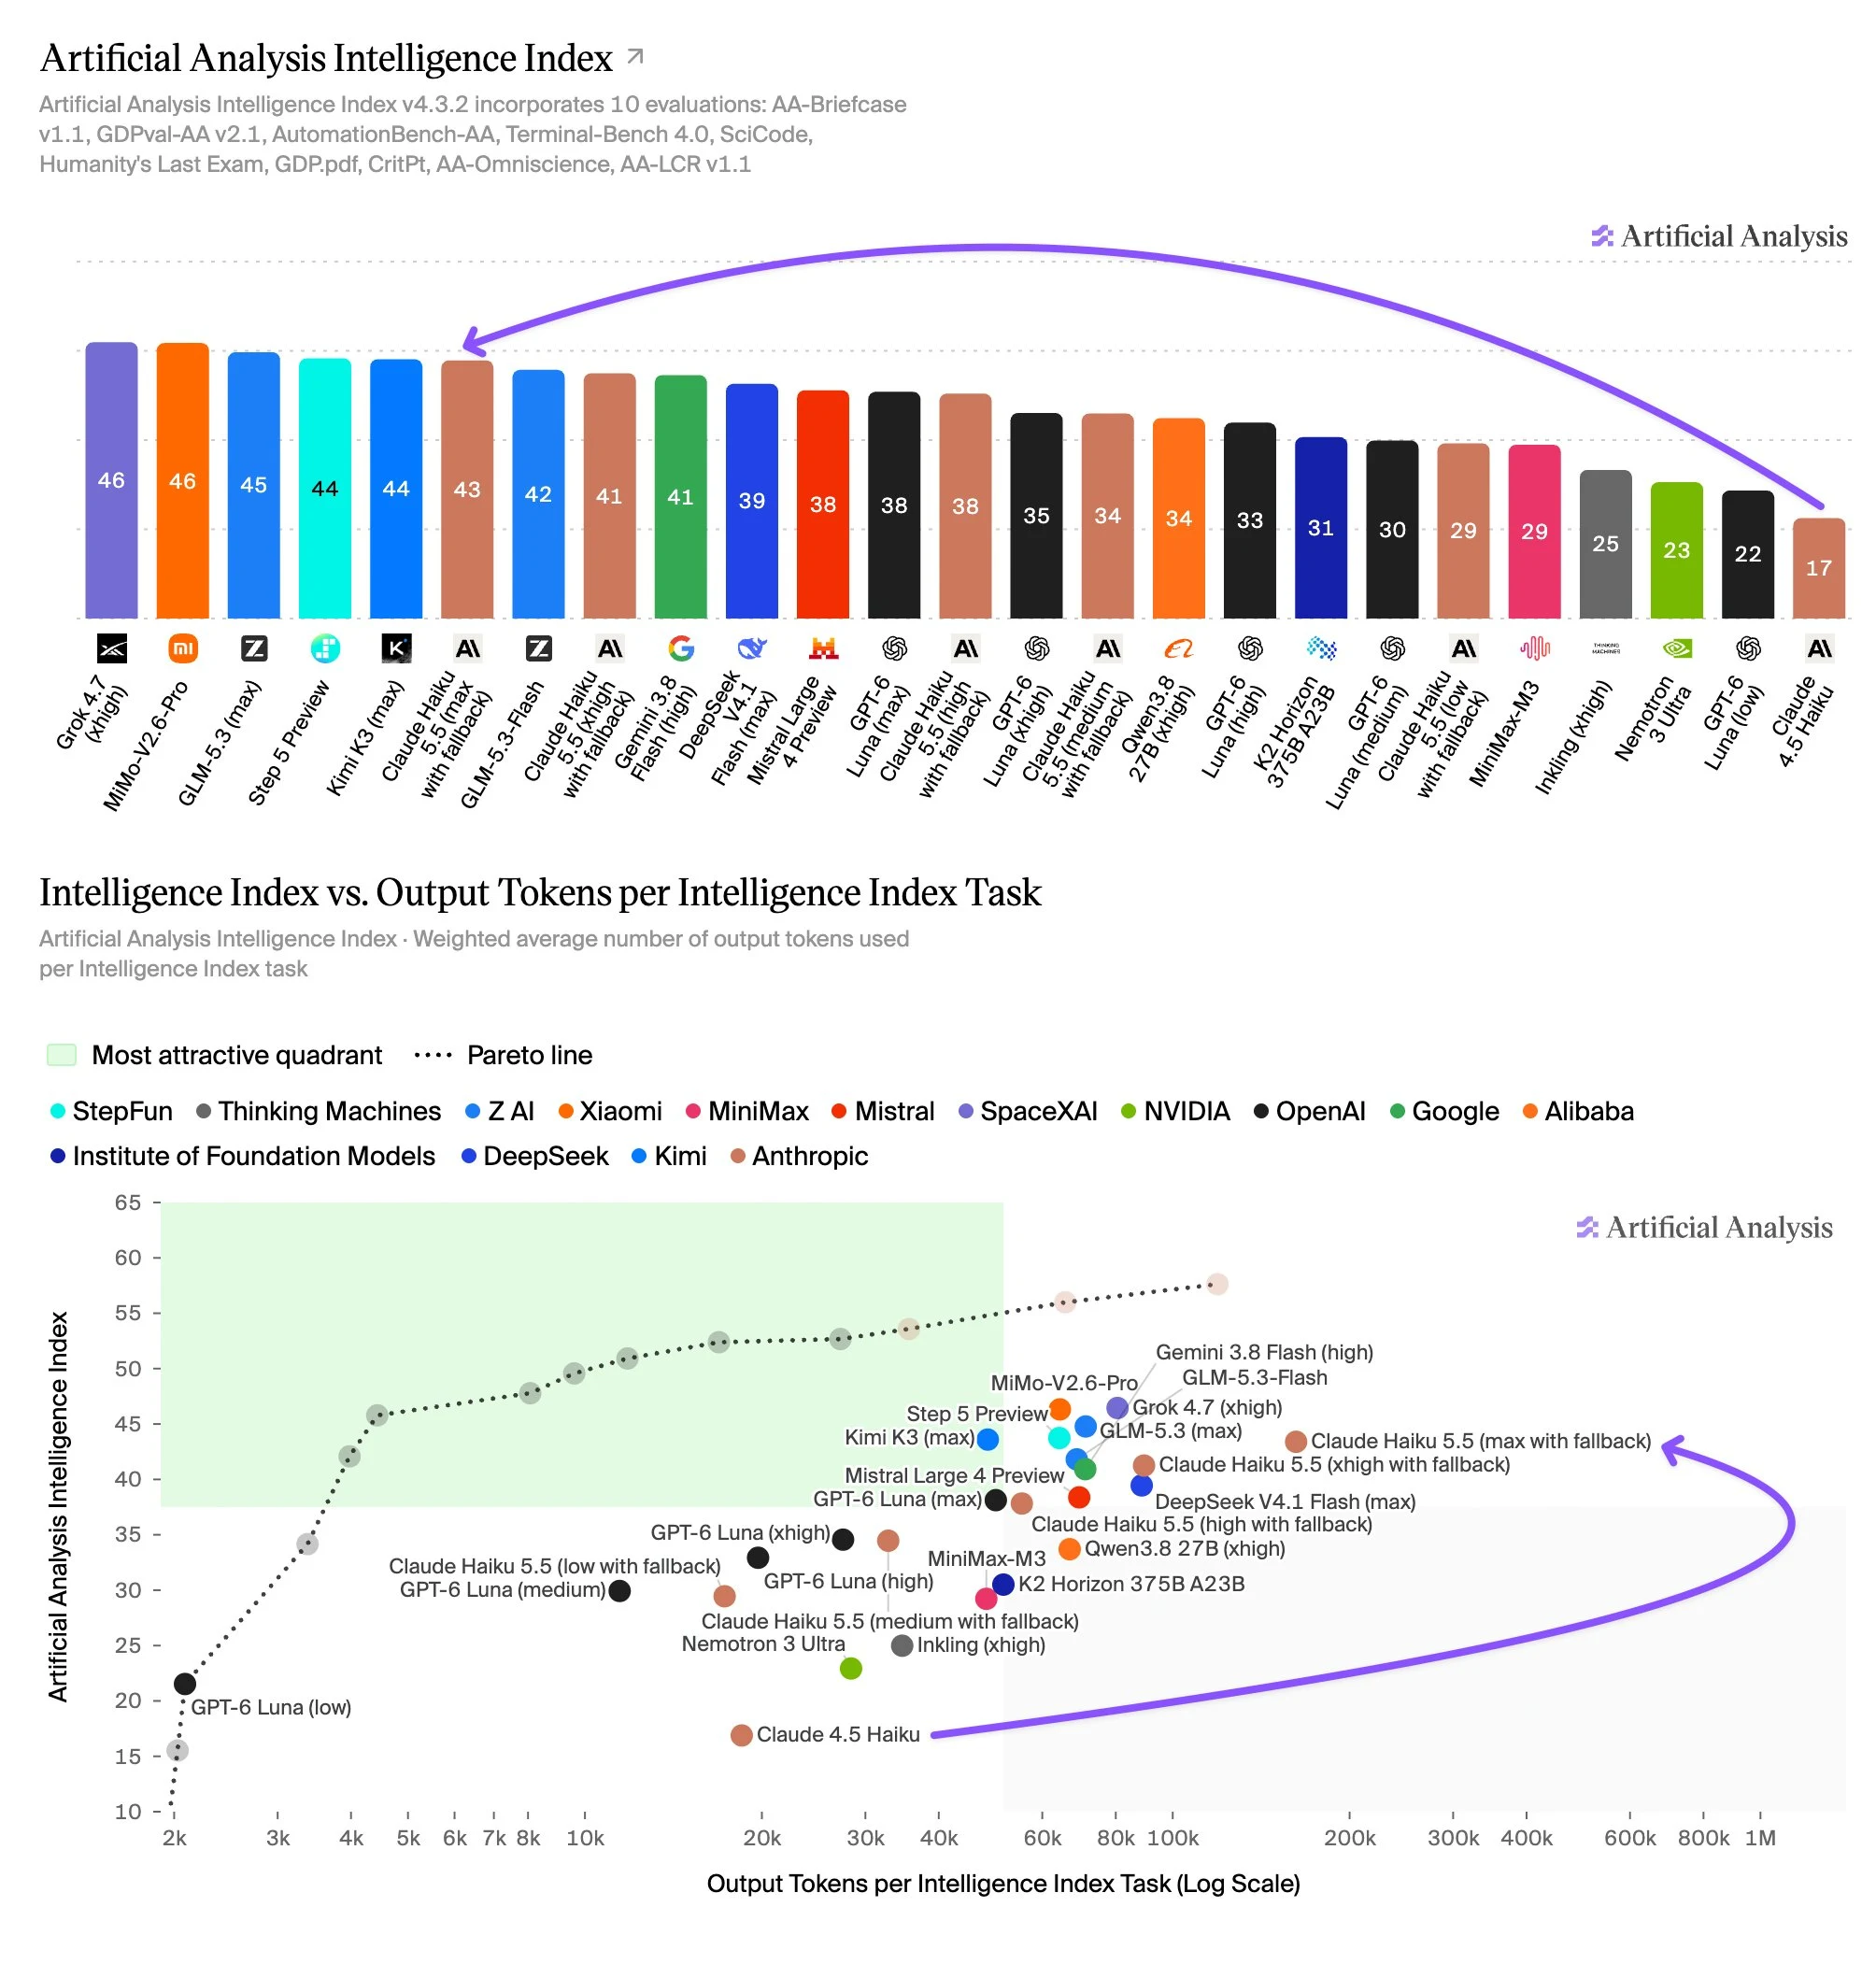
AnthropicがClaude Haiku 5.5をリリース。Artificial Analysis Intelligence Indexで43を記録 - 最後のHaikuリリースから1年後に26ポイント上昇
Haiku 5.5はAnthropicのeffort設定とadaptive thinkingを備えた初のHaikuモデルで、Anthropicは段階的料金を導入しました。
Haiku 5.5は前モデルより安価で、100kトークンまでのプロンプトでは1M入力/出力トークンあたり$0.10/$0.50です(GPT-6 Lunaと同等で、前Haikuモデルの10%)。ただし、100kを超えるとこの料金は5倍の$0.50/$2.50に上昇します。サイトはまだ段階的料金を反映していないため、Haiku 5.5の暫定コスト数値にはこの段階的なコスト増は含まれていません。現在対応に取り組んでおり、近日中にCost per Taskのカバレッジでフォローアップする予定です。
主なポイント:
➤ 小型クラスモデルで先行する性能: 最大effortにおいて、Haiku 5.5はGLM-5.3 Flash(42)、Gemini 3.8 Flash(41)、GPT-6 Luna(38)などのモデルをわずかに上回ります。そのスコアは2.8TパラメータのオープンウェイトモデルであるKimi K3(44)に匹敵し、Claude Sonnet 5.5(max、56)には13ポイント及びません
➤ GPT-6 Lunaと比較した重いトークン使用量: Haiku 5.5(max)はIntelligence Indexのタスクあたり約162k出力トークンを使用し、GPT-6 Luna(max、約50k)の約3倍です。xhighからmaxへの移行では、約1.8倍のトークンで2ポイント追加されます。同程度の知能でもGPT-6 Lunaより多くのトークンを使用します: Haiku 5.5(high)はタスクあたり約55kトークンで38を記録するのに対し、Luna(max)は約50kで38であり、低いeffort設定では差がさらに広がります
➤ エージェント的なナレッジワークで高い能力: 現実的なナレッジワークタスク向けの非公開評価であるAA-Briefcaseで、Haiku 5.5(max)は1578 Eloに達し、Kimi K3やGLM-5.3を含むモデルを上回り、Muse Spark 1.3(max)に匹敵します
➤ ターミナル利用の改善: Terminal-Bench 4.0では33%を記録し、Haiku 4.5の0%から上昇しました。これはGLM-5.3 Flashと同水準で、Gemini 3.8 Flash(20%)とGPT-6 Luna(13%)を上回ります
➤ 事実知識は低いが、幻覚は比較的少ない: 小型クラスモデルとして予想通り、Haiku 5.5は同系列モデルより事実知識が低くなっています。AA-Omniscienceの正答率は36%で、Gemini 3.8 Flashの55%やGPT-6 Lunaの44%を下回りますが、これは一部、知らないことを認める意欲が高いためです - 幻覚率は低く、55%と77%に対して40%です
➤ AutomationBench-AAの結果は過小評価されている可能性: Haiku 5.5は35%を記録し、GPT-6 Luna、Gemini 3.8 Flash、GLM-5.3 Flashの53〜60%に対して低くなっています。リリース前テスト中、安全性の拒否に関する問題により、モデルが過剰に拒否していました。Anthropicはこの問題の解決に取り組んでおり、修正後にこの評価を再実行する予定で、スコア上昇を見込んでいます
その他のモデル詳細:
➤ コンテキストウィンドウ: 100万トークンで、Claude 4.5 Haikuの200kから増加
➤ 料金: 100kトークンまでは1M入力/出力トークンあたり$0.10/$0.50、超過分は$0.50/$2.50。キャッシュ読み取りは$0.01(100k超は$0.05)、5分キャッシュ書き込みは$0.125(100k超は$0.625)
➤ マルチモーダリティ: テキストと画像の入力、テキストの出力