
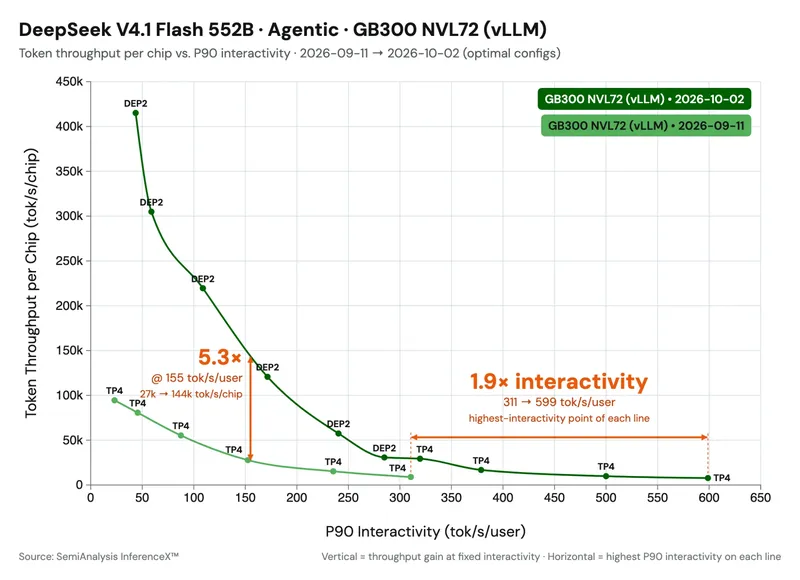
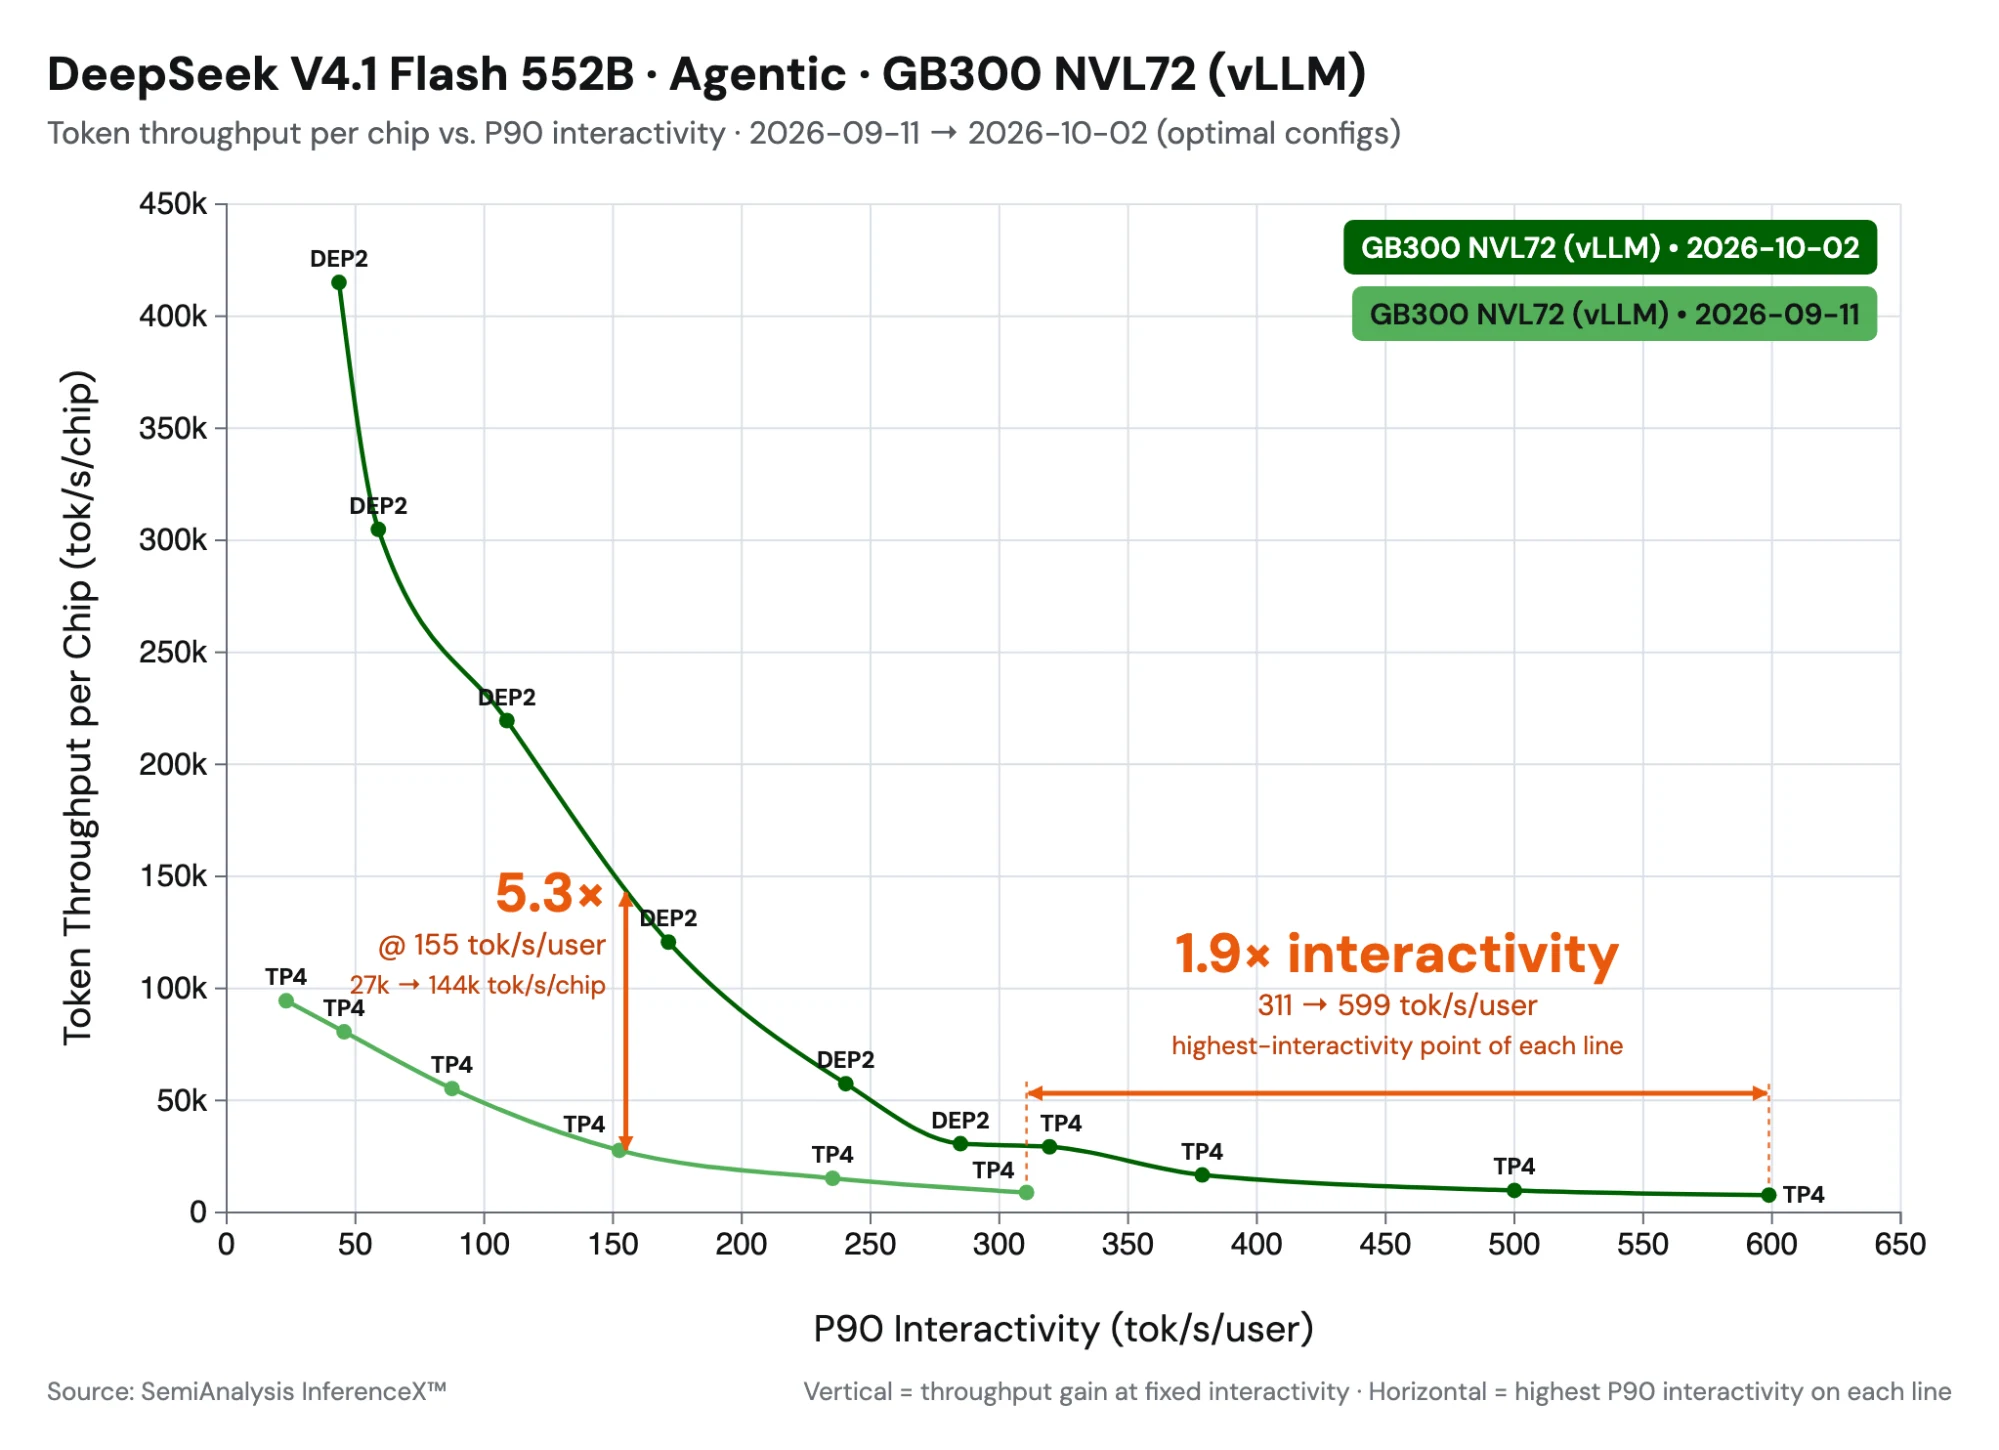
TL;DR: DeepSeek-V4.1-Flashのリリース後3週間で、InferactとvLLMコミュニティはモデルを最適化し、低同時実行時にて1.9倍の高速化、150 TPS制約下で5.3倍のスループット向上を達成しました。この性能向上は以下によるものです:
-
CUDAグラフを用いたSWA bounded replayを実装し、TTFTを約30%削減しました。
-
MegaAttention、Mega-mHC、Mega-Gate、DeepSelectを含む、DeepSeekが新たにリリースしたカーネルを統合しました。
-
mHCサイドストリームを含む残りのカーネルを積極的に融合・並列化し、all-reduceを前後のopと単一カーネルに融合しました。
DeepSeek V4.1は、長時間にわたるエージェンティックサービングタスクのための非常に効率的なアーキテクチャを導入しています。causal encoder-decoder(CED)アーキテクチャにより、decode時にはトークンあたり16Bパラメータを活性化しますが、prefill時には8Bパラメータのみです。このモデルはメモリ効率も極めて高くなっています。Compressed Sparse Attention 2(CSA2)、FP4 KVキャッシュ、レイヤー間KVキャッシュ共有など複数の手法を組み合わせてKVキャッシュサイズを縮小し、グローバルKVフットプリントをトークンあたり890バイトまで抑えています。本記事では、これらのDeepSeekによるモデルレベルの最適化とvLLM側のシステム最適化を組み合わせ、SemiAnalysis AgentXエージェンティックサービングベンチマークで5倍のスループットを達成する方法を示します。最適化をSWA bounded replayとカーネル関連の最適化の2つのカテゴリで解説します。
SWA bounded replay
DeepSeek-V4.1-Flashは2種類のKVキャッシュを保持します。グローバルKVは圧縮され、レイヤー間で共有され、FP4で保存されており、トークンあたり約890バイトです(V4.1レポート)。スライディングウィンドウ(SWA)KVはFP8で非圧縮のまま、40レイヤーそれぞれの直近128ポジションをカバーします。
SWA KVは2つのコストを生み出します:
-
プレフィックスキャッシュは、あらゆるヒット境界でSWA KVを保存する必要があり、グローバルKVの10倍以上のストレージを消費します。
-
prefillはレイヤー21〜39をすべてのプロンプトトークンに対して実行しますが、decodeはそれらの直近128ポジションしか読み出しません。
一つの straightforward なアプローチは、SWA KVをキャッシュせず再計算することです。しかし、正確な再計算は高コストです。各レイヤーの128トークンウィンドウが下位レイヤーのより前のポジションに依存するため、Lレイヤーにわたって再構築するには約L × 128トークンのリプレイが必要になるからです。
DeepSeek V4.1は、正確性を効率性と引き換えにするSWA bounded replayを導入しました。これは直近の128トークンのみを再実行し、リプレイ開始時点でSWAウィンドウをクリップします。結果はビット単位で正確ではありませんが、DeepSeekは品質低下は無視できると報告しています(詳細は下記)。vLLMはこれを、それぞれのコストに対応する2箇所で適用します。
エンコーダー側: キャッシュヒット時にウィンドウを再構築
エンコーダー側のリプレイでは、vLLMはグローバルKVのみをキャッシュし、SWA KVをスキップします。長さHのプレフィックスヒットがあった場合、トークン[H − 128, H)を再実行してSWA KVを再構築し、ウィンドウはs = H − 128でクリップされます。
デコーダー側: プロンプトprefillの大部分をスキップ
DeepSeek V4.1のCEDアーキテクチャでは、レイヤー20がデコーダーのグローバルKVを計算し、レイヤー21〜39はそれを再利用します。そのため、vLLMはグローバルKVを生成するためにレイヤー20をすべてのトークンに対して実行し、レイヤー21〜39は各リクエストの直近128トークンに対してのみ実行します。長いプロンプトの場合、これはモデルのほぼ半分をスキップすることになります。
トリミングされたレイヤーのためのCUDAグラフ
トリミング後、レイヤー21〜39はGPUワークが非常に少なく、eager実行ではカーネル起動オーバーヘッドが支配的になり、GPUがアイドル状態になります。また、その入力形状はレイヤー0〜20と異なるため、両方を1つのCUDAグラフにキャプチャすることはできません。vLLMのbreakableなPIECEWISEグラフはすでにモデルの途中でブレークするため、自然な分割点になります。レイヤー0〜20はフルバッチでキャプチャし、レイヤー21〜39はトリミングされたバッチで別途キャプチャします。これにより、トリミングされたprefillでもCUDAグラフが使用可能になり、レイヤー21〜39が独自のキャプチャサイズを使えるようになるため、グラフカバレッジが向上します。
SWA bounded replayはDeepSeek-V4.1でデフォルトで有効であり、以下で制御されます --[no-]swa-bounded-replay.
精度と性能の結果
SWA bounded replayは正確ではありませんが、DeepSeekは品質低下が無視できる程度であると報告しています。我々はGSM8KやGPQAなどのベンチマークでvLLM上のこれを確認し、意味のある精度差は見られませんでした(差は約1.5標準誤差以内)。
性能面では、エンコーダー側はヒットごとに1ウィンドウ分のprefillをキャッシュスペースと引き換えにするため、高速化はデコーダー側から得られます。単一リクエストのprefill TTFTを3つの設定で測定しました: リプレイ無効、デコーダーCUDAグラフなしのリプレイ有効(レイヤー21〜39はeager実行され、eagerステップのみトリミング)、デコーダーCUDAグラフありのリプレイ有効。
CUDAグラフを用いたデコーダーリプレイは、prefill計算時間を30〜40%削減します。 CUDAグラフは、カーネル起動がボトルネックとなる短いプロンプトで最も効果があります。CUDAグラフなしでは、起動オーバーヘッドがGPUの削減分を上回り、リプレイはベースラインより遅くなります(DEP2の1Kで最大+12%)。長いプロンプトでは、GPUワークが大きいため起動オーバーヘッドが隠蔽され、eagerリプレイですでにほとんどのゲインが得られ、CUDAグラフがさらに数ポイントを追加します。
カーネル
DeepSeekはDeepSeek-V4.1-Flashを、3つのリポジトリにまたがる新カーネルとともにリリースしました。DeepSelectはDeepSeek Sparse Attention向けの新しいtop-kライブラリです。DeepGEMMにはスパースインデクサーカーネルと複数のGEMM関連融合カーネルが追加されました。FlashMLAにはNVFP4 KVキャッシュサポートと融合アテンションカーネルMegaAttentionが追加されました。我々はこれらのオープンソースカーネルのいくつかをvLLMに統合し、進捗を次で追跡しています #57448.
Mega-mHC(#56962). Mega-mHC は mHC チェーンを 1 つのカーネルに融合します。post ステップ、遅延 pre ステップ、および RMSNorm です。これは、DeepGEMM の実装が現在性能を上回るようになった、既存の TileLang 融合パスを置き換えるものです。このカーネルは NVIDIA GB200 上で TileLang 版より 1.14~1.51 倍高速です。
Mega-Gate(#56266). Mega-Gate は MoE ルーター(gate GEMM、エキスパートスコアリング、バイアス、top-k 選択)を 1 つのカーネルに融合します。以前は、これらの処理は 1 つの GEMM とその後の別個の top-k カーネルとして実行され、追加のカーネル起動とスコアのメモリ往返のコストがかかっていました。この融合により、中程度のバッチサイズで 1.18~1.31 倍のカーネル高速化が実現します。
mHC マルチストリームオーバーラップ(#57603). V4.1 では、mHC 係数が 1 サブレイヤー分ずらされているため、次のシームの係数 GEMM は、attention や FFN の実行前にすでに存在する residual ストリームのみを読み取ります。次の post/pre ステップで両者が結合されるまで、どちら側も相手の出力を必要としません。小さなバッチサイズでは、vLLM は次の mHC ブロックの係数をサイドの CUDA ストリーム上で、attention および FFN と並行して計算するようになりました。これにより、レイテンシが支配的なデコードのクリティカルパスに載ってしまうはずの処理が隠蔽されます。TP4 の低レイテンシシナリオでは、これによりレイテンシが約 4% 削減されます。
Sparse MQA logits(#56254). V4.1 では、後段のインデクサーレイヤーは 16K 個の候補位置の固定セットから top-k を選択します。以前の実装では、コンテキスト全体のスコアを計算し、スコアリングの前にすべての非候補ブロックをマスクしていました。DeepGEMM の sparse カーネルは候補のみをスコアリングするため、コストはコンテキスト長に比例して増加しなくなります。NVIDIA GB300 上のレイヤーあたりでは、8K トークンで 1.2 倍、512K で 14~23 倍高速です。4× NVIDIA GB300 でのエンドツーエンドでは、デコードが 3~6% 向上します。プリフィルは 512K コンテキストで 1.43 倍、1M で 2 倍高速です。
NVFP4 圧縮 KV を用いた MegaAttention(#56935). FlashMLA の MegaAttention カーネルは、query RoPE、sparse attention、出力に対する逆 RoPE、および FP8 キャストを 1 回の起動で実行し、出力投影が読み取るバッファに直接書き込みます。これにより、attention と次のレイヤーの間の個別カーネルとメモリ往返が不要になります。また、以前の FP8 KV キャッシュより 45% 小さい新しい NVFP4 圧縮 KV フォーマットを読み取ります。MegaAttention はまた、演算間の HBM 書き込みを排除する積極的な融合により、カーネル効率を 1.45 倍向上させます。
低レイテンシ融合 WO-A カーネル(#58634). Blackwell 上の小さなデコードバッチに対して、逆 RoPE、FP8 量子化、WO-A バッチ GEMM、および MXFP8 再量子化を 1 つの CuTe-DSL カーネルに融合し、WO-B 前のチェーンを 3 カーネルから 1 カーネルに削減します。鍵となるアイデアは、中間アクティベーションをオンチップに保持し、データ移動を計算とパイプライン化することで、小さなバッチサイズで支配的になる追加のカーネル起動やグローバルメモリの往返を回避することです。これにより、融合 WO-A パスが最大約 2.1 倍向上し、低同時実行数でトークン間レイテンシが最大約 6~7% 低減されます。
Engram。 V4.1 の Engram レイヤーは、ハッシュ化されたトークン n-gram をキーとする 2 つの大きな FP8 テーブルから行をルックアップします。各ステップで読み取るのはわずかな行のみであるため、テーブルの配置とルックアップのレイテンシが計算よりも重要になります。我々は CPU にオフロードされた Engram ルックアップを非同期にプリフェッチし、ホストメモリアクセスをデコーダの計算とオーバーラップさせることで、低バッチデコードを高速化します(#56512)。Engram ヘッドは統一された TP/DP スキームでシャーディングされ、同一配置の DP レプリカは同じホストテーブルを共有するため、ルックアップパス上での冗長なコピーと DP 通信が回避されます(#57651)。これらの大きなホスト常駐テーブルに対して、透過的ヒュージページ(THP)もサポートし、ページフォールトのオーバーヘッドを削減することで、プリフィルのルックアップカーネルを最大 10 倍高速化します(#56926)。また、十分なヒュージページが利用できないケース向けの最適化も追加しました(#59327).
エージェント性能
代表的なエージェント型サービングワークロードとして、SemiAnalysis の AgentX ベンチマークを用いて性能を測定します(詳細は我々の 以前の記事を参照)。これらの最適化を組み合わせることで、vLLM は day-0 実装から大幅な性能向上を達成しました。Figure 6 に示すとおり、低レイテンシの結果は day-0 の結果から 1.9 倍に向上し、高スループットの結果は約 5 倍に向上しています。
低レイテンシサービングでは、FlashInfer attention を用いた TP4 を使用します。小バッチデコードは主にメモリ帯域幅がボトルネックであるため、モデルの重みを 4 基の GPU にシャーディングするのは良い適合です。MegaAttention も試しましたが、その主な利点は融合の効果がより発揮される高スループットの設定にあります。TP4 ではその利点ははるかに小さく、我々の実行では FlashInfer の方が高速でした。
高いスループットを実現するため、専門家を複数のGPUに分散させたDPアテンションを用いてDEP2に切り替えます。V4.1はすべてのヘッドで共有されたKV潜在表現を使用するため、TPではKVキャッシュがGPU間で複製されてしまいます。DPはこの重複を回避します。各GPUは自身が処理するリクエストのKVのみを保持し、セッションアフィニティによってターンをまたいでプレフィックスキャッシュの局所性が保たれます。MegaAttentionはNVFP4によってリクエストあたりのKVフットプリントをさらに削減し、FP8と比べてほぼ半分にしつつ、GPUあたりの同時実行数を高めます。
注目すべきは、V4.1が非常にメモリ効率に優れており、ベンチマーク全体を通じてKVキャッシュのオフロードを必要としないことです。KVキャッシュのオフロードは、P/D分離を併用したより高い同時実行数において効果を発揮し始めると期待しています。
SWA bounded replayは、プリフィル側のカーネル最適化と相まって、TTFTも大幅に改善しました。
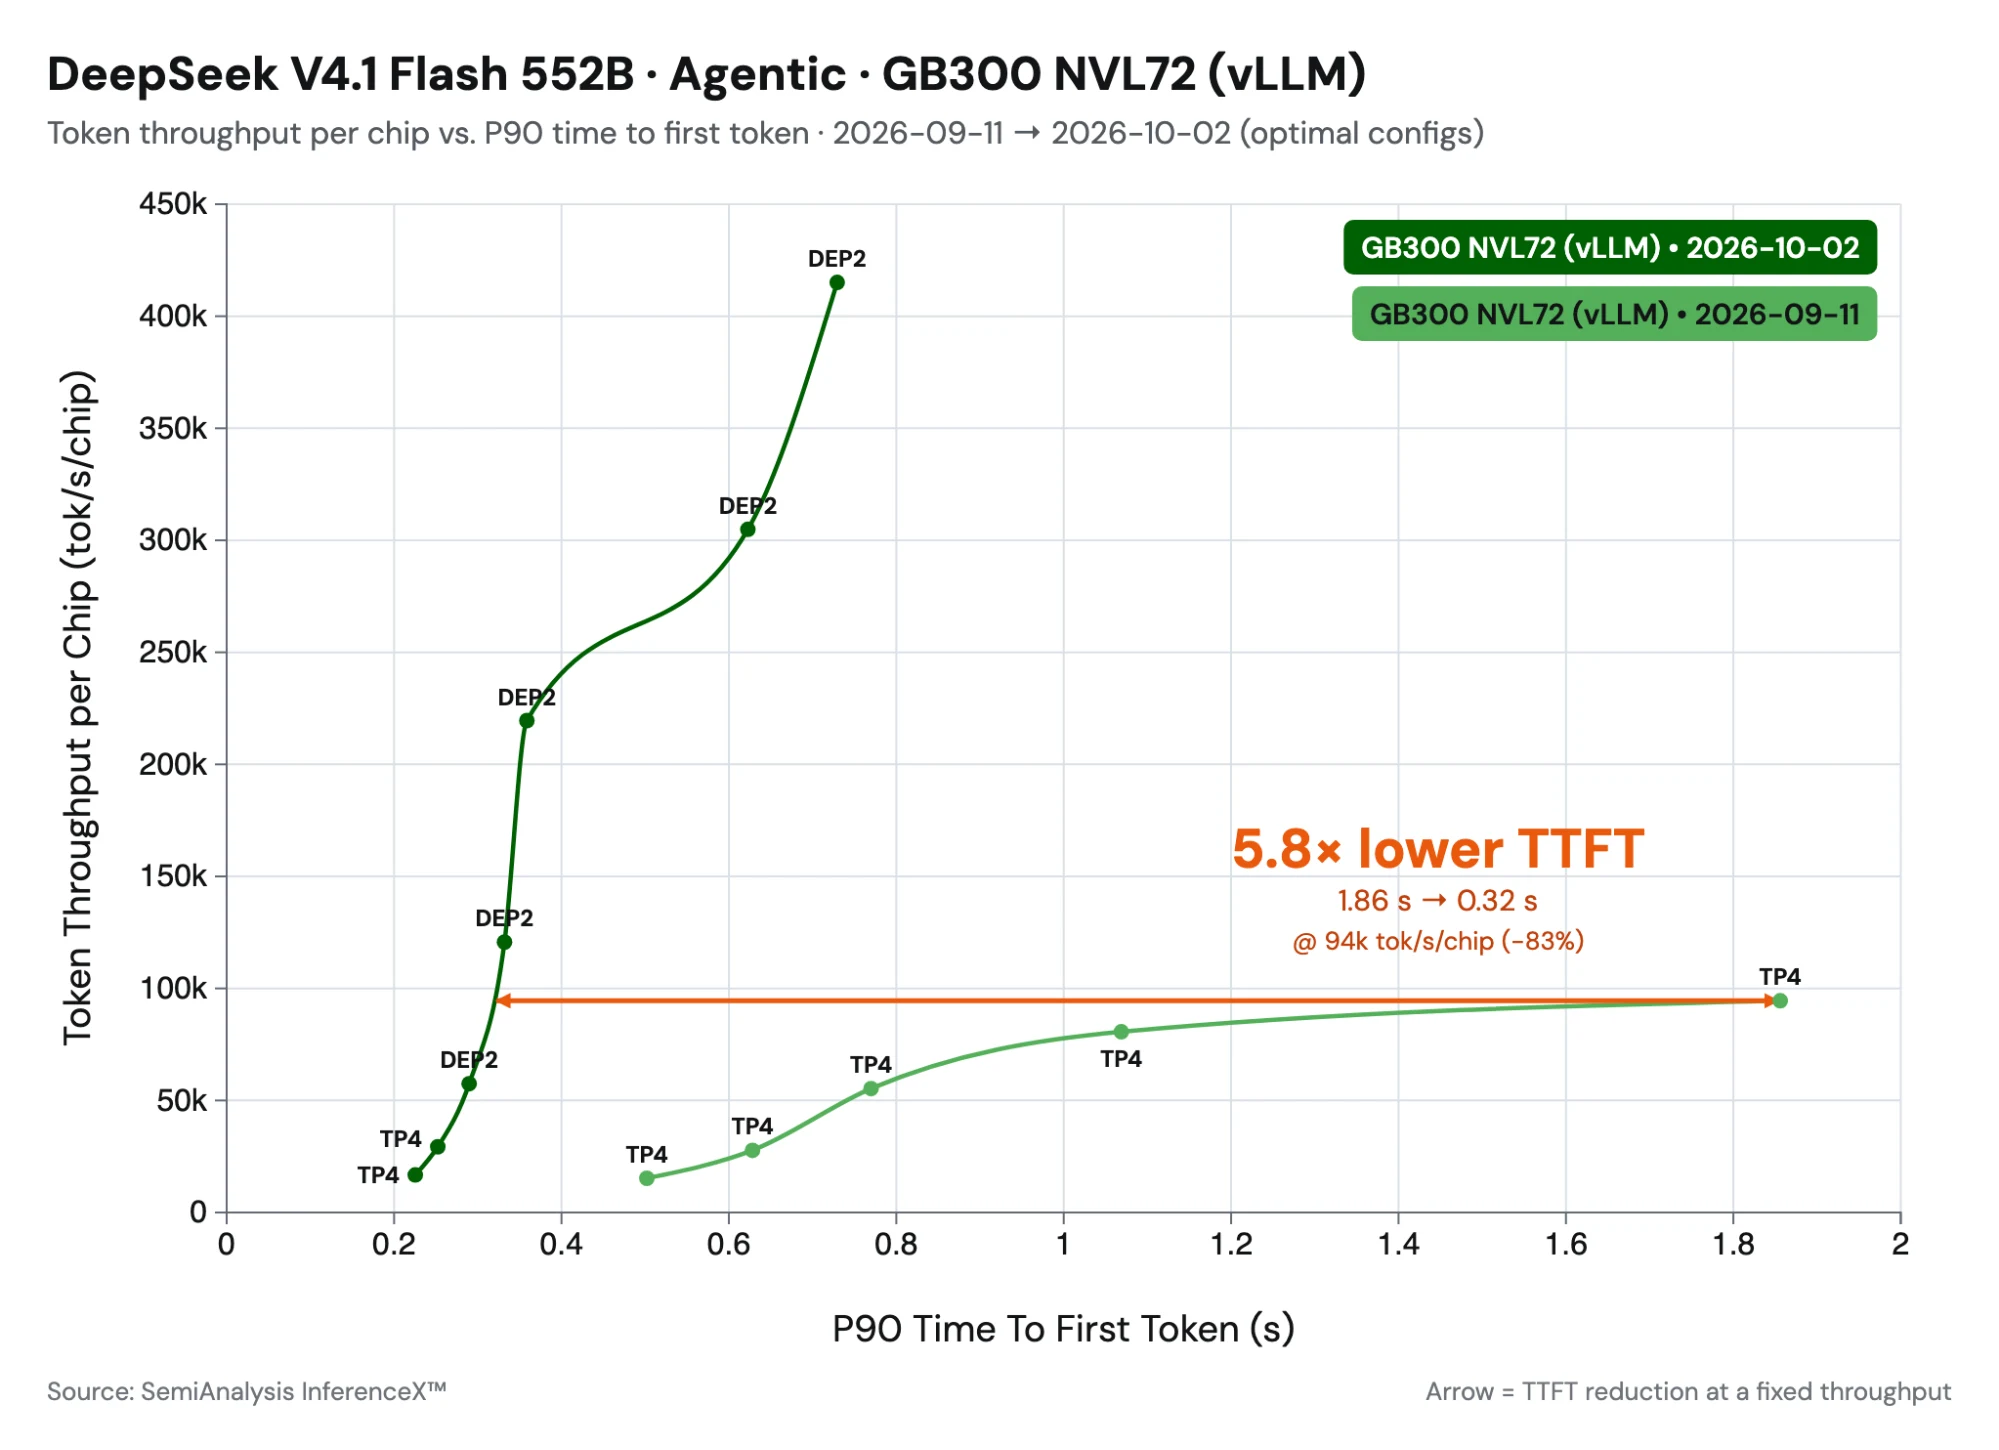
図7は、最適化後のTTFTとスループットのトレードオフを示しています。約100Kのスループットにおいて、TTFTは3つの最適化を組み合わせることで約70%低下します。
-
SWA bounded replayにより、モデルの上半分は最後の128トークンのみを処理すればよく、プリフィルの計算量はほぼ半分に削減されます。
-
CUDAグラフにより、トリミングされた小さなリプレイがCPUカーネル起動の制約ではなくGPU上で高速に実行されるため、高速化の効果を最大限に引き出せます。
-
カーネルの改良により、モデルの計算が高速化されます。
謝辞
DeepSeek-V4.1-Flashおよび関連カーネルをオープンソース化してくださったDeepSeek、初期のモデル立ち上げと最適化を担ってくださったInferactチーム、協力と支援をいただいたNVIDIA、そしてAgentXベンチマークのSemiAnalysisに感謝いたします。