
判断力こそが、シニアの専門家を若手の同業者から区別するものです。判断力を養うには、現場での学習に何千時間も費やす必要があり、通常は比較的定型的な作業への地道だが形成的な取り組みを通じて、経験豊富な職員の指導のもとで行われます。しかしAIはすでに、現場での学習のあり方を 変えつつあります 一方で、 放射線科, ビジネス問題解決, 求職者の文書作成、そして 法教育 における実証研究は、AIツールが訓練ワークフローに慎重に組み込まれれば、経験の浅い労働者でも独立したパフォーマンスを向上させられることを示しています。
他方、最近の実験では、 ソフトウェアエンジニア, 経営コンサルタント, 高校生、そして 臨床医 を対象に、AIは即時の成果を高める一時的な外骨格として機能するものの、その利得はツールを取り除くと多くの場合持続しないことが示されています。AIが専門知識を蝕むのか高めるのかを理解するには、めったに揃わない3つの要素が必要です。(1) 数時間ではなく数か月にわたり通常の業務に組み込まれた持続的なAI利用、(2) AIが使えない状況での支援なしの判断力についての信頼できる評価、(3) 分野の専門家によるブラインド採点です。
「AI支援は専門性を高めるのか、それとも損なうのか?特許明細書作成における3か月間のフィールド実験からの証拠」と題し、 National Bureau of Economic Researchから公表した論文で、私たちは、専門知識集約度が極めて高い知的財産法の分野でAIの使用に起因して生じる短期的な生産性と長期的なスキル形成の両方の変化を捉えるために用いた現地実験について述べています。実験では、当時未発表だった Google Labs のAI特許作成アシスタントツール(現在は Gemini Notebookの一部)へのアクセスを、Googleと常時かつ非独占的な取引を行う11の知的財産法務事務所に所属する133人の弁護士の間で無作為に割り当てました。各事務所の弁護士の3分の2(「処置」群)には早期にツールへのアクセスを与え、残り(「対照」群)にはAIの使い方に関する研修を一部実施したものの、3か月の研究期間が終わるまでツールの使用を認めませんでした。
AIによるより良い仕事
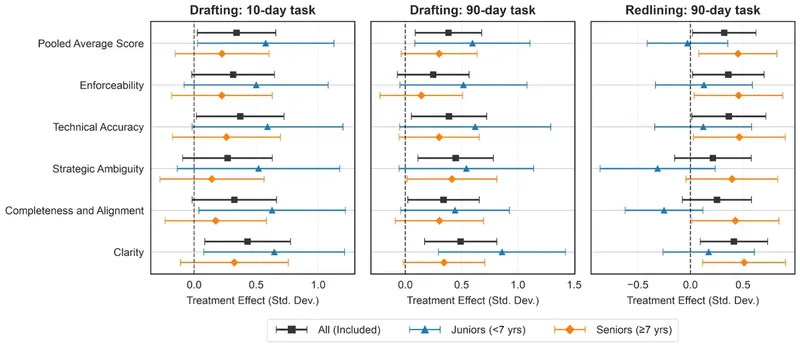
AI支援開始から10日後、参加したすべての弁護士に架空の発明に関する発明者資料一式を送り、特許を出案させました。90日後にも、別の模擬発明者資料一式で同じことを行いました。その結果、両時点の特許出案タスクで、期待どおりのAIによるパフォーマンス向上が見られました。10日目の時点で、AIツールへのアクセスにより出案スコア(独立した法律専門家が品質の5つの側面について リッカート尺度 を用いて採点したもの)は0.34標準偏差上昇し、これは対照群のスコア内でのパーセンタイル順位で10ポイントの上昇に相当しました。90日目までにこの改善は0.38 SDに拡大し、11パーセンタイルポイントの上昇を意味しました。これらの改善は、すべての品質次元で驚くほど一貫して生じました。注目すべきは、パフォーマンスの向上が低いスコアの頻度の減少と良好なスコアの頻度の増加によるものであり、優れたスコアの頻度には変化がなかったことです。形式的に言えば、AIアクセスを割り当てられた弁護士のスコアは下位から中下位・中位の五分位へと移動しましたが、際立って優れたスコアの数に目立った変化はありませんでした。このパターンは特に若手弁護士で顕著であり、その品質の向上は大幅な時間短縮(たとえば10日目のタスクでは、対照群の平均124分に対し18分速かった)にも裏付けられていました。
しかし、特許弁護士の仕事は特許の作成だけではありません。彼らは互いの仕事を見直し、法廷で特許を無効にしてしまい得る重大なミス(「特許プロファニティ」と呼ばれることもあります)をチェックします。例えば、発明の新規性や範囲を過大に主張してしまうことなどです。そこで、90日目にもう一つの課題を追加しました。この課題では、被験者に、実質的にも文体的にも多くの誤りを含む架空の既存特許の修正案(リドライン)を手作業でマークアップして修正することが求められました。このテスト課題は、より経験を積んだ弁護士が日常的に用いるプロフェッショナルな判断の一種を再現したものであり、まさにその種の判断ではAIに頼る余裕がないことがほとんどです。重要な点として、処置群の弁護士には作成課題で未公開AIツールやその他のAIツールの使用が推奨されましたが、リドライン課題でAIを使用することは誰にも許されず、この課題のスコアはスキルがどの程度発達したかを測る指標となりました。作成課題とリドライン課題のすべてについて、我々は第三者の特許専門家と協力し、提出物を5つの品質次元で採点しました:(1) 執行可能性、(2) 正確性、(3) 戦略的曖昧性(クレームの戦術的な範囲設定)、(4) 完全性、(5) 明確さ。
AIアクセスが特許作成およびリドラインの品質に与える影響の推定値。結果は全弁護士(黒い四角)、経験7年未満の若手弁護士(青い三角形)、経験7年以上のシニア弁護士(オレンジ色のひし形)について報告されています。すべての推定値は法律事務所間の差異を考慮し、弁護士ごとに受けた評価数のわずかなばらつきについても調整されています。
AIが取り除かれたとき
90日目のリドライン課題でAIアシスタントが取り除かれると、平準化効果は消えました。AIツールへのアクセスを与えられた弁護士は、この支援なしの課題で対照群を0.32 SD上回りました(パーセンタイル順位にして9ポイント相当の上昇)が、この効果は完全にシニア弁護士によるものであり、彼らは対照群の被験者を0.45 SD上回り(13ポイントの上昇)、一方、若手には目に見える改善は認められませんでした。それどころか、若手のスコアは二極化しました。非常に低いスコアが増え、中程度のスコアが減り、良いスコアは増えたものの、優れたスコアは増えませんでした。
これらの結果は学習にとって何を意味するのでしょうか。AIツールへのアクセスを与えられたシニアは、過去3か月間のツール使用を通じて、プロフェッショナルな判断の面で明らかに大きな価値を獲得していました。しかし、若手レベルの状況はより複雑です。スコアが向上した例もあり、AIが学習を飛躍的に加速できる可能性を示唆しています。一方で、他のスコアは分布の下位に広がっており、シナリオによってはAIが若手の十分な仕事の達成を助けるものの、機械の支援による高いパフォーマンスは、シニアの専門家を際立って価値あるものにする専門知識のより速い獲得にはつながらないことを示しています。
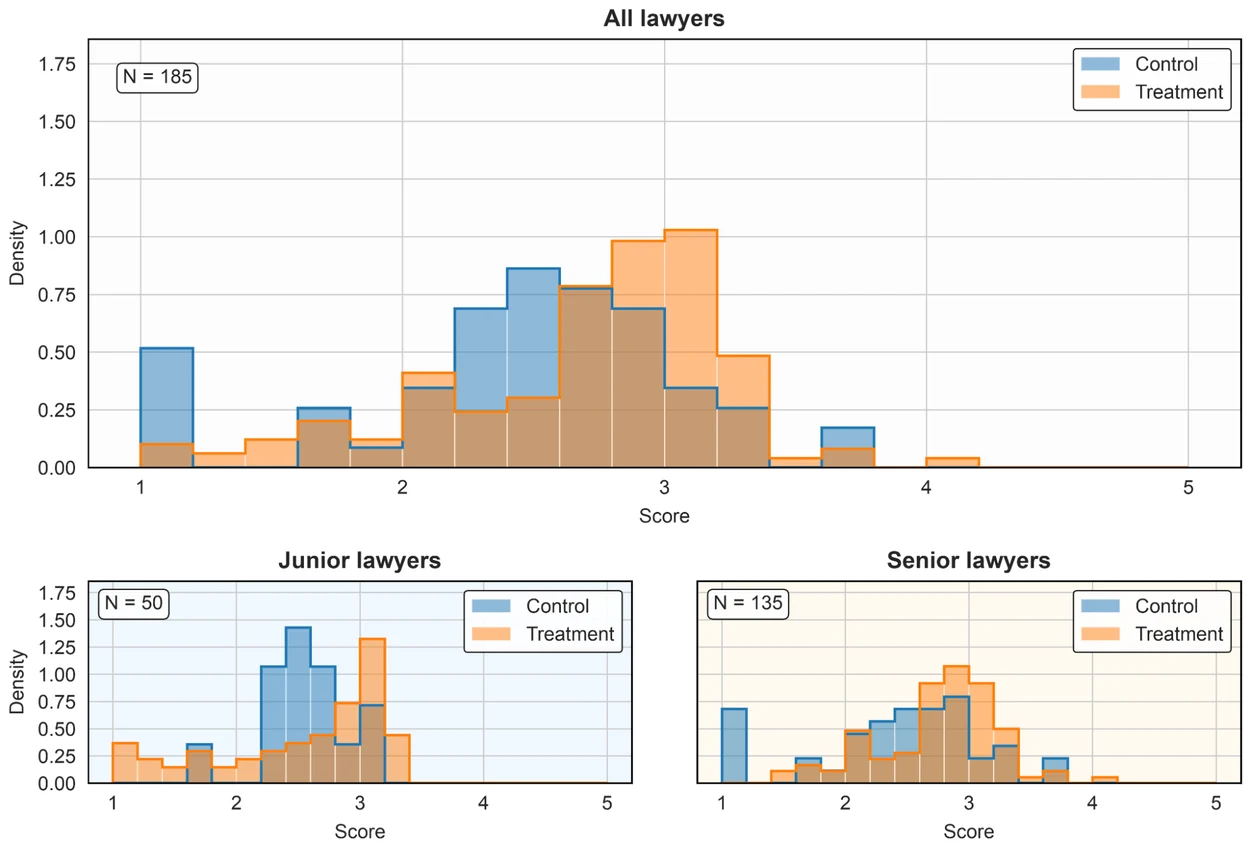
全弁護士、経験7年未満の若手弁護士、経験7年以上のシニア弁護士について、経験別に見た処置群(オレンジ)と対照群(青) 経験年数別の被験者、対象はすべての弁護士、経験7年未満の若手弁護士、経験7年以上のベテラン弁護士。観測値は、品質の全次元にわたって平均化された個別の評価です。
質的な編集パターンを調べることで、異なる経験レベルの専門家が生成AIツールにどう向き合っているかについて、いくつかの洞察が得られます。処置群と対照群の両方を通じて、若手の提出物は硬直した形式主義に従っていました。若手は上から下へ順番に作業を進め、本編の特許クレームに到達する前に、リスクの低い導入部分のコピーエディットに時間を費やしがちでした。若手はまた、商業的な範囲の改善よりも、表層的な類語の言い換えに焦点を当てていました。重大な欠陥に気づいた場合でも、修正のリドラインを実行するのではなく、欠陥を診断する説明的なコメントを残すだけのことがよくありました。この「診断するが実行しない」という姿勢は支援なしの対照群の若手にも同様に見られたため、これは3か月間AIに書き換えの実行を頼っても解消されなかった、若手の基本的な弱点を表しています。
対照的に、シニア弁護士はAIへの露出から一貫して恩恵を受けました。処置群のシニアは若手よりもリドラインに長い時間をかけ、リスクの低い文章を飛ばしてクレームを一から再構築し、意図せず法的権利を狭めたり保護範囲を制限したりしうる文言を取り除き、多くの編集に明示的な法理を対応させていました。フォローアップインタビューでは、シニアはAIの出力を完成品としてではなく「ロジック監査人」として扱っていたと語りました。それは既存の文章への愛着を弱め、構造的な編集の「なぜ」と「どのように」を言語化することを強制し、彼らの基礎的な専門知識を活性化し、研ぎ澄ましていました。
さらなる方向性
パフォーマンスの向上と、永続的なプロフェッショナルな判断力の構築は、異なる目標です。特に若手の専門家にとっては、これらは互いに緊張関係にあるかもしれません。基礎的な専門知識こそが、AI支援による繰り返しが、キャリアを通じて熟練したプロフェッショナルな判断へと転化することを可能にする、失われたリンクなのかもしれません。モデルの能力が進歩しても、そのような判断は今後も重要であり続けるでしょう。弁護士は裁判官、クライアント、同僚とのやり取りにおいて、引き続き自身の判断を用いることになります。すべての状況でAIツールに頼ることはできません。このAIの瞬間における重要な課題は、今日より良い仕事を生み出すために設計されたツールが、明日必要とされる専門家への若手専門家の成長を妨げないようにすることです。
勤務環境にある専門職を研究することは、研究者にとって難題です。私たちの実験には限られた数の特許弁護士しか含まれていませんが、これは当該分野のトップ層専門家の高い時間請求レートを反映しています。私たちが彼らを観察したのはわずか3か月間であり、 durable な専門性を身につけるのに必要な年数と比べれば短い期間です。さらに、過去1年間でのモデル能力とAIへの基礎的な習熟度の両方の急速な進歩(および法務分野におけるAI対応製品の浸透)により、今この試験を再実行すれば結果に影響が出る可能性があります。これらの限界は今後の研究の機会をもたらすものであり、その一部は今後数か月以内に取り組みたいと考えています。それでもなお、私たちの研究から明らかな教訓は、AI支援が専門的スキルに与える影響を理解するには、ツールの使用による効果とユーザーの支援なしのパフォーマンスによる効果を分離するテストが必要だということです。
謝辞
共著者のJosh Martin、Zanna Iscenko、Scott Strand、David Pearl、Melissa Ferereの皆さんに心からの感謝を申し上げます。また、James Manyika、Ruth Porat、Kent Walker、Josh Woodward、Anu Madgavkar、Daniel Rock、Fabien Curto Milletの皆さんには ご指導とご支援を、Tom Shane、Mauricio Carneiro、Johnny Jacobs、Victor Lavrenko、Yinghao Sun、Samuel Yang、Daniel Nishi、Eric Wang、Kevin Li、Hao Zheng、Franz OchをはじめとするGoogle Labsの皆さんには実験での協力を、Kiera Russellさんには製品アクセスとテスター支援を、Steve GongさんとTaylor Montgomeryさんには法務面での指導とリクルート支援を、さらにKerry McHugh、Zoe Ortiz、Emily Short、Joseph Mack、Esmeralda Cardenas、Leanne Trujilloをはじめとする広報、マーケティング、Research Blogのパートナーの皆さんにはローンチの推進に感謝いたします。