
AIファクトリーがメガワット規模からギガワット規模へと成長するにつれ、その構築には先進的なコンピューティングだけでは足りなくなっています。オープン標準は、業界がAIインフラをより速く、より効率的に、より信頼性高くスケールさせる助けとなっています。
San Jose McEnery Convention Centerで開催されているOpen Compute Project(OCP)Global Summitにおいて、NVIDIAは、次世代AIインフラの共通の基盤を作り出すことを目的とした新しいパートナーシップとコントリビューションを発表しました。
NVIDIAは主要な NVIDIA Vera Rubin ラックおよびコンピュートトレイの設計を、オープンな NVIDIA MGX アーキテクチャを通じてOCPにコントリビュートし、システムビルダーに次世代AIファクトリーインフラを開発するための共通の基盤を提供しました。
これらの取り組みは、AIファクトリーそのもの、それに電力を供給する公共電力網、そして現代のアクセラレーテッドコンピューティングの中心にあるラックスケールアーキテクチャに及びます。
NVIDIAとパートナー、オープンアーキテクチャの進展を発表
OCPイベントで、NVIDIAとパートナーは以下の発表を行いました。
- NVIDIAとハイパースケーラーは、AIファクトリー設計標準や電力網のレジリエンスを含む、次世代AIファクトリーのオープン標準を公開しました。
- NVIDIAは、NVIDIA DSX AI Factory向けの新しいオープンソースソフトウェアコンポーネントを公開しました。
- MetaとNVIDIAは、NVIDIA Spectrum-X Ethernet SuperNICとSpectrum-6のイノベーションにより、オープンなAIネットワーキングを前進させました。
- Visionbayは、Vera Rubinの時代に向けた800V DCのAIファクトリー設計を発表しました。
- NVIDIAとCiscoは、400Gb/sベースのネットワーキングファブリック向けとして業界初のモジュールとなるUltra-Dense Small Form Factor Pluggable(USFP)標準を発表しました。
- NVIDIAとGoogleは、将来のNVIDIA ConnectX-10 SuperNICおよびBlueField DPUにおけるFalcon Transportのサポートを発表しました。
満席の聴衆を前に、NVIDIAのハイパースケールおよびハイパフォーマンスコンピューティング担当バイスプレジデントであるIan Buckは、オープンインフラが世界中でAIファクトリーをスケールさせるための重要な要素になりつつあることについて語りました。
OCPでの ニュースは 、NVIDIAのエクストリームなコデザインがオープン標準と組み合わさることで、導入が加速され、電力効率が向上し、tokens-per-watt性能が高まっていることを浮き彫りにしています。
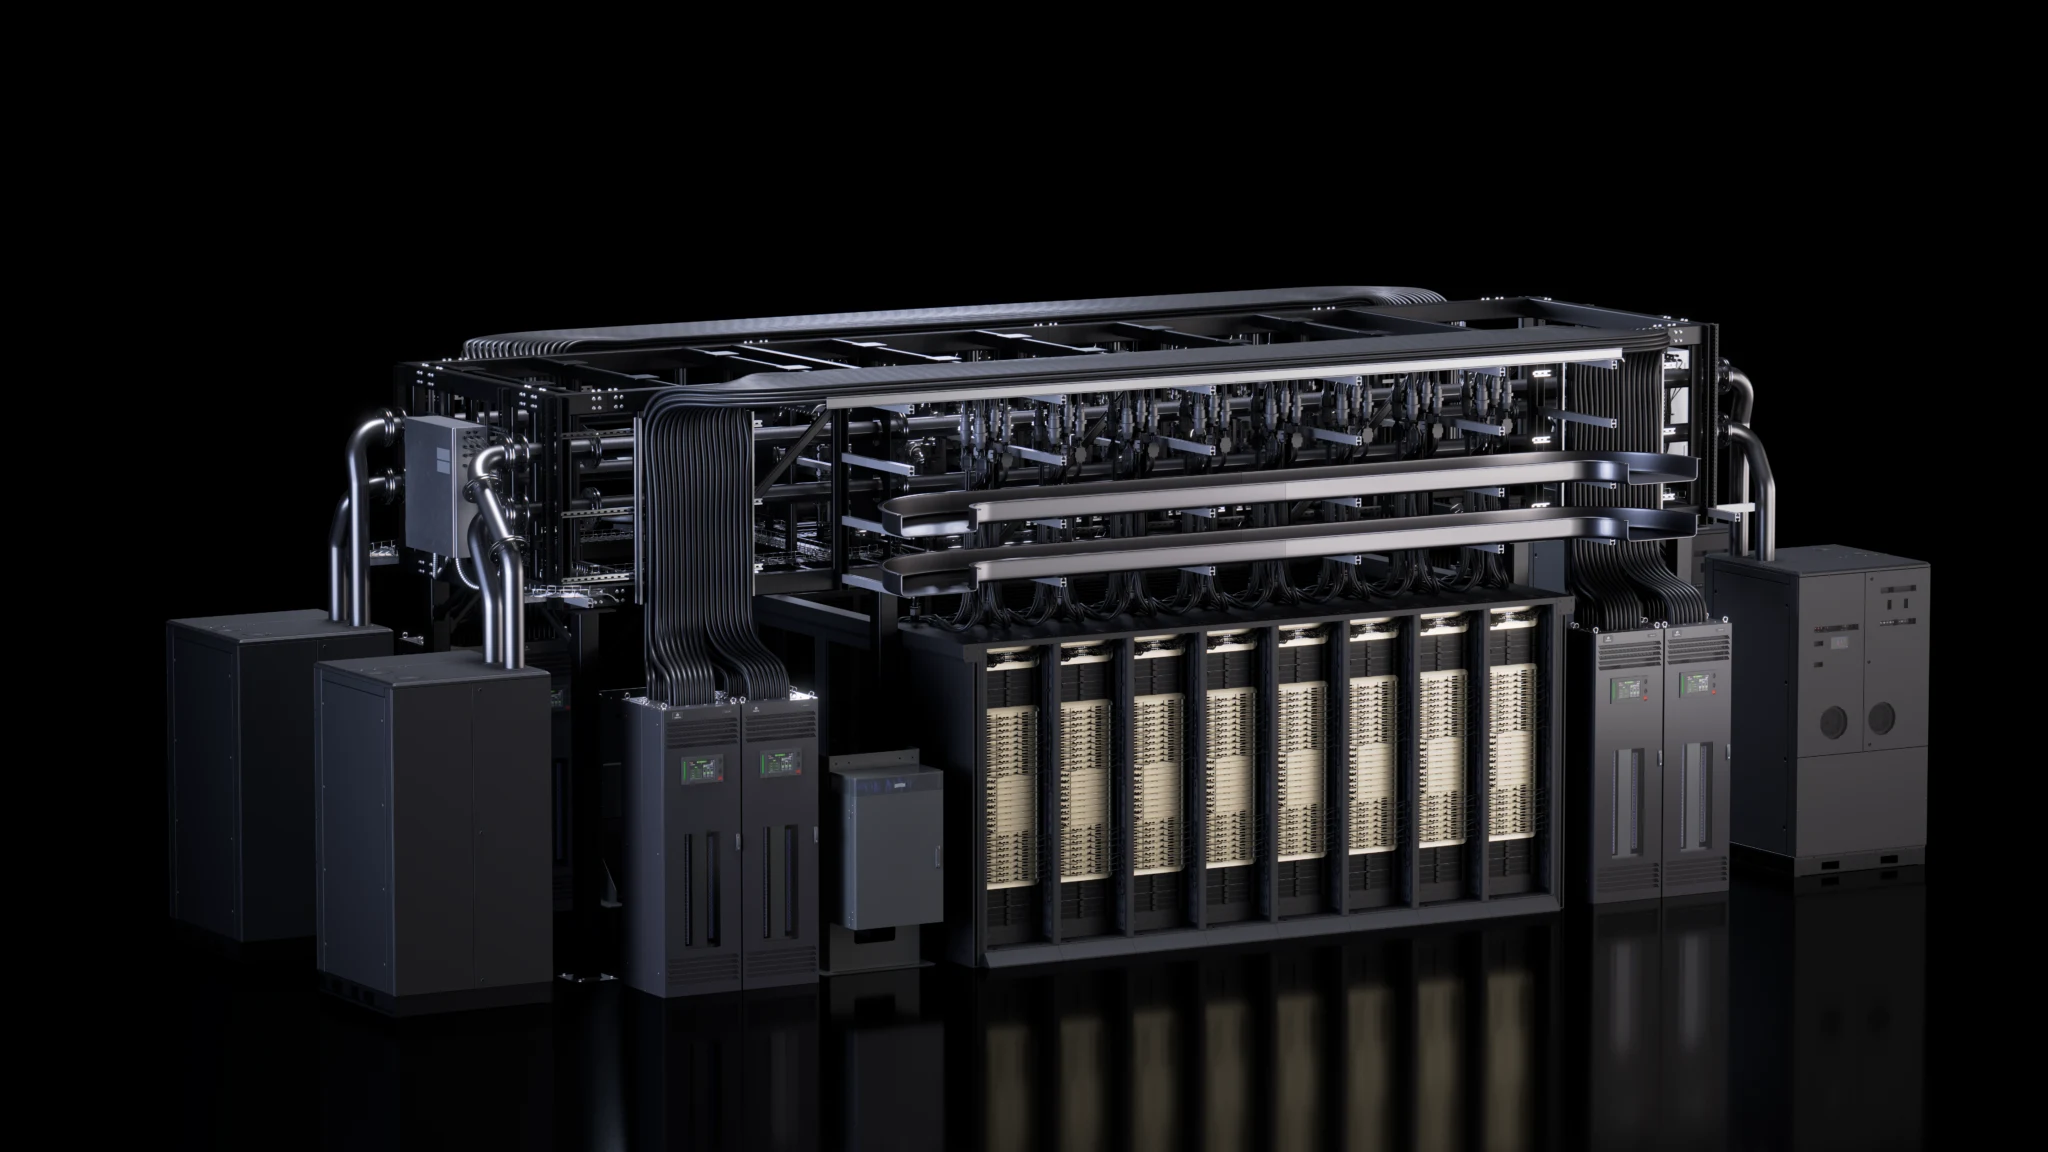
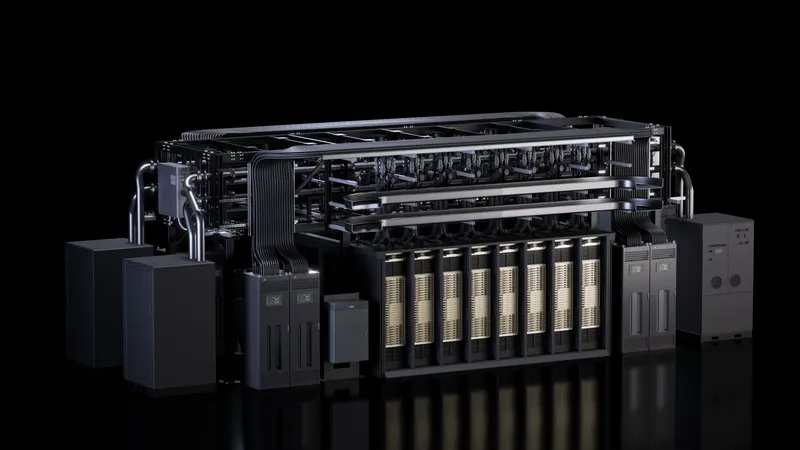
OCPにおけるMGXラックのコントリビューションでVera Rubin AIファクトリーが前進
NVIDIAは業界リーダーたちとともに、OCPのOpen DC Initiativeを通じて、第3世代MGX AIデータセンターリファレンス設計へのコントリビュートを行いました。
MQDやMQDBといったオープンな液冷技術と組み合わせることで、この取り組みは、実績あるAIファクトリー設計を、他社が採用、製造、スケールできる業界標準へと変える助けとなります。
NVIDIA Vera Rubin AIファクトリー向けに、更新されたMGX 1.2仕様は、ラックスケールのブラインドメイト液冷、相互運用可能なラックスケール相互接続インフラ、より高出力なAIシステム向けに設計された液冷式5,000Aのブスバーによって、AIファクトリー向けオープンアーキテクチャを拡張します。また、ネイティブの19インチ機器サポートと高密度ラック設計が追加されました。
MGX 1.2はさらに、構成可能なI/Oベイ、ファンレスの液冷コンピュートトレイ、標準化された電源および冷却インターフェースによりモジュール性を拡大し、エコシステムパートナーが相互運用可能なアクセラレーテッドコンピューティングプラットフォームを構築する助けとなる共通インフラを提供します。組み立て、テスト、サービスの時間を改善して製造およびフィールドサービスを合理化し、より速く効率的なインフラ構築を可能にします。このアーキテクチャは、メンテナンス性、導入、インフラの再利用を簡素化しながら、最大250kWのラック導入をサポートします。
Vera CPUラック設計仕様は、NVIDIA MGXオープンアーキテクチャをアクセラレーテッドコンピューティングの枠を超えて拡張し、拡大するエージェンティックAIの時代に向けた専用設計のプラットフォームを提供します。Vera Rubin NVL72が大規模な学習と推論の基盤として機能する一方で、 NVIDIA Vera CPU ラックは、ツール呼び出し、オーケストレーション、サンドボックス化された実行をサポートするよう設計されており、AIエージェントがアプリケーション、データ、サービスとリアルタイムにやり取りする助けとなります。
第3世代NVIDIA MGXラックアーキテクチャ上に構築されたVera CPUラックは、コンピュート、ネットワーキング、電源、冷却を共通のモジュラープラットフォームに統合する、同じラックスケール設計原則を共有しています。このアプローチにより、パートナーは共有エコシステム、簡素化された統合、次世代AIファクトリーのための一貫した基盤の利点を享受しながら、特化したインフラを導入することができます。
NVIDIA、DSX AIファクトリー向けの新しいオープンソースソフトウェアコンポーネントを発表
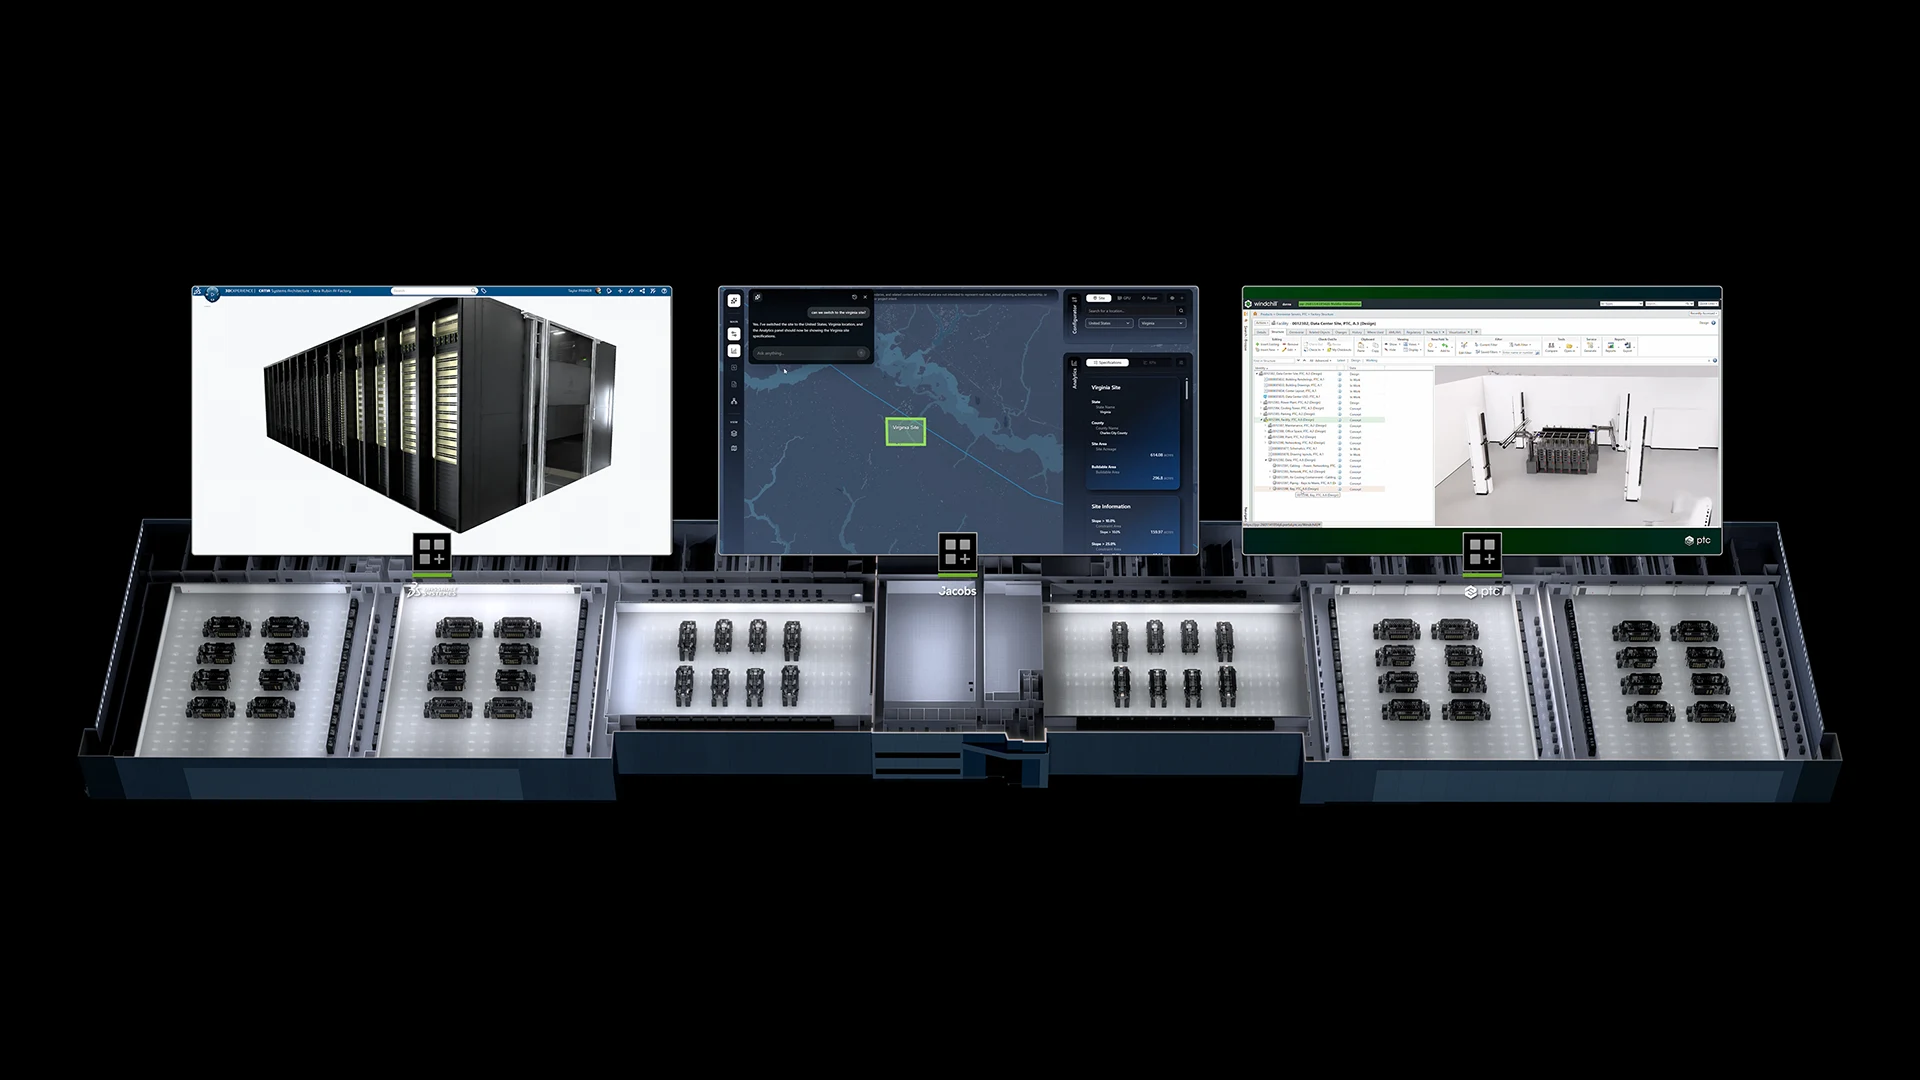
NVIDIA DSX AIファクトリープラットフォーム は、極限的なコデザインを適用してコンピューティング、ネットワーキング、電力、冷却、施設、ソフトウェアを統合し、AIファクトリーが単一の最適化されたシステムとして動作できるよう支援することで、利用可能なインフラ制約の中でAI出力を最大化します。この統合システムの中心にあるのがDSX OSであり、DSXアーキテクチャを大規模かつ協調的で再現性のある運用へと転換するオープンなオペレーティングレイヤーです。
OCPにおいて、NVIDIAはDSX OSを、ネットワークの構成、クラスタの検証、ラックの管理、ベアメタルのプロビジョニングのためのオープンソースコンポーネントで拡張しました。
- NVIDIA Config Manager:大規模なスイッチ構成を自動化し、顧客が最小限からゼロの手動介入で、一貫したAIファクトリーネットワークファブリックの展開、検証、保守を行えるようにします。
- NVIDIA Cluster Readiness Engine:実際のワークロードシミュレーションでGPUクラスタにストレステストを行い、トレーニング開始前にハードウェアの健全性を保証することで、高コストなジョブクラッシュの排除を支援します。
- NVIDIA Rack Management Service:ラックを第一級の単位として扱うラックハードウェア抽象化および運用ソリューションを提供し、AIファクトリースケールのファームウェア管理を改善します。
- Cluster API Provider for NVIDIA Infrastructure Controller:ベアメタルの展開とテナントのオンボーディングを加速し、生のAIハードウェアを数日ではなく数時間で本番対応のクラスタへと転換します。
NVIDIA DGX Cloudの運用経験から開発されたこれらのオープンソースコンポーネントにより、クラウドプロバイダーやソフトウェアパートナーは、AIファクトリー機能を自社のマルチテナントプラットフォームに直接統合できるようになります。
開発者は DSX AI Factory Githubページ にアクセスして、NVIDIA DSX AI Factoryプラットフォームの新規および既存のオープンソースソフトウェアコンポーネントを調べ、貢献することができます。
NVIDIAとハイパースケーラー、次世代AIファクトリーのためのオープン標準を公開
AIインフラを世界的にスケールさせるには、先進的なハードウェアだけでは不十分であり、業界全体がその上に構築できる共通の基盤が必要です。
OCPにおいて、NVIDIAはAMD、Google、Metaと共同で、その基盤を確立する新しいオープン仕様を公開しました。 Open Data Center Specification v0.7 は、電力アーキテクチャから冷却インフラ、物理レイアウトに至るまで、次世代AIファクトリー施設設計の統一された青写真を定義します。
Google、Meta、Microsoft、NVIDIAが公開した OCP Grid Resilience Specificationは、大規模AIインフラが電力網の乱乱時どのように振る舞うべきかを確立します。すなわち、接続を維持し、自動的に応答し、2秒未満でほぼフル負荷まで復旧することです。
これらの標準がオープンになったことで、世界中の製造業者には構築すべき共通のターゲットができました。機器メーカー、コロケーションプロバイダー、データセンターオペレーターは、個々の顧客からの独自仕様を待つことなく、世界中で建設中のAIファクトリーを支えるインフラレイヤーの設計、製造、提供を開始できます。
これらの仕様は NVIDIA DSXリファレンスデザインと互換性があり、施設レイアウトや電力アーキテクチャから、電力網のシグナルをリアルタイムで監視・応答するソフトウェアに至るまで、両仕様の検証済みで展開可能な実装を提供します。Vera Rubin AIファクトリーを構築するオペレーターにとって、オープンなコミュニティ標準から稼働中のシステムまでの直線的な道筋ができました。
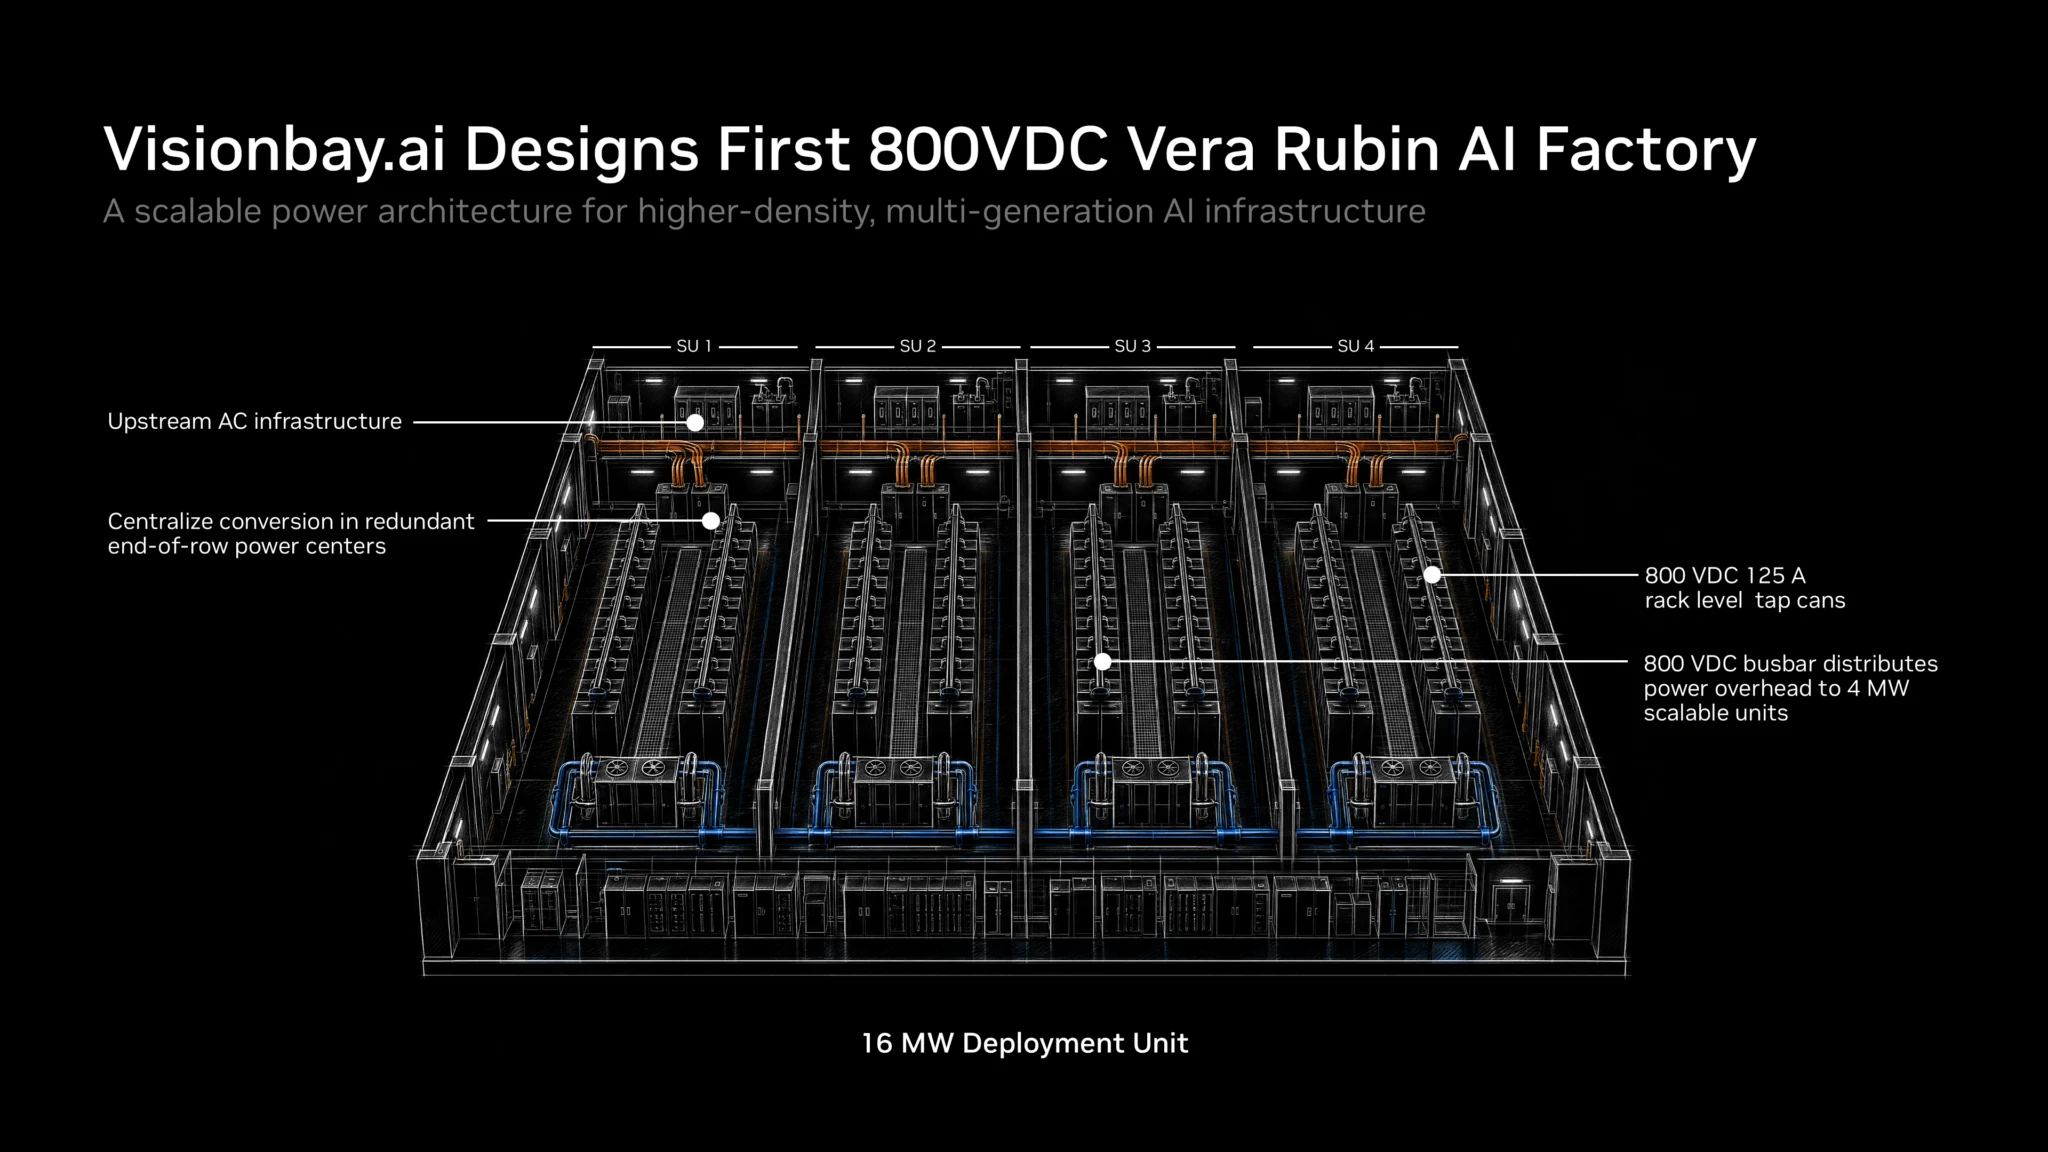
Visionbay.ai、Vera Rubin時代に向けた800VDC AIファクトリーを設計
AIファクトリーがより大規模で強力になるにつれ、すべてに共通する課題が立ち塞がります。それは、次世代のAIを推進するアクセラレーテッドコンピューティングシステムに十分な電力を供給することです。
OCPにおいて、VisionbayはK-1の計画を発表しました。これは、 800 VDCアーキテクチャ を中心に設計され、将来のNVIDIA Vera Rubin展開を念頭に置いて構築される次世代AIファクトリープラットフォームです。このプロジェクトは、NVIDIAの800 VDCリファレンスアーキテクチャとVertivの電力・熱技術を組み合わせ、高密度AIインフラのためのスケーラブルな基盤を生み出します。
この設計は、業界で高まりつつある課題に対応するものです。AIのトレーニング、推論、推論処理のワークロードが拡大するにつれ、ラックの電力密度は上昇し続けています。従来の低電圧電力配電はスケールさせることがますます困難になっており、より多くの銅、より多くの配線、より多くの電力変換装置が必要になります。
NVIDIAの800 VDCアーキテクチャを採用することで、K-1は既存の展開の柔軟性を保ちながら、より高密度なAIインフラストラクチャへの道を切り開きます。初日から完全に移行することを求めるのではなく、このプラットフォームは800 VDC配電が最大の効果をもたらす箇所から段階的に導入できるよう設計されており、大規模な施設の再設計を行わずに、事業者が次世代のアクセラレーテッドコンピューティングに備えることを支援します。
このアーキテクチャは、AC-DC変換を一元化し、800 VDCをコンピューティングリソースの近くまで配電するクラスタレベルの電力センターを中心に設計されています。このアプローチは下流の電力供給を簡素化し、モジュール式の拡張を支援し、将来のAIファクトリー成長のための再現可能な構成要素を生み出します。
K-1はまた、電力、冷却、コンピューティングが一体となって設計されるNVIDIA AIファクトリーの背後にあるシステムレベルの設計哲学を反映しています。液冷インフラストラクチャ、スケーラブルな電力配電、そして将来のVera Rubinクラスの展開に対応するこのプロジェクトは、エコシステムパートナーがNVIDIAのAIファクトリーアーキテクチャを、アクセラレーテッドコンピューティングの次の時代に向けて展開可能なインフラストラクチャへと具現化していることを示しています。
MetaとNVIDIA、Spectrum-6とマルチプレーン技術でAIネットワーキングを前進
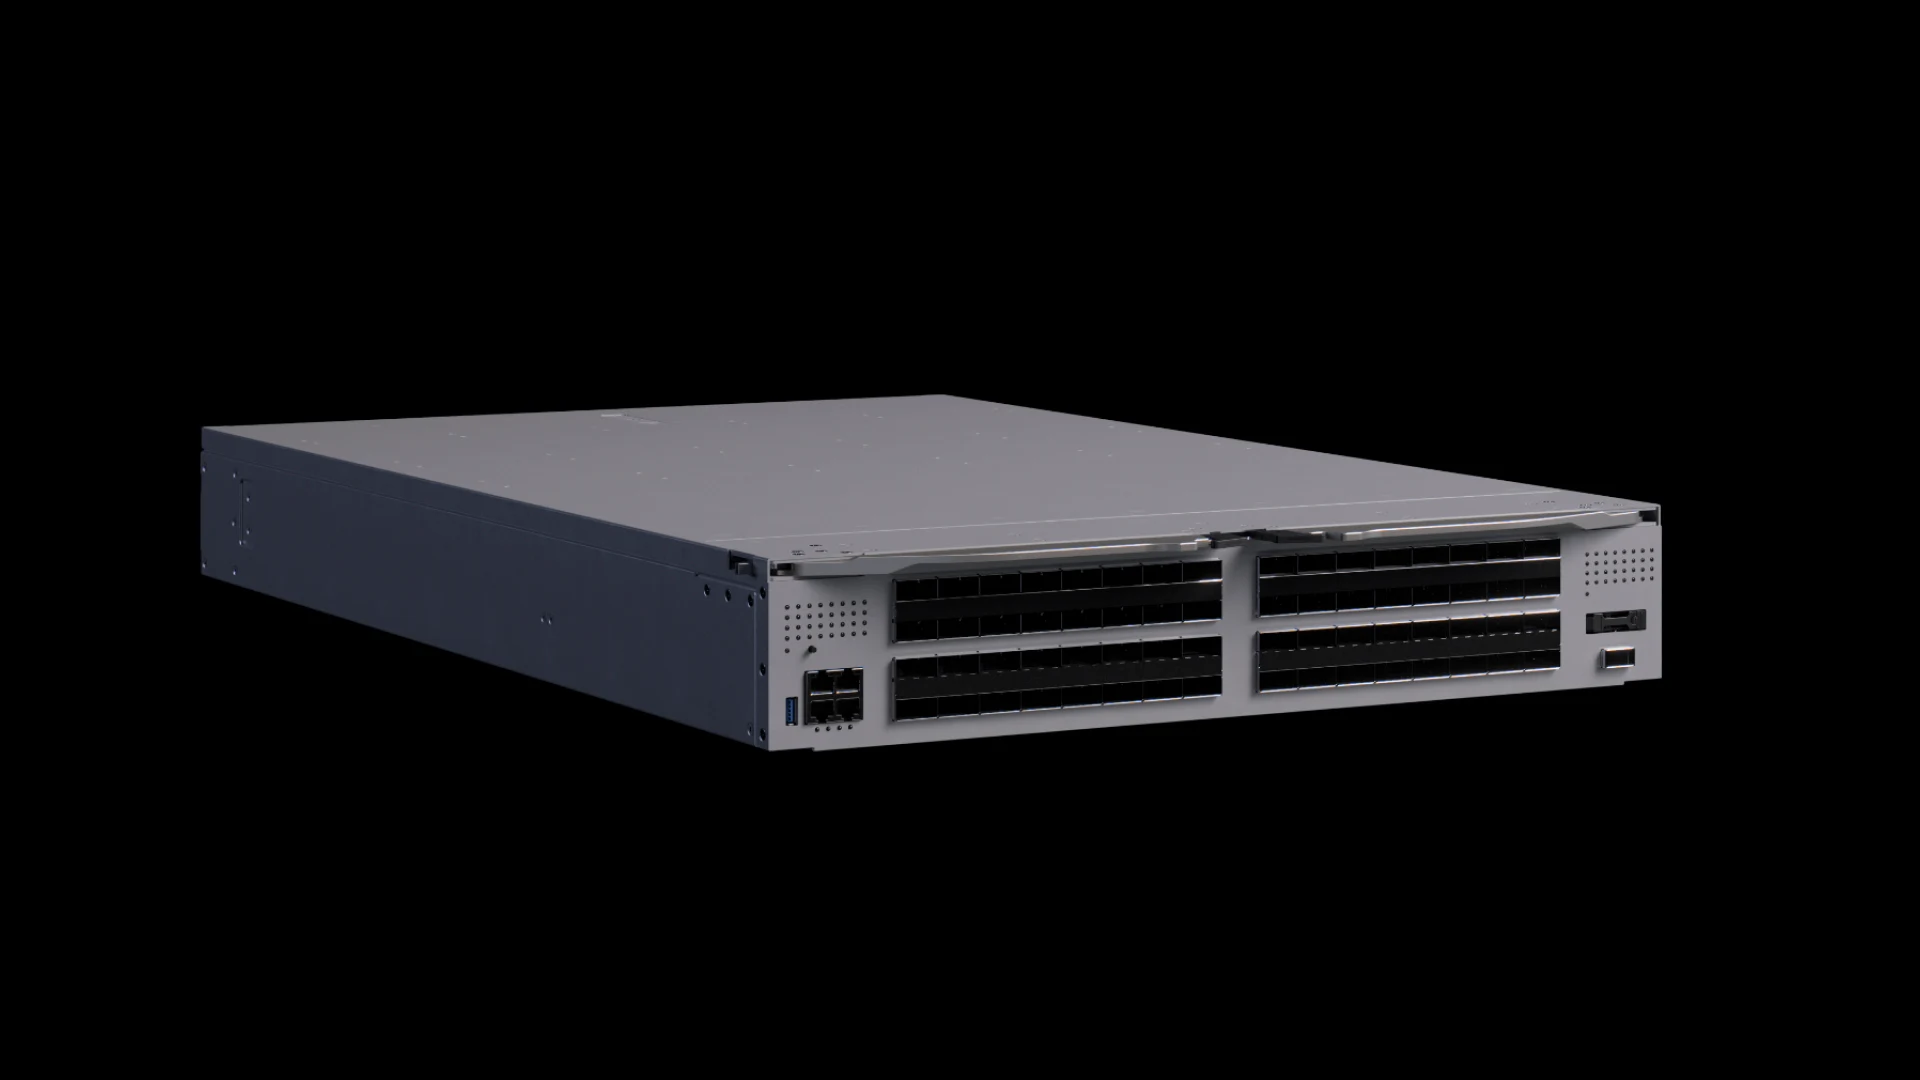
本イベントで、MetaとNVIDIAは、MetaがNVIDIA Spectrum-6 102.4Tb/sイーサネットスイッチを採用し、オープンネットワーキング上でより大規模で高性能なNVIDIA Vera Rubin AIファクトリーを構築することを発表しました。
Spectrum-6はSpectrum-4の2倍のスイッチング容量とレーンあたりの帯域幅を実現し、レーンあたり200GのロスレスイーサネットAIファブリックを提供します。高い実効帯域幅とパフォーマンス分離により、あるジョブのトラフィックが別のジョブを遅延させることがありません。
MetaのSpectrum-6ベースのスイッチ「N-IceCube」は、Metaの100T液冷ラック「IcePack」に搭載されます。N-IceCubeはFacebook Open Switching System(FBOSS)を実行します。これは、ハイパースケールでの効率的なネットワーキングを支援するためOCPに寄贈された、Metaのオープンソースネットワークオペレーティングシステムです。
FBOSSは、NVIDIAが開発に協力したOCP標準であるSwitch Abstraction Interface上に構築されており、ベンダーに依存しないスイッチハードウェアの制御方法を提供します。これらの技術が組み合わさることで、100,000基を超えるGPUで構成される、大規模な mixture-of-experts モデルを訓練し推論するエージェントAIファクトリーが実現します。
この発表は、ハイパースケールでAIインフラを運用するMetaの経験とNVIDIAのネットワーキング技術を組み合わせた協業の次のステップを示すものです。
この協業の中核をなすのは、Spectrum-6スイッチとConnectX-9 SuperNICによって実現されるSpectrum-Xマルチプレーン技術です。マルチプレーンは、GPUトラフィックをハードウェア上で最大8つの独立したネットワークプレーンに分散させ、AIファクトリーがより少ないスイッチ階層と低いインフラコストで100,000基を超えるGPUへスケールできるようにします。GPU間の複数の経路はネットワークの利用効率と耐障害性を向上させます。コンポーネントに障害が発生した場合、トラフィックは残りのプレーンに移行し、帯域幅が低下してもGPUとAIアプリケーションは稼働し続けます。
MetaとNVIDIAは、展開の経験と迅速なエンジニアリングの反復を通じて、この耐障害性の強化に共同で取り組みました。両チームはオンプレミス環境とクラウド環境の両方で改善を検証しました。
「マルチプレーンファブリックを運用面でスケーラブルかつ高性能にするためのNVIDIAとの緊密なパートナーシップに期待しています。これは当社自身のインフラ構築にとっても、共同クラウドパートナーにとっても重要な要件です。FBOSSをSpectrum ASICに拡張することで、当社のファブリック全体で同じソフトウェアスタックを実行でき、Metaの新しいSpectrumベースのスイッチであるN-IceCubeはそれをIcepack、すなわち当社のフリートにおける次世代アクセラレーターを接続するスケールアウト用の液冷102.4Tネットワークラックにもたらします」と、MetaのデータセンターおよびAIネットワーキング担当シニアディレクターOmar Baldonadoは述べました。
MetaとNVIDIAは、他のAIインフラ事業者が採用できるアーキテクチャと運用プレイブックを共同で開発しており、過酷な本番ワークロードから得られた教訓を、よりスケーラブルで耐障害性が高く効率的なAIファクトリーへと転換しています。
USFPにより、NVIDIAとCiscoがAIファクトリースケールに向けたプラガブルオプティクスを再発明
AIファクトリーがより大きなモデルと急増する推論需要に対応してスケールするにつれ、インフラスタックのすべてのコンポーネント、ネットワーク接続そのものに至るまで、より高い性能、効率、シンプルさを実現しなければなりません。
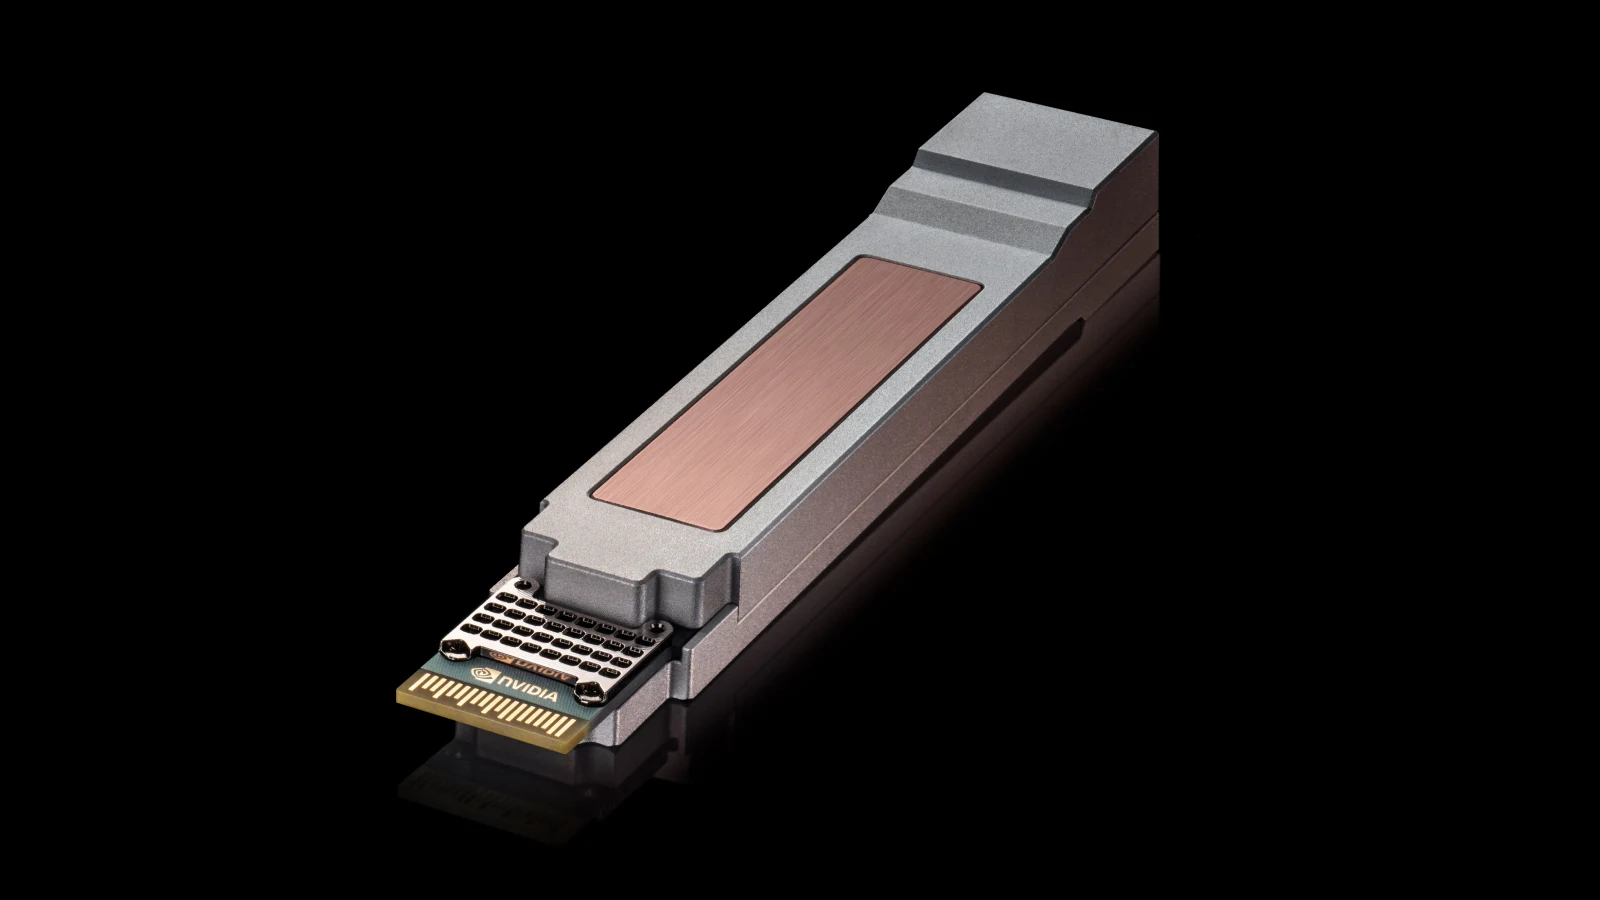
OCPにおいて、 NVIDIAとCiscoはUSFPに関する計画を発表しました USFPは、AIファクトリー構築者が次世代AIファブリックをスケールさせながら、帯域幅密度と電力効率を向上させることを支援するために設計された、新しい光プラガブルトランシーバーモジュールのフォームファクターです。
広く採用されているレーンあたり200Gb/sのOSFPフォームファクターとほぼ同じフットプリントでありながら、USFPはレーンあたり400Gb/sのネットワーキングへの道を提供し、数世代にわたるデータセンターネットワークで実証済みのトランシーバーベースの展開モデルを拡張します。16本の全二重レーンを搭載し、最大32レーンへの拡張を計画しているUSFPは、従来のレーンあたり200Gb/sのプラガブルオプティクスの4倍の帯域幅密度を実現します。
その結果、レイテンシ、電力消費、複雑さを増大させる可能性のあるネットワーク階層を追加することなく、より多くのコンピューティングリソースを接続できるようになります。
新しいフォームファクターは、次世代AIファクトリーの規模と効率に対する要求に対応するよう設計されており、より高い帯域幅のファブリックをサポートしながら、プラガブルオプティクスを現代のデータセンターの主流にしてきた柔軟性とメンテナンス性を維持します。また、約1.3倍の電力効率向上を実現し、事業者がより少ないエネルギーでより多くのデータを処理できるようにします。
オープンなエコシステムの推進を支援するため、NVIDIAとCiscoはTE ConnectivityおよびAmphenolと協業し、ケージ、コネクタ、モジュールを共同で開発します。両社は、コミュニティ主導のマルチソースの取り組みを通じてUSFPを前進させる計画です。これらの企業は、よりスケーラブルで効率的かつ相互運用可能なAIファクトリーネットワーキングの基盤を築いています。
Google Falcon Transport、NVIDIA ConnectX-10をサポートし相互運用可能なAIネットワーキングを実現
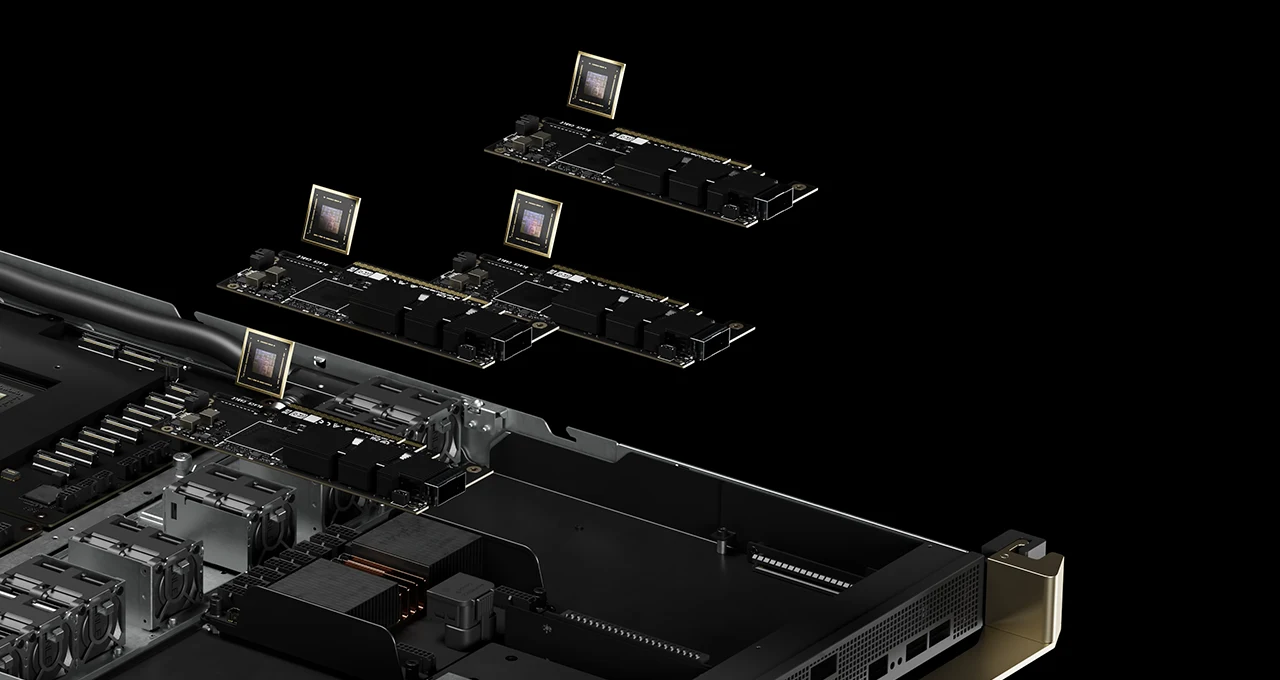
NVIDIAとGoogleはまた、将来のNVIDIA ConnectX-10 SuperNICおよびBlueField DPUにおけるFalcon Transportのサポートも発表しました。これにより、大規模AIインフラのネットワーク効率の向上が実現します。
Falconは、Ethernetネットワーク上でデータを確実に配信するために設計されたトランスポートプロトコルです。Ethernetネットワークは輻輳時にパケットをドロップすることがあります。Falconは、マルチパス負荷分散、プログラマブルな輻輳制御、ハードウェアによるパケットロス回復、接続ごとのセキュリティを通じて、AIおよびストレージのワークロードをサポートします。
この協業では、NVIDIAのハードウェアアクセラレーションとDOCAソフトウェアを組み合わせてFalconを実装し、NVIDIAのネットワーキングをGoogleのデータセンタートランスポートへと拡張します。NVIDIAとGoogleのNICは共通のトランスポートを介して通信でき、アプリケーションは標準のRDMAプログラミングインターフェースを維持できます。
トラフィックを複数のパスに分散させ、輻輳に適応し、ドロップしたパケットを回復し、接続を保護することで、Falconはワークロードが利用可能な帯域幅をより有効に活用し、Ethernetファブリックが拡張しても予測可能なパフォーマンスを維持できるよう支援します。
参加して詳しく知る OCPでのNVIDIA.