
夢瑶 凹非寺にて
量子位 | 公式アカウント QbitAI
なんと、バイトダンスは今度、AI生成をオープンワールドにしてしまった?!
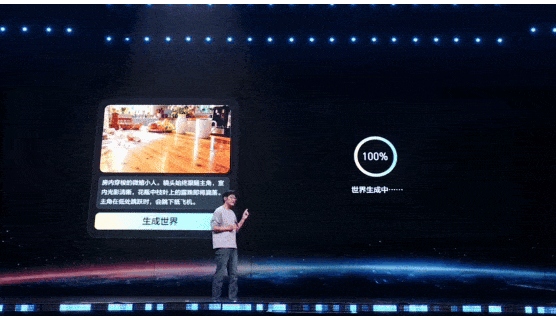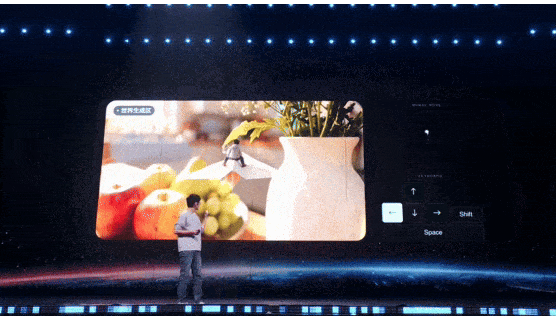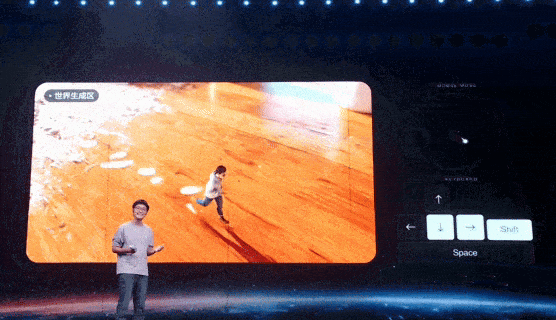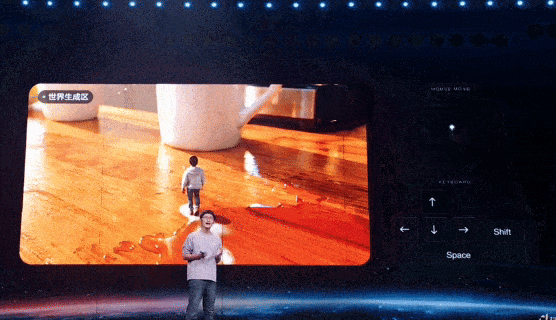
ごらんください、一文を入力するだけで、AIがミニチュア人形視点の部屋をまるで無からroll outしてくれます~
続けて、キーボードとマウスで猛スピード操作すれば、紙飛行機に乗ってサイバー世界を自由飛行でき、行きたいところへどこへでも行けます:
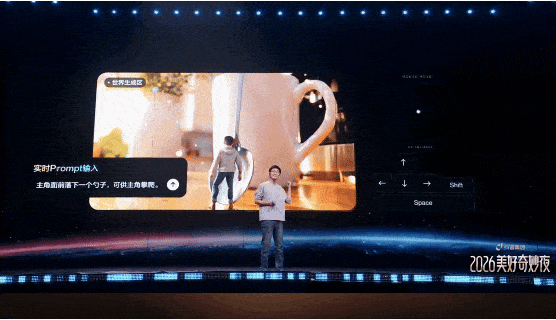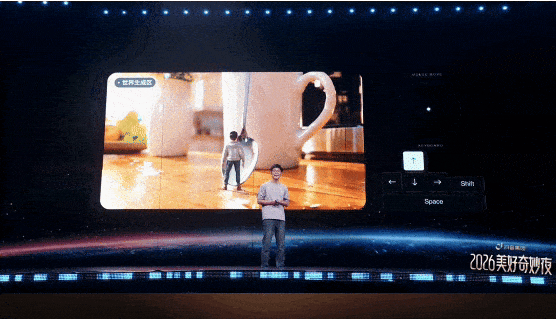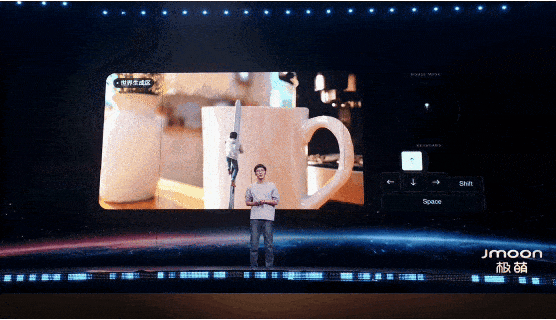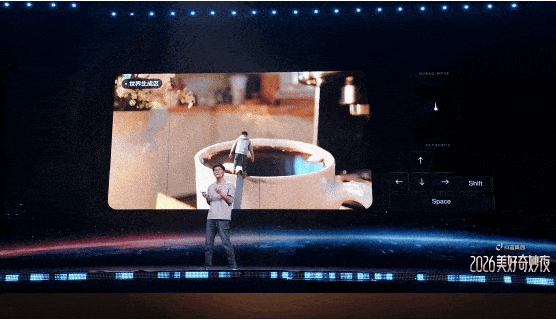
これで終わりではありません。このAI生成の世界では、目の前のものさえその場で創り出せます!
スプーンが欲しい?無からスッと作り出せるうえ、さらに…
スプーンとインタラクションすることもでき、日常の食器を本格クライミング会場に変えてしまうのです——
もちろん、この世界にできることはそれだけではありません。
「どこでもドア」機能のおかげで、まったく無関係な二つのシーンも直接つながります。
一秒前は部屋の中にいたのに、次の瞬間ドアを開けたら外宇宙に飛び出してしまう?!
こんな幻想的な光景が登場したのは、先ほど終了したばかりの抖音集団《2026 美好奇妙夜》のテクノロジーショーのステージで、デモを行ったのは影視颶風のTimでした。
さらに特筆すべきは、この一連のサイバー造物とも言える操作の裏には、バイトダンスがひそかに研究開発を続けてきた世界モデルがあるという点です。(衝撃.jpg)
モデルはまだ正式リリースされていませんが、現場でのデモからは、すでに三次元シーン生成、自由探索、リアルタイムインタラクション、物体編集、さらには異なる空間の間での自由なつながりを実現する能力~
今回、バイト(ByteDance)は番組の生デモを通じて、自社の世界モデルを思いがけず「初お披露目」させ、まさに前もって筋肉を見せつけた形となった。
こうして振り返ると感慨深いが、ここ数年、李飛飛が創業したWorld Labsをはじめ、Google DeepMindのGenie、さらにNVIDIAのCosmosへと。
大手テック企業も次々と参戦し、AIによる空間構造のより深い理解や現実の法則のシミュレーション、さらには人の行動に応じて環境がどう変化するかの予測を実現しようとしている。
今、AIはSF映画の中の世界を現実に作り出しつつある。
ひとつの世界を描くことから、世界全体を「生き」させるところへ
恐らく、初期にAIGCを遊び始めた人たちも予想していなかったのだろう——
いつの日か、AIが生成した動画が、中に歩いて入れて、インタラクションでき、しかも柔軟に編集できるサイバー三次元世界に変わるなんて。
少し数えてみると、年明けから現在までに私が実際に体験した世界モデル製品も、およそ六、七個にのぼる。。。
その衝撃は、前日まで『インターステラー』を見ていたのに、翌日には自分がスクリーンの中に歩いて入れて、ついでにブラックホールを自宅のリビングに持ち込める、といったレベルだ。
では、AIはどうやって画像・動画生成から、スムーズに「転職」して世界を作れるようになったのか?!
この話は、従来のマルチモーダル生成の技術的な弱点の話から始めなければならない。(doge)
現在、世界モデルは複数の技術ルートに派生しており、抽象的な状態予測、物理的因果モデリングから、生成型の三次元世界まで、それぞれに重点が異なる。
ここで取り上げるのは主に、マルチモーダル生成や空間知能に関わる次のルートである:
AIに現実世界の空間構造と変化の法則を学習させ、持続的に探索でき、リアルタイムにインタラクションできる三次元世界を生成・再構築・シミュレーションさせるというものだ。
ここで強調しておきたいのが、次の二つのキーワードだ:空間構造そして変化の法則。
そして、この2つの能力は、まさに過去数年間、視覚生成技術が完全には解決できていなかった基礎的な難題に的確に迫るものだった。
△AI生成
2024年、OpenAIがSoraを発表し、その驚異的な生成動画はネット中がサム・アルトマンとともに驚きのあまりめまいがしてへたり込むほどの衝撃を与えた。
しかし当時画面を埋め尽くしたあの動画たちに比べると、OpenAIが同時期に公開した技術報告書のほうが、今日振り返ってみるとむしろ味わい深い——
「Video generation models as world simulators」(映像生成モデルは世界シミュレータとして)、直訳するとこうなる。「世界シミュレーターとしての動画生成モデル」。
その頃OpenAIは、動画生成モデルの規模が拡大するにつれ、モデルが一定の三次元一貫性や物体の永続性を創発し始め、さらには簡単な環境インタラクションをシミュレートできるようになったことを発見した。
だが厄介なのは、リアルな世界の画面を生成できるモデルであっても、最も基本的な「物理的関係性」すら処理できない可能性があることだ。
例えばSoraは人がランニングマシン上を走っている映像を生成でき、人物、光と影、カメラワークまで、いかにもそれらしく見える。
しかしよく見ると、人物の動きとランニングマシンの動きの関係は、現実の物理法則に必ずしも合っていない。映像はとてもリアルなのに、物理法則はちょっと運まかせ??
△画像出典:OpenAI公式サイト
その背景には、実は従来の視覚生成技術の非常に根本的な問題が露呈している。
過去数年間、拡散モデルであれTransformerベースの生成アーキテクチャであれ、主流の画像・動画モデルは主として膨大な視覚データから学習したものに依存してきた。統計的法則、入力条件に合致した画像を生成するために使用されます。
この手法は非常に成功しており、すでに一部の三次元幾何、物体の関係、物理法則を暗黙的に学習できるほどになっています。
しかし視覚的な時空の連続性は、必ずしも安定した、外部の働きかけによる介入が可能な世界の状態に対応するとは限らない。——
例えば、ビデオ内でコップの外観を一貫して保たせることは、現在の生成モデルにとってはすでに比較的容易になっています。
しかし、それが持ち上げられたり、置かれたり、さらには机から突き落とされたりする際、モデルは空間的な位置、物体間の関係、状態の変化を継続的に追跡し、衝突や落下などの物理的な結果を予測しなければならない。
つまり、物理的直観に合致する動画を生成することから、動作が引き起こす環境の変化を確実に予測することまでの間には、世界状態のモデリングという課題が横たわっている。
そして、これこそまさに世界モデルが得意とするところだ。
今年6月、李飛飛(Fei-Fei Li)チームは『A Functional Taxonomy of World Models』という論文を発表した。
この記事は機能の観点から世界モデルを3つのタイプに分類しており、世界モデルがどのような「真の実力」を持っているのかについても、より明確な解釈を与えている——
- レンダラー: ワールドを担当〜のように見える人間向けの映像を出力するもので、核心の目標は画面のリアルさと視覚的表现力です。
- シミュレーター:世界を担当実際上でどのような样子になるかを維持し、幾何や物理的因果に適合するシーン状態を維持する。
- プランナー:エージェントの次にどう行動すべきかを担当する現在の世界状態と既定の目標に基づいて、合理的な行動を出力する。
この分類の興味深いところは、AIがすでに本物と見分けがつかない動画を生成できるのに、なぜ私たちがこれほど手間をかけて世界モデルを研究し続けなければならないのか、その理由をちょうど説明している点にある。
リアルな視覚映像の生成から、物理法則に適合する環境状態の維持、そしてエージェントによる自律的な意思決定と行動の支援に至るまで——
その背後にある空間表現、動的予測、行動計画の能力こそ、従来のマルチモーダル生成モデルがまだ十分に解決できていない技術的課題なのである。
そして今、論文の中のこれら一見手の届かなさそうな世界モデルの構想が、AIによって少しずつ「作り出され」始めている。
△画像出典:《A Functional Taxonomy of World Models》記事
例として挙げるのが、抖音集団(Douyin Group)の《2026 美好奇妙夜》というテック番組で、字節(ByteDance)のAIモデルによって実現されたサイバー的ないわば「造物」の操作だ。
たった一言で映像を生成するだけなら、今日ではもはや珍しいことではない。
しかし、人が実際にそのAI生成シーンの中に足を踏み入れて自由に移動できるとなると、モデルが処理すべき内容は、目の前の一枚の映像を生成することから、シーン全体の空間構造を維持することへと拡大する。
人がどの方向に移動しようと、どの角度から観察しようと、シーン内の地形や物体、そしてその相対的な位置関係は、十分な幾何学的一貫性を保つ必要がある。
この背景にあるのは、世界モデルの空間表現能力であり、AIが生成したシーンが繰り返しの探索に本当に耐えうるための基盤でもある。
スプーンが欲しいと言えば、AIがそれを無から生成し、さらにはスプーンを伝って這い進むといったリアルタイムのアクションインタラクションまで実現できる。
一見シンプルな数ステップの操作の裏には、世界モデルの即時生成、環境状態モデリングと動的予測能力——
が関わっている。モデルはユーザーの操作に応じて、シーン内の物体や空間関係をリアルタイムで更新し、アクションが引き起こす環境の変化を予測し続け、前後の状態の一貫性を保たなければならない。
さらに、空間そのものも手軽に改造でき、「どこでもドア」を描けば、現実の部屋と宇宙空間を直接つなぐことができる。
ここまでくると、世界モデルの能力はさらに一つの段階へと拡張される——三次元シーン再構築、空間の制御可能な編集、そしてシーン間の連続性モデリングである。
モデルは元のシーンの空間構造を保持しながら、異なるシーン間の幾何学的関係を動的に再構成し、シーンをまたぐ連続的な探索とリアルタイムインタラクションを支援できる。
空間構造の維持から、リアルタイムインタラクションへの応答、さらにシーン編集と空間間の再構成の支援まで、バイトダンスのAIモデルの能力が共に指し示すのは、世界モデルの核心的特徴でもある——
AIが生成するのはもはやコンテンツだけではなく、持続的に存在し、持続的に変化し、持続的にインタラクションできるデジタル世界を生成しているのだ。
ここ数年、大規模言語モデルはAIの言語と知識を処理する能力を拡大し続け、マルチモーダルモデルは生成能力を画像、音声、動画へと広げてきた。
そして今、世界モデルの発展に伴い、AIは空間構造、環境状態とその進化の法則をさらに探究し始めている。
生成的AIの技術発展もまた、画面がどれほどリアルかという段階から、生成された環境が持続的に存在し、インタラクションに応答し、さらには現実世界の動作をシミュレーションできるかへと進みつつある。
世界モデル、AIに仮想世界で「本物の実力」を磨かせる
もちろん、世界モデルが人間をサイバー世界であちこち探索させるだけなら、それは少々大げさに過ぎる使い方だろう。
より大きな産業の座標の中で見ると、世界モデルにはさらに想像力をかき立てられる価値がもう一つある——
機械に仮想世界で大規模な訓練と繰り返しの試行錯誤を行わせ、習得した能力を現実に移転させることだ。
なぜなら、ロボットや自動運転などの物理AIの発展は、長らく、実データの収集コストの高さ、試行錯誤のサイクルの長さ、そして危険で極端なシーンの再現の難しさといった現実的な制約に縛られてきたからだ。
世界モデルは新たな道を提供する:現実の環境を、生成可能で、制御可能で、繰り返し検証可能な仮想訓練場へと変換するのである。
希少な訓練データの生成から、複雑な環境のシミュレーション、行動戦略の検証まで、本来は実環境に依存していた訓練の一部が、仮想世界で完結できるようになる可能性がある。
これにより、世界モデルはコンテンツ生成からさらに物理AIの訓練と検証の段階へと拡張し、ロボットや自動運転などの分野における重要な技術的探究の方向となりつつある。
△AI生成
まず「訓練データ」について語ろう。
自動運転のような物理AIシステムにとって、重要な極端なシーンであればあるほど、訓練データは往々にして希少になる。
例えば突発的な事故や極端な天候などの低頻度・高リスクのシーンは、大量の走行距離をこなしても数回しか遭遇しないかもしれないが、世界モデルはまさにこうしたシーンを必要に応じて生成し、繰り返しシミュレーションすることができる。
抖音集団(Douyinグループ)の『2026 美好奇妙夜』の科学技術番組の会場で、彼らはまさにこうした自動運転のデモを展示した——
救急車が突然近づいてきたり、歩行者が道路を横断したり、交通警察官が現場で指揮をとったりする。
さまざまな複雑な道路交通状況がAI生成の仮想道路上に再現され、車両はその中で走行をシミュレーションし、突発的な状況に対応でき、さらにマルチカメラの再生で運転のパフォーマンスを分析することもできる。
従来は大量の実路テストによってしか蓄積できなかったロングテールシーンも、今や世界モデルによって大量に生成し、自動運転システムの繰り返しの訓練と検証に活用できるようになる可能性がある。
訓練データに加えて、世界モデルの産業的価値はもう一つの重要な側面にも表れている——物理AIの訓練と検証の効率向上である。
ご存知の通り、実物のロボットは訓練のたびに動作を実行し、フィードバックを待たなければならず、失敗した場合は手動でのリセットが必要になったり、ハードウェアの破損リスクを負うこともある。
しかし、これが三次元世界のこととなると、これまで多大な時間を要した試行錯誤のプロセスが、繰り返し可能で並列実行できるシミュレーション実験に変わる可能性がある。
今回の抖音集団(Douyin Group)の《2026 素晴らしき奇妙な夜》テクノロジー番組の現場で行われた家事ロボットのデモンストレーションは、同様の考え方を反映している。
AIが生成した仮想家庭環境の中で、ロボットは物を掴む、運ぶ、並べるといった家事操作を練習でき、絶えず変化する物体の位置や空間レイアウトに直面しながら、動作戦略を調整し、タスクの遂行に挑むこともできる。
操作に失敗した場合でも、仮想環境内で問題を素早く再現し、戦略を調整して、繰り返し訓練と検証を行うことができる。
現実で何度も操作し、手作業でリセットするやり方に比べ、世界モデルはロボットに、異なるシーンで並行して試行錯誤する機会を与えるより低いコストで、より速く、現実環境に対応する実力を身につけさせることができるのだ~
業界全体に目を向けると、テック大手たちはすでに異なる方向から、世界モデルの産業実装の探索を始めている。
今年3月、NVIDIAはCosmos世界モデルとIsaacシミュレーションプラットフォームを組み合わせ、ロボットが仮想環境でデータを生成し、繰り返し訓練できるようにした。
この産業向けシミュレーションソリューションは、ロボットの訓練から実際のデプロイまでのコストを大幅に引き下げる見込みだ。
△画像出典:NVIDIA公式サイト
さらに特筆すべきは、この加熱ムードが上流のチップ大手までも巻き込んだことだ。
先の9月には、AMDが82億ドルを投じて李飛飛のWorld Labsを買収すると発表した世界モデルの計算需要への先行布局を狙い、次世代チップの開発への道を敷くためである。
ロボットの仮想練習から、産業シミュレーション、そしてチップ大手の自らの参戦まで。
世界モデルの産業競争は、バリューチェーンに沿って次々と広がり、モデル能力や実際の応用から、次第に基盤の計算アーキテクチャへと深まっている。
世界モデルの世界規模の競争、中国プレイヤーの技術蓄積が成果を出し始めた
世界モデルの人気は本物だが、その熱狂の裏で、興味深い産業現象も次第に浮かび上がってきた。
海外内外のメーカーはいずれも、空間的に安定しリアルタイムで相互作用できる三次元世界の構築方法を探っているが、各社の技術蓄積、研究開発の重点、応用の道筋には大きな違いがある——
技術目標は次第に収束しつつあるが、実現の道筋は各社各様だ。
海外の例を挙げると、Google DeepMindのGenieや李飛飛のWorld Labsは、いずれも汎用世界シミュレーション能力の探索を進めており、空間構造、環境のダイナミクスモデリング、インタラクティブなシーン生成が重点となっている。
一方、NVIDIAのCosmosは物理AIの実需に近く、世界モデルをロボットシミュレーションや合成データ生成と組み合わせ、仮想訓練と現実の応用をつなぐことを試みている。
複数の路線にはそれぞれの重点があるが、最終的にはいずれも一つの目標を指し示している:AIが生成する仮想環境を、徐々に現実世界をシミュレーションできる能力を備えたものにすることだ。
では、国内に目を向けよう。
注目すべき強みとして、海外の汎用世界シミュレーション寄りの探索路線と比べ、国内メーカーは過去数年間に画像・動画生成分野で蓄積した技術力が、世界モデルに競争力のあるもう一つの進化の道筋を提供していることが挙げられる。
今年7月Seedance 2.5は1回の動画生成時間を30秒に拡張しただけでなく、マルチモーダル参照制御、カメラワーク、連続ナラティブ能力も強化した。
同期に発表された画像生成モデルSeedream 5.0 Proさらに、空間位置の理解、構造的一貫性、インタラクティブな精密編集を強化している。
ユーザーが画面上で位置を囲んだり、さらっと数筆描くだけで、モデルに指定領域への修正を行わせることができる。まさに「描いた場所を変える」のだ。
空間構造の一貫性から、長時間にわたる動的連続性、そして外部操作への精密な応答まで、いずれもインタラクティブな三次元世界の構築に欠かせない技術課題である。
ここ数年、中国企業が視覚生成と制御可能な編集で蓄積してきた技術が、いまや汎用世界モデルへの拡張の可能性を見せ始めている。
1895年、リュミエール兄弟は駅に驶込みましょう。いや、駅に滑り込む列車をスクリーンに映し出した。
当時の人々は、この新発明がその後の100年以上にわたり、世界を記録し表現する人類のあり方を根本的に変えることになると、想像するのは難かっただろう。
1世紀余り後、コンピュータグラフィックスやバーチャルリアリティ技術が相次いで登場し、人類は画面の中の世界を「観る」ことから、デジタル世界への没入型の体験と探索へと歩み始めた。
今日、世界モデルの登場により、100年以上にわたるこの技術の進化に新たな転機が訪れた——
機械が現実世界の空間構造と運行の法則を学び始め、継続的な探索やリアルタイムのインタラクション、さらには現実のシミュレーションにも使える仮想環境の生成に取り組んでいるのだ。
100年以上前、人類は映像で世界を記録することを学んだ。
100年以上後のいま、私たちは映像を、自ら足を踏み入れ、さらには現実を変えることさえできる世界にしようとしている。
100年以上が過ぎた今、私たちはついに、自らが創り出した映像の中へ足を踏み入れようとしている。