
リクエストのルーティング、エージェントのアクション選択、ポリシーの結果の割り当てを行うアプリケーションでは、自由形式のテキストではなく、固定された選択肢の集合に対するスコアが必要になることがよくあります。これらのディシジョンモデルを llama.cpp で Amazon SageMaker AI にデプロイすることで、CPU または GPU インフラストラクチャ上で量子化モデルを提供するためのマネージドな道筋が得られます。
この記事は、生成 AI 推論向けの特殊な AWS Deep Learning Containers (DLC) に関するシリーズの続編です。以前の記事では、 WhisperX, vLLM-Omni – パート 1vLLM-Omni – Part 1 vLLM-Omni – パート 2.
vLLM-Omni – Part 2 を取り上げました。 この記事では、まず InvokeEndpointllama.cpp 用 AWS DLC を使用して、SageMaker AI を通じて OpenAI 互換のチャット補完を提供します。次に、同じランタイムを SemIf(旧 OpenJev)で拡張します。SemIf は、回答トークンをデコードすることなく、宣言された選択肢に対する確率を返します。付属の、旧称 OpenJev、は回答トークンをデコードすることなく、宣言された選択肢に対する確率を返します。付属の には、CPU と GPU のデプロイオプションが含まれています。 ソリューションの概要
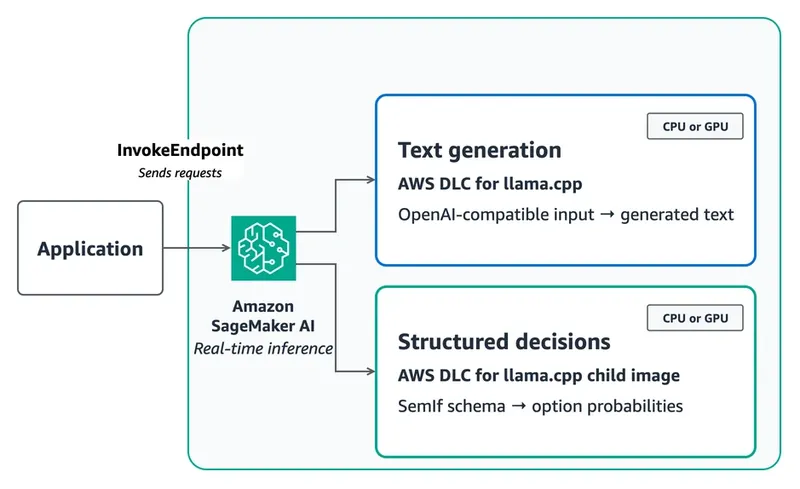
図 1 は、同じパッケージ化されたモデルからの 2 つのデプロイパスを示しています。テキスト生成パスは llama.cpp 用 AWS DLC を使用し、OpenAI 互換 API を通じて生成された応答を返します。構造化ディシジョンパスは、デフォルトのサーバーを SemIf アダプターに置き換える子イメージを構築し、宣言された選択肢の確率を返します。
図 1: ワークロードの API とレイテンシーの要件に応じて、llama.cpp 用 AWS DLC または SemIf 子イメージを CPU または GPU 上で実行する
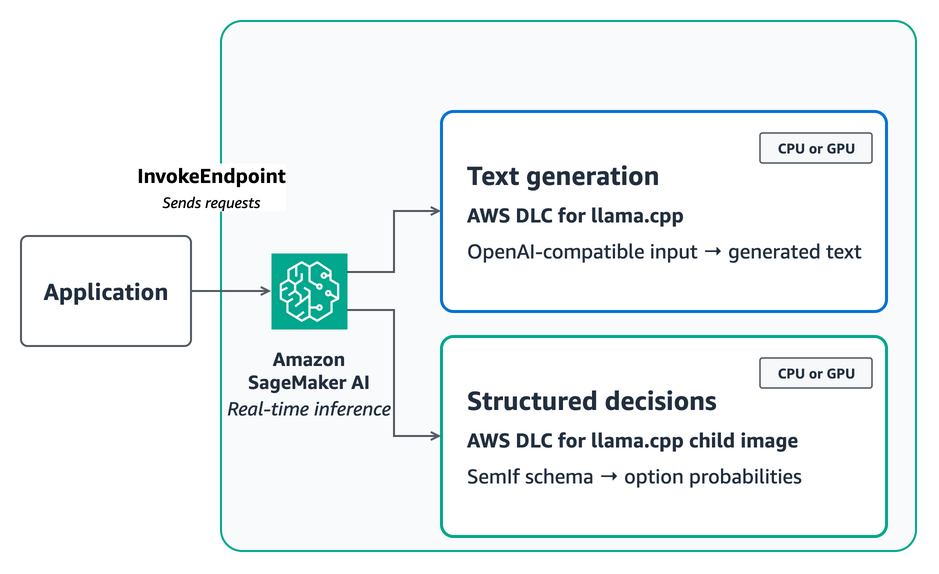
図 1: ワークロードの API およびレイテンシー要件に応じて、llama.cpp 用の AWS DLC または SemIf の子イメージを CPU または GPU 上で実行します
Amazon Simple Storage Service (Amazon S3) model.tar.gz 内の Amazon Simple Storage Service (Amazon S3) としてパッケージ化し、公開されている DLC イメージを直接参照します。コンテナは、 .gguf の下にある最初の /opt/ml/modelファイルを見つけ、 POST /invocations を llama-server にマッピングします。 /v1/chat/completions、そして渡します SM_LLAMA_CPP_* 環境変数をllama.cppの引数に変換します。
その llama-server HTTP APIは、SemIfが使用する最終位置のロジットおよび状態操作を公開していません。そのため構造化決定のパスでは、次を使用します。 AWS CodeBuild 子イメージをビルドしてそれを保存先とする Amazon Elastic Container Registry(Amazon ECR)この子イメージは、DLCのコンパイル済みCPUまたはCUDAライブラリを保持しつつ、そのエントリポイントをSageMaker互換のアダプターに置き換えます。
入力スキーマと出力スキーマを理解する
llama.cpp用のAWS DLCは、OpenAI Chat Completionsスキーマを受け付けます。以下を送信してください: messages 配列と role および content「、および次のような生成コントロール」 max_tokens および stream:
{
  "messages": [
    {
      "role": "user",
      "content": "A customer cannot receive a password reset email. Reply with the best support queue."
    }
  ],
  "max_tokens": 64,
  "stream": false
}
そのレスポンスはOpenAI互換の choices 配列。生成されたテキストを次から読み取ります: choices[0].message.content.
SemIfはチャットメッセージの代わりに、制約付きの決定スキーマを使用します。リクエストには、呼び出し側が定義したID、非構造化状態、質問、および許可された選択肢の順序付きリストが含まれます:
{
  "decision": {
    "id": "support-route",
    "state": "The customer cannot receive a password reset email.",
    "question": "Which queue should handle this request?",
    "options": [
      {"id": "account_access", "description": "Account access support."},
      {"id": "billing", "description": "Billing support."}
    ]
  }
}
レスポンスは次を返します option_ids, probabilities、およびraw option_logits 同じ順序で、プロンプト、タイミング、ピン留めされたモデルのメタデータも併せて提供されます。安定したオプション ID があれば、アプリケーションは生成された文章を解析することなく、しきい値、フォールバック、ポリシーチェックを適用できます。
SemIfは、非構造化された状態からアプリケーション定義の結果をスコアリングする、より広範なクラスの決定モデルに属します。その他の実装には以下が含まれます Jev、TypeSafeの意思決定モデルおよび /v1/systemone API; KevTypeSafe API互換性を持つために設計されたモデルサーバー、および Strands Decider 2Bエージェントワークフロー向けに特別に構築された、較正された出力を備えるモデルです。
適切な意思決定ワークフローを選ぶ
アプリケーションがリクエスト時に許可される選択肢を定義し、モデルに非構造化コンテキストを解釈させる必要がある場合に、このパターンを使用します。例として、ケースのキューへの振り分け、既知の選択肢から1つの値の抽出、インシデント優先度の割り当て、ポリシー結果の判定、エージェントアクションの選択などが挙げられます。認可と決定論的なビジネスルールはモデルの外部に置き、モデルが出力する確率を運用上の信頼度として扱う前に検証してください。
OpenAI互換のチャット補完が必要な場合は、次を経由する標準の SageMaker AI テキスト生成パスを使用してください。 InvokeEndpoint経由で利用する必要がある場合は、標準のSageMaker AIテキスト生成パスを使用してください。SageMaker AIのイメージは POST /invocations を llama-server /v1/chat/completions エンドポイントにマッピングします。SemIfの直接的なlogitsおよび状態アクセスのように、このインターフェースが提供しない動作がアプリケーションに必要な場合にのみ、子イメージをビルドしてください。
回答トークンの生成を省いても、モデルの推論はなくなりません。SemIfが最終的なlogitsを読み取る前に、モデルは完全な状態、質問、および選択肢の説明を処理します。プロンプトは簡潔に保ち、本番利用の前に、アプリケーションのラベル付き判断データを用いて選択したモデルを評価してください。
レイテンシーと品質の目標に合わせてチューニングする
以下のベンチマークは、テキスト生成エンドポイントではなく、SemIf拡張機能に適用されます。モデルサイズ、量子化、プロンプト長、ランタイム、CPUスレッド数が各判断に影響します。これらのトレードオフを定量化するため、同じ231件の公開 JevBench タスクを、1つのCPUエンドポイントと1つのGPUエンドポイントに逐次送信しました。
| 構成 | AWS DLC for llama.cpp | 有効なレスポンス | 精度 | クライアント p50 | クライアント p95 |
Qwen3.5-4B Q4_K_M, ml.c6i.8xlarge、32スレッド |
llama-cpp:server-sagemaker-cpu-v1 | 231/231 | 179/231 (77.5%) | 1.715秒 | 19.291秒 |
Qwen3.5-4B Q4_K_M, ml.g6e.xlarge、完全なGPUオフロード |
llama-cpp:server-sagemaker-cuda-v1 | 231/231 | 180/231 (77.9%) | 0.352秒 | 0.599秒 |
CPU構成と比較すると、GPUエンドポイントはp50で4.9倍、p95で32.2倍高速でした。このサンプルはSageMaker AIのインスタンスプール機能を使用して、互換性のあるGPUインスタンスタイプを優先順にリスト表示するため、最初の選択肢が利用できない場合にSageMakerが代替を選択できます。プールは g6e, g6, g5を最初に、次に g4dnを順序付けていました。SageMakerは ml.g6e.xlargeを選択し、起動ログでllama.cppが全34モデルレイヤーをNVIDIA L40Sにオフロードしたことが確認されました。CPUイメージとGPUイメージは異なるllama.cppビルドを使用し、6つの難しいタスクで異なる予測をしました。1件あたりの精度差はランタイムのばらつきとして扱い、GPUオフロードがモデル品質を向上させる証拠としないでください。
より小さいモデルは中央値レイテンシーを削減しましたが、2Bと0.8Bの候補は66.7パーセントと58.4パーセントの精度でした。そのためサンプルは、品質優先のデフォルトとして4Bの Q4_K_M モデルを維持しています。これらの測定値にはネットワークレイテンシーが含まれており、サービス保証ではありません。
モデルとインフラの完全な構成を、ご自身の判断データに対してベンチマークしてください。レイテンシーが重要でなく、数秒の応答時間を許容できるバックグラウンド、オフライン、低スループットのワークロードにはCPUを使用してください。インタラクティブな判断、長いプロンプト、厳しいテールレイテンシー目標を持つワークロードにはGPUを使用してください。状態と選択肢の説明は簡潔に保ち、同じ状態を共有する判断を1つのリクエストにまとめ、同時実行数に応じてエンドポイントインスタンスをスケールしてください。共有状態のスコアリングは共通のプロンプトプレフィックスを再利用し、アダプターは再試行可能なHTTP 503 ステートフルな llama.cpp コンテキストの周囲で無制限のキューを許すのではなく、レスポンスを処理します。
前提条件
必要なもの:
- デプロイ先の AWS リージョンにある AWS アカウントと S3 バケット。
- Python 3.10 以降、Git、および AWS Command Line Interface(AWS CLI)。
- オプションのSemIf拡張機能用の専用CodeBuildサービスロール。
- An AWS Identity and Access Management (IAM) SageMaker AI が引き受けることができるロール。
- SageMaker AI、Amazon ECR、Amazon S3、CodeBuild、IAM の pass-role アクション、および Amazon CloudWatch Logs.
- 互換性のあるx86 CPUまたはNVIDIA GPU向けのSageMakerリアルタイムエンドポイントのクォータ。
テキスト生成の例ではCPU DLCと固定のCPUインスタンスを使用します。SemIf拡張機能は、レイテンシが重要ではないワークロードについてはCPUをデフォルトのまま維持し、順序付きインスタンスプールを備えたオプションのCUDAイメージを提供します。レビュー SageMaker AI の料金 エンドポイントを作成する前に。
判断モデルをデプロイし、SemIfで拡張する
以下の手順に従って標準のテキスト生成エンドポイントをデプロイし、その後、CPU または GPU 上での構造化された判断のためのオプションの SemIf 拡張をビルドしてください。
- コードサンプルをクローンし、依存関係をインストールします。
git clone https://github.com/aws-samples/sagemaker-genai-hosting-examples.git cd sagemaker-genai-hosting-examples/03-features/semif-decision-model python3 -m venv .venv . .venv/bin/activate python3 -m pip install -r deploy/requirements.txt - アカウント用のデプロイ値を設定します。
export AWS_REGION="<your-region>" export ARTIFACT_BUCKET=amzn-s3-demo-semif-artifacts export CODEBUILD_ROLE_ARN=arn:aws:iam::111122223333:role/semif-codebuild-role export SAGEMAKER_ROLE_ARN=arn:aws:iam::111122223333:role/semif-sagemaker-role export STANDARD_ENDPOINT_NAME=llamacpp-gguf export SEMIF_ENDPOINT_NAME=semif-decision-workflows - ピン留めされたGGUFモデルとトークナイザーをCodeBuildでパッケージ化します。
python deploy/prepare_model_build.py \
  --region "$AWS_REGION" \
  --bucket "$ARTIFACT_BUCKET" \
  --codebuild-role-arn "$CODEBUILD_ROLE_ARN" \
  --model-s3-uri "s3://$ARTIFACT_BUCKET/semif-llamacpp/model.tar.gz"
返されたビルドIDが
SUCCEEDEDに達するのを待ちます。ビルドはソースのリビジョンとチェックサムをmodel-manifest.jsonに記録し、GGUFのチェックサムが検証済みの値と異なる場合は停止します。 - AWS DLC for llama.cpp を使用してGGUFモデルをデプロイします。
digestでピン留めされた
server-sagemaker-cpu-v1イメージを AWS DLC for llama.cpp ドキュメントから解決し、SageMaker AI のモデル、エンドポイント設定、エンドポイントを作成します:export STANDARD_IMAGE_URI="<published-llama-cpp-cpu-image>@sha256:<digest>" python deploy/deploy_standard_endpoint.py \ --region "$AWS_REGION" \ --image-uri "$STANDARD_IMAGE_URI" \ --model-data-url "s3://$ARTIFACT_BUCKET/semif-llamacpp/model.tar.gz" \ --role-arn "$SAGEMAKER_ROLE_ARN" \ --instance-type ml.c6i.2xlarge \ --name "$STANDARD_ENDPOINT_NAME"対応するEC2イメージではなく、
server-sagemaker-cpu-v1またはserver-sagemaker-cuda-v1EC2 ではなく対応する SageMaker AI イメージの方を選択してください。SageMaker AI のイメージは/pingおよび/invocationsコンテナ契約を実装し、呼び出しペイロードをチャット補完にマッピングします。このウォークスルーでは、GGUFモデルをAmazon S3内のSageMaker AI モデルアーティファクトとして提供します。代替として、エンドポイントにネットワーク送信(egress)がある場合は、
SM_LLAMA_CPP_HF_REPOとSM_LLAMA_CPP_HF_FILEを設定してHugging FaceからGGUFファイルをダウンロードすることもできます。この方法ではDockerfileやECRリポジトリは必要ありません。エンドポイントが
InServiceになるのを待ち、OpenAI互換のチャットリクエストを送信します:python deploy/invoke_standard_endpoint.py \ --region "$AWS_REGION" \ --endpoint-name "$STANDARD_ENDPOINT_NAME" - オプションのSemIf子イメージをビルドし、その不変のdigestを解決します。
CPUの場合:
python deploy/prepare_build.py \
  --region "$AWS_REGION" \
  --bucket "$ARTIFACT_BUCKET" \
  --codebuild-role-arn "$CODEBUILD_ROLE_ARN"
GPUの場合は、代わりにCUDA子イメージをビルドします:
python deploy/prepare_build.py \
  --region "$AWS_REGION" \
  --bucket "$ARTIFACT_BUCKET" \
  --codebuild-role-arn "$CODEBUILD_ROLE_ARN" \
  --dockerfile Dockerfile.gpu \
  --image-tag "gpu-$(date +%Y%m%d%H%M%S)"
ビルドが成功したら、不変のイメージURIを構成します:
ECR_REPOSITORY_URI=$(aws ecr describe-repositories \
  --region "$AWS_REGION" \
  --repository-names semif-llamacpp-dlc \
  --query 'repositories[0].repositoryUri' \
  --output text)
IMAGE_DIGEST=$(aws ecr describe-images \
  --region "$AWS_REGION" \
  --repository-name semif-llamacpp-dlc \
  --query 'sort_by(imageDetails,&imagePushedAt)[-1].imageDigest' \
  --output text)
export IMAGE_URI="${ECR_REPOSITORY_URI}@${IMAGE_DIGEST}"
デプロイスクリプトは可変のイメージタグを拒否します。
- SemIfエンドポイントをデプロイします。
CPU構成では固定のインスタンスタイプを使用します:
python deploy/deploy_endpoint.py \
  --region "$AWS_REGION" \
  --image-uri "$IMAGE_URI" \
  --model-data-url "s3://$ARTIFACT_BUCKET/semif-llamacpp/model.tar.gz" \
  --role-arn "$SAGEMAKER_ROLE_ARN" \
  --instance-type ml.c6i.8xlarge \
  --threads 32 \
  --name "$SEMIF_ENDPOINT_NAME"
返されたエンドポイント名が
InServiceになるのを待ちます。この方法ではn_gpu_layers=0が設定されます。アダプタは1つのステートフルなllama.cppコンテキストを中心にスコアリングをシリアライズするため、1つのコンテナ内で並列スコアリングを前提とせず、ワークロードを計測した上でエンドポイントインスタンスによるスケールアウトを行ってください。GPUイメージについては、順序付きのインスタンスプールを指定し、モデルの完全なオフロードを要求します:
python deploy/deploy_endpoint.py \
  --region "$AWS_REGION" \
  --image-uri "$IMAGE_URI" \
  --model-data-url "s3://$ARTIFACT_BUCKET/semif-llamacpp/model.tar.gz" \
  --role-arn "$SAGEMAKER_ROLE_ARN" \
  --instance-pool ml.g6e.xlarge \
  --instance-pool ml.g6.2xlarge \
  --instance-pool ml.g5.2xlarge \
  --instance-pool ml.g4dn.2xlarge \
  --gpu-layers=-1 \
  --provision-timeout 1200 \
  --name "$SEMIF_ENDPOINT_NAME"
インスタンスプールは順序付きの配置フォールバックであり、推論のロードバランシングではありません。SageMaker はバリアントに対して利用可能なタイプを 1 つ選択します。SageMaker AI がプールを処理する間、エンドポイントの作成に時間がかかる場合があります。選択された GPU の起動ログと、すべてのモデルレイヤーがオフロードされたことを確認するメッセージを確認してください。
- SemIf エンドポイントを例の決定で呼び出します。
リクエストは、許可された各オプションに対して安定した ID を宣言します:
{
  "decision": {
    "id": "support-route",
    "state": "Customer asks to reset a forgotten password and says the reset email never arrived.",
    "question": "Which queue should handle this request?",
    "options": [
      {"id": "account_access", "description": "Account access and authentication support."},
      {"id": "billing", "description": "Billing and payment support."},
      {"id": "sales", "description": "Sales and product evaluation."}
    ]
  }
}
python deploy/invoke_endpoint.py \ --region "$AWS_REGION" \ --endpoint-name "$SEMIF_ENDPOINT_NAME"レスポンスはオプションの順序を保持し、条件付き確率、生のロジット、トークンおよびプロンプトのメタデータ、そして固定されたモデル ID を含みます:
{
  "result": {
    "id": "support-route",
    "option_ids": ["account_access", "billing", "sales"],
    "probabilities": [0.99996, 0.00003, 0.00001],
    "option_logits": [28.47, 17.92, 17.04],
    "prompt_sha256": "016267542103ab91422c425d2234ec7e1b9aef77f9d3e481b96db2de7cca470a",
    "readout": "quantized last-position logits restricted to declared answer slots; no generated tokens"
  }
}
アプリケーションレベルのしきい値とフォールバックを適用してください。モデルの決定を認可の代わりとして使用しないでください。
クリーンアップ
SageMaker AI のエンドポイント、エンドポイント設定、およびモデルを削除します:
python deploy/cleanup_endpoint.py \
  --region "$AWS_REGION" \
  --name "$STANDARD_ENDPOINT_NAME"

python deploy/cleanup_endpoint.py \
  --region "$AWS_REGION" \
  --name "$SEMIF_ENDPOINT_NAME"
スクリプトは、明示的に名前が付けられた SageMaker AI リソースのみを削除します。CodeBuild プロジェクト、ECR リポジトリ、Amazon S3 内のモデルおよびソースオブジェクト、ログ、および目的別の IAM ロールは、不要になった時点で削除してください。
結論
llama.cpp 用の AWS DLC は、CPU および GPU インスタンスにわたって SageMaker AI 上で決定モデルを提供するためのマネージド基盤を提供します。SageMaker AI のモデルアーティファクトまたは設定された Hugging Face リポジトリから GGUF モデルをロードでき、その後、OpenAI 互換のチャット completions を InvokeEndpoint を通じて提供します。カスタムコンテナは不要です。アプリケーションが直接のロジットやモデル状態操作を必要とする場合は、DLC を SemIf アダプターで拡張できます。レイテンシーに敏感でないワークロードには CPU を選択し、プロンプトのプリフィルやテールレイテンシーがアプリケーションエクスペリエンスに影響する場合には GPU を選択してください。
以下を確認してください: コードサンプル, llama.cpp 用 AWS DLC ドキュメント、および SageMaker AI カスタム推論コンテナ契約 を参照して、デプロイをワークロードに合わせて調整してください。