
この投稿では、Amazon Elastic Kubernetes Service (Amazon EKS) 上の2つのGPUノードにわたって、マルチノードの Ray LLM Deep Learning Containers。これは1つのOpenAI互換エンドポイントの背後で、prefill用とdecode用の別々のノードを使用します。この種のマルチノード構成は、テンソル並列、パイプライン並列、データ並列、さらにはprefill/decode分離型推論ワークロードでも一般的です。「 前の投稿、私たちは Ray Serve DLC 単一のGPUノード上のHTTPエンドポイントの背後に小さなモデルを立ち上げるのに使いました。動作する推論エンドポイントが手に入り、コンテナがCUDAライブラリを含むGPUスタックの互換性を維持してくれるため、ボイラープレートコードを書く必要はありませんでした。
レイ は分散コンピュートフレームワークであるため、Ray Serveのデプロイメントは複数のノードにまたがることができます。お客様がマルチノードのRay Serveを利用する理由はいくつかあります。単一のGPUには大きすぎる基盤モデルやオープンウェイトモデルを実行したいお客様もいれば、1つのレプリカでは提供できない以上のスループットが必要なお客様もいます。また、パフォーマンスを向上させるために推論の2つのフェーズを分離したいお客様もいます。いずれの場合も、お客様は依存関係チェーンを自分で構築しなければなりません。GPUスタック用に互換性のあるライブラリを選択し、コンポーネントがずれたときに問題をデバッグするのです。これは、モデルの提供から時間と労力を奪う、差別化されていない作業です。
AWS Deep Learning Containers (DLC)は、トレーニングおよび推論ワークロード向けに、この種の問題を長らく解決してきました。DLCは事前構築済みでパフォーマンス最適化されたDockerイメージであり、フレームワークとその依存関係、GPUスタックをテスト済みでパッチ適用済みの組み合わせとして1つにまとめたもので、すぐにプルして使用できます。のローンチに伴い、 Ray LLM DLC マルチノードデプロイの場合、同じアプローチが現在ではマルチノード推論にも拡張されています。HTTPエンドポイントの背後でモデルを提供するために特化して構築されたコンテナ、AWSによってメンテナンスおよびテストされたもの、そして推論スタック全体がすでに組み立てられた状態で手に入ります。
この投稿では、マルチノードRay LLM DLCを使用してマルチノード分散型(disaggregated)推論を実装する方法を解説します。具体的には、2台のGPU搭載ノード上に単一の大規模言語モデルをデプロイします。 Amazon EKS 単一のエンドポイントの背後で連携して動作します。一方のGPUノードがプリフェーズ(prefill)を処理する間に、もう一方のGPUノードがデコードフェーズを処理します。フェーズを分離することで、計算負荷の高い長いプロンプトが、すでに処理中のリクエストのトークン生成を停滞させるのを防ぎます。このアプローチは、検索拡張生成(RAG)、ドキュメント要約、エージェントアプリケーションなどのワークロードに適しています。私たちは、同梱のマルチノードRay LLM DLCを使用します。 Ray Serve LLM, NVIDIA Inference Transfer Library (NIXL)、さらに Elastic Fabric Adapter (EFA) アプリケーションコードを一切書かずに、OpenAI互換のAPIを公開します。完全なコードは以下で入手できます。 付属のリポジトリ.
なぜprefill/decode(PD)分離なのか
LLM推論には、2つの明確なフェーズがあります。 プリフィル 入力プロンプト全体を並列に処理し、キー・バリュー(KV)キャッシュを構築します。 解読 その後、トークンを1つずつ生成しながら、そのキャッシュを読み取り、拡張していきます。Prefillは計算がボトルネックとなり、Decodeはメモリ帯域幅がボトルネックとなります。両方のフェーズが1つのGPUを共有すると、同じリソースを取り合い、バースト的で計算量の多いPrefill処理が、一定したレイテンシ敏感なDecode処理の妨げになります。PrefillフェーズをDecodeフェーズから分離することで、各フェーズに応じたハードウェアとサービング特性を選択でき、大規模環境での全体的なパフォーマンスが向上します。
PD disaggregationでは、この2つのフェーズを別々のノードに配置します。そうすることで、各フェーズは互いに干渉することなく実行され、独立してスケールできます。トレードオフとしては、プリフィル中に構築されたKVキャッシュをデコードノードに引き渡す必要があり、その転送がベネフィットを打ち消さない程度に高速でなければならない点です。まさにそのため、ノード間のインターコネクトが重要になります。
Ray LLM DLCが提供するもの
AWS DLCは、フレームワークとその依存関係、GPUスタックを検証済みでパッチ適用済みの組み合わせとして1つにまとめた、事前構築済みのパフォーマンス最適化Dockerイメージです。すぐにプルして使用できます。すべてのコンポーネントは各リリース前にまとめて検証されるため、CUDAランタイム、フレームワーク、サービング層の間でバージョンのずれが発生しません。セキュリティパッチはビルド時に適用されます。
ザ・ Ray LLM DLC 分散型LLMサービングにもこれを拡張しています。同梱されているのは vLLM 推論エンジンとして、Ray ServeのHTTPをサービング層として、ノード間のKVキャッシュ転送にはNIXL、そしてEFAスタック(libfabric および aws-ofi-nccl高帯域幅のノード間通信用です。なぜなら Ray Serve LLM ライブラリ 組み込みのアプリケーションビルダーを備えており、サービングアプリケーション全体がYAMLのブロック1つです。ハンドラークラスも、モデルアーカイバも、ビルドするカスタムイメージも不要です。単一のヘルパー、 build_pd_openai_appは、prefill設定とdecode設定を受け取り、両者間のKV-cache転送を1つのOpenAI互換エンドポイントの背後で接続します。
アーキテクチャ
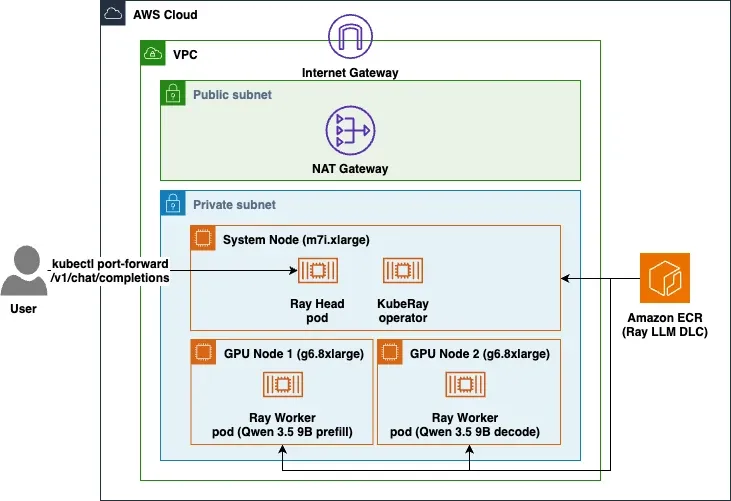
以下の図は、Amazon EKS 上でのデプロイメントの構成を示したものです。ユーザーのリクエストは CPU システムノード上の Ray head に到達し、2 つの GPU ワーカーノードがモデルの prefill フェーズと decode フェーズを実行します。
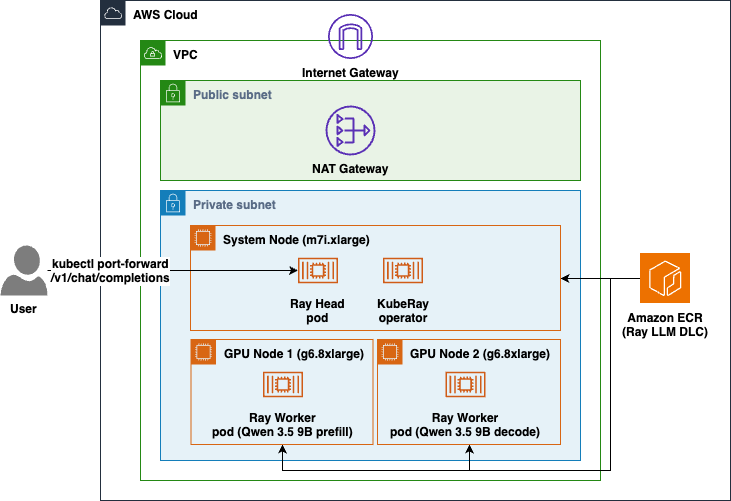
図1:Amazon EKS上のマルチノード推論アーキテクチャ。RayヘッドはCPUシステムノードに配置され、プリフィルおよびデコードの各フェーズは2つのGPUワーカーノードで実行されます
デプロイメントは、仮想プライベートクラウド(VPC)内のEKSクラスターです。ノードはプライベートサブネットで稼働し、NATゲートウェイを経由したアウトバウンドアクセスを行います。CPU システムノード (m7i.xlarge)はシステムワークロードをホストし、 KubeRay operator、およびCPUのみのRay head pod。GPUは2基 ワーカーノード (g6.8xlarge) Rayワーカーを実行します。片方はプリフェーズを担当し、もう片方はデコードフェーズを担当します。両方のノードがRay LLM DLCを以下から取得します。 Amazon Elastic Container Registry(Amazon ECR).
KubeRayは適用されたRayServiceを監視し、ヘッドとワーカーの接続を自動的に設定します。Ray Serveは、プレフィルおよびデコードのデプロイメントを2つのGPUワーカーに配置します。KVキャッシュは、NIXLのlibfabricバックエンドを通じてEFAを使用し、NIXL経由でプレフィルワーカーからデコードワーカーへ流れます。EFAはアベイラビリティーゾーン(AZ)をまたげないため、GPUノードグループは単一のAZに固定されています。
前提条件
この投稿に沿って進めるには、次のものが必要です:
- 請求が有効になっている AWS アカウント。
- お使いのターゲットリージョンで2つの g6.8xlarge インスタンス(少なくとも64 vCPU)を実行するのに十分なサービスクォータ。
- AWS コマンドラインインターフェイス(AWS CLI) 認証情報が設定された状態です。
- Kubernetesクラスターのコントロールプレーンと通信するためのkubectl CLI。
- EKS上でクラスタを作成・管理するための eksctl CLI。
- Kubernetesのパッケージマネージャーであるhelmを使用してKubeRay operatorをインストールします。
- マニフェストをレンダリングするために、envsubstユーティリティ(GNU gettextの一部)を使用します。
以下のコマンドでAWS認証情報が有効であることを確認してください:
aws sts get-caller-identity事前構築済みのアプリケーションを使用して推論を提供する
このアプリケーションは serveConfigV2 でブロックする manifest/rayservice.yaml。使用しているのは build_pd_openai_app、これは prefill_config およびa decode_config そして、両者の間のKV-cache転送を接続します:
applications:
- name: qwen
  import_path: ray.serve.llm:build_pd_openai_app # OpenAI-compatible PD app, built in
  route_prefix: /
  args:
    prefill_config:
      model_loading_config: { model_id: qwen3.5-9b, model_source: Qwen/Qwen3.5-9B }
      engine_kwargs:
        max_model_len: 4096
        dtype: bfloat16
        gpu_memory_utilization: 0.90
        enforce_eager: true # Skip CUDA graph capture to reduce peak GPU memory
      kv_transfer_config:
        kv_connector: NixlConnector
        kv_role: kv_both
        engine_id: prefill
        kv_connector_extra_config: { backends: ["LIBFABRIC"] }
      deployment_config: { num_replicas: 1 }
    decode_config:
      model_loading_config: { model_id: qwen3.5-9b, model_source: Qwen/Qwen3.5-9B }
      engine_kwargs:
        max_model_len: 4096
        dtype: bfloat16
        gpu_memory_utilization: 0.90
        enforce_eager: true
      kv_transfer_config:
        kv_connector: NixlConnector
        kv_role: kv_both
        engine_id: decode
        kv_connector_extra_config: { backends: ["LIBFABRIC"] }
      deployment_config: { num_replicas: 1 }
重荷のほとんどを担っているのは、わずか数個の設定です。 max_model_len: 4096 測定されたKVキャッシュに合わせてコンテキストのサイズをGPU上で調整します。 dtype: bfloat16 および gpu_memory_utilization: 0.90 precisionの設定と、vLLMが確保できるVRAMの量を指定します。 enforce_eager: true CUDA グラフのキャプチャをスキップしてピーク GPU メモリを削減します(モデルおよび入力に依存)。この kv_transfer_config 設定こそが分離を機能させる鍵である:両フェーズとも使用する NixlConnector と共に kv_role: kv_both そして、明確に異なる engine_id (一方でプリフィル、他方でデコードを行う)。重要な設定は kv_connector_extra_config: { backends: ["LIBFABRIC"] }。この行がない場合、NIXLはUCXにデフォルト設定され、EFA上でもTCP速度で動作します。
マニフェストの残りの部分は、 rayClusterConfig「とポッドについて説明している。ヘッドポッドはCPU専用で(「num-gpus: "0"`)、システムノードグループにピン留めされます。各ワーカーPodは1つのGPUと1つのEFAインターフェースを要求します(`nvidia.com/gpu: "1", vpc.amazonaws.com/efa: "1") を介して GPU ノードをターゲットとし、 nodeSelector: { role: gpu-worker }. それは実行されます privileged: true CUDA VRAMがEFA NICに登録されるためです。The IPC_LOCK 能力だけでは十分ではありません。労働者たちは設定した FI_PROVIDER=efa、読んだ VLLM_HOST_IP ポッドIPからアクセスし、共有メモリボリュームをマウントします。メモリ上限は約18 GiBのチェックポイントを十分に上回っており、OSのページキャッシュがそれを保持できるようになっています。前述のキャッシュ構成を用いてg6.8xlarge上でQwen3.5-9Bモデルをロードした場合、再起動時のモデル重みのロード時間は約145秒から約2秒に短縮されます。
Amazon EKS へのデプロイ
すべてのスクリプトは単一の設定ファイルを共有します。 scripts/env.sh。このスクリプトには以下のデフォルトが含まれています CLUSTER_NAME, REGION, K8S_VERSION、また NAMESPACE。その他のデフォルト値は、システムおよびGPUノードグループ、KubeRayのバージョン、モデルを対象としています。スクリプトを実行する前に変数をエクスポートすることで、任意の変数を上書きできます。
プロジェクトのルートからベースディレクトリを設定し、その後変数を読み込みます:
CURRENT_DIR=$(pwd)
cd $CURRENT_DIR/ray-serve-multi-node/scripts
source ./env.sh
ステップ 1: EKSクラスターを作成する
./deploy_cluster.shこのスクリプトは、EKSクラスタ(VPC、OIDCプロバイダー、コアアドオン)と、システムワークロード、KubeRayオペレーター、Rayヘッドを実行するCPUシステムノードグループをプロビジョニングします。ノードはNAT Gateway経由で外部通信を行うプライベートサブネットで実行され、クラスタのサブネットはGPUインスタンスタイプが利用可能なAZに配置されます。このスクリプトは冪等であり、初回実行には15〜20分かかります。
ステップ 2: GPUワーカーノードを追加する
./deploy_node_group.shこれによりGPUノードグループが作成されます。EFAを有効化したg6.8xlargeインスタンス2台で構成され、単一のAZに固定され、ラベルが付けられます。 role=gpu-worker そこでRayのワーカーはそれらをターゲットにします。EFAを有効にすると、EFAデバイスプラグインもインストールされ、これが以下をアドバタイズします。 vpc.amazonaws.com/efa 各ノード上で実行します。このステップには5〜20分程度かかり、通常は初回の実行時に時間がかかります。
ステップ3:KubeRayオペレーターをインストールする
./install_kuberay.shこの手順では、Helmを使用してKubeRayオペレーターをインストールし、システムノードグループに固定することで、GPUノードを推論用に確保します。KubeRayは次に適用するRayServiceを監視し、ヘッドとワーカーの接続を自動的に設定します。このステップには約1~2分かかります。
ステップ4:RayServiceをデプロイする
./deploy_ray_service.shこれにより描画されます manifest/rayservice.yaml 画像・モデル・命名の各変数を envsubst で展開してテンプレートを適用します。KubeRay がヘッド Pod と 2 つのワーカー Pod を作成し、Ray Serve LLM が prefill と decode のデプロイメントを起動します。スクリプトは、ヘッドが Ready になること、両方のワーカーが Running になること、そして最後に Serve アプリが RUNNING と報告するのを待ちます。各ノードがモデルをロードするため、このステップには数分かかることを想定してください。
各Podがどのノードに配置されたか、利用可能なGPU容量など、ステータスはいつでも確認できます:
./deploy_ray_service.sh statusモデルを呼び出す
Serve アプリが正常になった後、KubeRay は安定した <rayservice-name>-serve-svc Service。それにポートフォワードします:
kubectl port-forward -n inference svc/ray-llm-serve-svc 8000:8000DLCはOpenAI互換のAPIを公開しているため、カスタムスキーマなしでモデルの一覧表示や標準的なチャット補完リクエストを送信できます。
curl --silent http://127.0.0.1:8000/v1/models
curl --fail --silent --show-error \
  --request POST "http://127.0.0.1:8000/v1/chat/completions" \
  --header "Content-Type: application/json" \
  --data '{
    "model": "qwen3.5-9b",
    "messages": [
      {"role": "user", "content": "Explain the benefits of prefill/decode disaggregation."}
    ],
    "max_tokens": 200,
    "temperature": 0.7
  }'
EFAが使用されていることを確認する
libfabric を使用できない場合、NIXL は TCP 速度のトランスポートにフォールバックしますが、その際にエラーをraiseしないため、選択されたバックエンドを確認する価値があります。ワーカーのログをgrepしてください。
for POD in $(kubectl get pods -n inference -l ray.io/node-type=worker \
  -o jsonpath='{.items[*].metadata.name}'); do
  kubectl exec -n inference "$POD" -c ray-worker -- \
    grep -rhoE "Backend (LIBFABRIC|UCX) was instantiated" /tmp/ray/session_latest/logs/ 2>/dev/null
done | sort | uniq -c
deploy_node_group.sh すでに〜を出力している vpc.amazonaws.com/efa ノードごとのカウントをグループ作成時に使用します。ノード間帯域幅の数値については、DLC にはあらかじめビルドされた NVIDIA Collective Communications Library(NCCL)ベンチマークが に同梱されています。 /usr/local/bin/all_reduce_perf.
クリーンアップ
継続的な課金を避けるために、リソースを逆の順序で削除してください:
./delete_ray_service.sh # Remove the RayService
./install_kuberay.sh cleanup # Uninstall the KubeRay operator
./delete_node_group.sh # Remove the GPU node group
./delete_cluster.sh # Delete the EKS cluster
結論と次のステップ
2つのGPUノードにまたがってprefill/decode分離による単一モデルを提供し、アプリケーション全体がYAMLのブロックであり、ハンドラーコードもモデルアーカイバも、手作業で組み立てたGPUとEFAのスタックも必要ありませんでした。マルチノードのRay LLM DLCがテスト済みの推論スタックを提供し、KubeRayがRayクラスタをオーケストレーションし、EFA上のNIXLがノード間でKVキャッシュを運びました。あなたの仕事はそれを構築することではなく、設定することでした。
マルチノード推論を実行する一般的なパターンには、テンソル並列およびパイプライン並列(1つのインスタンスには大きすぎるモデルをシャーディングする)、データ並列(スループット向上のためモデルをレプリケーションする)、プリフィル/デコード分離(推論の2つのフェーズを異なるノードに分ける)があります。
ここからは、スループットを高めるためにデコードレプリカをスケールしたり、より大きな GPU インスタンス上でテンソル並列やパイプライン並列を使ってより大きなモデルへ移行したり、必要なモデル向けに同じ検証済みのベースへ追加のライブラリを重ねたりすることができます。完全なコード、現在のイメージタグの一覧、そして内部の仕組みについては、以下を参照してください。 付属のリポジトリ, the Ray LLM DLC利用可能なイメージのページ, the Ray Serve LLM prefill/decodeドキュメント, and the EFAドキュメント.