
Google, EmbeddingGemma 2가 자신보다 2배 큰 경쟁 임베딩 모델들을 능가한다고 주장
 Matthias Bastian
의 LinkedIn 프로필 보기
2026년 10월 6일
Google이 EmbeddingGemma 2를 출시했습니다. 텍스트, 이미지, 비디오, 오디오, 코드를 수치 벡터로 변환하여 유사한 콘텐츠를 더 쉽게 찾고 비교할 수 있게 해주는 오픈 모델입니다. Google은 740 million 파라미터 규모로 이런 종류의 모델 중 가장 컴팩트하며, 경쟁 모델들을 능가합니다 멀티모달 임베딩 벤치마크에서 자신보다 2배 큰 모델에 필적하는 성능을 보입니다.
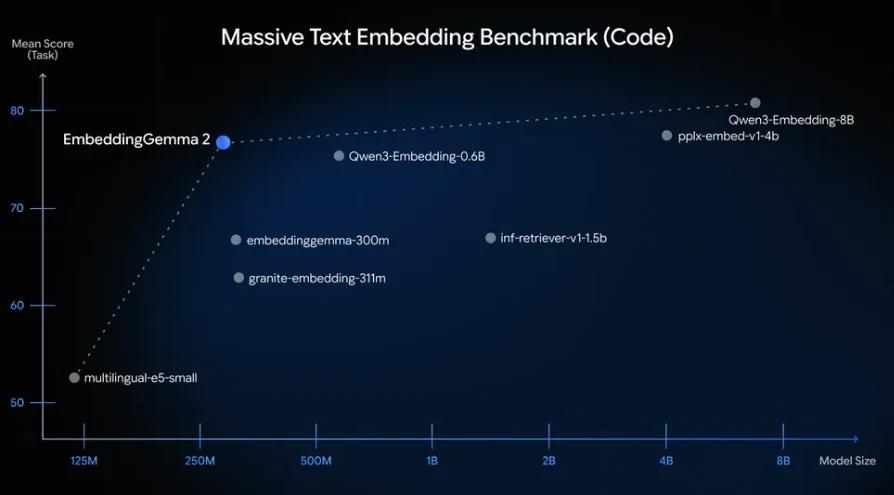
이 모델은 API 키 없이 로컬에서 실행됩니다. 브라우저에서 WebGPU를 통해 각 쿼리에 약 20~70밀리초가 걸립니다. 약 191MB의 RAM만 필요하며 로컬 벡터 데이터베이스 저장 공간을 최대 6배까지 절감합니다. 텍스트 전용 작업에는 270-million-파라미터 버전으로도 충분합니다.
Gemma 4 Gemma 4, EmbeddingGemma 2는 외부 서버로 데이터를 보내지 않고도 오프라인 RAG 앱을 실행할 수 있습니다. 가중치는 다음에서 제공됩니다: 와 Kaggle 에서 제공되며, 함께개발자 가이드 와 문서화 도 제공됩니다.광고
과장 없는 AI 뉴스 – 사람이 직접 큐레이션
광고 없는 읽기, 주간 AI 뉴스레터, 연 6회 제공되는 독점 "AI Radar" 프론티어 리포트, 전체 아카이브 접근, 댓글 섹션 이용을 위해 THE DECODER를 구독하세요.
출처: Google